
Qwen3.5-397B-A17B sur deux DGX Spark : mythe ou réalité ? Retour d’expérience après 6 mois de tests
Un utilisateur a passé six mois à faire tourner le modèle Qwen3.5-397B-A17B (397 milliards de paramètres, architecture MoE) sur un cluster de deux DGX Spark. Cet article décrypte son retour d’expérience : configuration réseau et RDMA, déploiement avec vLLM, benchmarks de performance réels, problèmes
Le paradoxe du petit modèle : comment le DGX Spark transforme un Llama 8B en assistant de raisonnement
Cet article décrypte la récente expérience de full fine-tuning de Llama 3.1-8B sur NVIDIA DGX Spark pour débloquer des capacités de raisonnement avancées. Nous analysons la méthodologie (jeux de données, hyperparamètres, durée), les gains mesurés sur des benchmarks de raisonnement, et comparons avec
Unsloth vs Axolotl sur DGX Spark : duel des géants du fine-tuning local en 2026
Comparatif technique approfondi entre Unsloth et Axolotl pour le fine-tuning QLoRA de LLMs sur NVIDIA DGX Spark. L’article analyse les performances (vitesse d’entraînement, consommation mémoire), la facilité d’installation, la compatibilité avec les modèles récents (Llama 3, Qwen, DeepSeek) et les f
Deux DGX Spark en cluster : mythe ou réalité ? Décryptage des premiers retours d’expérience
Cet article décrypte les premières expériences concrètes de clustering de deux DGX Spark, une configuration qui promet de faire tourner des LLM de 70B paramètres localement. À partir de retours d’utilisateurs ayant réussi à mettre en place un cluster NCCL multi-node sans compilation host, nous analy
DGX Spark en entreprise : Progress Chef transforme le plus petit supercalculateur IA en outil industriel
L’annonce récente de Progress Chef Enterprise Management pour NVIDIA DGX Spark marque un tournant dans l’adoption professionnelle de ces machines. Ce dossier explore en profondeur comment ce logiciel d’automatisation et de gestion d’infrastructure permet de déployer, configurer et superviser des clu
vLLM sur DGX Spark : l’inférence locale de LLM entre dans une nouvelle ère
En juin 2026, vLLM a publié un support natif et optimisé pour le NVIDIA DGX Spark, marquant un tournant pour l’inférence locale de LLM open source. Cet article décrypte en profondeur l’architecture du backend vLLM sur la puce GB10 Grace Blackwell, l’exploitation du nouveau format NVFP4, et les gains
Nemotron Nano sur DGX Spark : le fine-tuning LoRA décrypté – promesses, réalités et mode d’emploi
Nvidia a dévoilé Nemotron Nano, un modèle open-weight conçu pour tourner efficacement sur le DGX Spark. Cet article décrypte en profondeur comment réaliser un fine-tuning LoRA de Nemotron Nano sur cette machine : installation, configuration, choix des hyperparamètres, performances observées (vitesse
TensorRT-LLM sur DGX Spark : comment décupler les performances d’inférence des LLMs open-source
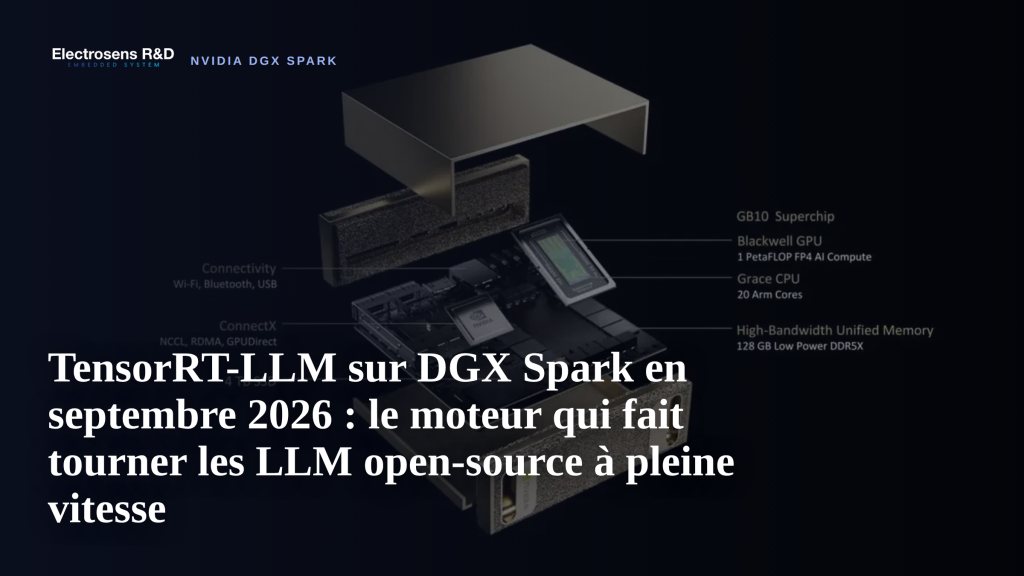
Ce dossier explore en profondeur l’optimisation de l’inférence des LLMs open-source sur le NVIDIA DGX Spark grâce à TensorRT-LLM et Triton Inference Server. Nous détaillerons le pipeline de compilation, les gains de performance mesurés (latence, throughput, mémoire), les modèles compatibles (Llama 3
Agents IA sur cluster DGX Spark : le guide complet avec Kubernetes
Cet article explore en profondeur l’utilisation de Kubernetes pour orchestrer des agents d’intelligence artificielle sur un cluster de DGX Spark. Alors que la puissance individuelle du DGX Spark est impressionnante, la mise en cluster via Kubernetes ouvre la voie à des applications multi-agents, des
Apple M5 Max vs NVIDIA DGX Spark : le choc des titans pour l’IA locale en 2026
Cet article propose un comparatif approfondi entre l’Apple M5 Max et le NVIDIA DGX Spark, deux machines de pointe pour exécuter des LLM open source en local. Nous analyserons leurs performances brutes d’inférence (vitesse, mémoire, latence), leur capacité à faire du fine-tuning (LoRA, QLoRA, full FT