
 NVIDIA DGX Spark · 9 September 2026
DGX Spark en septembre 2026 : Nemotron 3, DeepSeek V4 Flash, Qwen3.8-27B et l’écosystème open-source qui explose
Le DGX Spark, ce mini‑supercalculateur signé Nvidia, promet de mettre le fine‑tuning de grands modèles à la portée d’un seul bureau. Avec l’arrivée de Nemotron 3 Nano (30B MoE) en avril 2026, puis de Laguna S 2.1 (118B‑A8,5B) le 21 juillet 2026, d’Ant Ling‑3.0‑Flash (124B‑A5B) le 23 juillet, de DeepSeek V4 Flash‑0731 (284B‑A13B) le 31 juillet, et désormais de Qwen3.8‑27B en août, l’écosystème open‑weight n’a jamais été aussi riche. Entre premiers tests indépendants, mise à jour logicielle de juin 2026 (NVFP4, clustering 4 nœuds, NemoClaw), optimisations de septembre 2026 et tutoriels concrets, plongeons dans les entrailles du fine‑tuning local le plus ambitieux de l’année.
Le DGX Spark, un an et demi après : la promesse tenue, et amplifiée
En mars 2025, Nvidia dévoilait le DGX Spark lors de la GTC : un mini PC à 3 999 $, embarquant l’architecture Grace Blackwell (CPU Grace + GPU Blackwell), 128 Go de mémoire unifiée et 4 To de stockage NVMe. L’ambition ? Offrir une station de travail IA capable de faire tourner des modèles à plusieurs centaines de milliards de paramètres – le tout sur un bureau, sans recourir au cloud.
Un an et demi plus tard, le constat est sans appel : la machine tient ses promesses, et l’écosystème logiciel a considérablement mûri. La mise à jour de juin 2026 a apporté trois piliers majeurs :
- NVFP4 : format de quantification propriétaire 4 bits qui défie FP8, réduisant l’empreinte mémoire des poids de moitié. Il est désormais supporté nativement par les principaux runtimes (vLLM, TensorRT‑LLM) et par les poids de Laguna S 2.1, DeepSeek V4 Flash, Nemotron 3 et Qwen3.8‑27B. Selon le blog NVIDIA, l’architecture Blackwell permet de compresser les modèles d’IA jusqu’à 70 % et d’augmenter les performances sans perdre l’intelligence.
- NemoClaw : agent de sécurité et d’optimisation qui gère les ressources en temps réel. Comme le détaille le blog NVIDIA, NemoClaw orchestre l’exécution d’agents IA locaux sur les RTX PCs et les DGX Spark, en surveillant la consommation mémoire, le cache KV et la latence.
- Clustering 4 nœuds : possibilité de connecter jusqu’à 4 DGX Spark en cluster pour des charges de travail plus lourdes (fine‑tuning distribué, inférence parallélisée). Le guide de déploiement officiel de Nemotron 3 Ultra décrit précisément cette configuration avec vLLM, tensor parallelism, réseau RoCE et décodage spéculatif MTP (SparkDeploymentGuide).
En septembre 2026, Nvidia a encore simplifié l’accès à l’IA locale sur ses GPU, y compris le DGX Spark. Comme le rapporte Wccftech le 3 septembre, la firme apporte des optimisations supplémentaires à vLLM et llama.cpp, et étend le support local aux GPU avec 24+ Go de VRAM – une aubaine pour les utilisateurs de RTX qui veulent reproduire l’expérience Spark sur du matériel plus classique.
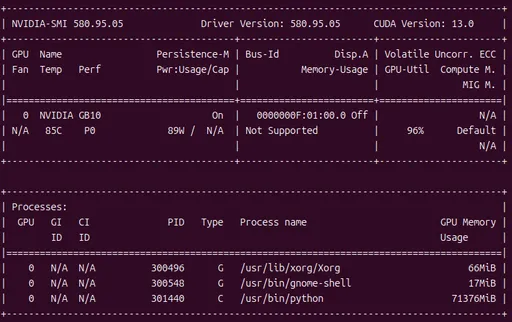
Côté matériel, les tests indépendants confirment les spécifications. Un test réalisé en novembre 2025 sur un DGX Spark Dell (source : mikihands.com) a permis de fine‑tuner le modèle FLUX 1‑dev (12 milliards de paramètres) avec LoRA :
| Paramètre | Valeur observée |
|---|---|
| Mémoire utilisée (continu) | ~71,4 Go |
| Consommation électrique crête | 89–90 W |
| Température stabilisée | 81–86 °C |
| Temps pour 1000 steps (40 images, 1024px) | ~8 heures |
| Temps moyen par étape | ~2,8 secondes |
La bande passante mémoire de 273 Go/s (confirmée par les tests DeepSeek sur les forums NVIDIA et par l’analyse de vLLM) reste l’arme secrète du GB10 : elle permet de charger l’intégralité des poids d’un modèle 30B en FP16 (~60 Go) sans se soucier de la séparation VRAM/RAM. Un benchmark indépendant de devtoolstack.mynewit.com a testé 17 LLM locaux sur GB10, confirmant que la machine excelle sur les modèles jusqu’à ~120B en quantification NVFP4.
Nemotron 3 : la famille complète, du Nano à l’Ultra
Nemotron 3 n’est pas un modèle unique, mais une famille complète, comme le détaille la page officielle NVIDIA Developer. Trois déclinaisons principales, toutes déployables sur DGX Spark :
- Nano (30B‑A3,6B) : le modèle open‑weight pensé pour le DGX Spark, avec une architecture hybride Mamba‑Transformer MoE, 6 experts actifs sur 128, et une fenêtre de contexte native de 1 million de tokens. Il est jusqu’à 4× plus rapide en inférence que Nemotron Nano 2, et jusqu’à 3,3× plus de throughput que des modèles de taille similaire comme Qwen3‑30B ou GPT‑OSS‑20B.
- Nano Omni (30B‑A3B) : version multimodale du Nano, capable de comprendre vidéo, audio, image et texte dans un seul modèle. Idéal pour les agents qui doivent traiter plusieurs modalités.
- Super (120B‑A12B) : le modèle intermédiaire, optimisé pour le raisonnement et l’appel d’outils dans les applications multi‑agents. Les guides de déploiement officiels fournissent des notebooks pour vLLM, SGLang et TensorRT‑LLM sur un seul DGX Spark, avec quantification NVFP4 et décodage spéculatif MTP. Un cookbook dédié couvre le fine‑tuning LoRA Text2SQL sur le benchmark BIRD. Attention toutefois : un test YouTube récent (septembre 2026) intitulé « Nemotron Super 120B isn’t practical on a DGX Spark » suggère que ce modèle, bien que supporté, peut s’avérer peu pratique en usage réel sur un seul nœud – le clustering est recommandé pour exploiter pleinement son potentiel.
- Ultra (550B‑A55B) : le fleuron, conçu pour les workflows d’entreprise les plus exigeants (service client automatisé, chaîne d’approvisionnement, sécurité IT). Avec 55B paramètres actifs, il ne tient pas dans un seul DGX Spark, mais peut être déployé sur un cluster de 4 nœuds – le guide officiel décrit la configuration vLLM avec tensor parallelism et réseau RoCE.
Le rapport technique (arXiv:2512.20848) confirme l’architecture : combinaison de couches Transformer, Mamba 2, attention groupée et routeur perceptron. Seuls 10 % des paramètres sont actifs à chaque token, ce qui réduit d’autant les calculs et les besoins en mémoire lors de l’inférence et du fine‑tuning.
Disponible en open‑weight sur Hugging Face, via NIM microservice sur build.nvidia.com et OpenRouter, Nemotron 3 Nano cible explicitement le déploiement local sur DGX Spark, H100 et B200. La page build.nvidia.com/spark/nemotron propose un playbook complet pour déployer Nano ou Super avec vLLM (vllm/vllm-openai:v0.20.0) en quelques commandes Docker.
Laguna S 2.1 : le roi du codage open‑weight, passé à l’épreuve du terrain
Le 21 juillet 2026, Poolside a publié Laguna S 2.1, un modèle open‑weight de 118 milliards de paramètres (dont 8,5 milliards actifs grâce à une architecture MoE). Les poids sont disponibles sur Hugging Face sous licence permissive OpenMDW‑1.1, dans plusieurs formats de précision : BF16, FP8, INT4 et NVFP4. Ce dernier format est spécialement optimisé pour le DGX Spark et sa mise à jour NVFP4. La couverture de MarkTechPost souligne qu’il s’agit du premier grand modèle open‑weight américain depuis 11 mois, une réponse directe aux avancées chinoises.
Les benchmarks de codage sont impressionnants :
| Modèle | Taille | Terminal‑Bench 2.1 | SWE‑bench Multilingual | SWE‑Bench Pro |
|---|---|---|---|---|
| Laguna S 2.1 | 118B‑A8,5B | 70,2 % | 78,5 % | 59,4 % |
| Laguna M.1 (avril 2026) | 225B‑A23B | 44,9 % | 63,1 % | 49,2 % |
| DeepSeek V4‑Pro Max | 1.6T‑A49B | 64,0 % | 76,2 % | 55,4 % |
| Nemotron 3 Nano | 30B‑A3,6B | ~52 % (estimation) | — | — |
| Claude Sonnet 5 | — | 80,4 % | — | 63,2 % |
| GPT‑5.6 Luna Max | — | 82,5 % | — | — |
Laguna S 2.1 surpasse largement Nemotron 3 Nano sur les tâches de codage, tout en restant dans les limites mémoire du DGX Spark grâce à ses 8,5B actifs. Pour le fine‑tuning, cela signifie qu’on peut adapter un modèle de 118B avec une empreinte mémoire comparable à celle d’un modèle dense de 8B. Les poids en NVFP4 (4 bits) tiennent dans environ 60 Go, laissant 68 Go pour les activations et les adaptateurs LoRA.
Premiers retours terrain : un test indépendant mené par dev.classmethod.jp (publié début août 2026) rapporte des débits réels entre 19 et 50 tok/s selon la configuration (quantification NVFP4, batch size, longueur de séquence). Sur les forums NVIDIA, les utilisateurs confirment que le modèle tourne de manière fluide sur un seul Spark, avec une qualité de code remarquable pour un modèle de cette taille.
DeepSeek V4 Flash‑0731 : le géant qui tient en cluster
Le 31 juillet 2026, DeepSeek a publié la version officielle de son modèle V4 Flash‑0731 : 284 milliards de paramètres au total, 13 milliards actifs par token, une fenêtre de contexte d’un million de tokens, et une licence permissive (MIT). C’est le modèle open‑weight le plus ambitieux jamais conçu pour tourner sur du matériel de bureau.

Le défi mémoire : en quantification Q8 (UD‑Q8_K_XL), les poids occupent 162 Go – trop pour un seul Spark de 128 Go. Même en Q4 (UD‑Q4_K_XL), on atteint 155 Go. La solution ? Le clustering. Sur deux DGX Spark connectés, avec le format NVFP4 et une configuration adaptée du cache KV, les utilisateurs des forums NVIDIA rapportent un débit d’environ 30 tok/s, avec une qualité de réponse restaurée après un petit ajustement de configuration (voir le fil officiel).
C’est exactement le scénario pour lequel le clustering 4 nœuds de la mise à jour de juin 2026 a été conçu. Avec 13B paramètres actifs, DeepSeek V4 Flash‑0731 offre des performances de niveau « frontier » pour les agents IA privés, comme le détaille flowtivity.ai dans son test sur deux Spark avec Hermes Agent. Le blog technique de vLLM confirme que les flags d’inférence doivent être ajustés à la mémoire unifiée : --gpu-memory-utilization doit laisser de la marge pour l’OS, le runtime conteneur et la croissance du cache KV, et --max-num-seqs doit rester bas car le Spark est taillé pour du small‑batch, pas de la forte concurrence.
Un test indépendant mené par emiluzelac (voir DeepWiki) a tenté de faire tourner le modèle sur un seul Spark. Verdict : c’est possible avec une quantification agressive (Q4 ou NVFP4) et en limitant le contexte, mais les performances restent dégradées par rapport à un cluster. Le 1er août 2026, un utilisateur a même rapporté 1 000 tok/s en prefill et 59 tok/s en multi-agent serving sur un seul Spark avec une configuration optimisée (voir fil NVIDIA). Ces chiffres montrent que le GB10 peut faire des merveilles quand on pousse les réglages.
Comparaison avec les autres modèles :
| Modèle | Taille | Actifs | Contexte | Débit sur Spark | Quant. recommandée |
|---|---|---|---|---|---|
| Nemotron 3 Nano | 30B | 3,6B | 1M | ~40‑60 tok/s (est.) | FP16 / NVFP4 |
| Nemotron 3 Super | 120B | 12B | 128K | ~20‑30 tok/s (est.) | NVFP4 |
| Laguna S 2.1 | 118B | 8,5B | 128K | 19‑50 tok/s (testé) | NVFP4 |
| DeepSeek V4 Flash‑0731 | 284B | 13B | 1M | ~30 tok/s sur 2 nœuds | NVFP4 / Q8 |
| Ant Ling‑3.0‑Flash | 124B | 5B | 256K | 15‑20 tok/s (est.) | NVFP4 |
| Qwen3.8‑27B | 27B | dense | 256K | 48 tok/s (testé) | NVFP4 / FP16 |
Ant Ling‑3.0‑Flash : le nouveau challenger
Le 23 juillet 2026, Ant Group a publié Ling‑3.0‑Flash, un modèle de 124B paramètres (dont 5B actifs), qui promet d’être encore plus rapide que Laguna S 2.1 sur un seul Spark. Son architecture hybride combine des couches KDA et MLA dans un ratio 5:1, avec une attention linéaire native. La fenêtre de contexte native est de 256K tokens, extensible à 1M.
Les premiers benchmarks (forums NVIDIA) le placent au‑dessus du précédent modèle 1T d’Ant Group sur presque tous les tests, malgré une taille 8× inférieure. Le débit estimé sur DGX Spark est de 15‑20 tok/s, ce qui en fait une alternative sérieuse pour le codage et les agents. Le fil de discussion officiel indique que le modèle est disponible en NVFP4 et tourne sur un seul Spark sans configuration particulière.
Qwen3.8‑27B : le nouveau champion du rapport qualité/performance
Alibaba a frappé fort en août 2026 avec Qwen3.8‑27B, un modèle dense de 27 milliards de paramètres qui s’impose comme l’un des meilleurs choix pour le DGX Spark. Testé par blog.openzeka.com le 26 août, il atteint 48 tok/s sur un Spark en quantification NVFP4, avec un score de 52 sur l’Artificial Analysis Intelligence Index – le meilleur de sa catégorie parmi les modèles open-weight.
Ce modèle bénéficie d’un support MTP (Multi-Token Prediction) qui accélère encore l’inférence. Le 2 septembre 2026, banandre.com rapportait que le support MTP pour Qwen3.8‑Flash‑Next (une variante) permettait un speedup de 1,67×, passant de 83 à 138 tok/s, sans perte de qualité. Cette technique, également utilisée par Nemotron 3, est devenue un standard sur le Spark.
Pour ceux qui veulent l’essayer, le guide de codersera.com (18 août 2026) explique comment l’exécuter localement avec Ollama, LM Studio ou llama.cpp, avec des tables de VRAM pour GPU 16/24 Go. Sur le Spark, la configuration recommandée est NVFP4 + MTP, comme le confirment les tests de la communauté.
Fine‑tuning avec Unsloth : le guide officiel NVIDIA
Nvidia a publié un guide officiel de fine‑tuning sur DGX Spark avec Unsloth, l’un des frameworks open‑source les plus utilisés pour le fine‑tuning de LLM. Le blog met en avant trois méthodes principales :
- Parameter‑efficient fine‑tuning (LoRA / QLoRA) : met à jour seulement une petite portion du modèle. Recommandé pour ajouter des connaissances de domaine, améliorer la précision de codage, adapter le modèle à des tâches légales ou scientifiques, ou affiner le raisonnement. Nécessite un dataset de 100 à 1 000 paires prompt‑réponse.
- Full fine‑tuning : met à jour tous les paramètres. Utile pour enseigner au modèle des formats ou styles spécifiques, notamment pour construire des agents et des chatbots.
- Instruction tuning / RLHF : pour aligner le comportement du modèle sur des préférences humaines.
Le guide détaille aussi l’installation et l’utilisation d’Unsloth sur le Spark, avec des exemples de code pour LoRA sur Nemotron 3 Nano et Laguna S 2.1. La page DeepWiki consacrée au fine-tuning sur DGX Spark confirme que la plateforme supporte nativement LoRA, QLoRA et le full fine-tune en BF16, grâce à la mémoire unifiée de 128 Go.
Clusters DGX Spark : l’art de faire travailler plusieurs machines ensemble
Le clustering est devenu un sujet central en 2026. NVIDIA a officialisé le support de 4 nœuds en juin, mais la communauté a rapidement poussé plus loin. Le guide sojufx/DGX-Spark-LLM-Field-Guide sur GitHub compile les meilleures pratiques pour monter un cluster : configuration réseau (ConnectX‑7 100 GbE, ou 10GbE pour les configurations économiques), installation de Kubernetes avec le GPU Operator, et déploiement de vLLM en tensor parallelism.
Les benchmarks réels montrent des gains significatifs : sur 2 nœuds, DeepSeek V4 Flash‑0731 atteint ~30 tok/s (contre ~15 sur un seul nœud en Q4), et sur 4 nœuds, Nemotron 3 Super devient utilisable en conditions réelles. Le blog 3DVF rappelle que la connectivité NVIDIA ConnectX permet d’interconnecter deux systèmes pour des modèles jusqu’à 405 milliards de paramètres – une capacité que le clustering 4 nœuds étend encore.
Pour les utilisateurs avancés, le guide de déploiement de Nemotron 3 Ultra (voir plus haut) fournit une configuration de référence avec vLLM, RoCE et décodage spéculatif MTP. Les forums NVIDIA regorgent d’exemples concrets, comme ce test d’agent serving sur 2× DGX Spark avec DeepSeek V4 Flash (voir fil du 2 août).
Logiciels et runtimes : la guerre fait rage, et tout le monde gagne
Le DGX Spark supporte désormais une multitude de runtimes, chacun avec ses forces :
- vLLM : le plus mature, avec un support NVFP4 et MTP excellent. Le blog vLLM détaille les optimisations spécifiques au Spark.
- TensorRT‑LLM : le moteur maison de NVIDIA, qui compile les modèles en plans optimisés. Un article du magazine (septembre 2026) liste les modèles supportés officiellement et les benchmarks de la Spark Arena.
- llama.cpp : le champion de la simplicité, avec un support GGUF et MTP récemment ajouté (voir banandre pour Qwen3.8‑Flash‑Next).
- SGLang : de plus en plus utilisé pour les agents, avec un support natif du Spark.
- Uzu : un nouveau venu qui propose du speculative decoding pour Qwen3.6 27B, avec des performances supérieures à MTPLX sur les puces Apple M5 (voir trymirai.com).
En septembre 2026, NVIDIA a annoncé de nouvelles optimisations pour vLLM et llama.cpp sur ses GPU, y compris le Spark (voir Wccftech). Ces améliorations concernent notamment la gestion de la mémoire unifiée et le support de nouveaux formats de quantification.
Comparatif avec la concurrence : le Spark face au Mac et aux PC
Le DGX Spark n’est plus seul sur le marché des stations IA locales. AMD a lancé le Ryzen AI Halo (Strix Halo) à 3 999 $, avec 128 Go LPDDR5X et 256 Go/s de bande passante – légèrement inférieur au Spark (273 Go/s). Un comparatif de septembre 2026 (voir blog.lalatendu.info) montre que le Spark reste supérieur pour le fine-tuning grâce à CUDA et à l’écosystème NVIDIA, mais le Halo offre un meilleur rapport performance/prix pour l’inférence pure.
Apple, de son côté, a vu ses Mac mini et Mac Studio être massivement achetés par OpenAI et Anthropic pour l’entraînement (voir Frandroid du 31 août 2026). Mais pour les développeurs open-source, le Spark reste la référence grâce à sa compatibilité CUDA et à son support logiciel inégalé.
Conclusion : 2026, l’année où l’IA locale est devenue une réalité
Le DGX Spark a tenu ses promesses, et l’écosystème open-source qui l’entoure n’a jamais été aussi dynamique. Entre Nemotron 3, Laguna S 2.1, DeepSeek V4 Flash, Ant Ling, Qwen3.8 et les nombreux autres modèles disponibles, les développeurs ont l’embarras du choix pour construire des agents IA privés, fine-tuner des modèles sur mesure, ou simplement explorer les limites du matériel de bureau.
Les mises à jour logicielles de juin et septembre 2026 ont considérablement amélioré l’expérience : NVFP4, clustering 4 nœuds, NemoClaw, optimisations vLLM/llama.cpp, support MTP… Le Spark n’est plus un simple jouet pour passionnés, mais une véritable plateforme de développement professionnelle.
Reste à surveiller : l’arrivée des mini-PC concurrents (Acer, Gigabyte) prévue pour début 2027, et les prochains modèles open-weight qui ne manqueront pas de repousser les limites de ce que peut faire une machine de bureau.
Sources
- NVIDIA DGX Spark – Page officielle
- NVIDIA Blog – DGX Spark et Station pour les modèles open-source
- Wccftech – NVIDIA simplifie l’IA locale sur GPU (3 sept 2026)
- OpenZeka – Qwen3.8-27B sur DGX Spark (26 août 2026)
- Banandre – Qwen3.8-Flash-Next MTP (2 sept 2026)
- TryMirai – Speculative decoding dans Uzu (3 sept 2026)
- MarkTechPost – Laguna S 2.1 (21 juillet 2026)
- Forums NVIDIA – DeepSeek V4 Flash sur 2× DGX Spark
- Forums NVIDIA – 1× Spark, 1000 tok/s prefill
- Flowtivity – DeepSeek V4 Flash sur 2 Spark
- vLLM Blog – DGX Spark optimizations
- DeepWiki – Fine-tuning sur DGX Spark
- DeepWiki – DeepSeek V4 Flash sur un seul Spark
- GitHub – DGX Spark LLM Field Guide
- 3DVF – Fiche produit DGX Spark
- DevToolStack – Benchmark 17 LLM sur GB10
- Codersera – Guide Qwen3.8 local (18 août 2026)
- Frandroid – OpenAI et Anthropic achètent des Mac mini (31 août 2026)
- Lalatendu – DGX Spark vs RTX 5090 (23 juillet 2026)
Article recherché et rédigé automatiquement · Magazine Electrosens