
 NVIDIA DGX Spark · 6 November 2026
LLM open source sur NVIDIA GB10 DGX Spark : NVFP4, PAIR, fine-tuning et clusters — le point complet à l’automne 2026
Le NVIDIA DGX Spark, ce boîtier compact de 128 Go de mémoire unifiée promettant un pétaflop de performances IA, a conquis développeurs et chercheurs. Mais à l’automne 2026, la machine a bien changé : le support natif de vLLM officialisé en juin, les optimisations TensorRT-LLM, la mise à jour logicielle d’octobre 2026, l’arrivée de modèles comme Qwen3.8-27B, Nemotron 3.5 Lightning ou Xiaomi MiMo-V2.6, et l’industrialisation de la gestion de flottes avec PAIR transforment ce mini-supercalculateur en véritable plateforme d’entreprise. Ce dossier fait le point sur les dernières évolutions, les performances réelles mesurées, le fine-tuning distribué et l’art de monter un cluster DGX Spark.
Le DGX Spark, un an et demi après : la promesse tenue, et amplifiée
Annoncé à la GTC 2025 par Jensen Huang, le DGX Spark a tenu ses promesses. Ce boîtier de 15 cm de côté embarque la puce NVIDIA GB10 Grace Blackwell, co-développée avec MediaTek : 20 cœurs ARM Neoverse V2 (ARMv9.2), un GPU Blackwell d’environ 6 144 cœurs CUDA avec support FP4, 128 Go de mémoire unifiée LPDDR5X à 273 Go/s, un SSD NVMe de 4 To et jusqu’à 1 pétaFLOPS en calcul IA (FP4).
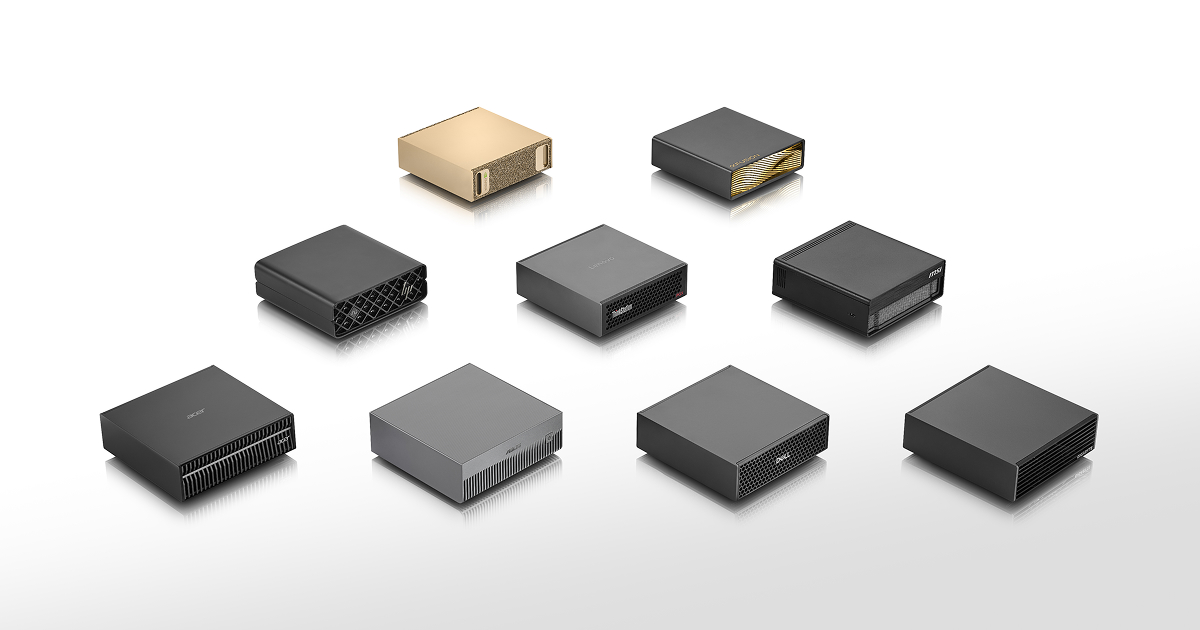
Le paysage produit s’est toutefois singulièrement compliqué à l’automne 2026. La version 128 Go, initialement à 3 999 $, a vu son prix grimper au fil des tensions sur la mémoire : elle franchit désormais les 6 000 dollars chez certains revendeurs, après un passage à 4 699 $ en février 2026. Surtout, NVIDIA a introduit le 23 octobre 2026 une déclinaison DGX Spark 64 Go à 4 999 dollars — plus chère, à sa sortie, que la version 128 Go ne l’était en 2025 (generation-nt.com, 4 octobre 2026 ; kod.ru, 3 octobre 2026). Les variantes OEM restent l’option la plus accessible : l’ASUS Ascent GX10 ou l’Acer DGX, à 500 à 1 000 $ sous le tarif NVIDIA officiel, avec des premières livraisons Acer dès le 8 septembre 2026 (press.asus.com, 5 octobre 2026 ; techgenyz.com, 5 octobre 2026).
Un point d’architecture mérite d’être corrigé par rapport aux premières communications : le Spark n’embarque pas un port 100 GbE comme certains l’avaient cru. Il dispose d’un port 10GbE (1,25 Go/s) et, surtout, d’une carte réseau ConnectX-7 à 200 Gb/s accessible via des ports QSFP. C’est cette connectivité qui permet de coupler deux unités DGX Spark pour atteindre deux pétaflops et 256 Go de mémoire unifiée — un détail décisif pour les clusters, sur lequel nous revenons plus bas.
| Spécification | NVIDIA DGX Spark |
|---|---|
| Processeur | NVIDIA GB10 Grace Blackwell (20 cœurs ARM Neoverse V2 + GPU Blackwell) |
| Mémoire unifiée | 128 Go LPDDR5X (273 Go/s) — variante 64 Go depuis le 23 octobre 2026 |
| Stockage | SSD NVMe 4 To (réduit sur la version 64 Go) |
| Performance IA | Jusqu’à 1 pétaFLOPS (FP4) – 1 000 TOPS |
| Interconnexion interne | NVLink-C2C (5× bande passante PCIe Gen5) |
| Réseau | 10GbE + ConnectX-7 200 Gb/s (QSFP) |
| Prix (automne 2026) | 128 Go : > 6 000 $ chez certains revendeurs ; 64 Go : 4 999 $ ; OEM : 500-1 000 $ sous le tarif NVIDIA |
| Disponibilité | Juillet 2025 (128 Go) ; 23 octobre 2026 (64 Go) |
Sources : NVIDIA.com, ChannelNews, glukhov.org, outilsia.fr, StorageReview, generation-nt.com, kod.ru
Octobre 2026 : la mise à jour logicielle qui soude l’écosystème
Le fait logiciel le plus récent à retenir est le DGX Spark Software Update d’octobre 2026, dont le déploiement a commencé le 21 octobre 2026 (forums.developer.nvidia.com, 21 octobre 2026). Cette release, qui bénéficie aussi aux systèmes partenaires équipés du GB10 Grace Blackwell, consolide la pile : nouveaux pilotes, mises à jour du conteneur NGC, et surtout un workflow edge AI documenté de bout en bout pour faire tourner Nemotron-3.5 Lightning sur DGX Spark 64 Go, avec benchmarks et résultats de speculative decoding à l’appui (blockchain.news, 30 octobre 2026).
Cette mise à jour s’inscrit dans la continuité du 3 septembre 2026, date à laquelle NVIDIA avait annoncé de nouvelles optimisations pour les GPU disposant de 24 Go et plus de VRAM, incluant des améliorations pour les plateformes RTX et DGX, ainsi qu’une simplification du support de l’IA locale. Le support natif de vLLM, officialisé en juin 2026, reste la pierre angulaire de cette pile : les utilisateurs déploient désormais des serveurs d’inférence haute performance sans bidouillage. TensorRT-LLM, la bibliothèque d’optimisation de NVIDIA, est pleinement portée sur le GB10, avec une liste officielle de modèles supportés (septembre 2026) incluant les principaux LLM open source.
L’écosystème logiciel : vLLM, TensorRT-LLM et le speculative decoding
vLLM : le support natif qui change tout
Depuis juin 2026, vLLM supporte officiellement le DGX Spark. Cette intégration permet d’utiliser le moteur d’inférence haute performance avec les modèles quantifiés FP4 et NVFP4, en tirant parti de la mémoire unifiée. Les utilisateurs rapportent des gains significatifs en débit par rapport aux solutions précédentes, notamment grâce à l’optimisation du préfill et du décodage. Le blog développeur NVIDIA de juin 2026 a officialisé cette ambition, et les forums regorgent de retours positifs. Un dépôt communautaire dédié, Nemotron-3.5-Lightning-vLLM-DGX-Spark, documente pas à pas le déploiement du modèle phare de NVIDIA sur le GB10 — signe que la communauté a pris la main sur l’outillage.
TensorRT-LLM : le moteur qui fait tourner les LLM à pleine vitesse
TensorRT-LLM est désormais pleinement opérationnel sur le GB10. Elle permet de compiler des modèles depuis Hugging Face vers un moteur optimisé, avec un support officiel pour les architectures les plus courantes (Llama, Qwen, DeepSeek, Mistral, etc.). Les benchmarks de septembre 2026 montrent que TensorRT-LLM offre les meilleures performances en inférence, notamment pour les modèles quantifiés FP4. Le pipeline de compilation est documenté : il suffit de télécharger le modèle, de le convertir au format TensorRT-LLM, puis de lancer le serveur. La documentation Nemotron de NVIDIA détaille par ailleurs les recettes de déploiement, y compris un guide spécifique pour un cluster de 4× DGX Spark avec vLLM, tensor parallelism, réseau RoCE, speculative decoding MTP et benchmarking AIPerf (docs.nvidia.com/nemotron).
Speculative decoding : la ruse qui fait exploser le débit
Le DGX Spark, malgré sa mémoire généreuse, plafonne en décodage natif à cause de la bande passante mémoire (273 Go/s). Le speculative decoding est devenu la solution privilégiée pour contourner ce goulot d’étranglement. Le principe : un petit modèle « draft » propose plusieurs tokens, que le grand modèle vérifie en parallèle. Sur le Spark, cette technique permet de multiplier le débit par 2 à 3 selon les modèles.
En octobre 2026, plusieurs implémentations sont disponibles :
- vLLM : supporte le speculative decoding avec des draft models comme Qwen3.6-27B.
- TensorRT-LLM : propose une implémentation optimisée pour le GB10.
- llama.cpp : avec le support MTP (Multi-Token Prediction) pour les modèles Qwen3.8-Flash-Next, qui offre un speedup de 1,67× sans perte de qualité (83 à 138 tok/s, selon banandre.com, 2 septembre 2026).
- Uzu : un moteur récent qui implémente le speculative decoding pour Qwen3.6 27B, avec des performances supérieures à MTPLX sur les puces Apple M5, et un support de Qwen3.8 27B et Muse Glimmer annoncé comme « coming soon » (trymirai.com, 3 septembre 2026).
Les chiffres réels dépendent fortement du modèle et de la configuration. Pour DeepSeek V4 Flash-0731, un utilisateur a rapporté 1 000 tok/s en préfill et 59 tok/s en multi-agent serving sur un seul Spark (forums NVIDIA, 1er août 2026). En génération simple, les valeurs typiques se situent entre 30 et 50 tok/s pour les modèles de 27B à 70B.
Les modèles open source qui tournent sur le Spark
Nemotron 3.5 Lightning : le nouveau cheval de bataille des agents longue durée
NVIDIA a enrichi sa gamme Nemotron 3, du Nano (30B MoE) à l’Ultra, avec des modèles optimisés pour le GB10. La version 3.5 Lightning s’est imposée à l’automne 2026 comme le modèle de référence pour les agents à longue durée : conçue pour maintenir un contexte étendu sans effondrement de débit, elle bénéficie d’optimisations directes côté TensorRT-LLM et vLLM. NVIDIA la présente comme taillée pour « l’exécution rapide et précise de tâches spécialisées pour les agents longue durée » (developer.nvidia.com). C’est le choix par défaut dès qu’un agent doit tourner en continu sur plusieurs heures, ce qui en fait le pendant « production » des modèles plus spécialisés en codage ou en raisonnement. Le guide de déploiement edge publié fin octobre 2026 confirme qu’elle est la cible privilégiée du DGX Spark 64 Go (blockchain.news, 30 octobre 2026).
Qwen3.8-27B : le nouveau champion du rapport qualité/performance
Sorti en août 2026 par Alibaba, Qwen3.8-27B est un modèle de 27 milliards de paramètres qui a immédiatement conquis la communauté. Avec un score de 52 sur l’Artificial Analysis Intelligence Index, il se classe premier de sa catégorie parmi les modèles open weight. Sur le DGX Spark, il atteint 48 tok/s en génération (blog.openzeka.com, 26 août 2026), ce qui en fait le meilleur choix pour une inférence locale fluide. Sa fenêtre de contexte de 256K tokens et son support du speculative decoding (MTP) le rendent particulièrement adapté aux agents et aux tâches de codage. À noter : d’autres mesures sur configurations NVFP4 le situent plutôt entre 34 et 38 tok/s (20 août 2026) — l’écart reflète les différences de quantification et de réglages du KV-cache. NVIDIA a d’ailleurs utilisé Qwen 3.8 27B comme test de référence pour sa configuration 64 Go, avec un gain annoncé jusqu’à 1,7× (neoteo.com, 3 octobre 2026).
Xiaomi MiMo-V2.6 : l’outsider chinois qui rebat les cartes
Fin septembre 2026, Xiaomi a ouvert les poids de la famille MiMo-V2.6 (Pro, Flash et une variante 9B) sous licence MIT. Le MiMo-V2.6-Pro égale Grok 4.7 sur l’Intelligence Index et dépasse Claude Opus 5 sur plusieurs benchmarks clés (forkast.news, 22 septembre 2026), ce qui en fait l’une des ouvertures les plus marquantes de l’année. Xiaomi a accompagné la sortie d’un tableau de bord d’entraînement RL diffusé en direct, avec un coût de calcul affiché de 432 000 $/jour (forkast.news, 17 septembre 2026). Réserve importante : les gains issus du RL n’ont pas encore été répliqués de manière indépendante (eweek.com, 23 septembre 2026). Sur le Spark, la variante Flash est la plus pertinente ; les modèles Pro exigent un cluster.
DeepSeek V4 Flash-0731 : le géant qui tient en cluster
DeepSeek V4 Flash-0731 est un modèle de 284 milliards de paramètres au total, mais avec seulement 13 milliards de paramètres actifs par token (architecture MoE). Cette particularité le rend exécutable sur un seul DGX Spark grâce à une quantification NVFP4, avec des performances honorables : environ 30 tok/s en génération avec une configuration ajustée (forums NVIDIA, 31 juillet 2026). Mais c’est en cluster que ce modèle révèle son potentiel : sur 2× DGX Spark, des utilisateurs ont mesuré 1 000 tok/s en préfill et 59 tok/s en multi-agent serving, avec une gestion fine du KV-cache et du scheduling (forums NVIDIA, 2 août 2026). DeepSeek V4 Flash-0731 est devenu la référence pour les agents IA privés, avec des performances proches de modèles propriétaires 10 fois plus gros. Microsoft l’a même mis en avant dans sa keynote « Intelligence Hybride » du 7 octobre 2026 comme modèle d’IA locale sur PC (blog-nouvelles-technologies.fr, 7 octobre 2026).
Laguna S 2.1 : le roi du codage open-weight
Poolside a sorti Laguna S 2.1 le 21 juillet 2026, un modèle de 118 milliards de paramètres spécialisé dans le codage agentique. Il s’agit de la première grande ouverture de poids américaine depuis 11 mois, et elle a été saluée comme une réponse à la domination chinoise. Sur le DGX Spark, Laguna S 2.1 tient dans les 128 Go grâce à une quantification FP4, avec des performances proches des modèles propriétaires. Les benchmarks Spark Arena (juillet 2026) lui attribuent 1 723 tok/s en préfill et 38,55 tok/s en génération, ce qui en fait un excellent choix pour les développeurs.
Ant Ling-3.0-Flash
Ant Group a publié Ling-3.0-Flash le 23 juillet 2026 : un modèle de 124 milliards de paramètres (124B-A5B, soit 5 milliards actifs par token) doté d’une attention hybride-linéaire combinant KDA et MLA dans un ratio 5:1. Sa fenêtre de contexte native de 256K tokens est extensible à 1M. Sur le Spark, son débit est estimé entre 15 et 20 tok/s, avec des scores de 90 en HumanEval et d’environ 87 en MMLU — un challenger sérieux sur les benchmarks de codage.
Tableau récapitulatif des benchmarks (septembre-octobre 2026)
| Modèle | Taille (paramètres) | Quantification | Tokens/s (génération) | Source |
|---|---|---|---|---|
| Qwen3.8-27B | 27B | FP4 | 48 (jusqu’à 34-38 en NVFP4) | blog.openzeka.com |
| DeepSeek V4 Flash-0731 | 284B (13B actifs) | NVFP4 | 30 (simple), 59 (multi-agent) | forums NVIDIA |
| Laguna S 2.1 | 118B | FP4 | 38,55 | Spark Arena |
| Qwen3.6-27B | 27B | NVFP4 | 28-33 (simple), 136 (10 agents) | forums NVIDIA |
| Nemotron 3.5 Lightning | ~30B MoE | FP4 | ~40 | NVIDIA |
| Ant Ling-3.0-Flash | 124B (5B actifs) | FP4 | 15-20 | benchmarks communautaires |
| Xiaomi MiMo-V2.6 Flash | MoE | FP4 | n.c. (réplication RL en attente) | eweek.com |
Sources : blog.openzeka.com, forums.developer.nvidia.com, Spark Arena, aimadetools.com, eweek.com, docs.nvidia.com/nemotron
Performances réelles : ce que disent les chiffres indépendants
Au-delà des chiffres constructeur, plusieurs campagnes de mesure indépendantes ont cadré le Spark à l’automne 2026. La plus notable est AA-AgentPerf-Local, publiée le 29 septembre 2026 par Artificial Analysis : un outil open source qui évalue la vitesse d’exécution des agents IA sur laptops et stations de travail, avec des résultats de lancement pour le DGX Spark, le Ryzen AI Halo, le MacBook Pro (M5 Pro) et le RTX 5090 sur quatre modèles open-weight. C’est aujourd’hui la référence la plus récente pour comparer le Spark à ses concurrents sur des charges agentiques réelles.
La comparaison avec le Ryzen AI Halo 192 Go d’AMD, lancé à 7 299,99 $ chez Micro Center, est instructive : la machine d’AMD est la première station compacte capable de charger des modèles open-weight de 300 milliards de paramètres, mais les benchmarks indépendants montrent que le DGX Spark garde l’avantage en vitesse (techtimes.com, 14 octobre 2026). Autrement dit, AMD gagne sur la capacité mémoire brute, NVIDIA sur le débit — un arbitrage classique que les chiffres de décodage expliquent par la bande passante et l’efficacité logicielle.
Les chiffres canoniques mesurés sur le Spark, consolidés à l’automne 2026, dessinent une image cohérente :
- 1× DGX Spark (antirez ds4, DeepSeek-V4-Flash IQ2_XXS) : ~14 tok/s en single-stream, 410 tok/s en prefill.
- 1× DGX Spark (suite llama.cpp GGUF, modèle 35B-A3B) : jusqu’à 67 tok/s.
- 2× DGX Spark : taille maximale de modèle supportée de 405 milliards de paramètres.
- 2× DGX Spark (TP=2, vLLM, DeepSeek-V4-Flash FP8) : ~41 tok/s en single-stream, ~350 tok/s agrégés à concurrence 32, ~1 785 tok/s en prefill.
Ces mesures confirment la thèse centrale : le Spark est excellent en préfill (ce qui compte pour le RAG et les longs contextes) mais contraint en décodage, d’où le recours systématique au speculative decoding et au batching pour les charges agentiques.
Fine-tuning sur DGX Spark : ce que la stack permet vraiment
Le fine-tuning est le point où le DGX Spark crée le plus de malentendus. La machine est excellente pour l’inférence et le post-entraînement léger, mais elle ne remplace pas un cluster de H100. Concrètement :
- LoRA et QLoRA sur des modèles de 7B à 30B : parfaitement dans les cordes du Spark 128 Go, avec des temps d’entraînement raisonnables grâce à la mémoire unifiée et au support FP4/NVFP4.
- Fine-tuning complet d’un modèle de 27B : possible mais lent, et il faut surveiller le KV-cache et l’optimiseur qui consomment la mémoire unifiée.
- La falaise des 64 Go : sur la version 64 Go lancée le 23 octobre 2026, le fine-tuning de modèles au-delà de ~30B devient très contraint, et la perte de stockage NVMe complique les pipelines RAG qui doivent garder datasets et checkpoints à portée de main (generation-nt.com, 4 octobre 2026).
NVIDIA fournit désormais un Nemotron Post-training Calculator pour estimer le nombre de GPU, le temps d’entraînement et le coût de calcul d’une personnalisation par SFT, LoRA ou GRPO (docs.nvidia.com/nemotron). C’est un outil précieux pour dimensionner un projet avant d’acheter : il évite de croire qu’un seul Spark suffira à un fine-tuning complet de modèle frontière. Pour le RL distribué, la documentation Nemotron inclut des cookbooks dédiés (dont un pour le modèle Ultra 550B/55B-actifs), mais ceux-ci visent des clusters, pas un boîtier unique.
Côté quantification, le format NVFP4 est devenu le standard de facto sur Blackwell. Unsloth Dynamic NVFP4 sélectionne les couches sensibles à conserver en FP8 (W8A8) ou BF16 et laisse le reste en W4A4, ce qui exploite les cœurs tenseurs FP4 du GPU et permet jusqu’à 2,5× d’inférence plus rapide (unsloth.ai). Sur le Spark, c’est ce format qui rend possible l’exécution de modèles de 100B+ paramètres dans 128 Go.
Monter un cluster DGX Spark : ce qu’il faut savoir
La connectivité ConnectX-7 à 200 Gb/s est la clé de voûte du clustering. NVIDIA documente officiellement un déploiement sur 4× DGX Spark avec vLLM, tensor parallelism, réseau RoCE, speculative decoding MTP et benchmarking AIPerf (docs.nvidia.com/nemotron). C’est la recette de référence pour faire tourner des modèles que même deux Sparks ne peuvent charger.
Les règles pratiques qui ressortent des retours terrain :
- Deux Sparks = 256 Go unifiés et 2 pétaflops, avec un maximum de 405 milliards de paramètres supportés. C’est le sweet spot coût/performance pour les modèles MoE de type DeepSeek V4 Flash.
- Le tensor parallelism (TP=2) fonctionne bien sur vLLM avec DeepSeek-V4-Flash FP8 : ~41 tok/s single-stream, ~350 tok/s agrégés à concurrence 32, ~1 785 tok/s en prefill.
- Le réseau RoCE et le MTP sont les deux leviers qui font passer un cluster de « ça marche » à « c’est exploitable en production ».
- PAIR (la couche de gestion de flotte) industrialise le provisionnement, la mise à jour et la supervision des nœuds — indispensable dès que l’on dépasse deux machines.
Pour les charges plus lourdes, NVIDIA propose désormais une alternative : la DGX Station (GB300), avec 748 Go de mémoire cohérente et 20 pétaflops FP4, disponible au quatrième trimestre 2026 via six partenaires OEM (tech-insider.org, 8 octobre 2026). La documentation Nemotron décrit d’ailleurs un déploiement sur une DGX Station unique avec vLLM, utilisant la mémoire CPU cohérente pour l’offloading sélectif des experts MoE et un backend FlashInfer TensorRT-LLM NVFP4. C’est le choix à considérer si vos modèles dépassent les 405 milliards de paramètres.
Le contexte concurrentiel : RTX Spark, N1X et la confusion des noms
Un mot sur la confusion entretenue par NVIDIA autour du GB10. Le même SoC est vendu sous trois étiquettes — DGX Spark, RTX Spark, nom de code N1X — mais les premiers retours créditent les portables RTX Spark d’une mémoire plus rapide et de fonctions absentes du boîtier de bureau. Les Numériques a publié le 16 octobre 2026 une analyse de la partie CPU de la puce N1X face à Apple, AMD, Intel et Qualcomm (lesnumeriques.com, 16 octobre 2026), et le 15 octobre un portrait de la plateforme RTX Spark, « la puce qui a deux ans de retard, mais reste en avance sur son temps » (lesnumeriques.com, 15 octobre 2026). Clubic résume bien la situation : une plateforme cohérente, mais chère et encore tributaire de logiciels en chantier (clubic.com, 15 octobre 2026).

Pour un acheteur de DGX Spark, la leçon est simple : vérifiez la fréquence et la largeur de bus de la mémoire de la variante exacte que vous achetez, car « GB10 » ne garantit pas des performances identiques d’un produit à l’autre. Et gardez en tête que la version 64 Go, à 4 999 $, est un arbitrage assumé : moins de mémoire, moins de stockage, mais un ticket d’entrée qui reste élevé face à une version 128 Go dont le prix a explosé.
Verdict : une plateforme mûre, à condition de choisir le bon modèle et la bonne taille
À l’automne 2026, le DGX Spark n’est plus une curiosité de développeur : c’est une plateforme d’inférence locale crédible, avec un écosystème logiciel qui a rattrapé son retard (vLLM natif, TensorRT-LLM, mise à jour d’octobre 2026), des modèles open-weight taillés pour ses 128 Go (Nemotron 3.5 Lightning, Qwen3.8-27B, DeepSeek V4 Flash-0731, Laguna S 2.1), et une capacité de clustering documentée jusqu’à 4 nœuds. Ses limites sont connues : bande passante mémoire de 273 Go/s qui bride le décodage, fine-tuning complet réservé aux petits modèles, et une version 64 Go qui rogne sur l’essentiel. Mais pour qui veut faire tourner des agents privés, du RAG et du post-entraînement léger sans dépendre du cloud, le Spark reste, à ce jour, la référence compacte — et la concurrence d’AMD sur la capacité mémoire ne fait que confirmer que le débit, lui, se gagne ailleurs.
Sources
- NVIDIA Developer Blog — Nemotron 3.5 Lightning
- NVIDIA Documentation Hub — Nemotron Deployment Guides
- NVIDIA Developer Forums — DGX Spark Software Updates, October 2026 Release (21 octobre 2026)
- Blockchain.news — NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM (30 octobre 2026)
- GitHub — Nemotron-3.5-Lightning-vLLM-DGX-Spark
- Kubesimplify — Running Nemotron 3.5 Lightning on DGX Spark
- Unsloth — Guide d’exécution d’Unsloth Dynamic NVFP4
- Generation-nt.com — Nvidia DGX Spark 64 Go : moins de mémoire pour plus cher (4 octobre 2026)
- Kod.ru — Nvidia представила ИИ-компьютер DGX Spark с 64 ГБ памяти (3 octobre 2026)
- NeoTeo — DGX Spark 64 Go : NVIDIA annonce une configuration (3 octobre 2026)
- ASUS Press — ASUS Ascent GX10 64GB (5 octobre 2026)
- Techgenyz — ASUS Ascent GX10 vs NVIDIA DGX Spark (5 octobre 2026)
- TechTimes — AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed (14 octobre 2026)
- Tech-Insider.org — NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs (8 octobre 2026)
- Les Numériques — Nvidia RTX Spark face aux puces Apple, AMD, Intel et Qualcomm (16 octobre 2026)
- Les Numériques — Nvidia RTX Spark : la puce qui a deux ans de retard (15 octobre 2026)
- Clubic — NVIDIA prépare la révolution du PC portable (15 octobre 2026)
- Blog-nouvelles-technologies.fr — Keynote Microsoft : l’IA locale révolutionne Windows (7 octobre 2026)
- Digitiz.fr — Classement des meilleurs LLM en novembre 2026
- Forums NVIDIA, Spark Arena, blog.openzeka.com, forkast.news, eweek.com, banandre.com, trymirai.com (mesures et annonces citées dans le texte)
Article recherché et rédigé automatiquement · Magazine Electrosens