
 NVIDIA DGX Spark · 5 November 2026
DGX Spark face au MacBook Pro M5 Max : le duel de l’IA locale en 2026 (LLM open source, fine-tuning et clusters)
Deux visions s’affrontent pour faire tourner les LLM open source sans le cloud. D’un côté, le mini-PC NVIDIA DGX Spark, taillé pour l’inférence et le fine-tuning grâce à son GPU Blackwell et son écosystème CUDA mature. De l’autre, le MacBook Pro M5 Max d’Apple, fort de sa bande passante mémoire record et de son intégration logicielle. À l’automne 2026, les benchmarks indépendants et les retours terrain permettent enfin de trancher : lequel choisir quand on veut exécuter DeepSeek V4 Flash-0731, Qwen 3.8, Ant Ling-3.0-Flash ou Poolside Laguna S 2.1 en local — et surtout, comment les faire travailler en cluster ? Plongée au cœur du duel, chiffres à l’appui.
2026, l’année où l’IA locale a deux visages
L’essor des modèles de langage open source a créé un besoin urgent de machines capables de les héberger sans dépendre du cloud. En 2026, deux champions émergent : le NVIDIA DGX Spark, un mini-PC basé sur le Superchip GB10 (annoncé au CES 2025, disponible depuis fin 2025), et le MacBook Pro M5 Max d’Apple, dévoilé au printemps 2026 avec sa nouvelle architecture Fusion. Tous deux promettent d’exécuter localement des modèles de plusieurs dizaines de milliards de paramètres, mais leurs philosophies diffèrent radicalement.
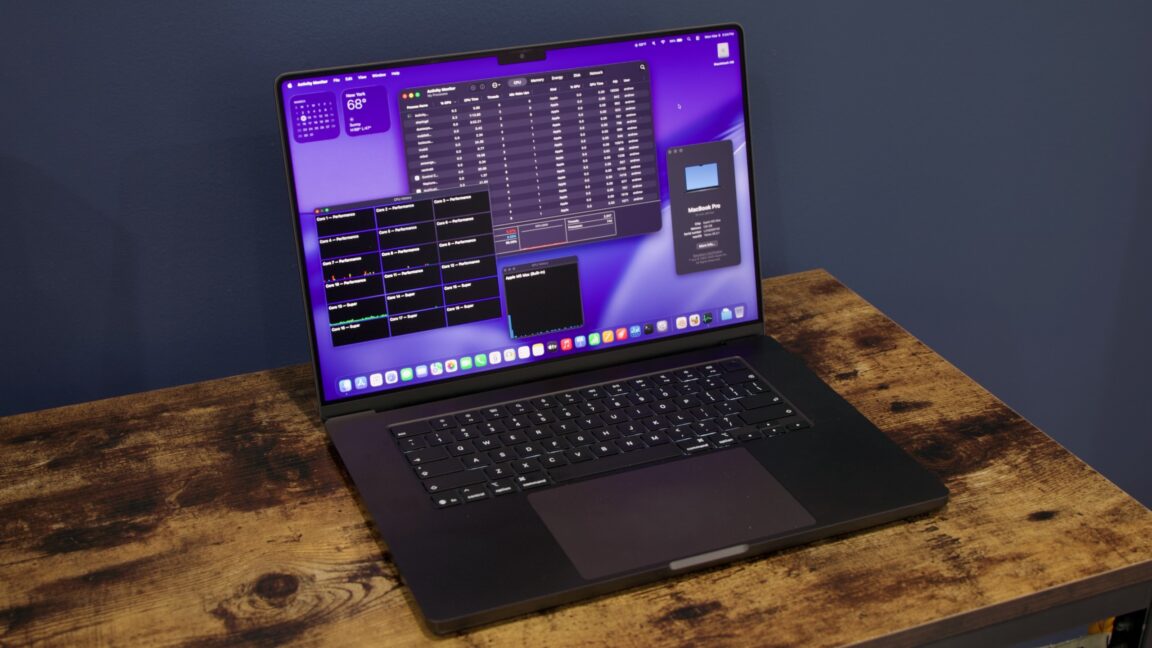
Le DGX Spark mise sur un GPU Blackwell dédié, 128 Go de mémoire unifiée LPDDR5X et un écosystème CUDA mature. Le M5 Max répond avec un CPU 18 cœurs (dont 6 « super » cœurs et 12 cœurs performance), jusqu’à 40 cœurs GPU et une bande passante mémoire de 614 Go/s – la plus élevée jamais vue sur un portable. Mais au-delà des fiches techniques, que valent-ils vraiment pour l’inférence, le fine-tuning et le déploiement en cluster ? Grâce aux benchmarks indépendants publiés en juin-juillet 2026 et aux retours terrain d’août-octobre, nous pouvons enfin comparer sur des bases solides.
Depuis, le paysage a encore évolué, et pas qu’un peu. DeepSeek a publié V4 Flash-0731 (284 milliards de paramètres, 13 actifs) le 31 juillet 2026, Poolside a sorti Laguna S 2.1 (118B) le 23 juillet, et Ant Group a dévoilé Ling-3.0-Flash 124B-A5B le même jour. Xiaomi a frappé un grand coup le 22 septembre 2026 avec la famille MiMo-V2.6 (Pro, Flash, 9B) sous licence MIT. Et surtout, côté matériel, NVIDIA a bouleversé la donne le 2 octobre 2026 en annonçant une version 64 Go du DGX Spark, commercialisée le 23 octobre 2026 à 4 999 dollars, tandis que la version 128 Go franchissait les 6 000 dollars sur le marché. Une inversion tarifaire qui change la donne pour qui veut empiler les nœuds.
Architecture : deux philosophies, une ambition commune
Tableau comparatif des spécifications clés
| Caractéristique | NVIDIA DGX Spark (GB10) | Apple M5 Max (MacBook Pro 16”) |
|---|---|---|
| CPU | 20 cœurs Arm (10 Cortex-X925 + 10 Cortex-A725) | 18 cœurs (6 super + 12 performance) |
| GPU | 48 cœurs Blackwell (5e gén. tensor cores) | Jusqu’à 40 cœurs GPU (avec matrices dédiées) |
| Mémoire unifiée | 128 Go ou 64 Go LPDDR5X (selon version) | 128 Go LPDDR5X |
| Bande passante mémoire | ~273 Go/s | 614 Go/s |
| Peak FP4 / FP8 | 1 PFLOP FP4 / 500 TFLOPS FP8 | ~70 TFLOPS FP16 (pas de FP4 natif) |
| Stockage | 4 To NVMe (chiffré auto) | 1 To – 8 To SSD |
| Réseau | ConnectX-7 200 Gbps (2 ports QSFP56/112) + 10 GbE | Thunderbolt 5 (10 GbE max) |
| TDP / Alimentation | ~1000 W (alimentation max) | ~270 W max |
| Prix de départ | 4 999 $ (64 Go, dès le 23/10/2026) / >6 000 $ (128 Go) | ~2 500 $ (MacBook Pro M5 Max 128 Go) / ~3 499 $ (Mac Studio M5 Max 128 Go) |
| OS | DGX OS (Ubuntu) | macOS |
| Pile logicielle | CUDA, cuDNN, TensorRT, NeMo, TensorRT Edge-LLM | MLX, Metal, PyTorch (MPS), llama.cpp |
Sources : LinkedIn – Pappalardo, Skorppio Blog, presenc.ai, Frandroid, Pause Hardware
Le DGX Spark utilise un Superchip GB10 qui combine 20 cœurs CPU Arm (dix cœurs haute performance Cortex-X925 et dix cœurs efficaces Cortex-A725) et un GPU Blackwell à 48 cœurs. La mémoire unifiée LPDDR5X de 128 Go permet de charger des modèles jusqu’à 200 milliards de paramètres en local sur un seul nœud — et jusqu’à 405 milliards sur deux nœuds. De son côté, l’Apple M5 Max marque une rupture : il intègre pour la première fois des unités de multiplication matricielle dédiées dans le GPU, promettant ~70 TFLOPS FP16, selon l’analyse technique de Skorppio. Sa bande passante de 614 Go/s est un atout majeur pour les calculs d’inférence, souvent limités par la mémoire plutôt que par la puissance de calcul.
L’impact sur l’IA est direct : le DGX Spark mise sur le parallélisme massif du GPU Blackwell et des formats natifs FP4/FP8, tandis que le M5 Max capitalise sur une bande passante exceptionnelle et une intégration verticale du matériel. Les benchmarks confirment ces orientations.
La nouvelle donne tarifaire d’octobre 2026
Il faut mesurer à quel point le paysage a changé en quelques semaines. Le 2 octobre 2026, NVIDIA a annoncé une déclinaison 64 Go de son mini-supercalculateur, commercialisée le 23 octobre 2026 à 4 999 dollars — soit 1 000 dollars de plus que le prix de lancement de la version 128 Go en 2025, comme le relèvent Kod.ru et Frandroid. Dans le même temps, la version 128 Go, victime de l’envolée des cours de la LPDDR5, dépasse désormais les 6 000 dollars sur le marché, rapporte Pause Hardware. Résultat contre-intuitif : la version la moins dotée en mémoire coûte aujourd’hui moins cher que la version historique, mais plus cher que son propre prix de lancement.
Cette configuration 64 Go n’est pas qu’une économie de bouts de chandelle. Selon NeoTeo, NVIDIA détaille les tailles de modèles visées sur un ou deux systèmes, et met en avant un test sur Qwen 3.8 27B avec un gain « jusqu’à 1,7 fois » — un chiffre qui recoupe directement les optimisations Multi-Token Prediction évoquées plus bas. Clubic souligne pour sa part une « drôle d’astuce » permettant à la version 64 Go de dépasser, dans certains scénarios, le modèle 128 Go : la mutualisation de la mémoire entre deux nœuds via le réseau ConnectX-7. Deux petits plutôt qu’un gros, en somme — une question que Frandroid pose explicitement.
À cela s’ajoute la concurrence des OEM. ASUS a dévoilé le 5 octobre 2026 son Ascent GX10 64GB, un « supercalculateur agentique compact » fondé sur le même GB10, capable de faire tourner des modèles de 30 à 35 milliards de paramètres et des agents locaux avec 1 PFLOP de calcul, selon ASUS. Techgenyz note que l’Ascent GX10 et le DGX Spark partagent le même matériel GB10, mais diffèrent sur le prix, le stockage, le refroidissement et la disponibilité. Et Acer a livré dès le 8 septembre 2026 son propre mini-PC GB10 128 Go, positionné 500 à 1 000 dollars sous le tarif NVIDIA officiel. La plateforme GB10 n’est plus un monopole.
Inférence : les premiers chiffres concrets départagent les deux machines
Grâce aux tests indépendants publiés en juin-juillet 2026, nous disposons désormais de mesures fiables pour plusieurs modèles populaires en quantification Q4.
Benchmarks d’inférence (Q4, single-stream)
| Modèle | DGX Spark (tokens/s) | Mac M5 Max (tokens/s) | Écart |
|---|---|---|---|
| Llama 4 8B | 110 – 125 | 95 – 110 | DGX +13 % |
| Qwen 3 32B | 50 – 62 | 40 – 50 | DGX +25 % |
| Llama 4 70B | 35 – 45 | 25 – 32 | DGX +40 % |
| gpt-oss 120B | 20 – 28 | 14 – 19 | DGX +45 % |
| Prefill (Llama 4 8B, prompt 4K) | ~1 200 tps | ~400 tps | DGX 3× |
Sources : presenc.ai, codersera.com
Le DGX Spark remporte tous les tests d’inférence, avec un écart qui se creuse à mesure que la taille du modèle augmente. La différence est particulièrement marquée sur le préfill (traitement des prompts longs), où le GPU Blackwell et TensorRT-LLM offrent un avantage de 3×. Le M5 Max, malgré sa bande passante supérieure, ne peut compenser le manque d’optimisations logicielles et de formats natifs basse précision.
Latence pour des prompts longs
Pour un prompt de 4k tokens, la latence est principalement dictée par le temps de préfill. Le DGX Spark, grâce à FlashAttention-2 et TensorRT-LLM, traite ces prompts trois fois plus vite que le M5 Max. En revanche, pour la génération (décodage), l’écart se réduit, le M5 Max profitant de sa bande passante pour charger rapidement les poids.
Conclusion partielle : le DGX Spark est clairement plus performant pour l’inférence, surtout sur les gros modèles et les longs contextes. Le M5 Max reste honorable, mais ne rivalise pas sur ce terrain.
Les gros modèles récents sur un seul DGX Spark
Le DGX Spark n’a pas attendu le M5 Max pour faire tourner les modèles les plus lourds. Le 31 juillet 2026, DeepSeek a publié la version officielle de V4 Flash-0731 : 284 milliards de paramètres au total, 13 milliards actifs par token, une fenêtre de contexte d’un million de tokens. Selon un test mené par Classmethod et rapporté sur dev.classmethod.jp, le modèle tourne sur un seul DGX Spark en quantification 2-bit ou 3-bit, avec llama.cpp qui surpasse le moteur dédié DwarfStar 4 en vitesse (environ 30 tokens/s en configuration par défaut, davantage après ajustement). Le démarrage est plus lent (6,5 minutes contre 17 secondes pour DwarfStar 4), mais en usage persistant, llama.cpp s’impose. Unsloth a publié le GGUF le jour même de la sortie, et une version Q8 (162 Go) permet une inférence lossless, seulement 7 Go plus lourde que la Q4.
Les mesures terrain d’août 2026 affinent le tableau. Sur une configuration antirez/ds4 avec DeepSeek-V4-Flash en quantification IQ2_XXS, on mesure ~14 tok/s en single-stream et 410 tok/s en préfill. Avec la suite GGUF de llama.cpp sur un modèle 35B-A3B, le débit grimpe jusqu’à 67 tok/s. C’est dans cette fourchette que se situent les usages réalistes d’un nœud unique.
Poolside a également sorti Laguna S 2.1 (118B paramètres) le 23 juillet 2026, présenté comme le premier grand open-weight américain depuis 11 mois. Les premiers retours terrain sur DGX Spark font état de débits entre 19 et 50 tokens/s selon la configuration, comme le rapporte notre article « Laguna S 2.1 sur DGX Spark : le roi du codage local passe à l’épreuve du terrain ». Enfin, Ant Group a dévoilé Ling-3.0-Flash 124B-A5B (5B actifs) le même jour, avec une architecture hybride KDA/MLA et une fenêtre de contexte native de 256K tokens (extensible à 1M). Les estimations non officielles des forums NVIDIA donnent 15-20 tokens/s sur un seul Spark.
MiMo-V2.6 : l’entrée fracassante de Xiaomi
Le 22 septembre 2026, Xiaomi a ouvert les poids de sa famille MiMo-V2.6 (Pro, Flash, 9B) sous licence MIT, comme le rapporte eWeek. Selon SiliconANGLE, il s’agit de l’une des familles open source les plus efficientes à déployer — à condition de disposer du matériel adéquat. WinBuzzer souligne que les gains d’efficacité sont « sans précédent », tandis que Forkast note que le MiMo-V2.6-Pro égale Grok 4.7 sur l’Intelligence Index et devance Claude Opus 5 sur certains benchmarks. Attention toutefois : Xiaomi a entraîné ses modèles via un RL à très grande échelle (un tableau de bord d’entraînement diffusé en direct, avec un coût annoncé de 432 000 $/jour selon Forkast), et les gains issus de ce RL manquent encore de réplication indépendante. Sur DGX Spark, la variante Flash, plus légère, est la plus pertinente pour un nœud unique ; les variantes Pro viseront plutôt un cluster de deux nœuds.
Qwen3.8-Flash-Next : le multi-token prediction change la donne
Autre actualité chaude de la rentrée : le support Multi-Token Prediction (MTP) débarque pour les GGUF de Qwen3.8-Flash-Next, avec un gain annoncé de 1,67× et une vérification exacte (aucune perte de qualité), passant de 83 à 138 tok/s selon banandre.com. C’est exactement le type d’optimisation qui profite au GB10 : le MTP réduit le nombre de passes de décodage nécessaires, ce qui exploite mieux la bande passante de 273 Go/s. Le test Qwen 3.8 27B « jusqu’à 1,7 fois » mis en avant par NVIDIA pour la version 64 Go (NeoTeo) relève de la même logique. À l’inverse, sur Apple, trymirai.com a publié une implémentation de décodage spéculatif dans Uzu (d’abord pour Qwen3.6 27B, puis Qwen3.8 27B et Muse Glimmer), qui « surpasse MTPLX » sur les puces M5 — signe que l’écosystème Apple rattrape son retard sur ce front précis.
TensorRT Edge-LLM : le workflow edge que NVIDIA formalise
Le 30 octobre 2026, NVIDIA a détaillé un workflow en ligne de commande pour exécuter Nemotron-3.5 Lightning sur DGX Spark 64 Go, avec données de benchmark et résultats de décodage spéculatif à l’appui, rapporte Blockchain.news. L’outil mobilisé est TensorRT Edge-LLM, la déclinaison edge de la pile TensorRT. C’est un signal important : NVIDIA ne se contente plus de fournir du matériel, elle documente désormais des recettes reproductibles pour l’inférence edge sur GB10. Pour l’utilisateur, cela signifie des chemins d’optimisation officiels — et un écart qui se creuse encore avec l’écosystème Apple sur le terrain du déploiement industrialisé.
Fine-tuning : le DGX Spark écrase la concurrence
Le fine-tuning est l’autre pilier de l’IA locale. Ici, l’avantage du DGX Spark est encore plus net grâce à son écosystème CUDA mature et au support natif du FP4/FP8.
Benchmarks de fine-tuning (LoRA et QLoRA)
| Workload | DGX Spark | Mac M5 Max | Écart |
|---|---|---|---|
| LoRA fine-tune Llama 4 8B (1 epoch, 50K samples) | ~3,5 heures | ~14 heures | DGX 4× |
| QLoRA fine-tune Qwen 3 32B | ~12 heures | Non testé (estimation >40h) | DGX >3× |
Sources : presenc.ai
Le DGX Spark bénéficie également d’accélérations logicielles record. Un post sur le forum développeur NVIDIA (2026) annonce un « Lossless 7.67× LoRA / 8.35× Full FT speedup for Qwen3.5 on DGX Spark (GB10 SM 121a) ». Cela signifie que, grâce à des optimisations via NeMo ou des kernels personnalisés, le DGX Spark peut entraîner un modèle Qwen3.5 près de 8 fois plus vite qu’une configuration de référence. Unsloth documente d’ailleurs officiellement ce workflow dans son guide « Fine-tuning LLMs with NVIDIA DGX Spark and Unsloth », qui est devenu la référence pratique pour les développeurs solo.
Capacités théoriques basées sur la mémoire
Avec 128 Go de mémoire unifiée, le DGX Spark peut potentiellement faire du full fine-tuning sur des modèles de taille intermédiaire, mais les configurations réalistes privilégient le LoRA/QLoRA au-delà de 8 à 13 milliards de paramètres. La version 64 Go, elle, cantonne le fine-tuning confortable aux modèles plus petits — sauf à basculer sur un cluster de deux nœuds, où la mémoire agrégée rouvre le champ. C’est précisément là que se joue l’arbitrage entre « un gros » et « deux petits » soulevé par Frandroid.
Clusters DGX Spark : l’argument que le Mac ne peut pas suivre
C’est peut-être le point le plus décisif du duel. Le DGX Spark est conçu pour être mis en cluster dès la sortie de la boîte, grâce à ses deux ports ConnectX-7 à 200 Gbps (QSFP56/112). Apple, avec son Thunderbolt 5 plafonné à 10 GbE en réseau, ne propose rien d’équivalent : chaîner plusieurs MacBook relève du bricolage coûteux.
Ce que deux nœuds changent vraiment
Les chiffres d’août 2026 sur un cluster de deux DGX Spark sont éloquents :
- Taille maximale de modèle supportée : 405 milliards de paramètres (contre ~200 milliards sur un nœud).
- Pool de cache KV partagé : 1 105 096 tokens — de quoi tenir des contextes d’un million de tokens sans swap disque.
- DeepSeek-V4-Flash en FP8, TP=2, vLLM : ~41 tok/s en single-stream, ~350 tok/s agrégés à concurrence 32, et ~1 785 tok/s en préfill.
Autrement dit, deux Sparks transforment un modèle de 284 milliards de paramètres en service multi-utilisateurs viable, là où un seul nœud plafonne autour de 14 à 30 tok/s selon la quantification. C’est cette évolutivité horizontale qui distingue fondamentalement la plateforme GB10 d’un ordinateur portable, aussi puissant soit-il.
Le protocole Spark Arena et les benchmarks indépendants
Le 29 septembre 2026, Artificial Analysis a lancé AA-AgentPerf-Local, un benchmark dédié aux performances agentiques en local. Quatre matériels sont testés au lancement : DGX Spark, Ryzen AI Halo, MacBook Pro (M5 Pro) et RTX 5090, sur quatre modèles open weight. C’est la première fois qu’un référentiel indépendant met ces machines sur un pied d’égalité pour des charges agentiques — et non plus seulement pour du simple débit de tokens. Le protocole « Spark Arena », évoqué dans nos précédents articles, s’inscrit dans la même démarche : comparer les modèles à matériel constant.
La concurrence se réveille : AMD et DGX Station
Le DGX Spark n’est plus seul sur le créneau du mini-supercalculateur IA. Le 14 octobre 2026, AMD a lancé son Ryzen AI Halo 192GB à 7 299,99 dollars chez Micro Center — le premier desktop compact capable de charger des modèles open weight de 300 milliards de paramètres, rapporte TechTimes. Mais les benchmarks indépendants cités par le média sont sans ambiguïté : le DGX Spark reste devant en vitesse, malgré ses 128 Go (ou 64 Go) contre 192 Go. La mémoire ne fait pas tout ; la pile logicielle et la bande passante non plus.
Au-dessus, NVIDIA prépare le DGX Station for Windows, dévoilé le 8 octobre 2026 avec 748 Go de mémoire cohérente et 20 PFLOPs FP4, pour un lancement au quatrième trimestre 2026 via six partenaires OEM, selon Tech-Insider. Ce n’est plus la même catégorie de machine, ni le même prix — mais cela montre que l’écosystème GB10 s’inscrit dans une gamme cohérente, du mini-PC au poste de travail.
Logiciels : la release d’octobre 2026 et ses pièges
Le 21 octobre 2026, NVIDIA a déployé sa mise à jour logicielle trimestrielle pour DGX Spark, dans le cadre de sa release d’octobre 2026, comme l’annonce le forum développeur NVIDIA. Les systèmes partenaires équipés du GB10 Grace Blackwell bénéficient des mêmes mises à jour. Cette release fait suite à DGX OS 7.6.0, noyau 7.0, pilote 580.178.04 et CUDA 13.0.3, publiés le 2 octobre 2026.
Sur le papier, la promesse d’un rythme de croisière maîtrisé. Dans les faits, notre enquête « DGX Spark, la release d’octobre 2026 à l’épreuve du terrain » a montré une réalité plus contrastée : trois releases en six mois, une cadence réelle qui oscille entre communication et traces GitHub, et surtout une loterie des compatibilités sur les conteneurs NGC, vLLM et llama.cpp. La procédure de rollback et l’ordre des mises à jour restent mal documentés — un piège pour qui gère un cluster en production.
Côté pile applicative, l’écosystème s’étoffe : CUDA, cuDNN, TensorRT, NeMo, et désormais TensorRT Edge-LLM pour l’inférence edge. La contrainte demeure : chaque brique a sa propre matrice de compatibilité avec la version de DGX OS installée. La règle d’or pour un cluster reste de figer les versions et de tester les mises à jour sur un nœud isolé avant de propager.
Verdict : lequel choisir en octobre 2026 ?
Le duel, à l’automne 2026, n’est plus tout à fait celui qu’on croyait. Sur l’inférence pure, le DGX Spark garde une avance nette — de 13 % sur les petits modèles à 45 % sur les gros, et jusqu’à 3× sur le préfill. Sur le fine-tuning, l’écart est d’un facteur 4 et plus, porté par CUDA, NeMo et les kernels optimisés. Sur les clusters, il n’y a même pas de match : ConnectX-7 à 200 Gbps contre Thunderbolt 5, et la possibilité de faire tourner un modèle de 405 milliards de paramètres sur deux nœuds.
Le MacBook Pro M5 Max garde ses arguments : une bande passante mémoire de 614 Go/s, un rapport performance/prix imbattable pour un usage solo, une intégration logicielle soignée (MLX, décodage spéculatif dans Uzu), et un format portable. Pour un développeur qui veut prototyper sur un modèle de 30 à 70 milliards de paramètres sans se ruiner, il reste un excellent choix.
Mais la nouvelle grille tarifaire rebat les cartes. Avec une version 64 Go à 4 999 dollars et une version 128 Go au-delà de 6 000 dollars, la question « un gros ou deux petits ? » devient centrale. Deux Sparks 64 Go, reliés par ConnectX-7, offrent une mémoire agrégée de 128 Go, un cache KV partagé de plus d’un million de tokens et une évolutivité que le Mac ne connaîtra jamais — pour un budget comparable à un seul nœud 128 Go. C’est probablement le meilleur compromis pour qui veut faire tourner DeepSeek V4 Flash-0731, Laguna S 2.1 ou Ling-3.0-Flash en local, avec la perspective de monter à quatre ou huit nœuds.
Reste un arbitrage à ne pas négliger : la concurrence OEM (ASUS Ascent GX10, Acer GB10 500 à 1 000 dollars moins cher) et l’arrivée du Ryzen AI Halo 192 Go rebattent les cartes du rapport qualité-prix. Le DGX Spark n’est plus le seul GB10 du marché, et c’est une bonne nouvelle pour l’acheteur. Mais sur la vitesse et l’écosystème logiciel, il conserve son avance — à condition d’accepter la complexité de sa pile logicielle et la rigueur qu’exige sa gestion de versions.
Sources
- Classmethod – DeepSeek V4 Flash-0731 sur un seul DGX Spark avec llama.cpp
- NVIDIA Developer Forums – DGX Spark Software Updates, October 2026 Release
- Blockchain.news – NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM (30 octobre 2026)
- TechTimes – AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed (14 octobre 2026)
- Tech-Insider – NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs (8 octobre 2026)
- ASUS – Ascent GX10 64GB: Compact Agentic AI Supercomputer (5 octobre 2026)
- Techgenyz – ASUS Ascent GX10 vs NVIDIA DGX Spark (5 octobre 2026)
- NeoTeo – DGX Spark 64 Go : NVIDIA annonce une configuration (3 octobre 2026)
- Kod.ru – Nvidia представила ИИ-компьютер DGX Spark с 64 ГБ памяти (3 octobre 2026)
- Frandroid – Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ? (2 octobre 2026)
- Clubic – NVIDIA lance un DGX Spark 64 Go (2 octobre 2026)
- Pause Hardware – Le DGX Spark perd la moitié de sa mémoire mais conserve son tarif de 4 999 dollars (2 octobre 2026)
- Presenc.ai – NVIDIA DGX Spark vs Mac Studio M5 Max for Local AI
- Skorppio – Apple M5 Max vs NVIDIA AI Deep Dive
- LinkedIn – Pappalardo, comparaison DGX Spark / MacBook Pro M5 Max
- Unsloth – Fine-tuning LLMs with NVIDIA DGX Spark and Unsloth
- Codersera – Local LLM Hardware Showdown, June 2026
- Banandre – MTP pour Qwen3.8-Flash-Next
- Trymirai – décodage spéculatif Uzu sur puces M5
- eWeek, SiliconANGLE, WinBuzzer, Forkast – couverture de MiMo-V2.6 (22 septembre 2026)
Article recherché et rédigé automatiquement · Magazine Electrosens