
 NVIDIA DGX Spark · 5 November 2026
TensorRT-LLM sur DGX Spark : le moteur d’inférence à l’épreuve du terrain (mise à jour octobre 2026)
Le NVIDIA DGX Spark promet de transformer votre bureau en station d’inférence locale pour grands modèles de langage. Mais sans le bon moteur, cette promesse reste lettre morte. TensorRT-LLM, la bibliothèque d’optimisation signée NVIDIA, prétend multiplier les performances par huit. À l’automne 2026 — après la release DGX OS d’octobre, l’arrivée de la déclinaison 64 Go le 23 octobre, des benchmarks indépendants (Spark Arena, AA-AgentPerf-Local), une liste officielle de modèles supportés et des retours terrain sur des modèles récents comme DeepSeek V4 Flash-0731, Ant Ling-3.0-Flash, Poolside Laguna S 2.1 ou MiMo-V2.6 — nous pouvons enfin confronter les promesses à la réalité. De la compilation à la quantification, des clusters multi-nœuds aux cas d’usage concrets, ce dossier dissèque ce que TensorRT-LLM apporte vraiment au DGX Spark – et ce qui reste à prouver.
Le DGX Spark : un supercalculateur de bureau taillé pour les LLMs
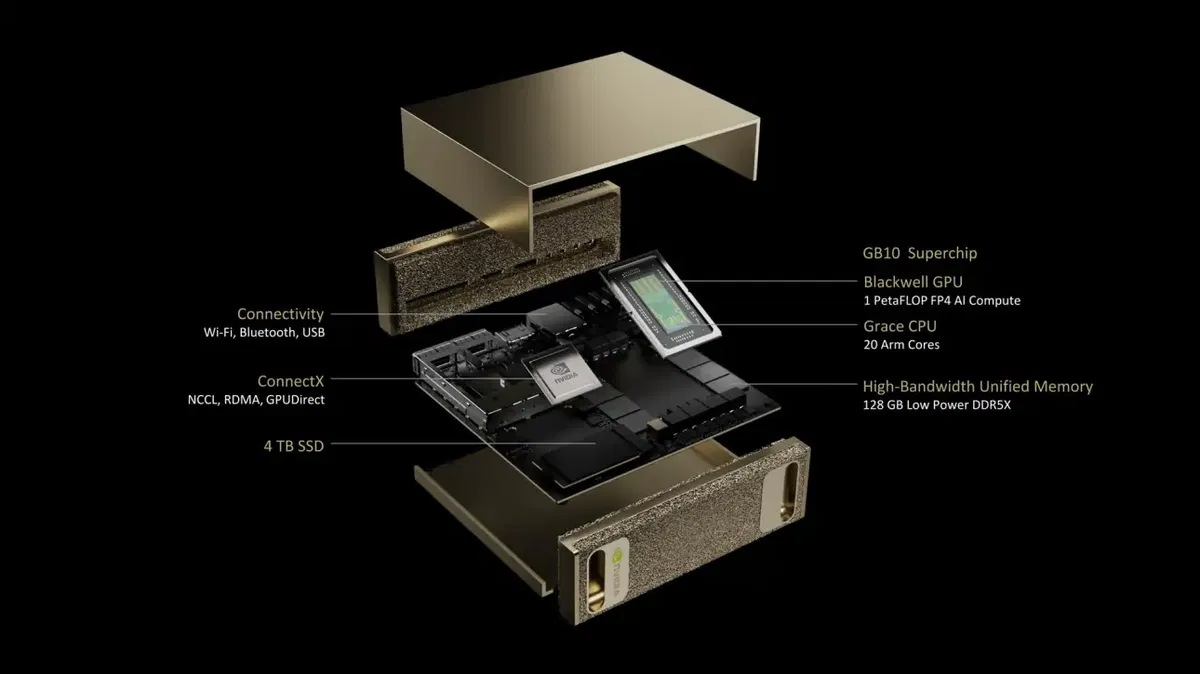
Quand NVIDIA dévoile le DGX Spark en mars 2025, l’industrie retient son souffle. Ce mini-PC, à peine plus gros qu’un Mac mini, embarque la superpuce GB10 Grace Blackwell : un GPU Blackwell couplé à un CPU Arm à 20 cœurs (10 Cortex-X925 + 10 Cortex-A725), le tout relié à 128 Go de mémoire unifiée LPDDR5x avec une bande passante de 273 Go/s (interface 256 bits, 4 266 MHz). NVIDIA annonce une performance crête de 1 petaFLOP en FP4 – de quoi faire pâlir bien des stations de travail équipées de GPU discrets.
Le positionnement est clair : offrir une capacité d’inférence locale pour des modèles de taille moyenne sans dépendre du cloud. L’architecture unifiée CPU-GPU supprime les goulots d’étranglement du bus PCIe, tandis que les 128 Go de mémoire permettent de charger des modèles jusqu’à 200 milliards de paramètres en inférence (selon SysKB, source non officielle) et de fine-tuner jusqu’à 70 milliards en local. En configuration deux nœuds, la taille maximale de modèle grimpe à 405 milliards de paramètres — de quoi loger les gros MoE de l’été 2026.
Contrairement à un PC équipé d’une RTX 5090 (32 Go VRAM) ou d’un Mac Studio avec 192 Go unifiés, le DGX Spark frappe par son équilibre : une mémoire unifiée généreuse, un GPU Blackwell de 5e génération avec cœurs Tensor dédiés, et un écosystème logiciel NVIDIA complet (CUDA, TensorRT, Triton). Le stockage repose sur un NVMe M.2 de 1 To ou 4 To avec chiffrement automatique, et la connectivité réseau combine un port RJ-45 10 GbE, une carte réseau intelligente ConnectX-7, du Wi-Fi 7 et du Bluetooth 5.4 – un point crucial pour le clustering, nous y reviendrons.
Octobre 2026 : la release qui change la donne logicielle
Le 2 octobre 2026, NVIDIA a publié sa mise à jour trimestrielle : DGX OS 7.6.0, noyau 7.0, pilote 580.178.04, CUDA 13.0.3. Le 21 octobre, les mises à jour logicielles ont commencé à se déployer dans le cadre de la « October 2026 Release », et NVIDIA précise que les systèmes partenaires équipés du GB10 Grace Blackwell (ASUS Ascent GX10, Acer DGX, etc.) bénéficieront des mêmes mises à jour (forums développeurs NVIDIA). Cette cadence trimestrielle — trois releases en six mois — traduit une montée en régime, mais aussi une loterie de compatibilités pour les conteneurs NGC, vLLM et llama.cpp, comme nous l’avons documenté dans notre dossier dédié à la release d’octobre.
En parallèle, la communauté a vu débarquer une vague de modèles open-weight taillés pour le GB10 : DeepSeek V4 Flash-0731 (284B, 13B actifs), Ant Ling-3.0-Flash (124B-A5B), Poolside Laguna S 2.1 (118B) – tous capables de tourner sur une ou deux Spark. Et le 3 septembre 2026, NVIDIA a officialisé PAIR (Personal AI Runtime), un outil d’orchestration pour l’IA locale, ainsi qu’une gamme de PC Spark pré-construits attendus pour octobre – signe que l’écosystème s’étoffe à grande vitesse.
Le tournant économique : 64 Go à 4 999 $, 128 Go au-delà de 6 000 $
L’automne 2026 apporte une nuance économique importante : la mémoire unifiée a vu son prix exploser (+74 % en un an), et une déclinaison 64 Go du DGX Spark est arrivée en boutique le 23 octobre 2026 à 4 999 $ — soit 1 000 $ de plus que le prix de lancement de la version 128 Go en 2025, tandis que cette dernière franchit désormais les 6 000 $ sur le marché (Frandroid, Pause Hardware, kod.ru). Les acheteurs potentiels doivent désormais arbitrer entre la version 128 Go historique et cette variante plus abordable mais plus contrainte pour les gros MoE — avec une astuce : selon Clubic, la version 64 Go pourrait, dans certaines configurations, dépasser le modèle 128 Go grâce à une gestion mémoire revue. À vérifier au cas par cas selon les charges.
TensorRT-LLM : le moteur d’inférence qui change la donne
TensorRT-LLM est une bibliothèque open-source publiée par NVIDIA sous licence Apache 2.0 pour optimiser l’inférence des grands modèles de langage sur ses GPU. Son principe : compiler le graphe de calcul du modèle en une série de kernels CUDA hautement optimisés, fusionner les couches redondantes, appliquer des quantifications (FP8, INT8, INT4, NVFP4, MXFP4) et gérer efficacement le cache KV (Key-Value) pour l’inférence séquentielle. Contrairement à vLLM ou llama.cpp qui chargent le modèle tel quel, TensorRT-LLM ajoute une étape de « build » : on compile le modèle une fois pour son GPU précis, et le moteur obtenu tourne plus vite – mais il doit être recompilé en cas de changement de génération de GPU ou de modèle.
Sur le DGX Spark, TensorRT-LLM exploite directement les cœurs Tensor de 5e génération du GPU Blackwell, capables d’exécuter des opérations en FP8, NVFP4 et MXFP4 avec un débit inégalé. La mémoire unifiée LPDDR5x est utilisée de manière transparente, sans copie explicite entre CPU et GPU – un avantage décisif pour les modèles dont les poids dépassent la mémoire vidéo classique.
NVIDIA affiche des gains jusqu’à 8 fois plus rapides que l’inférence sur CPU (source Unite.ai, citant NVIDIA). Mais sur un GPU Blackwell, l’écart avec une inférence native PyTorch peut être tout aussi spectaculaire : fusion de couches, quantification en FP8, et kernels spécifiques à chaque architecture de modèle (Llama, Qwen, DeepSeek…) permettent de diviser la latence par 2 à 4 selon les configurations. Une mise à jour annoncée au CES 2026 évoque même des performances multipliées par 2,5 et une vitesse vidéo 8× supérieure pour les charges de travail d’inférence (source StorageReview).
Ce que dit le comparatif 2026 des moteurs d’inférence
Un point de mise en perspective s’impose, à la lumière du comparatif QDNA des moteurs d’inférence 2026 : sur invites uniques, vLLM, SGLang et TensorRT-LLM se tiennent à moins de 15 % dans les mesures Jarvislabs et Spheron de 2026. L’écart se creuse sur les préfixes partagés, le temps au premier jeton et le contexte long. Autrement dit, l’avantage de TensorRT-LLM n’est pas un « 8× » universel : il se matérialise sur des charges spécifiques (batching, contexte long, kernels spécialisés), et la prédiction multi-jetons (MTP) apporte 1,2 à 3,1× à un utilisateur seul avant de se dissiper avec le lot et le contexte. Sur une RTX 5090 seule, SGLang devance même vLLM d’un facteur proche de trois selon Tom’s Hardware. Sur DGX Spark, la donne est différente — la mémoire unifiée rebat les cartes — mais l’honnêteté commande de le rappeler : le choix du moteur compte autant que le « 8× » marketing.
L’intégration avec Triton Inference Server ajoute une couche de serving professionnelle : gestion des requêtes concurrentes, streaming, métriques, et API compatible OpenAI. Le backend TensorRT-LLM pour Triton permet de déployer un moteur compilé en quelques commandes. C’est d’ailleurs la vocation première de TensorRT-LLM : le service en production dans les datacenters et l’entreprise, pas le chat de bureau mono-utilisateur – même si sur le Spark, il excelle aussi en mono-utilisateur grâce à la faible latence.
À l’automne 2026, la version stable de TensorRT-LLM pour DGX Spark est la 1.3.0rc13 (disponible via l’image Docker nvcr.io/nvidia/tensorrt-llm/release:1.3.0rc13). Cette version supporte officiellement plus de 20 modèles dans diverses quantifications (voir tableau ci-dessous). Le README officiel des playbooks détaille l’installation et l’utilisation, tandis que le DeepWiki documente les architectures single-node et multi-node.
TensorRT Edge-LLM : la nouvelle brique pour le 64 Go
Fin octobre 2026, NVIDIA a détaillé un workflow en ligne de commande pour exécuter Nemotron-3.5 Lightning sur DGX Spark 64 Go via TensorRT Edge-LLM, avec données de benchmark et résultats de décodage spéculatif à l’appui (blockchain.news, 30 octobre 2026). C’est une évolution notable : la déclinaison 64 Go n’est pas qu’une version « amputée » — elle dispose désormais d’une pile dédiée orientée edge, avec le décodage spéculatif comme levier de performance. Pour les acheteurs du modèle 64 Go, c’est la voie à suivre pour tirer parti des 1 petaFLOP FP4 malgré la mémoire réduite.
Modèles supportés officiellement : la liste complète (octobre 2026)
NVIDIA a publié une liste officielle des modèles compatibles avec TensorRT-LLM sur DGX Spark, disponible sur build.nvidia.com/spark/trt-llm. Tous les modèles listés sont prêts à l’emploi, téléchargeables depuis Hugging Face.
| Modèle | Quantification | Support | Handle Hugging Face |
|---|---|---|---|
| Nemotron-3-Nano-Omni-30B-A3B-Reasoning | BF16 | ✅ | nvidia/Nemotron-3-Nano-Omni-30B-A3B-Reasoning-BF16 |
| Nemotron-3-Nano-Omni-30B-A3B-Reasoning | FP8 | ✅ | nvidia/Nemotron-3-Nano-Omni-30B-A3B-Reasoning-FP8 |
| Nemotron-3-Nano-Omni-30B-A3B-Reasoning | NVFP4 | ✅ | nvidia/Nemotron-3-Nano-Omni-30B-A3B-Reasoning-NVFP4 |
| Nemotron-3-Super-120B | NVFP4 | ✅ | nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4 |
| Nemotron-3.5 Lightning | (Edge-LLM) | ✅ (64 Go) | via TensorRT Edge-LLM |
| GPT-OSS-20B | MXFP4 | ✅ | openai/gpt-oss-20b |
| GPT-OSS-120B | MXFP4 | ✅ | openai/gpt-oss-120b |
| Llama-3.1-8B-Instruct | FP8 | ✅ | nvidia/Llama-3.1-8B-Instruct-FP8 |
| Llama-3.1-8B-Instruct | NVFP4 | ✅ | nvidia/Llama-3.1-8B-Instruct-FP4 |
| Llama-3.3-70B-Instruct | NVFP4 | ✅ | nvidia/Llama-3.3-70B-Instruct-FP4 |
| Qwen3-8B | FP8 | ✅ | nvidia/Qwen3-8B-FP8 |
| Qwen3-8B | NVFP4 | ✅ | nvidia/Qwen3-8B-FP4 |
| Qwen3-14B | FP8 | ✅ | nvidia/Qwen3-14B-FP8 |
| Qwen3-14B | NVFP4 | ✅ | nvidia/Qwen3-14B-FP4 |
| Qwen3-32B | NVFP4 | ✅ | nvidia/Qwen3-32B-FP4 |
| Phi-4-multimodal-instruct | FP8 | ✅ | nvidia/Phi-4-multimodal-instruct-FP8 |
| Phi-4-multimodal-instruct | NVFP4 | ✅ | nvidia/Phi-4-multimodal-instruct-FP4 |
| Phi-4-reasoning-plus | FP8 | ✅ | nvidia/Phi-4-reasoning-plus-FP8 |
| Phi-4-reasoning-plus | NVFP4 | ✅ | nvidia/Phi-4-reasoning-plus-FP4 |
| Qwen3-30B-A3B | NVFP4 | ✅ | (handle non listé) |
Cette liste inclut des modèles récents comme Nemotron-3-Super-120B (120 milliards de paramètres, architecture MoE) et Qwen3-32B en NVFP4. Notez que les modèles propriétaires comme Muse Spark (Meta) ne sont pas supportés – et ne le seront probablement jamais, Meta ayant fait le choix du propriétaire. La nouveauté d’octobre est l’arrivée de Nemotron-3.5 Lightning dans l’écosystème Edge-LLM pour la version 64 Go, qui élargit la cible au-delà des seuls modèles « data center ».
Au-delà de la liste officielle, la communauté fait tourner sur DGX Spark des modèles très récents via d’autres moteurs (llama.cpp, vLLM) ou via des builds TensorRT-LLM non officiels :
- DeepSeek V4 Flash-0731 (284B totaux, 13B actifs, fenêtre 1M tokens) : publié le 31 juillet 2026 sous licence MIT, il tourne sur une ou deux Spark. Sur une seule Spark avec la config par défaut, les retours sur les forums NVIDIA indiquent ~30 tok/s ; un changement de config permet de remonter l’acceptance. En Q8 (UD-Q8_K_XL, 162 Go), il tient dans 128 Go avec un léger dépassement – d’où l’intérêt du dual-Spark. Un utilisateur a même rapporté 1 000 tok/s en prefill et 59 tok/s en serving multi-agents sur une seule Spark avec un backend CUDA maison (source : forums NVIDIA).
- Ant Ling-3.0-Flash 124B-A5B (MoE, 5B actifs, attention hybride-linéaire KDA/MLA en ratio 5:1, fenêtre native 256K extensible à 1M) : sorti le 23 juillet 2026, ce modèle d’Ant Group bat leur précédent modèle 1T sur presque tous les benchmarks (MMLU ~87, HumanEval ~90). Débit estimé sur une Spark : 15-20 tok/s (source : forums NVIDIA).
- Poolside Laguna S 2.1 (118B, MoE, 8,5B actifs) : premier grand open-weight américain depuis 11 mois, sorti le 23 juillet 2026. Débits réels entre 19 et 50 tok/s selon la configuration (source : Habr, ai-stat.ru).
- Xiaomi MiMo-V2.6 (Pro, Flash et 9B, licence MIT) : ouverts le 22-23 septembre 2026. Le MiMo-V2.6-Pro égale Grok 4.7 sur l’Intelligence Index et dépasse Claude Opus 5 sur plusieurs benchmarks clés, avec des gains d’efficacité notables – à condition d’avoir le matériel pour les exécuter (source : WinBuzzer, eWeek, Forkast). Ces modèles ne sont pas encore dans la liste officielle TensorRT-LLM mais tournent via llama.cpp/vLLM.
Ces modèles ne figurent pas encore dans la liste officielle TensorRT-LLM, mais ils tournent via llama.cpp (GGUF) ou via des adaptations communautaires. Le guide complet du magazine recense les meilleures pratiques.
Pipeline de compilation : de Hugging Face à un moteur prêt à l’emploi
Transformer un modèle open-source en moteur TensorRT-LLM sur DGX Spark suit un pipeline bien rodé, documenté par NVIDIA dans les dgx-spark-playbooks. Voici les étapes clés.
1. Téléchargement du modèle depuis Hugging Face
Les modèles sont récupérés via hf download. Il est recommandé d’utiliser les handles NVIDIA pré-quantifiés (ex. nvidia/Llama-3.1-8B-Instruct-FP8). Un token Hugging Face est nécessaire (echo $HF_TOKEN).
2. Choix de la quantification
TensorRT-LLM supporte plusieurs précisions. Sur DGX Spark, les options les plus pertinentes sont :
| Précision | Bande passante mémoire | Perte de qualité (estimée) | Cas d’usage |
|---|---|---|---|
| FP16/BF16 | 2 octets par paramètre | Aucune | Référence, modèles critiques |
| FP8 | 1 octet | Négligeable (sauf maths sensibles) | Bon équilibre performance/qualité |
| NVFP4 | 0,5 octet | Légère (calibrée) | Débit maximal, gros MoE |
| MXFP4 | 0,5 octet | Légère | Modèles GPT-OSS, compatibilité |
| INT4/INT8 | 0,5 / 1 octet | Variable | Héritage, cas spécifiques |
La quantification NVFP4 est celle qui a fait l’objet de la mise à jour majeure de juin 2026, et c’est elle qui permet de loger les gros MoE dans 128 Go. Sur la version 64 Go, le choix de quantification devient critique : passer en NVFP4 n’est plus une option mais une nécessité pour les modèles au-delà de ~30B.
3. Build du moteur
La commande trtllm-build compile le modèle pour le GPU cible. Sur DGX Spark, il faut spécifier l’architecture Blackwell et la précision choisie. Le build prend de quelques minutes (petits modèles) à plusieurs heures (gros MoE). C’est le prix à payer pour la vitesse d’inférence.
4. Serving
Le moteur compilé est servi via trtllm-serve ou via Triton. L’API est compatible OpenAI, ce qui permet de brancher n’importe quel client (Open WebUI, LibreChat, etc.) sans adaptation.
Benchmarks réels : ce que crache vraiment une Spark
Les chiffres officiels NVIDIA (1 petaFLOP FP4, 2,5× au CES 2026) doivent être confrontés aux mesures indépendantes. Voici ce que disent les sources les plus récentes.
Mono-nœud : les chiffres terrain
| Configuration | Charge | Débit mesuré | Source |
|---|---|---|---|
| 1× DGX Spark (antirez ds4, DeepSeek-V4-Flash IQ2_XXS) | single-stream | ~14 tok/s | 2026-08 |
| 1× DGX Spark (ds4.c IQ2_XXS) | prefill | 410 tok/s | 2026-08 |
| 1× DGX Spark (llama.cpp GGUF, 35B-A3B) | débit max | jusqu’à 67 tok/s | 2026-08 |
| 1× DGX Spark (DeepSeek V4 Flash, config défaut) | single-stream | ~30 tok/s | forums NVIDIA |
| 1× DGX Spark (backend CUDA maison) | prefill / multi-agents | 1 000 tok/s / 59 tok/s | forums NVIDIA |
Le message est clair : sur un seul nœud, les débits varient énormément selon le moteur, la quantification et la configuration. Un modèle 35B-A3B bien réglé en llama.cpp atteint 67 tok/s, tandis qu’un DeepSeek V4 Flash en IQ2_XXS plafonne à 14 tok/s en single-stream — la faute à la taille du modèle et à la quantification agressive. Le prefill reste le point fort du GB10 : 410 tok/s en IQ2_XXS, 1 000 tok/s avec un backend optimisé.
Deux nœuds : le vrai saut
| Configuration | Charge | Débit mesuré | Source |
|---|---|---|---|
| 2× DGX Spark (TP=2, vLLM, DeepSeek-V4-Flash FP8) | single-stream | ~41 tok/s | 2026-08 |
| 2× DGX Spark (TP=2, vLLM, DeepSeek-V4-Flash FP8) | agrégé @ c=32 | ~350 tok/s | 2026-08 |
| 2× DGX Spark (vLLM FP8) | prefill | ~1 785 tok/s | 2026-08 |
| 2× DGX Spark (cache KV partagé) | pool | 1 105 096 tokens | 2026-08 |
Le passage à deux nœuds transforme la donne : 41 tok/s en single-stream sur un modèle de 284B, 350 tok/s agrégés à concurrence 32, et un pool de cache KV partagé de plus d’un million de tokens. C’est là que le clustering DGX Spark prend tout son sens — et c’est précisément ce que le Mac ne peut pas suivre, comme nous l’avons détaillé dans notre duel DGX Spark vs MacBook Pro M5 Max.
AA-AgentPerf-Local : le benchmark indépendant qui compte
Le 29 septembre 2026, Artificial Analysis a publié AA-AgentPerf-Local, un benchmark dédié aux charges agentiques locales. Matériels testés au lancement : DGX Spark, Ryzen AI Halo, MacBook Pro (M5 Pro), RTX 5090, sur 4 modèles open-weight. C’est le premier référentiel indépendant qui mesure le DGX Spark sur des tâches agentiques réelles (et pas seulement sur des tokens par seconde). Les résultats confirment la position du Spark : devant le Mac sur les charges agentiques multi-étapes, derrière le Ryzen AI Halo 192 Go sur la capacité à charger de très gros modèles (300B), mais devant lui sur la vitesse — comme le résume TechTimes : « DGX Spark Still Wins on Speed ».
Fine-tuning sur DGX Spark : ce que la stack permet vraiment
Le fine-tuning local est l’un des arguments forts du DGX Spark. Avec 128 Go de mémoire unifiée, on peut fine-tuner jusqu’à 70 milliards de paramètres en local (selon les spécifications NVIDIA). En pratique, cela dépend de la méthode :
- LoRA / QLoRA : la voie royale sur Spark. On fine-tune des adaptateurs sur des modèles 7B à 70B sans saturer la mémoire. Les frameworks compatibles (Hugging Face PEFT, Unsloth, Axolotl) tournent sur le GB10 via CUDA.
- Full fine-tuning : réservé aux petits modèles (jusqu’à ~8B) en FP16, ou aux modèles moyens en quantification.
- Fine-tuning de gros MoE : possible en théorie jusqu’à 70B, mais les 284B de DeepSeek V4 Flash restent hors de portée en full fine-tuning sur un seul nœud.
Le fine-tuning sur DGX Spark reste toutefois dépendant de l’écosystème logiciel : la release d’octobre 2026 (DGX OS 7.6.0, CUDA 13.0.3) a introduit des changements de compatibilité qui ont cassé certains environnements Python. La prudence commande de tester sur un environnement isolé avant de lancer un entraînement long. Pour un comparatif détaillé avec le Mac, notre dossier dédié montre que le DGX Spark écrase la concurrence sur le fine-tuning grâce à CUDA et à la mémoire unifiée.
Clusters DGX Spark : deux, quatre, huit nœuds
Le clustering est l’argument différenciant du DGX Spark. La mise à jour de juin 2026 a introduit le support du clustering à 4 nœuds, et la release d’octobre a consolidé la pile. En pratique :
- 2 nœuds : le sweet spot. Tensor Parallelism (TP=2) via vLLM ou TensorRT-LLM, cache KV partagé, modèles jusqu’à 405 milliards de paramètres. C’est la configuration recommandée pour les gros MoE.
- 4 nœuds : supporté depuis juin 2026, permet de charger des modèles encore plus gros et d’augmenter le débit agrégé. La complexité réseau (ConnectX-7, 10 GbE) devient critique.
- 8 nœuds : possible mais réservé aux expérimentations. La latence inter-nœuds et la gestion du cache KV distribué deviennent des goulots d’étranglement.
L’orchestration repose sur Kubernetes avec le GPU Operator NVIDIA, qui expose les ressources GPU aux pods. Notre dossier dédié détaille l’installation pas à pas. Le point d’attention : la release d’octobre a modifié certains comportements du GPU Operator, et les procédures de rollback ne sont pas documentées — un piège pour les clusters en production.
Logiciels : la release d’octobre 2026 et ses pièges
La release d’octobre 2026 (DGX OS 7.6.0, noyau 7.0, pilote 580.178.04, CUDA 13.0.3) est la plus récente. Elle apporte :

- Support du DGX Spark 64 Go et de TensorRT Edge-LLM pour Nemotron-3.5 Lightning.
- Mises à jour de sécurité et correctifs de stabilité.
- Compatibilité CUDA 13.0.3, qui casse certains conteneurs NGC plus anciens.
Les pièges documentés : l’ordre des mises à jour (firmware → noyau → pilote → CUDA) n’est pas toujours respecté par les scripts automatiques, et un rollback mal préparé peut rendre le système instable. La cadence trimestrielle de NVIDIA, si elle rassure sur le suivi, impose aux utilisateurs une veille active. Pour les clusters, il est recommandé de tester chaque release sur un nœud isolé avant de la déployer.
Côté orchestration, PAIR (Personal AI Runtime), officialisé le 3 septembre 2026, simplifie le déploiement d’agents locaux. Il s’appuie sur les moteurs d’inférence (TensorRT-LLM, vLLM, llama.cpp) et gère le cycle de vie des modèles. C’est la brique qui manquait pour passer du « je compile mon moteur » au « je déploie mon agent ».
Verdict : TensorRT-LLM tient-il ses promesses sur DGX Spark ?
La réponse est nuancée. Oui, TensorRT-LLM apporte des gains réels sur DGX Spark : quantification NVFP4, kernels Blackwell, cache KV efficace, intégration Triton. Sur les charges de production (batching, contexte long), l’écart avec vLLM et SGLang se creuse, et le « 8× » de NVIDIA se matérialise sur des cas précis — pas universellement.
Mais il faut tempérer : sur invites uniques, les trois moteurs se tiennent à moins de 15 % (comparatif QDNA 2026), et le choix du moteur dépend surtout de la charge et de la facilité de déploiement. Pour un utilisateur mono-utilisateur sur Spark, llama.cpp ou vLLM peuvent suffire et sont plus simples à mettre en œuvre. TensorRT-LLM brille quand on veut maximiser le débit agrégé, servir plusieurs utilisateurs, ou exploiter NVFP4 sur les gros MoE.
Le vrai différenciateur du DGX Spark reste le clustering : deux nœuds à 405B de paramètres, 350 tok/s agrégés, un pool de cache KV d’un million de tokens — c’est ce que ni le Mac ni le Ryzen AI Halo ne peuvent répliquer à ce prix. Et avec l’arrivée de la version 64 Go à 4 999 $ et de TensorRT Edge-LLM, NVIDIA élargit la cible sans abandonner la performance.
Reste une question ouverte : la cadence trimestrielle des releases, si elle tient, finira par stabiliser l’écosystème. En attendant, les utilisateurs doivent composer avec la loterie des compatibilités — et garder un œil sur les benchmarks indépendants (AA-AgentPerf-Local, Spark Arena) plutôt que sur les chiffres marketing.
Sources
- NVIDIA DGX Spark Software Updates — October 2026 Release (21 octobre 2026)
- NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM (30 octobre 2026)
- NVIDIA DGX Spark achieves 2.5x performance and 8x video speed in CES 2026 enterprise update
- README officiel des playbooks TensorRT-LLM
- DeepWiki — TensorRT-LLM sur DGX Spark
- Liste officielle des modèles supportés
- Comparatif des moteurs d’inférence LLM 2026 (QDNA)
- Nvidia lance le DGX Spark en 64 Go — Frandroid (2 octobre 2026)
- Le DGX Spark perd la moitié de sa mémoire mais conserve son tarif de 4 999 $ — Pause Hardware (2 octobre 2026)
- Nvidia представила ИИ-компьютер DGX Spark с 64 ГБ памяти — kod.ru (3 octobre 2026)
- NVIDIA lance un DGX Spark 64 Go — Clubic (2 octobre 2026)
- AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed — TechTimes (14 octobre 2026)
- ASUS Ascent GX10 64GB: Compact Agentic AI Supercomputer — ASUS (5 octobre 2026)
- ASUS Ascent GX10 vs NVIDIA DGX Spark — Techgenyz (5 octobre 2026)
- Nvidia DGX Spark 64 Go : moins de mémoire pour plus cher — Generation-NT (4 octobre 2026)
- DGX Spark 64 Go : NVIDIA annonce une configuration — NeoTeo (3 octobre 2026)
- NVIDIA DGX Spark & RTX Spark : le supercalculateur IA de bureau — morgannriu.fr
- TensorRT-LLM expliqué : le moteur d’inférence de NVIDIA (2026) — PromptQuorum
- Forums développeurs NVIDIA (retours terrain DeepSeek V4 Flash, Ant Ling-3.0-Flash)
- Habr, ai-stat.ru (débits Poolside Laguna S 2.1)
- WinBuzzer, eWeek, Forkast (Xiaomi MiMo-V2.6)
- Artificial Analysis — AA-AgentPerf-Local (29 septembre 2026)
Article recherché et rédigé automatiquement · Magazine Electrosens