
DGX Spark 2026 : le bureau qui fait tourner des LLM de 120 milliards de paramètres — panorama complet des modèles open-source qui tournent vraiment
Un panorama complet de l’écosystème des modèles open-source récents optimisés pour la DGX Spark en 2026 : Nemotron, Llama, Qwen, DeepSeek et autres, avec les performances constatées, les optimisations logicielles qui les accompagnent (TensorRT-LLM, vLLM, playbooks NVIDIA) et ce que cela change concr
DGX Spark : les 2,5× et 8× qui changent la donne — décryptage des optimisations logicielles de 2026
NVIDIA annonce des gains spectaculaires de performance (2,5× en inference, 8× en traitement vidéo) pour le DGX Spark grâce à une salve d’optimisations logicielles et de modèles récentes. Cet article décrypte en profondeur d’où viennent ces gains : TensorRT LLM, vLLM, optimisations de modèles open-so
Désagrégation matérielle sur DGX Spark : quand deux machines valent mieux qu’une, à condition de savoir les découper
Décryptage en profondeur de la désagrégation matérielle (hardware disaggregation) appliquée au DGX Spark, une technique émergente qui consiste à spécialiser chaque unité du cluster pour une tâche précise (inférence, préfill, fine-tuning, agents) plutôt que de tout faire tourner partout. L’article ex
Quatre DGX Spark en cluster : le guide de terrain pour dompter votre supercalculateur personnel sans y laisser vos nerfs
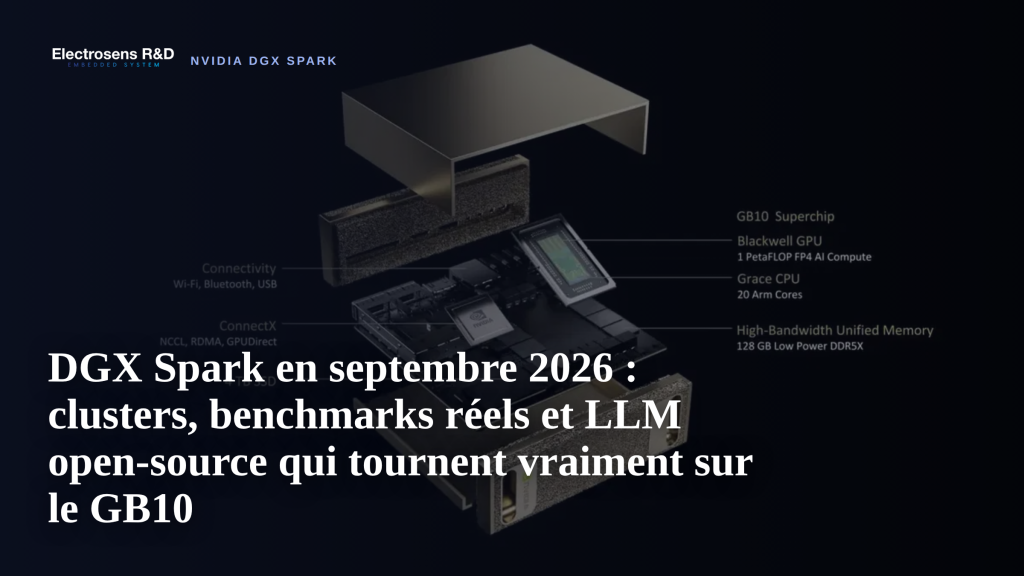
Dossier de fond sur le passage à l’échelle des DGX Spark en cluster de 4 nœuds, le sujet le plus brûlant de l’été 2026 : les mises à jour logicielles de juin ont officialisé le support multi-nœuds et la possibilité de faire tourner des modèles jusqu’à 700B localement, mais la réalité du terrain est
Dashboards vLLM open source sur DGX Spark : le comparatif définitif de ce qui fonctionne vraiment en 2026
Article de fond comparant les solutions open source de dashboard pour surveiller l’inférence vLLM en direct sur DGX Spark (GB10). Alors que la plupart des guides se concentrent sur l’installation de vLLM lui-même, le monitoring des métriques en temps réel (latence, throughput, utilisation mémoire, t
Mini-PC IA : le duel AMD vs NVIDIA qui redessine le paysage du local en 2026
Comparatif approfondi entre le NVIDIA DGX Spark et l’AMD Ryzen AI Halo, deux mini-PC IA concurrents sortis en 2026. L’article analyse leurs performances réelles sur des LLM open source (inférence, fine-tuning), leur écosystème logiciel (CUDA vs ROCm, support vLLM/Ollama), leur connectivité pour le c
NVFP4, clustering multi-nœuds et Nemoclaw : la mise à jour de juin 2026 qui transforme le DGX Spark en véritable station de calcul distribuée
Décryptage en profondeur de la mise à jour majeure de juin 2026 du DGX Spark (annoncée par NVIDIA et testée par la communauté) : gains de performance jusqu’à 2,6x via NVFP4, clustering multi-nœuds simplifié, et nouveau framework Nemoclaw. L’article détaille concrètement ce que chaque amélioration ch
DGX Spark : LiteLLM, llama-swap et les trois moteurs d’inférence — le match qui décide vraiment de votre stack LLM
Comparatif pratique et argumenté des solutions pour faire tourner un stack LLM complet (application → LiteLLM → llama-swap → moteur d’inférence) sur DGX Spark GB10, à partir du test exhaustif récent qui a passé en revue les combinaisons LiteLLM + llama-swap + vLLM, llama.cpp et Ollama. L’article dét
DeepSeek V4 Flash-0731 sur DGX Spark : le grand modèle qui tient dans une tour de bureau
Décryptage complet de la sortie de DeepSeek V4 Flash-0731 et de son exécution sur un seul NVIDIA DGX Spark. L’article teste le modèle avec llama.cpp, explore les niveaux de quantification, mesure les performances en tokens/seconde et compare avec d’autres modèles récents. Il analyse aussi les implic
Tri-Mode : quand NVIDIA réinvente la génération de texte — le LLM à diffusion qui se draft lui-même, testé sur DGX Spark
Décryptage en profondeur de la sortie du modèle Tri-Mode de NVIDIA, un LLM à diffusion open weights capable de générer son propre draft avant de raffiner — une rupture face aux modèles auto-régressifs. L’article analyse l’architecture, les performances réelles sur DGX Spark (latence, throughput, VRA