
 NVIDIA DGX Spark · 31 October 2026
LLM open source sur NVIDIA GB10 DGX Spark : ce qui tourne vraiment à l’automne 2026, la bascule des 64 Go, la diffusion et les clusters
Octobre 2026. Le DGX Spark de NVIDIA a passé le cap de son premier anniversaire, et le paysage des LLM open source a radicalement changé. Mais la vraie nouvelle de cet automne n’est pas logicielle : le 23 octobre, NVIDIA a ouvert les ventes d’une mouture 64 Go à 4 999 $, tandis que le modèle 128 Go, lui, a franchi la barre des 6 000 $. Un an après la commercialisation, la machine à 128 Go de mémoire unifiée n’est plus un objet unique : c’est une famille, déclinée chez six fabricants, qui accueille des modèles de diffusion capables de générer 256 jetons en parallèle, des MoE de 124 milliards de paramètres sur une seule machine, des modèles de classe 400B en cluster, et des agents autonomes qui transforment le boîtier en poste de travail agentique. Plongée rigoureuse dans la stack LLM open source qui tient vraiment la route sur GB10 — et dans ce qui a changé depuis un an.
La bascule d’octobre : 64 Go, 128 Go et une nouvelle grille tarifaire
Avant d’entrer dans le vif du sujet, il faut poser les faits, car ils ont bougé deux fois en six mois.
Avril 2026 : la hausse. NVIDIA a revu le prix du DGX Spark 128 Go à la hausse de +700 $, portant le ticket à 4 699 $ au catalogue américain. Une décision qui n’a pas refroidi les développeurs, mais qui a repositionné la machine face à des concurrents comme le Mac Studio M5 Ultra ou les mini-PC AMD Strix Halo. En Europe, la facture grimpe encore : comptez dès 5 038 € HT selon les relevés de septembre 2026.
Octobre 2026 : la scission. Le 2 octobre, NVIDIA a annoncé une seconde configuration, 64 Go de mémoire unifiée, commercialisée à 4 999 $ à partir du 23 octobre chez plusieurs constructeurs — ASUS, MSI, Acer notamment. Le même jour, le modèle 128 Go dépasse désormais les 6 000 $ sur le marché, comme le relèvent Pause Hardware et Frandroid. La logique est contre-intuitive : la version 64 Go, moins capacitaire, coûte 1 000 $ de plus que le prix de lancement du 128 Go en octobre 2025 (3 999 $), et Kod.ru le souligne sans détour. La cause est macroéconomique : l’envolée des cours de la LPDDR5X, que Hardware & Co résume d’une formule — « une cure d’amaigrissement » imposée par le marché de la mémoire.
Le blog officiel NVIDIA du 2 octobre 2026 présente cette mouture comme une porte d’entrée pour « exécuter des agents IA locaux avec la pile NVIDIA AI complète — et les mettre en cluster pour plus de performance à mesure que les charges grandissent ». Clubic note l’astuce : la version 64 Go peut, via le clustering, dépasser en capacité agrégée ce qu’un seul 128 Go peut faire. NeoTeo précise les tailles de modèles visées sur un ou deux systèmes, avec un test Qwen 3.8 27B annoncé jusqu’à 1,7× plus rapide dans certaines conditions.
Les variantes OEM — ASUS Ascent GX10, MSI EdgeXpert, Acer DGX — restent généralement 500 à 1 000 $ moins chères que le DGX Spark officiel, comme le souligne OutilsIA, qui note aussi que 70 à 80 % des acheteurs de mai 2026 préféraient le Strix Halo pour un usage généraliste. ASUS a d’ailleurs étendu sa gamme dans les deux sens : le 5 octobre 2026, l’Ascent GX10 64GB a été officialisé comme « Agent Computer » compact (1 PFLOP, modèles 30–35B et agents locaux), tandis que le ProArt GR1X vise les TPE/PME avec 128 Go unifiés. Techgenyz résume bien la situation : même plateforme GB10, mais prix, stockage, refroidissement et disponibilité changent tout.
Pour le fine-tuning intensif, vLLM optimisé et la recherche ML, le DGX Spark garde un avantage décisif : l’écosystème CUDA complet. Mais la donne tarifaire de l’automne impose une question nouvelle, que nous traitons plus bas : un gros ou deux petits ?
GB10 en 2026 : un an et demi de maturité logicielle
Sous le capot, rien n’a changé : la NVIDIA GB10 Grace Blackwell Superchip (sm121) associe 20 cœurs ARM Neoverse V2 à un GPU Blackwell d’environ 6 144 cœurs CUDA avec support FP4, le tout adossé à 128 Go de LPDDR5X unifiée à 273 Go/s (ou 64 Go sur la nouvelle mouture) et un TDP système d’environ 170 W. La machine tourne sous DGX OS, un Ubuntu Server 24.04 ARM, avec la pile NVIDIA AI Enterprise pré-installée : CUDA 13.0, cuDNN, NCCL, drivers Blackwell et Docker NVIDIA Container Toolkit.
C’est cette maturité logicielle — acquise en dix-huit mois — qui fait la différence. Comme le rappelle Programmez!, NVIDIA a annoncé pour l’automne 2026 une version Windows de sa plateforme DGX. Le 8 octobre 2026, les caractéristiques de la DGX Station for Windows ont fuité puis été confirmées : 748 Go de mémoire cohérente, 20 PFLOPs en FP4, lancement au Q4 2026 via six partenaires OEM. C’est une autre catégorie de machine — et de prix — mais elle confirme la stratégie : NVIDIA veut couvrir tout le spectre, du Spark 64 Go à la Station Windows.
Le blog officiel NVIDIA rappelle le positionnement de la gamme : « des modèles à 100 milliards de paramètres sur DGX Spark aux modèles à 1 billion de paramètres sur DGX Station », avec le format NVFP4 qui compresse les modèles jusqu’à 70 % sans perte d’intelligence. La famille Nemotron 3 de NVIDIA y est nativement supportée.
Un point de friction mérite d’être signalé, car les reviews anglo-saxonnes le passent souvent sous silence : la friction ARM. Le setup Docker sur ARM64, la disponibilité des wheels précompilés et la gestion des dépendances Python restent des points d’attention réels pour qui sort des sentiers battus. La communauté a d’ailleurs documenté un cas de perte totale de réactivité de l’hôte lors d’une inférence MiniMax H3 FL2VA (texte-vers-vidéo 864×480, 124 frames) sur un DGX Spark mono-GPU — un rappel que la machine, malgré sa robustesse, n’est pas à l’abri de charges vidéo génératives mal calibrées.
La révolution diffusion : quand les LLM génèrent en parallèle
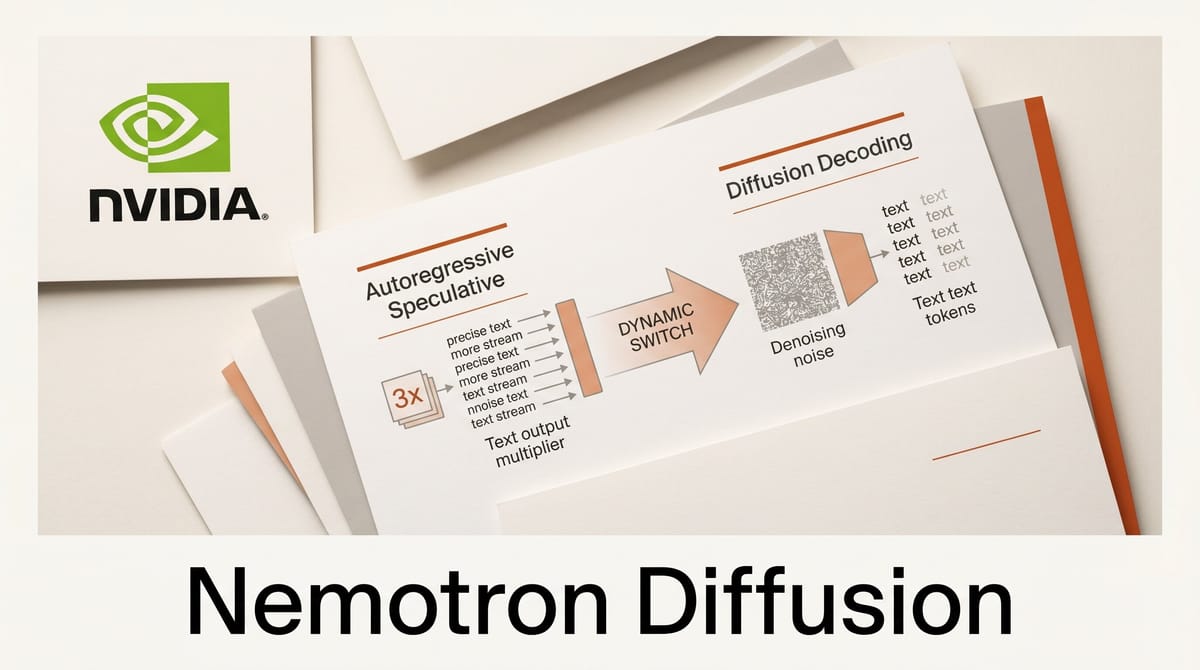
Il y a des annonces qui passent inaperçues et qui méritent pourtant le détour. Le 20 mai 2026, la page recherche de NVIDIA s’enrichissait d’une publication sobrement intitulée « Nemotron-Labs-Diffusion : Tri-Mode Language Model Unifying Autoregressive, Diffusion, and Self-Speculation » — un titre de papier académique qui cache une petite révolution. Sept semaines plus tard, le 7 juillet 2026, le preprint correspondant était déposé sur arXiv sous l’identifiant 2607.05722, et les poids du modèle apparaissaient sur Hugging Face sous licence NVIDIA Open Model License, une licence commerciale qui autorise une utilisation en entreprise.
Mais ce n’était que le début. Le 10 août 2026, Google DeepMind a riposté avec DiffusionGemma, un modèle ouvert expérimental conçu pour une génération de texte exceptionnellement rapide — et NVIDIA l’a immédiatement optimisé pour ses plateformes, y compris le DGX Spark. Plutôt que de générer du texte un mot à la fois, DiffusionGemma débruite jusqu’à 256 jetons par étape au lieu d’en prédire un à la fois. Basé sur Gemma 4, un modèle de mélange d’experts de 26 milliards de paramètres qui n’active que 3,8 milliards par étape, il associe une tête de diffusion à l’architecture Gemma 4 de Google. Les performances annoncées : jusqu’à 4× plus rapides que la génération autorégressive classique sur du matériel local. Et surtout, c’est un modèle à poids ouverts sous licence permissive Apache 2.0, qui s’exécute entièrement sur RTX et DGX Spark — sans cloud, ni coût par jeton — avec une prise en charge immédiate dans Hugging Face Transformers, vLLM et Unsloth.
Cette double annonce marque un tournant : la diffusion, longtemps cantonnée aux modèles d’images, s’impose comme une voie crédible pour l’inférence LLM locale. Et le DGX Spark, avec ses 128 Go de mémoire unifiée, est en première ligne.
Nemotron-Labs-Diffusion : le tri-mode qui bouscule l’autorégression
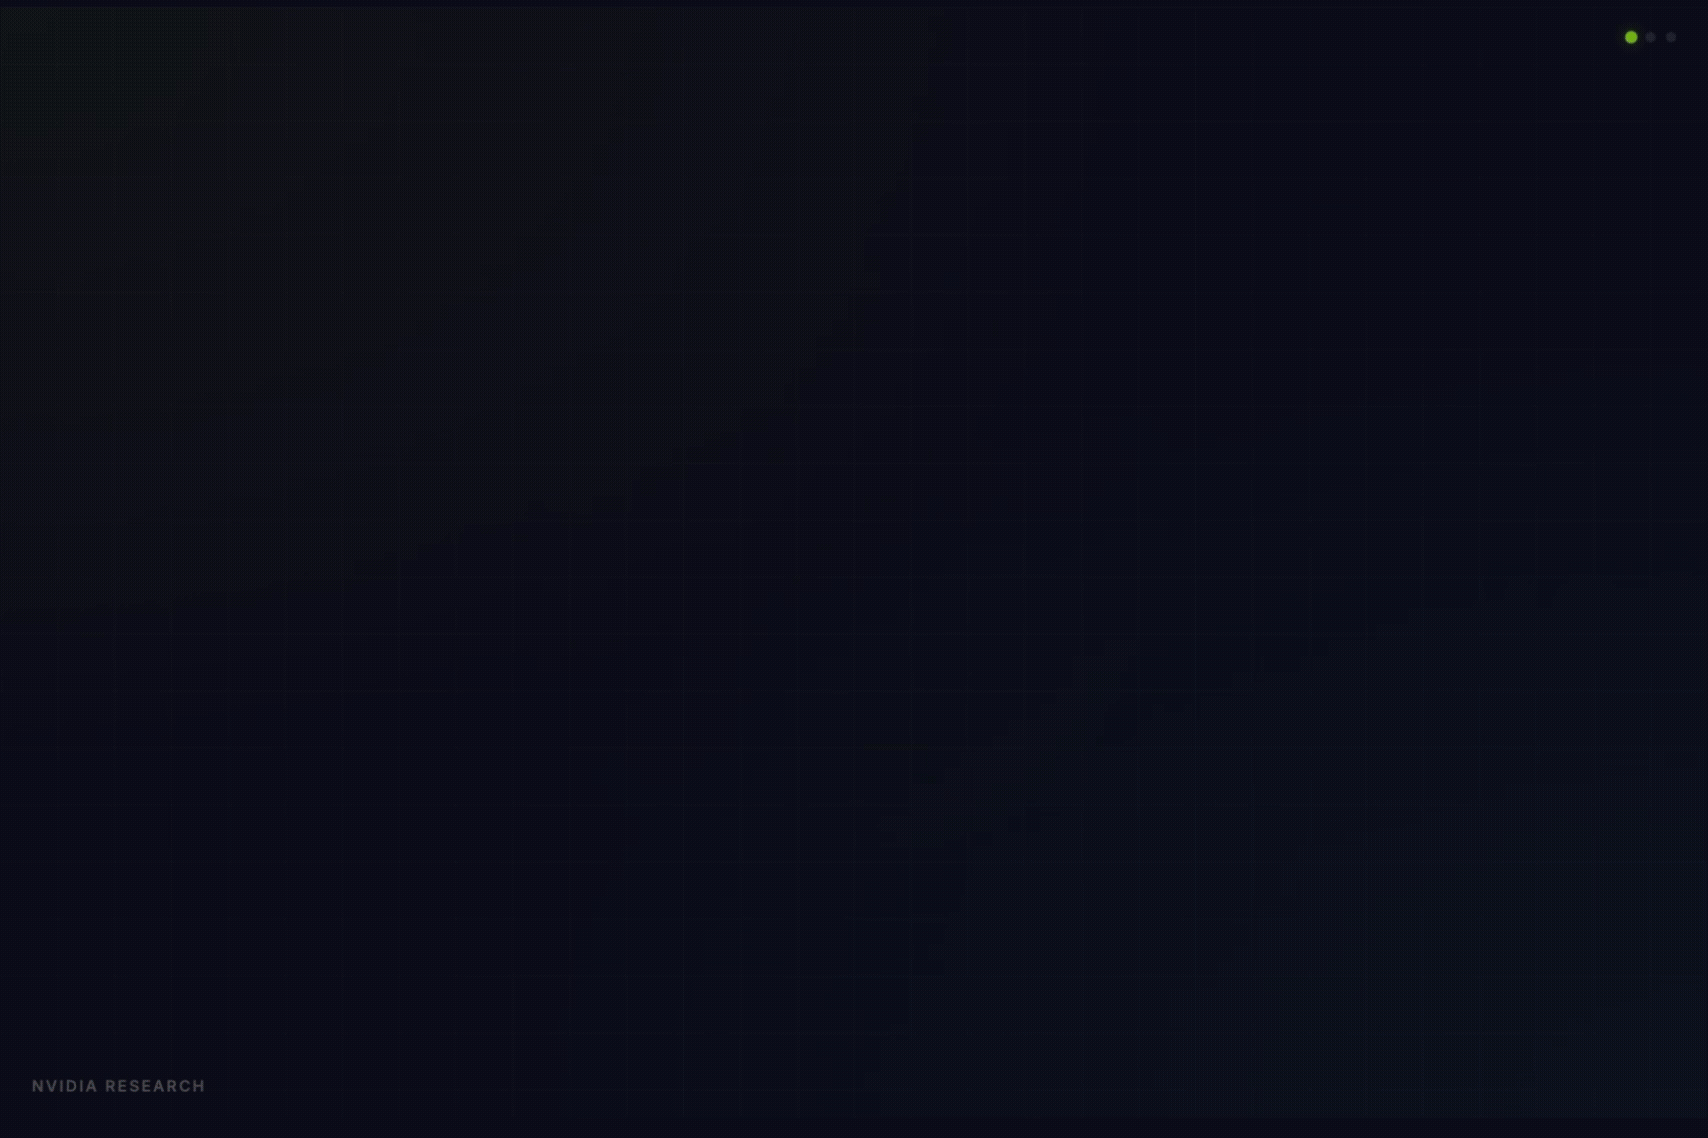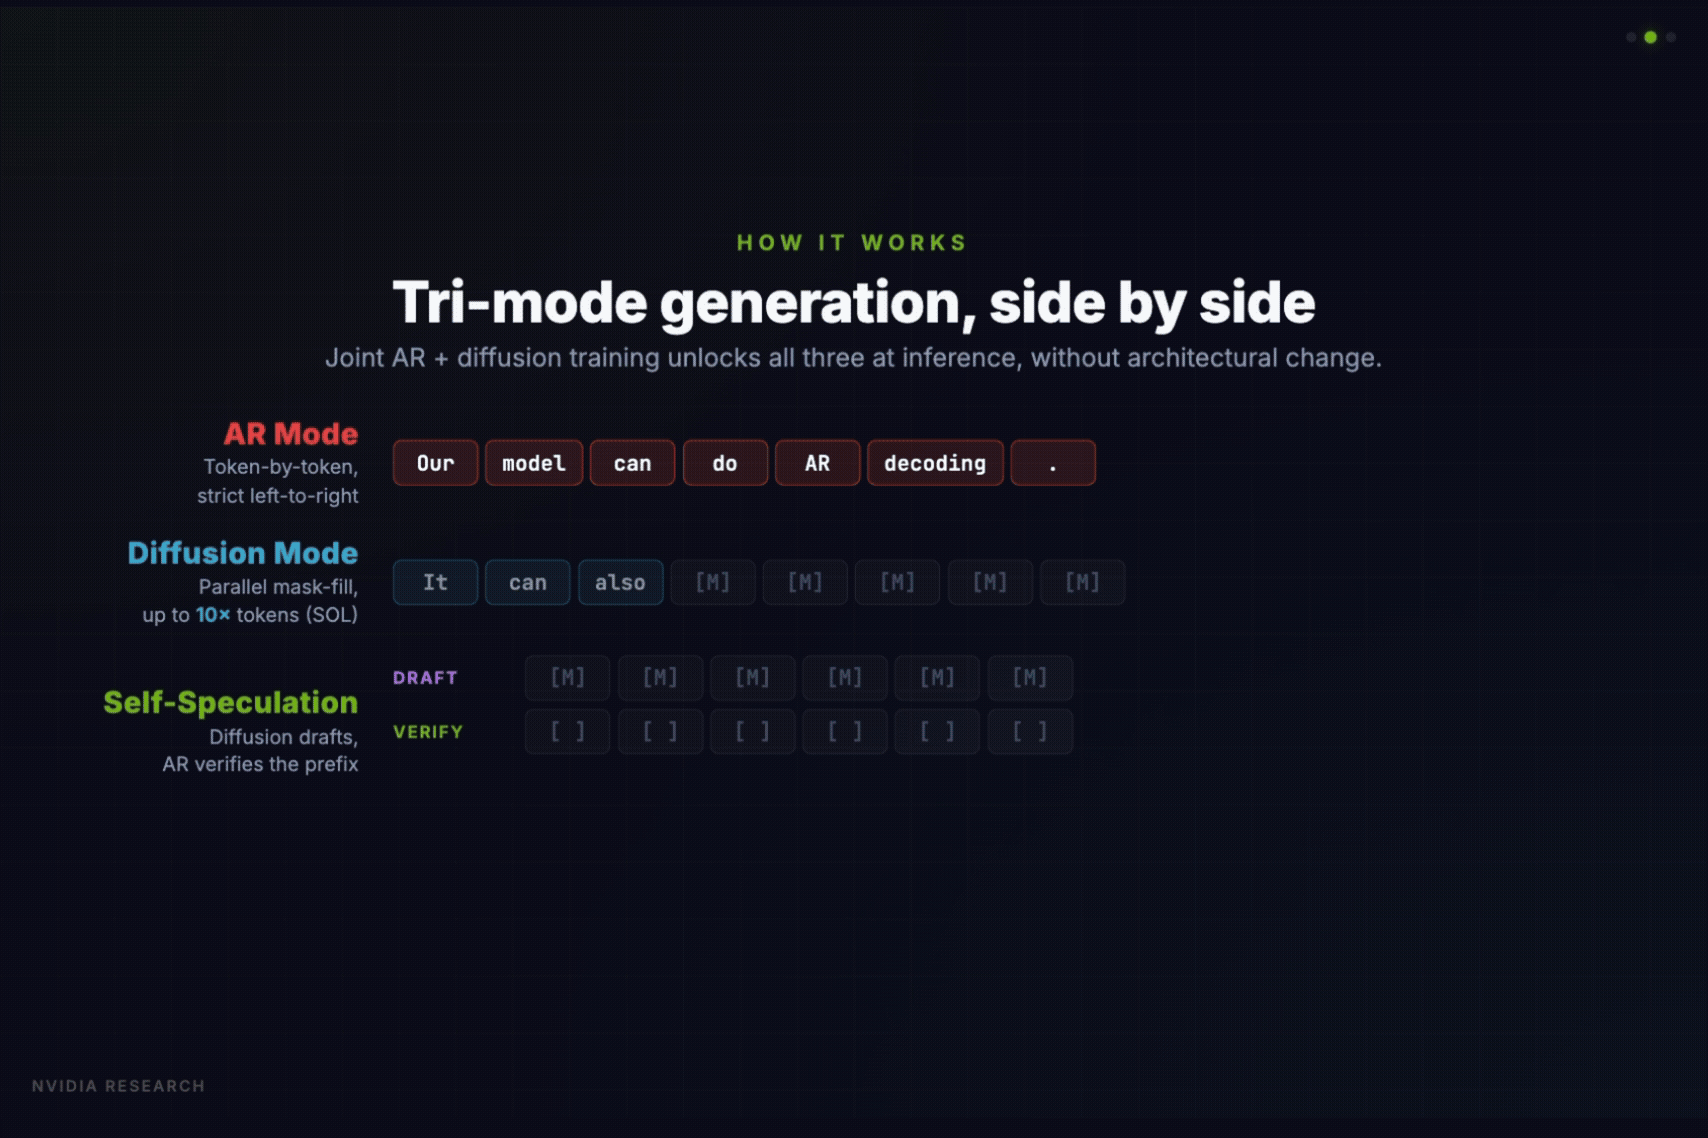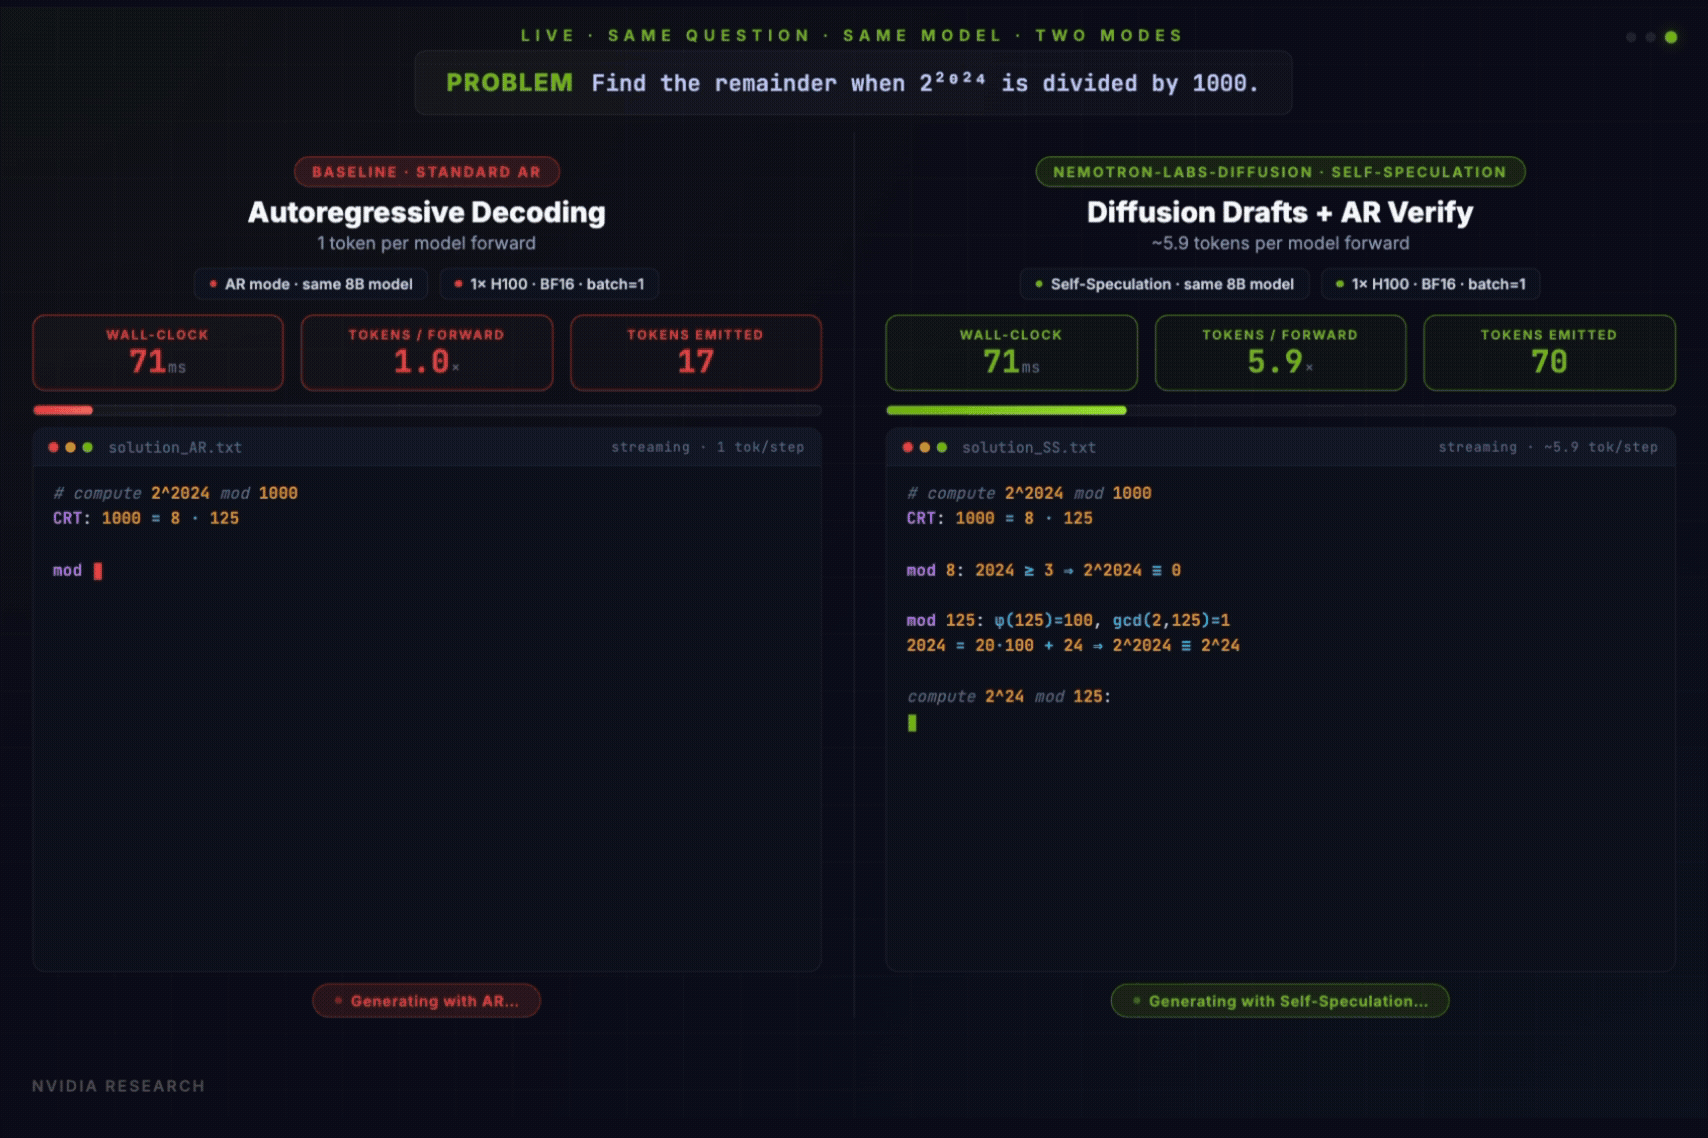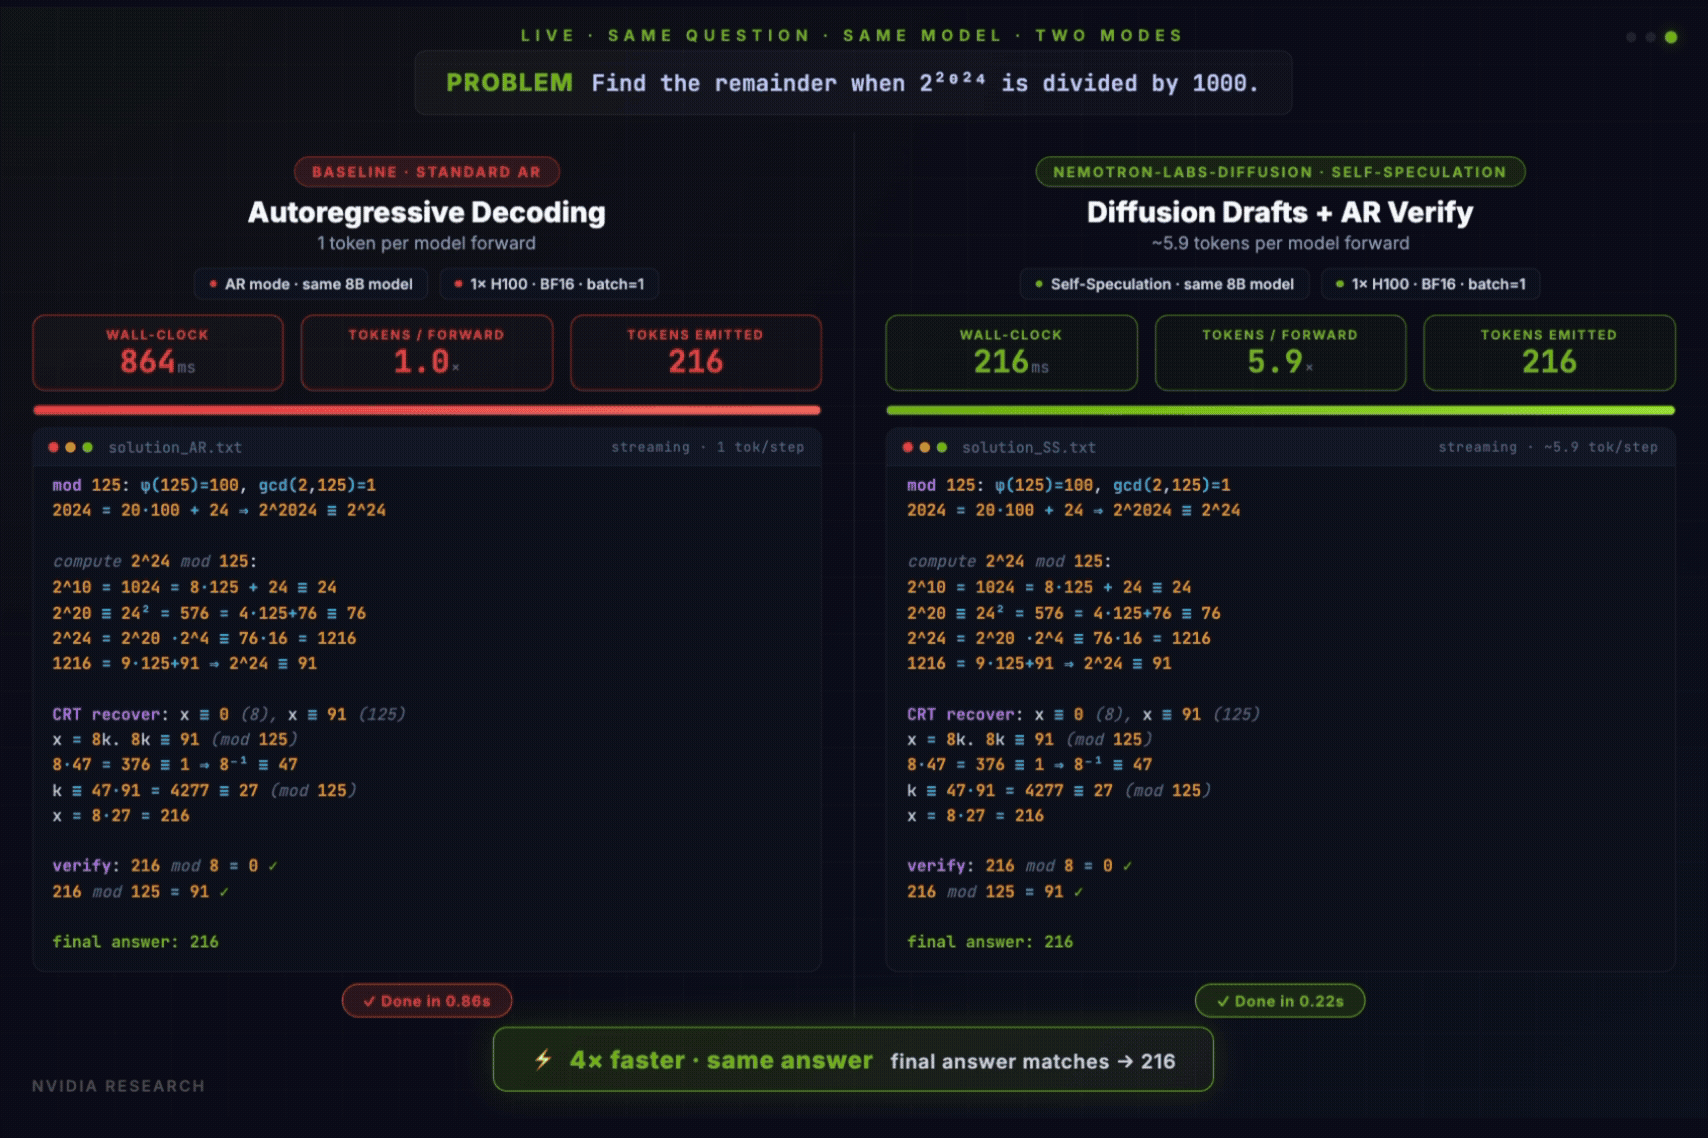
Pour comprendre ce que fait Nemotron-Labs-Diffusion, il faut oublier un instant le réflexe conditionnel qui domine l’inférence des LLM depuis GPT-2. Dans un modèle auto-régressif classique, chaque token est généré en conditionnant sur tous les précédents — une chaîne séquentielle qui borne le débit par la latence d’une seule passe avant. Tri-Mode, lui, peut basculer entre trois modes de génération à l’inférence, sans aucun changement de poids :

- Mode auto-régressif (AR) : le fonctionnement classique, token après token, utile pour les tâches où la précision séquentielle prime.
- Mode diffusion : la séquence est d’abord entièrement masquée, puis toutes les positions sont affinées simultanément, passe après passe. Les tokens à haute confiance sont « engagés » à chaque itération, ce qui permet de générer des blocs entiers en parallèle.
- Mode auto-spéculation : le module diffusion génère un brouillon (draft) complet en parallèle, puis le module AR vérifie ce brouillon en une seule passe. C’est le mécanisme de « self-drafting » — le modèle se draft lui-même, sans modèle auxiliaire externe.
Cette dernière propriété est cruciale. Les techniques de décodage spéculatif classiques (comme Medusa ou Eagle) nécessitent un modèle draft séparé, souvent plus petit, entraîné spécifiquement pour proposer des candidats. Tri-Mode élimine ce besoin : le draft et la vérification sont deux facettes du même réseau de neurones, entraîné conjointement pour les deux tâches. D’après TechTimes, qui a analysé le preprint, le processus de diffusion est multi-passes : il part d’une séquence masquée, raffine toutes les positions simultanément, et n’engage que les tokens dont la confiance est suffisante avant de repartir pour une nouvelle passe de raffinement.
Un détail intrigue : TechTimes affirme que l’architecture part du modèle de base Ministral3 de Mistral AI. Cette information n’est pas confirmée par la page officielle de NVIDIA, et aucune autre source indépendante ne la corrobore. Si elle se vérifie, cela signifierait que NVIDIA a pris un modèle auto-régressif existant et l’a ré-entraîné avec un objectif conjoint AR-diffusion, en adaptant probablement le tokenizer et les mécanismes d’attention pour supporter la génération non auto-régressive. Mais ces adaptations techniques ne sont documentées nulle part dans les sources disponibles — un manque qui laisse la place à toutes les spéculations. Nous la signalons donc comme non confirmée.
5,9× plus de tokens par passe : décryptage des chiffres de performance
Les chiffres annoncés par NVIDIA sont alléchants. Sur la page officielle, on apprend que Nemotron-Labs-Diffusion-8B décode 5,9× plus de tokens par forward pass que Qwen3-8B, avec une meilleure précision. TechTimes arrondit à « six fois plus de tokens », et les deux sources concordent sur un débit 4× supérieur sur le benchmark SPEED-Bench, exécuté avec SGLang sur un GPU GB200. L’analyse « speed-of-light » menée par NVIDIA va encore plus loin : elle suggère un potentiel de 76,5 % de tokens en plus par forward pass par rapport à l’auto-spéculation avec un échantillonneur optimal.
Ces chiffres méritent d’être lus avec discernement. D’abord, le preprint arXiv du 7 juillet 2026 n’a pas encore été évalué par les pairs, et TechTimes le mentionne explicitement. Ensuite, aucune réplication indépendante n’existe à ce jour sur d’autres matériels — les benchmarks ont été réalisés sur un GB200, une puce data center qui n’a rien à voir avec une DGX Spark. Enfin, les sources ne s’accordent pas entre elles : CreativeAINews évoque un facteur 3× là où NVIDIA et TechTimes annoncent 4× à 6×. Cette discordance suggère que les conditions de mesure (quantification, longueur de séquence, batch size) influencent fortement les résultats.
Ce qui est certain, c’est que le mécanisme d’auto-spéculation change la donne théorique. Dans un décodage spéculatif classique, le draft model propose des candidats et le modèle principal les vérifie ; le gain dépend du taux d’acceptation des tokens proposés. Avec Tri-Mode, le draft et la vérification partagent les mêmes poids, ce qui devrait en théorie améliorer la cohérence entre les deux — le draft « sait » ce que le vérificateur acceptera. C’est élégant, mais cela reste à prouver sur des charges de travail réelles, et surtout sur GB10.
DiffusionGemma sur DGX Spark : ce que dit NVIDIA
Contrairement à Nemotron-Labs-Diffusion, DiffusionGemma bénéficie d’une optimisation officielle NVIDIA pour le DGX Spark. Le blog NVIDIA du 10 août 2026 est explicite : le modèle « s’exécute entièrement sur RTX et DGX Spark — sans cloud, ni coût par jeton ». Les fonctionnalités clés :
- Génération parallèle : débruite jusqu’à 256 jetons par étape au lieu d’un à la fois.
- Basé sur Gemma 4 : MoE de 26 milliards de paramètres, 3,8 milliards actifs par étape.
- Performances jusqu’à 4× plus rapides : là où la génération pour un utilisateur unique stagne généralement — sur du matériel local.
- Ouvert et local : licence Apache 2.0, prise en charge immédiate dans Hugging Face Transformers, vLLM et Unsloth.
Le modèle est disponible sur Hugging Face sous la référence nvidia/diffusiongemma-26B-A4B-it-NVFP4, avec une quantification NVFP4 pensée pour les GPU NVIDIA. C’est un signal fort : NVIDIA ne se contente plus de publier des papiers de recherche, il optimise activement des modèles de diffusion tiers pour sa plateforme.
Les modèles qui tournent vraiment sur GB10 à l’automne 2026
Au-delà de la diffusion, le paysage des LLM open source sur DGX Spark s’est considérablement enrichi cet été et à la rentrée. Voici les modèles qui font l’actualité.
DeepSeek V4 Flash 0731
Sorti fin juillet 2026, DeepSeek V4 Flash 0731 est un modèle MoE optimisé avec 13 milliards de paramètres actifs (sur ~284 milliards au total, selon la reproduction indépendante documentée sur DeepWiki). C’est le modèle qui a servi de base à la plupart des benchmarks communautaires sur DGX Spark cet été, notamment via le portage ds4.c d’antirez. Les chiffres mesurés sur une machine unique en quantification IQ2_XXS donnent ~14 tok/s en single-stream et 410 tok/s en prefill (août 2026) — un débit modeste en génération, mais un prefill rapide qui rend l’usage interactif viable pour des prompts longs. En cluster de deux Spark avec vLLM en TP=2 et quantification FP8, on monte à ~41 tok/s en single-stream, ~350 tok/s en agrégé à concurrence 32, et ~1 785 tok/s en prefill (août 2026). C’est le grand écart entre la machine seule et la paire.
Qwen 3.8 27B et la famille Qwen3.6-NVFP4
NVIDIA a mis en avant, à l’occasion du lancement du 64 Go, un test Qwen 3.8 27B jusqu’à 1,7× plus rapide sur un ou deux systèmes (NeoTeo). C’est le sweet spot de la machine : un modèle dense de 27B en NVFP4 tient confortablement dans 64 Go avec un contexte généreux, et les variantes Qwen3.6-NVFP4 publiées par NVIDIA sont devenues la référence pour qui veut du code et du raisonnement sans se battre avec les quantifications GGUF exotiques.
Les MoE de 124B et la classe 400B en cluster
Sur une seule Spark 128 Go, les MoE de 124 milliards de paramètres tiennent en quantification agressive, avec un débit qui dépend fortement du taux d’activation. En cluster de deux Spark, la barre monte à 405 milliards de paramètres supportés — c’est le chiffre canonique de l’automne 2026, et il ouvre la porte aux modèles de classe 400B en FP8/INT4. Avec un cache KV partagé, un cluster de deux Spark expose un pool de 1 105 096 tokens (août 2026), ce qui autorise des contextes très longs en serving multi-utilisateurs.
Ornith, MiMo-V2.6-Pro et les autres
La rentrée a aussi vu arriver Ornith et MiMo-V2.6-Pro, deux modèles open source qui ont fait l’objet de portages NVFP4 spécifiques pour GB10. Ils complètent une offre qui couvre désormais tous les usages : du 7B rapide pour l’agentique au 124B pour le raisonnement lourd, en passant par les modèles de diffusion.
Benchmarks réels : le tableau de bord de l’automne 2026
Le 29 septembre 2026, Artificial Analysis a publié AA-AgentPerf-Local, un outil open source pour mesurer la vitesse des agents IA locaux sur laptops et workstations. Au lancement, quatre matériels sont testés — DGX Spark, Ryzen AI Halo, MacBook Pro (M5 Pro), RTX 5090 — sur quatre modèles open weight. C’est la première fois qu’un benchmark agentique standardisé inclut le Spark, et cela change la lecture des performances : on ne mesure plus seulement des tokens par seconde en génération pure, mais le débit d’un agent qui enchaîne appels d’outils, lectures de fichiers et raisonnements.
Le contexte concurrentiel s’est lui aussi durci. Le 14 octobre 2026, l’AMD Ryzen AI Halo 192GB est arrivé chez Micro Center à 7 299,99 $, premier desktop compact capable de charger des modèles open weight de 300 milliards de paramètres. Les benchmarks indépendants cités par TechTimes sont nuancés : le Halo charge plus gros, mais le DGX Spark reste devant en vitesse. C’est un arbitrage capacité/vitesse qui structure désormais le marché.
Côté logiciel, la pile vLLM sur DGX Spark a été documentée en détail par l’équipe vLLM dès juin 2026 : architecture, configuration, serving local. C’est aujourd’hui la référence pour qui veut du serving multi-utilisateurs sur GB10, avec TensorRT-LLM en alternative pour les charges figées et llama.cpp pour l’expérimentation rapide. Le guide de Pyshine reste la synthèse la plus complète des tailles de modèles supportées sur 1, 2, 4 et 8 Spark, avec les débits de décodage à 273 Go/s comme goulot principal.
Un gros ou deux petits ? La question de l’automne
La nouvelle grille tarifaire impose une question que personne ne se posait en 2025 : à 4 999 $ le 64 Go et plus de 6 000 $ le 128 Go, vaut-il mieux un gros ou deux petits ? Frandroid pose explicitement la question, et la réponse dépend de l’usage.
- Un seul 128 Go : la zone de confort des 7B–32B avec contexte long, et la falaise des 70B en quantification agressive. C’est le choix de la simplicité, sans câble, sans switch, sans NCCL à configurer.
- Deux 64 Go en cluster : la capacité agrégée dépasse celle d’un seul 128 Go, et le pool de cache KV partagé ouvre des contextes que le mono-nœud ne peut pas tenir. Mais on paie la complexité : câblage, configuration réseau, et un débit single-stream qui ne double pas.
- Un seul 64 Go : la porte d’entrée agentique. 30–35B en local, 1 PFLOP, et la possibilité de clusteriser plus tard. C’est le positionnement exact de l’ASUS Ascent GX10 64GB.
Le curieux « 2 plus rapide que 3 » documenté dans la littérature cluster (deux nœuds bien appariés surpassent trois nœuds mal équilibrés) reste d’actualité : le partitionnement des poids et l’équilibrage de charge comptent plus que le nombre brut de machines.
Clusters DGX Spark : ce qui marche vraiment en 2026
Le clustering est devenu la vraie histoire de l’année. Avec 405 milliards de paramètres supportés sur deux nœuds et un pool de cache KV de plus d’un million de tokens, la paire de Spark n’est plus un jouet de laboratoire. Les chiffres d’août 2026 sur DeepSeek-V4-Flash FP8 en TP=2 via vLLM — ~41 tok/s single-stream, ~350 tok/s agrégé à c=32, ~1 785 tok/s en prefill — montrent un rendement réaliste : le débit agrégé scale bien, le single-stream beaucoup moins.
À quatre nœuds, on entre dans le royaume des MoE et des 400B, avec des contraintes réseau qui deviennent dominantes. À huit nœuds, le cluster existe surtout sur le papier pour les particuliers : le coût, la complexité et les limites de bande passante en font une affaire d’équipe, pas de développeur solo. La DGX Station for Windows, avec ses 748 Go cohérents et 20 PFLOPs FP4 au Q4 2026, pourrait d’ailleurs court-circuiter le débat : pourquoi empiler huit Spark quand une Station fait le travail ? La réponse tient au prix et à la consommation — mais la question mérite d’être posée.
Fine-tuning local : ce qui est réaliste, ce qui ne l’est pas
Le fine-tuning reste l’argument massue du DGX Spark face aux Mac et aux mini-PC AMD : l’écosystème CUDA complet, Unsloth, PEFT, TRL, et les wheels précompilés pour Blackwell. Sur 128 Go, le LoRA sur des modèles jusqu’à 70B en QLoRA est réaliste, avec des temps d’entraînement qui se comptent en heures, pas en jours. Sur 64 Go, on descend confortablement à la classe 30–35B, ce qui couvre l’immense majorité des cas d’usage métier.
Ce qui n’est pas réaliste : le full fine-tuning de modèles de plus de 30B sur une seule machine, et le pré-entraînement, même sur petit corpus. Le fine-tuning de modèles de diffusion (Nemotron-Labs-Diffusion, DiffusionGemma) reste par ailleurs mal outillé : les recettes LoRA standard ne s’appliquent pas directement à un objectif conjoint AR-diffusion, et aucune recette publique n’existe à ce jour. C’est un chantier ouvert pour 2027.
Sources
- NVIDIA — DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI (2 octobre 2026)
- NVIDIA — DGX Spark and Station, open source frontier models (10 août 2026)
- Pause Hardware — Le DGX Spark perd la moitié de sa mémoire mais conserve son tarif de 4 999 $ (2 octobre 2026)
- Frandroid — Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ? (2 octobre 2026)
- Clubic — NVIDIA lance un DGX Spark 64 Go (2 octobre 2026)
- NeoTeo — DGX Spark 64 Go : NVIDIA annonce une configuration (3 octobre 2026)
- Kod.ru — DGX Spark с 64 ГБ памяти (3 octobre 2026)
- Hardware & Co — Le DGX Spark se prend une cure d’amaigrissement (2 octobre 2026)
- ASUS — Ascent GX10 64GB: Compact Agentic AI Supercomputer (5 octobre 2026)
- Techgenyz — ASUS Ascent GX10 vs NVIDIA DGX Spark (5 octobre 2026)
- Tech-Inside — NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs (8 octobre 2026)
- TechTimes — AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed (14 octobre 2026)
- Artificial Analysis — AA-AgentPerf-Local (29 septembre 2026)
- vLLM — vLLM on the DGX Spark: Architecture, Configuration, and Local Serving (1er juin 2026)
- Pyshine — The Best DGX Spark for Local AI in 2026 (1er octobre 2026)
- OutilsIA — NVIDIA DGX Spark 2026 : comparatif complet (mise à jour du 10 octobre 2026)
- Programmez! — DGX Spark
- Glukhov — DGX Spark vs Mac Studio vs RTX 4080
- DeepWiki — reproduction indépendante DeepSeek V4 Flash
Article recherché et rédigé automatiquement · Magazine Electrosens