
 NVIDIA DGX Spark · 4 November 2026
LLM open source sur NVIDIA GB10 DGX Spark : 64 Go, NVFP4, PAIR, fine-tuning et clusters — le point complet à l’automne 2026
Le 23 octobre 2026, la DGX Spark 64 Go est arrivée en boutique à 4 999 dollars, pendant que la version 128 Go franchissait les 6 000 dollars sur le marché. Neuf mois après la commercialisation, l’écosystème logiciel — PAIR, NVFP4, CUDA 13.0, TensorRT-LLM, vLLM — a mûri au point de faire tourner des modèles de 120 milliards de paramètres en local, et même des MoE de 284 à 405 milliards de paramètres sur deux nœuds. Nemotron, Llama, Qwen, DeepSeek, Ant Ling, Poolside Laguna, MiMo-V2.6 et une myriade de runtimes optimisés se disputent la machine. Voici l’état des lieux complet, chiffres à l’appui.
Un petaflop dans une boîte de 1,2 kg : la promesse GB10 tient-elle ?
Quand NVIDIA a dévoilé la DGX Spark au CES 2025, l’annonce avait des airs de gadget marketing : un ordinateur de bureau de 150 × 150 × 50,5 mm pesant 1,2 kg, capable de délivrer environ 1 petaflop de performance IA en FP4. Un an et demi plus tard, la machine s’est imposée comme une catégorie à part entière, entre le PC gaming haut de gamme et la station de travail professionnelle — et elle a même essaimé en plateforme : ASUS l’a déclinée en Ascent GX10 64 Go, Microsoft en Surface RTX Spark Dev Box, Acer en mini-PC GB10 livré depuis le 8 septembre 2026.
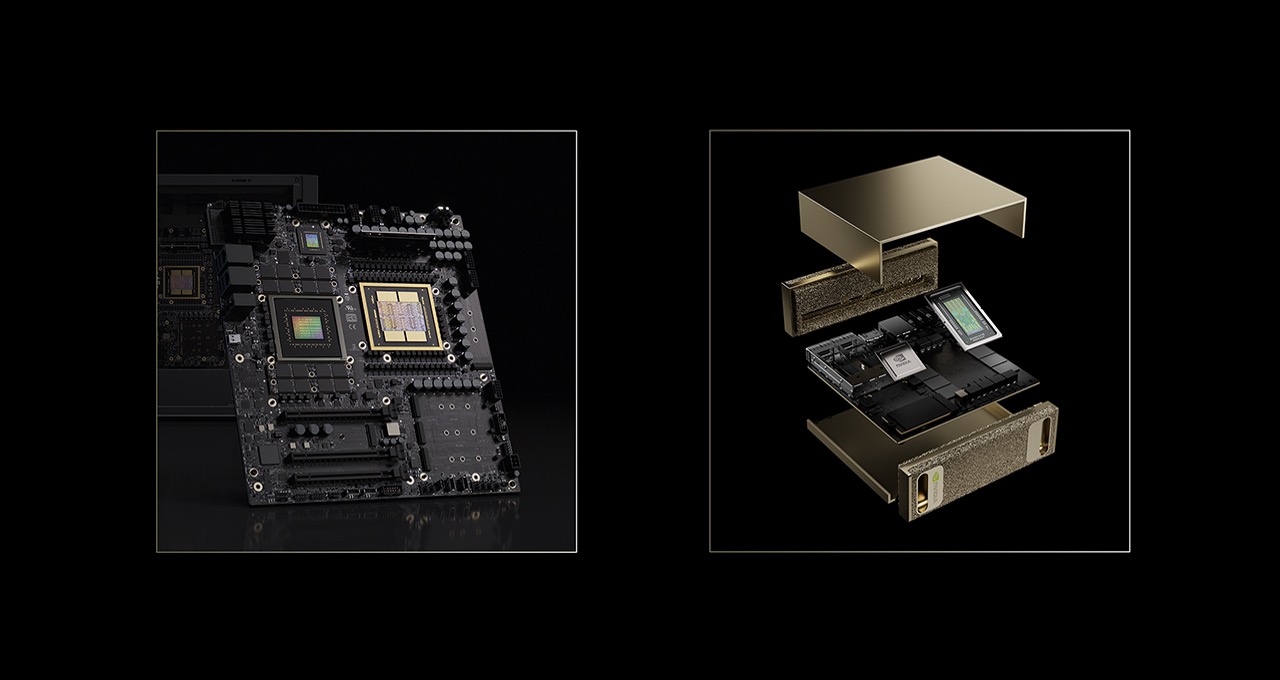
Le cœur de la bête est la superpuce Grace Blackwell GB10, qui combine un CPU ARM Grace (20 cœurs Neoverse V2) et un GPU Blackwell (6 144 cœurs CUDA, l’équivalent d’une RTX 5070) dans un même package, reliés par une interconnexion NVLink-C2C. La mémoire unifiée LPDDR5X de 128 Go est accessible par le CPU et le GPU sans copie, ce qui change radicalement la donne par rapport à une architecture classique où la VRAM est un goulot d’étranglement. La bande passante annoncée de 273 Go/s place la machine dans une catégorie intermédiaire entre un Mac Studio M2 Ultra (800 Go/s) et un PC portable équipé d’une RTX 5090 (32 Go de VRAM, mais avec une bande passante GDDR7 bien supérieure). Le TDP système tourne autour de 170 W, et la machine reste silencieuse au repos (36 °C / 3 W en idle, selon les relevés communautaires).
Le prix, lui, a connu des soubresauts spectaculaires. Lancée à 3 999 $ en octobre 2025, la DGX Spark est passée à 4 699 $ en février 2026, puis a grimpé à 6 950 $ au 2 octobre 2026 — soit 74 % de hausse en un an à configuration identique, selon Frandroid. En France, la Founders Edition était passée de 4 099 à 4 800 euros en février, et le Dell Pro Max 4 To testé en mai s’affichait déjà à 7 149 euros chez Dell avant cette nouvelle hausse. La cause : la crise de la RAM, qui frappe de plein fouet une machine bâtie autour de 128 Go de LPDDR5X. Depuis, la version 128 Go a dépassé les 6 000 dollars sur le marché, selon Pause Hardware.
C’est précisément ce qui explique la réponse de NVIDIA : une déclinaison 64 Go, annoncée à 4 999 $ et disponible depuis le 23 octobre 2026, uniquement chez Acer, Asus, Dell, Gigabyte, HP et MSI — pas de Founders Edition dorée en 64 Go. C’est exactement la même machine que la version 128 Go (même GB10, même CPU 20 cœurs, même GPU 6 144 cœurs CUDA, même bande passante de 273 Go/s, même ConnectX-7 pour le clustering), avec la moitié de la RAM (64 Go) et un SSD raboté (2 To au lieu de 4). Le prix européen n’est pas communiqué ; à ce rythme, on devrait tourner autour de 5 000 euros. Détail savoureux relevé par Clubic : la version 64 Go coûte 1 000 dollars de plus que le prix de lancement de la version 128 Go en 2025 — la mémoire est devenue plus chère que le silicium.
Côté logiciel, la machine a bénéficié de mises à jour régulières. En juin 2026, NVIDIA a déployé une mise à jour majeure promettant un gain de performance de 2,6× grâce au format de quantification propriétaire NVFP4, une pile logicielle enrichie et un support CUDA étendu. Le blog officiel « New Software and Model Optimizations Supercharge NVIDIA DGX Spark » documente ces évolutions, notamment l’optimisation de TensorRT-LLM et la collaboration avec llama.cpp. La machine supporte désormais CUDA 13.0 (confirmé par les guides de premier boot de l’été 2026), avec des prérequis précis : Docker, et les ports TCP 8355 (LLM) et 8356 (VLM) pour les services d’inférence. En juillet 2026, une nouvelle mise à jour (DGX Spark Software Updates – July 2026 Release) a encore amélioré le support CUDA, les performances d’inférence et ajouté de nouveaux SDK. Plus récemment, le 30 octobre 2026, NVIDIA a détaillé un workflow en ligne de commande pour faire tourner Nemotron-3.5 Lightning sur DGX Spark 64 Go, avec données de benchmark et résultats de décodage spéculatif à l’appui, selon blockchain.news.
Le 3 septembre 2026, NVIDIA a officialisé PAIR (Personal AI Router), un outil gratuit et open source pour orchestrer l’IA locale sur ses machines, et une gamme de PC « Spark » pré-construits arrivés sur le marché en octobre. Cette annonce marque un tournant : la DGX Spark n’est plus seulement un mini-supercalculateur pour développeurs, mais la tête de pont d’un écosystème plus large, avec des PC portables RTX Spark (ASUS, MSI, Microsoft Surface Laptop Ultra) et des mini-PC concurrents comme celui d’Acer, qui promet 128 Go de mémoire unifiée et le support de modèles à 200 milliards de paramètres pour 500 à 1 000 $ de moins que la DGX Spark. Trois semaines avant la sortie du 64 Go, NVIDIA a également annoncé des agents locaux packagés, qui s’appuient sur cette pile.
128 Go (ou 64 Go) de mémoire unifiée : le vrai game-changer pour les LLM open-source
La spécification la plus importante de la DGX Spark n’est ni le petaflop FP4 ni le CPU ARM, mais bien sa mémoire unifiée LPDDR5X. C’est elle qui permet d’exécuter des modèles que même les GPU les plus chers ne peuvent pas charger en VRAM.
Un GPU classique comme la RTX 5090 dispose de 32 Go de VRAM. Pour faire tourner un modèle de 70 milliards de paramètres en FP16, il faut environ 140 Go — impossible. Même en FP4, un modèle 70B pèse environ 35 Go, ce qui passe tout juste, mais sans laisser de place pour le cache KV (le contexte). La DGX Spark, avec ses 128 Go, peut charger des modèles jusqu’à environ 200 milliards de paramètres en quantification FP4, selon les estimations de la communauté. En pratique, les utilisateurs rapportent des exécutions fluides de modèles 120B (GPT-OSS, Nemotron-3-Super, Poolside Laguna S 2.1) et même de MoE massifs comme DeepSeek V4 Flash (284B de paramètres totaux, mais seulement 13B actifs par token). Sur deux nœuds, la taille maximale de modèle supportée grimpe à 405 milliards de paramètres, avec un pool de cache KV partagé de 1 105 096 tokens (relevés d’août 2026).
La bande passante de 273 Go/s est le facteur limitant pour la génération de tokens (le « decode »), qui est essentiellement liée à la mémoire. C’est pourquoi les benchmarks montrent des débits de 35 à 80+ tokens/s pour des modèles 120B, et des vitesses bien plus élevées pour les petits modèles. Le « prefill » (le traitement du prompt) est, lui, limité par le calcul, et la machine excelle dans ce domaine grâce à ses cœurs Tensor de 5e génération : 410 tok/s en prefill sur DeepSeek-V4-Flash IQ2_XXS avec le fork ds4.c, et jusqu’à ~1 785 tok/s en prefill sur deux nœuds avec vLLM en FP8.
Comparons avec les alternatives. Un Mac Studio M2 Ultra avec 128 Go unifiés offre une bande passante de 800 Go/s, ce qui le rend plus rapide pour le decode, mais son écosystème logiciel pour l’IA est moins mature (pas de TensorRT-LLM, support CUDA absent). La RTX 5090, avec ses 32 Go, ne peut tout simplement pas charger les gros modèles. L’AMD Ryzen AI Halo, dans sa version 192 Go lancée à 7 299,99 $ chez Micro Center le 14 octobre 2026, est un concurrent sérieux : c’est le premier desktop compact capable de charger des modèles open-weight de 300 milliards de paramètres, et il atteignait 34-39 tok/s sur des modèles 120B en septembre 2026. Mais TechTimes est catégorique : « DGX Spark Still Wins on Speed » — la Spark garde l’avantage sur le débit, grâce à un écosystème logiciel bien plus optimisé. En mai 2026, 70 à 80 % des acheteurs de DGX Spark déclaraient néanmoins préférer le Strix Halo pour un usage généraliste. La DGX Spark occupe donc un créneau unique : la capacité d’un petit serveur dans un format de mini-PC, avec le meilleur support logiciel du marché — mais à un prix qui ne cesse de grimper. Et la concurrence ne s’arrête pas là : NVIDIA prépare une DGX Station for Windows à 748 Go de mémoire cohérente et 20 petaflops FP4, attendue au quatrième trimestre 2026 chez six partenaires OEM, selon tech-insider.org.
Nemotron, Llama, Qwen, DeepSeek, Ant Ling, Poolside, MiMo : qui tient vraiment la cadence sur Spark ?
Le paysage des modèles open-source optimisés pour la DGX Spark a considérablement évolué depuis janvier 2026. NVIDIA a publié une matrice de support officielle pour TensorRT-LLM, listant les modèles testés et optimisés. En voici la synthèse, mise à jour avec les sorties de l’été et de l’automne 2026 :
| Famille | Modèles notables | Taille | Quantification supportée | Retours communauté |
|---|---|---|---|---|
| Nemotron | Nemotron-3-Super-120B, Nemotron-3.5 Lightning | 120B | NVFP4, FP8 | 35-80+ tok/s, excellent raisonnement ; Lightning optimisé pour le 64 Go (workflow CLI du 30 octobre 2026) |
| GPT-OSS | GPT-OSS-120B | 120B | NVFP4 | Débit ~4x supérieur à Qwen 3.5 27B, mais moins bon en code |
| Llama | Llama 3.3-70B, Llama 4 (Scout/Maverick) | 70B-400B | NVFP4, INT8 | Llama 3 70B plus rapide que les 120B |
| Qwen | Qwen 3 (235B), Qwen 3.6 35B A3B, Qwen3.6-27B, Qwen3.8-27B, Qwen3.8-Flash-Next | 27B-235B | NVFP4, UD-Q4_K_XL | Qwen 3.6 35B A3B : 200+ tok/s en NVFP4 ; Qwen3.6-27B : 163 tok/s en pic, 136 tok/s en multi-agents ; Qwen3.8-Flash-Next : 83→138 tok/s avec MTP |
| DeepSeek | V3/R1 (671B MoE), V4 Flash 0731 (284B, 13B actifs) | 284B-671B | NVFP4, Q8 | V4 Flash : ~41 tok/s single-stream sur 2× Spark, ~350 tok/s agrégé à concurrence 32 ; ~14 tok/s single-stream sur 1× Spark |
| Ant Ling | Ling-3.0-Flash 124B-A5B | 124B (5B actifs) | NVFP4 | 15-20 tok/s sur 1× Spark, 256K contexte |
| Poolside | Laguna S 2.1 | 118B (8,5B actifs) | NVFP4 | Premier grand open-weight américain depuis 11 mois, domine les benchmarks code |
| Xiaomi | MiMo-V2.6 (Pro, Flash, 9B) | jusqu’à ~1T classe labo | NVFP4 | Sorti le 22 septembre 2026 sous licence MIT, gains d’efficacité inédits |
Les retours de la communauté, notamment sur les forums NVIDIA et Spark Arena, montrent que les modèles MoE (Mixture of Experts) sont particulièrement adaptés à la machine. DeepSeek V4 Flash 0731, sorti fin juillet 2026, est un cas d’école : avec seulement 13 milliards de paramètres actifs, il offre des performances « frontier-level » pour l’agentique, selon les tests de flowtivity.ai. Sur une seule Spark, le fork CUDA d’antirez/ds4 atteint 410 tok/s en prefill et environ 14 tok/s en single-stream (août 2026) ; sur deux Spark en TP=2 avec vLLM et DeepSeek-V4-Flash en FP8, on monte à ~41 tok/s single-stream, ~350 tok/s agrégés à concurrence 32 et ~1 785 tok/s en prefill. À noter que la suite llama.cpp GGUF atteint jusqu’à 67 tok/s sur des modèles 35B-A3B — un rappel que les petits MoE restent les rois du débit sur cette machine.
Ant Ling-3.0-Flash, publié le 23 juillet 2026 par Ant Group, est un autre exemple frappant : 124 milliards de paramètres totaux, mais seulement 5 milliards d’actifs par token, grâce à une architecture hybride (attention KDA et MLA empilées 5:1). Sur une seule DGX Spark, il atteint 15-20 tok/s, avec une fenêtre de contexte native de 256K tokens extensible à 1M. C’est un modèle pensé pour l’agentique, capable de traiter des documents entiers en une seule passe, avec un MMLU d’environ 87 et un HumanEval d’environ 90.
Poolside a frappé fort le 23 juillet 2026 avec Laguna S 2.1, un modèle de 118B paramètres (8,5B actifs) taillé pour le code et l’agentique. C’est le premier grand open-weight américain depuis 11 mois, et il domine les benchmarks de codage face à des modèles 10 fois plus gros, tout en tenant dans un seul desktop. Les tests communautaires sur Spark Arena confirment des débits de 35-80+ tok/s en NVFP4.
Qwen3.6-27B, sorti le 22 avril 2026 avec une version NVFP4 le 26 juin 2026, reste une valeur sûre : 27B paramètres, 256K de contexte, 163 tok/s en pic de decode, 136 tok/s en multi-agents (10 agents), et un score MMLU de 0,8446 en NVFP4. La version Qwen3.8-27B, testée le 20 août 2026, atteint 34-38 tok/s en génération. Plus récemment, Qwen3.8-Flash-Next a reçu le support Multi-Token Prediction (MTP) : selon banandre.com, le débit passe de 83 à 138 tok/s sans perte de qualité, avec vérification exacte — une optimisation à surveiller pour les usages agentiques. Llama 4 (Scout et Maverick) est également supporté, mais les benchmarks précis manquent encore dans les sources publiques. Les utilisateurs rapportent que Llama 3.3-70B en NVFP4 est plus rapide que les modèles 120B, ce qui en fait un choix pragmatique pour les usages quotidiens.
Enfin, la rentrée a été marquée par l’arrivée de Xiaomi MiMo-V2.6, dévoilé le 22 septembre 2026 sous licence MIT (Pro, Flash et un modèle 9B). Selon Forkast, le MiMo-V2.6-Pro égale Grok 4.7 sur l’Intelligence Index et surpasse Claude Opus 5 sur plusieurs benchmarks clés, avec des gains d’efficacité qualifiés d’« inédits » par WinBuzzer. Attention toutefois : eWeek souligne que ses gains issus du RL n’ont pas encore été répliqués indépendamment et reposent sur une infrastructure d’entraînement coûteuse. Xiaomi a par ailleurs mené un entraînement RL diffusé en direct, avec un burn rate de 432 000 $/jour — un signal de transparence qui défie les limites habituelles de la communication sur les modèles frontière.
Benchmarks réels : ce que crache vraiment une Spark
Le 29 septembre 2026, Artificial Analysis a lancé AA-AgentPerf-Local, un benchmark dédié aux performances agentiques en local, testé au lancement sur quatre matériels (DGX Spark, Ryzen AI Halo, MacBook Pro M5 Pro, RTX 5090) et quatre modèles open-weight. C’est la première tentative sérieuse de normaliser les comparaisons entre machines locales, et la DGX Spark y figure en bonne place grâce à son support CUDA. Pour les débits bruts, les chiffres consolidés d’août 2026 donnent une image plus nuancée que la communication de NVIDIA :
- 1× DGX Spark, DeepSeek-V4-Flash IQ2_XXS (ds4.c) : ~14 tok/s single-stream, 410 tok/s en prefill.
- 1× DGX Spark, llama.cpp GGUF (35B-A3B) : jusqu’à 67 tok/s.
- 2× DGX Spark, vLLM TP=2, DeepSeek-V4-Flash FP8 : ~41 tok/s single-stream, ~350 tok/s agrégés à concurrence 32, ~1 785 tok/s en prefill.
- 2× DGX Spark : taille maximale de modèle supportée de 405 milliards de paramètres, pool de cache KV partagé de 1 105 096 tokens.
La leçon est claire : la Spark n’est pas une machine de génération ultra-rapide en single-stream sur les gros modèles — c’est une machine de capacité et de débit agrégé. Pour un usage agentique multi-requêtes, le scaling en cluster change tout ; pour un chat interactif sur un modèle 120B, on est plutôt à 35-40 tok/s, ce qui reste parfaitement utilisable mais loin des 200+ tok/s d’un petit MoE. Le guide de pyshine.com sur les tailles de modèles et les clusters reste la référence la plus complète pour se repérer.
Fine-tuning sur DGX Spark : ce que la stack permet vraiment
La question revient sans cesse : peut-on entraîner sur une Spark, ou seulement inférer ? La réponse est nuancée. Avec 128 Go de mémoire unifiée et un GPU de 6 144 cœurs CUDA, la machine peut faire du fine-tuning par LoRA et QLoRA sur des modèles de taille moyenne (7B à 70B selon la quantification), via les frameworks classiques (PyTorch, Hugging Face PEFT, Unsloth). Le support CUDA 13.0 et les SDK mis à jour en juillet 2026 ont fluidifié ces workflows, et la communauté a publié des recettes pour entraîner des adaptateurs LoRA sur des modèles 27B-35B en QLoRA 4 bits sans saturer la mémoire.
En revanche, il ne faut pas attendre de la Spark qu’elle remplace un cluster d’entraînement : un full fine-tuning d’un modèle 70B est hors de portée, et même un LoRA sur 120B demande des compromis sévères (séquences courtes, batch de 1, gradient checkpointing agressif). La vraie force de la machine en matière d’adaptation, c’est le fine-tuning léger pour l’agentique : adapter un Qwen3.8-27B ou un Llama 3.3-70B à un domaine métier, puis servir le modèle en NVFP4 avec TensorRT-LLM ou vLLM. C’est exactement le workflow que PAIR vient orchestrer : router les requêtes vers le bon modèle (gros modèle pour le raisonnement, petit modèle pour les tâches rapides), et exposer le tout comme un service local. Pour les équipes qui veulent aller plus loin, le clustering ConnectX-7 permet de répartir l’entraînement LoRA sur deux nœuds, mais le gain reste modeste face au coût du matériel.
Clusters DGX Spark : deux, quatre, huit nœuds
Le clustering est l’argument le plus sous-estimé de la Spark. Grâce au ConnectX-7 (200 Gb/s par nœud) et à la mémoire unifiée, deux Spark forment un nœud logique de 256 Go capable de charger des modèles jusqu’à 405 milliards de paramètres — c’est le cas d’usage qui justifie vraiment l’achat, notamment pour DeepSeek V4 Flash en FP8 avec vLLM en tensor parallel. Les relevés d’août 2026 montrent un passage de ~14 tok/s (1 nœud) à ~41 tok/s single-stream (2 nœuds) et ~350 tok/s agrégés à concurrence 32, avec un prefill qui bondit à ~1 785 tok/s.
Au-delà de deux nœuds, l’histoire se complique. Quatre Spark (512 Go) permettent de charger des modèles de classe 671B en quantification agressive, mais le rendement du tensor parallel se dégrade et la complexité opérationnelle explose. Huit Spark (1 To de mémoire) relèvent davantage de l’expérimentation que de la production : c’est le sujet d’un article dédié de ce magazine, qui démonte le mythe du « gros cluster » facile. La recommandation pragmatique reste : une Spark pour découvrir, deux pour la production agentique sérieuse, au-delà pour la recherche. Et avec la version 64 Go à 4 999 $, l’équation « deux petits plutôt qu’un gros » (2 × 64 Go = 128 Go pour ~10 000 $, contre 6 000-6 950 $ pour une 128 Go) mérite d’être posée — Frandroid pose d’ailleurs explicitement la question. La réponse dépend du besoin : deux nœuds offrent le clustering et le double de bande passante agrégée, mais coûtent plus cher, consomment plus et ajoutent de la latence réseau.
PAIR, PC Spark et l’écosystème logiciel : où en est-on vraiment ?
PAIR (Personal AI Router), officialisé le 3 septembre 2026, est sans doute la brique logicielle la plus importante de l’année pour la Spark. Gratuit et open source, il orchestre plusieurs modèles locaux, route les requêtes selon la complexité et le type de tâche, et expose une interface unifiée pour les agents. C’est la réponse de NVIDIA à la fragmentation des runtimes (TensorRT-LLM, vLLM, llama.cpp, Ollama) : plutôt que d’imposer un moteur, PAIR les fédère. Pour les développeurs, cela signifie qu’un même poste peut servir un petit modèle rapide pour l’autocomplétion et un gros modèle pour le raisonnement, sans changer d’infrastructure.
Autour de la Spark, l’écosystème matériel s’est densifié : ASUS Ascent GX10 64 Go (même GB10, 1 petaflop, ciblé agents et modèles 30-35B), Acer mini-PC GB10 128 Go livré depuis le 8 septembre 2026 à 500-1 000 $ sous le prix NVIDIA, Surface RTX Spark Dev Box et Surface Laptop Ultra chez Microsoft, sans oublier les PC portables RTX Spark d’ASUS et MSI. Côté système, Microsoft a présenté le 7 octobre 2026 sa vision « Windows for Hybrid Intelligence », qui fait de Windows 11 26H2 la plateforme des agents IA locaux — avec DeepSeek V4 Flash cité parmi les modèles mis en avant. La Spark n’est donc plus une curiosité isolée : elle est devenue le fer de lance d’une catégorie entière, du mini-PC de développeur au laptop « AI PC » haut de gamme.
Reste la question qui fâche : le prix. À 6 950 $ pour la 128 Go et 4 999 $ pour la 64 Go, la Spark est chère face à un Ryzen AI Halo 192 Go à 7 299 $ qui charge des modèles de 300B, ou face à un Mac Studio M2 Ultra 128 Go plus rapide en decode. Sa justification tient à trois choses : l’écosystème CUDA (TensorRT-LLM, NVFP4, vLLM optimisé), le clustering ConnectX-7, et le format. Pour un développeur qui veut faire tourner des agents locaux, fine-tuner des adaptateurs et servir des modèles en production légère, c’est aujourd’hui la plateforme la plus complète — à condition d’accepter de payer la prime NVIDIA. Pour les autres, la concurrence n’a jamais été aussi crédible.
Sources
- Frandroid — Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ?
- NVIDIA Blog — DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI
- Pause Hardware — Le DGX Spark perd la moitié de sa mémoire mais conserve son tarif de 4 999 dollars
- Clubic — NVIDIA lance un DGX Spark 64 Go : moins de mémoire, mais une drôle d’astuce pour dépasser le modèle 128 Go
- NeoTeo — DGX Spark 64 Go : NVIDIA annonce une configuration
- Generation-NT — Nvidia DGX Spark 64 Go : moins de mémoire pour plus cher et toujours pour l’IA locale
- ASUS Press — ASUS Ascent GX10 64GB: Compact Agentic AI Supercomputer
- Techgenyz — ASUS Ascent GX 10 vs NVIDIA DGX Spark: Same GB 10 Platform, Very Different Prices
- TechTimes — AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed
- tech-insider.org — NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs
- blockchain.news — NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM
- pyshine.com — The Best DGX Spark for Local AI in 2026: LLM Speed, Model Sizes, and Clusters
- vLLM — vLLM on the DGX Spark: Architecture, Configuration, and Local Inference
- banandre.com — Qwen3.8-Flash-Next et Multi-Token Prediction
- Forkast — Xiaomi MiMo-V2.6
- WinBuzzer — Xiaomi MiMo-V2.6
- eWeek — Xiaomi MiMo-V2.6 : les limites des gains RL
- Microsoft — Building Windows for Hybrid Intelligence
- Journal du Geek — Oubliez l’IA, Windows présente son « Intelligence Hybride »
- Branchez-vous — Microsoft Surface Laptop Ultra et Surface RTX Spark
- Artificial Analysis — AA-AgentPerf-Local (lancement du 29 septembre 2026)
Article recherché et rédigé automatiquement · Magazine Electrosens