
Qwen 3.5 122B en Int4 sur DGX Spark : la recette qui pulvérise les 100 tokens/s
Décryptage de la recette la plus rapide jamais publiée pour faire tourner Qwen 3.5 122B en Int4 sur un DGX Spark, issue de six mois de benchmarks réels et de collaboration communautaire. L’article détaille les réglages précis (quantization, batch size, speculative decoding, paramètres CUDA) qui perm
Perplexity Portable Computer : la fin du cloud pour les agents IA ? Décryptage sur DGX Spark
Décryptage en profondeur du lancement du « Portable Computer » de Perplexity, développé en partenariat avec Nvidia, et de son intégration dans l’écosystème DGX Spark / RTX Spark. Nous analysons l’architecture de cet agent 100% local promettant zéro coût de token, ses implications pour les modèles op
DGX Station for Windows : le nouveau géant de bureau qui éclipse le DGX Spark ?
NVIDIA vient de dévoiler la DGX Station for Windows, un poste de travail promettant un supercalculateur à trillion de paramètres sur le bureau. Cet article décrypte en profondeur cette annonce majeure : quelles sont les spécifications réelles, comment se positionne-t-elle face au DGX Spark (GB10) po
Speculative decoding sur DGX Spark : la ruse qui fait exploser le débit d’inférence sans sacrifier un seul token de qualité
Dossier technique de fond sur le speculative decoding appliqué au DGX Spark : comment cette technique de draft model permet de multiplier le débit d’inférence des LLM open source (Llama, Qwen, DeepSeek) sur la mémoire unifiée du GB10, sans perte de qualité. L’article détaille le principe, les implém
NVIDIA PAIR et les PC Spark : la fin du tout-cloud a peut-être vraiment commencé
Décryptage en profondeur de l’annonce NVIDIA du 3 septembre 2026 : l’outil PAIR (Personal AI Runtime ?) et les nouveaux agents d’IA locale, couplés à la révélation des PC Spark pré-construits pour octobre. On analyse ce que ces nouveautés changent concrètement pour les possesseurs de DGX Spark : sim
Mac Studio vs DGX Spark : le duel des mini-supercalculateurs qui a redéfini l’IA locale en 2026
Comparatif argumenté entre le Mac Studio (puce Apple Silicon) et le NVIDIA DGX Spark (GB10 Grace Blackwell) pour faire tourner des LLM open source en local. L’article analyse les performances brutes (benchmarks récents, y compris les 17 LLM testés sur GB10), l’écosystème logiciel (CUDA vs Metal, sup
M5 Ultra vs DGX Spark : le duel des stations IA locales en 2026 — lequel choisir pour vos LLM ?
Comparatif approfondi entre l’Apple M5 Ultra et le NVIDIA DGX Spark pour l’inférence et le fine-tuning de LLM open source. Analyse des performances brutes (tokens/s, mémoire unifiée), de l’écosystème logiciel (CUDA vs Metal/MLX), de la consommation et du prix. Verdict nuancé selon les usages : créat
RTX Spark, N1X, GB10 : trois noms, un seul die — le grand démêlage pour possesseurs de DGX Spark
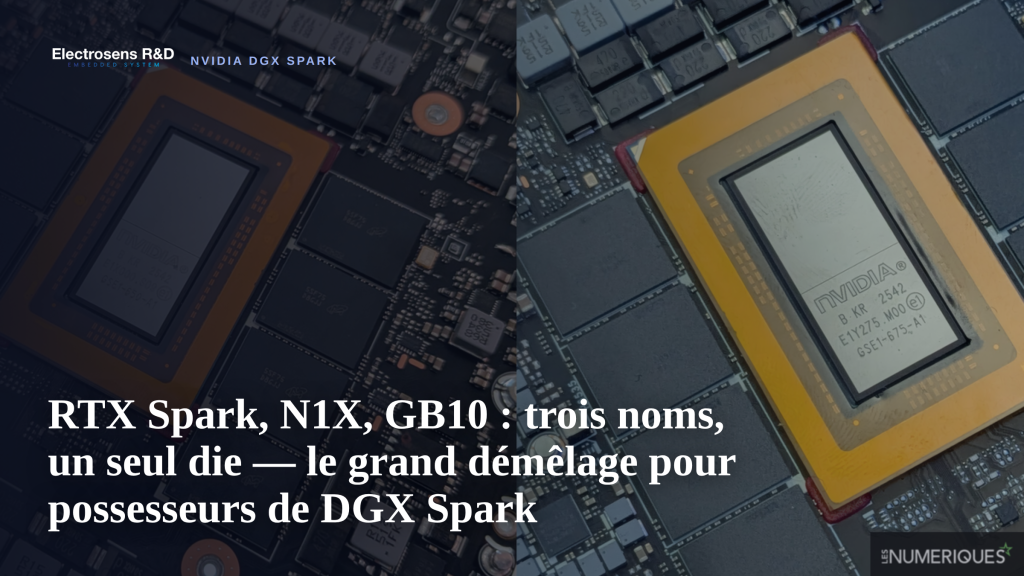
NVIDIA brouille les pistes avec trois étiquettes pour un même silicium. Ce décryptage remonte à la source de la confusion entre RTX Spark, le nom de code N1X et le GB10 du DGX Spark, et explique ce que cela change concrètement pour les développeurs et possesseurs de machines. On y détaille les impli
DGX Spark : quand NVIDIA lâche les rênes, l’écosystème s’emballe
NVIDIA ne vend plus seul le DGX Spark : Acer, Asus, Dell, Lenovo et MSI lancent leurs propres mini-PC basés sur le GB10. Ce dossier dissèque cette ouverture soudaine de l’écosystème, ses implications pour les possesseurs actuels et futurs, et propose un guide pratique pour choisir sa machine selon s
Fine-tuning sur DGX Spark : construire un pipeline de production reproductible
Dossier technique de fond sur l’industrialisation du fine-tuning sur DGX Spark. Le sujet couvre l’état de l’art des méthodes (LoRA, QLoRA, full fine-tuning), la comparaison des outils disponibles (PyTorch natif, Unsloth, Axolotl, playbooks NVIDIA), et la construction d’un pipeline complet et reprodu