
 NVIDIA DGX Spark · 9 November 2026
DGX OS 8 sur DGX Spark : ce que la mise à jour d’octobre 2026 change vraiment sous le capot du GB10
NVIDIA a fait rouler la mise à jour d’octobre 2026 sur les DGX Spark : nouveau socle logiciel, pilotes rafraîchis, conteneurs réorganisés, firmware à reflasher dans le bon ordre. Sur le papier, c’est une simple release de plus dans le cycle semestriel. En pratique, c’est le genre de transition qui peut vous coûter une nuit blanche si vous la traitez comme un `apt upgrade` anodin — ou vous faire gagner des points de performance réels si vous la préparez. Voici le mode d’emploi argumenté.
Octobre 2026 : la mise à jour qui rebat les cartes sur un bureau
Le 21 octobre 2026, le forum développeur de NVIDIA a ouvert un fil sobrement intitulé « DGX Spark Software Updates — October 2026 Release ». Derrière cette entrée de changelog se cache une réalité beaucoup plus tangible pour quiconque possède un GB10 : une refonte de la pile système, qui touche au noyau, aux pilotes GPU/CUDA, à l’empilement conteneurs, au firmware et aux outils de gestion. Autrement dit, à peu près tout ce qui fait qu’une machine de ce type est utilisable pour faire tourner des LLM en local.
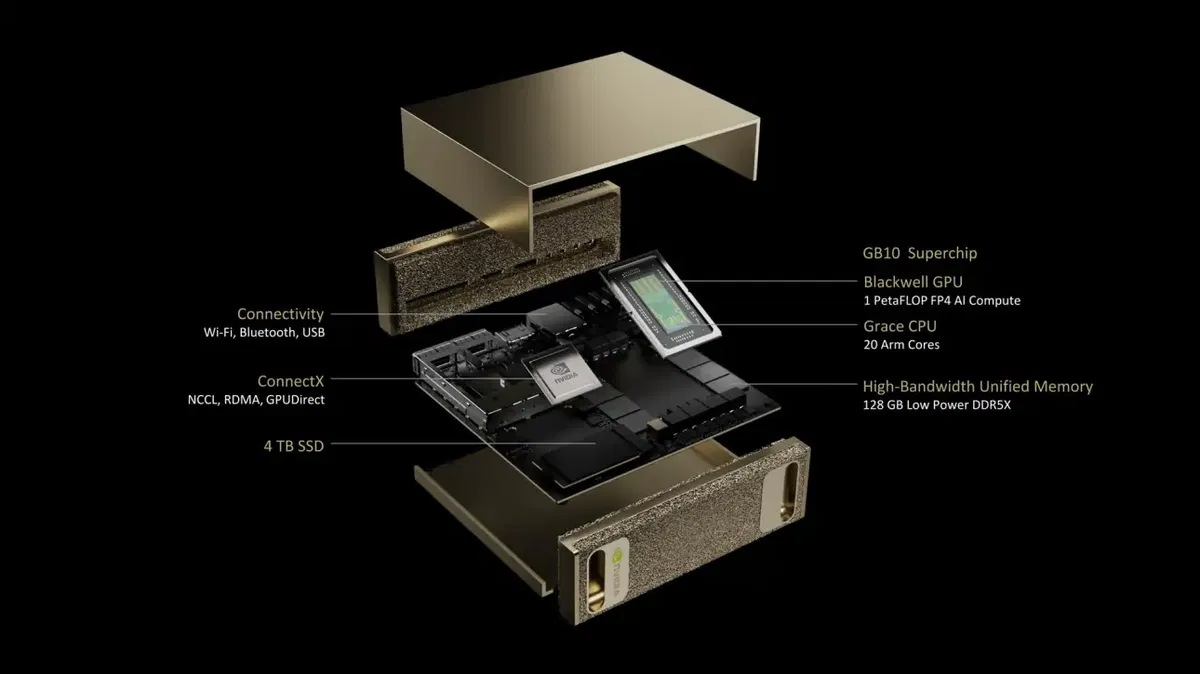
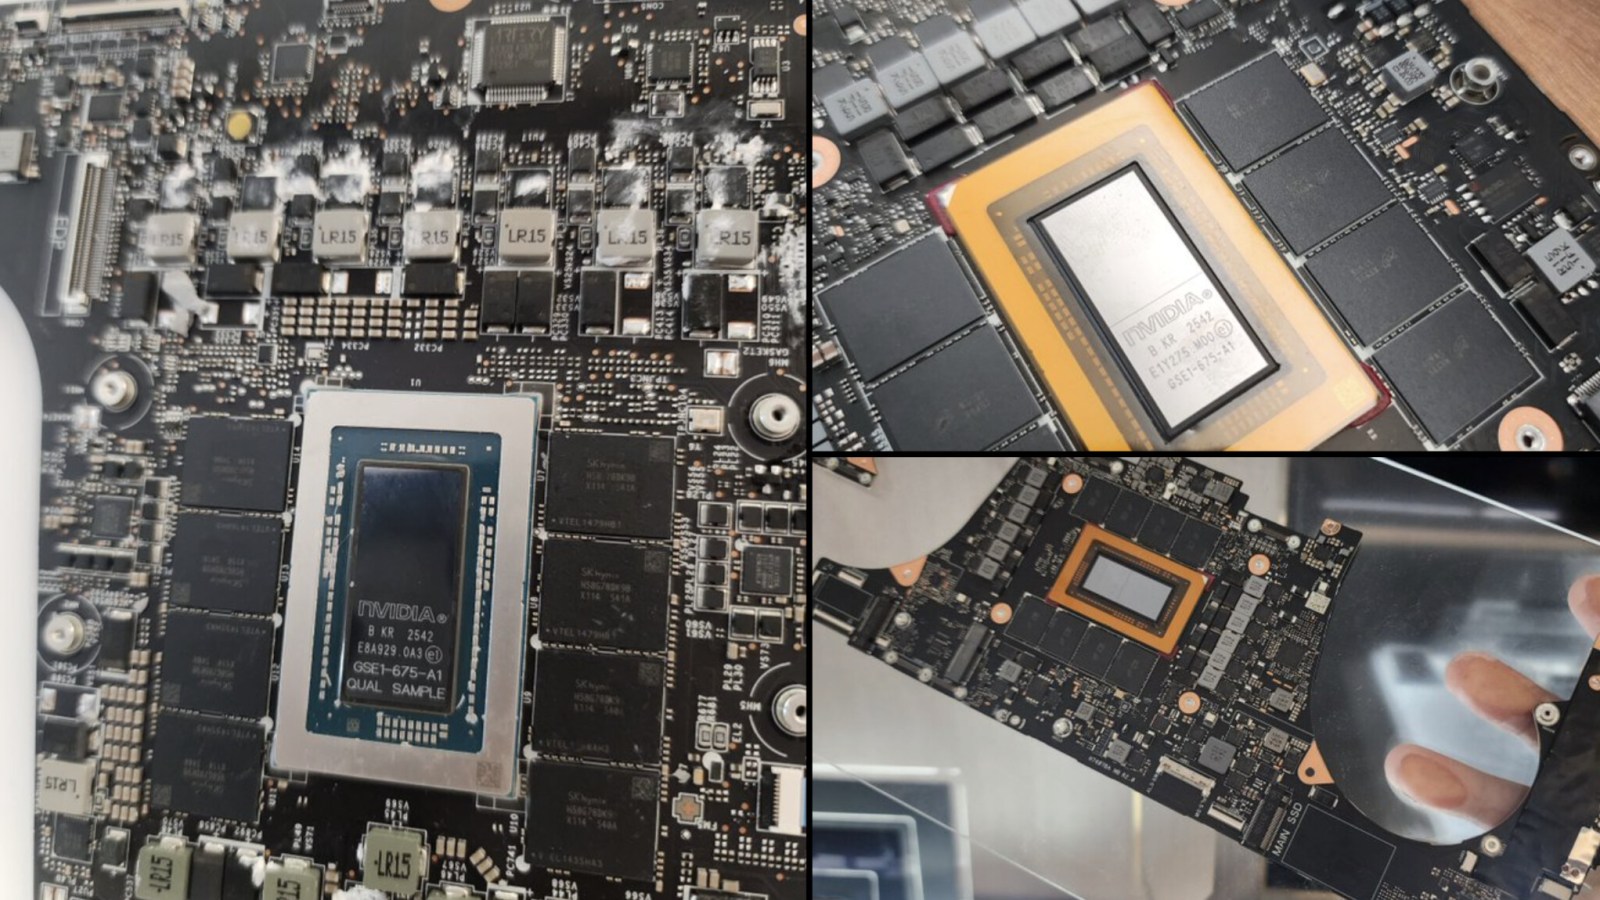
Pour comprendre pourquoi cette release mérite mieux qu’un haussement d’épaules, il faut se rappeler ce qu’est un DGX Spark. Sous le capot, un superchip GB10 Grace Blackwell : 20 cœurs Arm (10 Cortex-X925 + 10 Cortex-A725), un GPU Blackwell, 128 Go de LPDDR5X unifiée partagée entre CPU et GPU via un interconnect à environ 273 Go/s, jusqu’à 1 PFLOP en FP4. Pas de VRAM séparée : tout le monde puise dans le même pool. C’est cette architecture qui rend la machine si intéressante pour l’inférence de gros modèles open weight — et si particulière à administrer. Quand on n’a pas de mémoire dédiée au GPU, le système d’exploitation et les pilotes ne sont pas de simples couches logicielles : ils font partie intégrante de la gestion mémoire de la charge IA.
La promesse d’octobre 2026 est donc double. D’un côté, un socle modernisé, aligné sur les versions récentes de CUDA, de noyau et de runtime conteneurs, qui doit débloquer des stacks plus récentes (vLLM, TensorRT-LLM, PyTorch compilés contre les bonnes versions) et corriger des irritants accumulés depuis le lancement. De l’autre, une tension opérationnelle : toute machine déjà en production, avec ses recettes d’inférence, ses images conteneurs et parfois son cluster à deux nœuds, doit absorber ce saut sans se casser. C’est là que se joue la vraie histoire.
DGX OS 7 → DGX OS 8 : la dette technique qu’il fallait solder
Pour situer le saut, un peu de contexte. Le DGX Spark est arrivé sur le marché en 2025, avec des livraisons attendues autour de juillet 2025 et des précommandes ouvertes dans plusieurs pays européens. Il est livré avec DGX OS, une distribution Linux personnalisée basée sur Ubuntu, avec pilotes et paramètres préconfigurés pour le matériel NVIDIA. La documentation officielle d’intégrateurs comme Ultralytics renvoie d’ailleurs explicitement au guide utilisateur « DGX OS 7 » — c’est la version de référence qui a accompagné la première vraie année de commercialisation du GB10.
Le rythme de publication de DGX OS est régulier : des mises à jour environ deux fois par an, complétées par des correctifs de sécurité intermédiaires. Sur le forum NVIDIA, on retrouve la trace de cette cadence pour le DGX Spark avec des fils dédiés aux releases d’avril 2026, juin 2026 et juillet 2026. Autrement dit, la release d’octobre 2026 n’est pas un ovni : elle s’inscrit dans une série. Mais elle en diffère par l’ampleur.
Ce que la pile d’origine portait comme limitations, il faut le dire franchement : la documentation publique ne détaille pas, ligne par ligne, la liste des dettes techniques soldées par DGX OS 8. Ce qui est documenté, en revanche, c’est la mécanique de la transition : un guide officiel de mise à jour OS et composants, des notes de release et un fil de forum qui décrit les nouveautés de la release d’octobre. C’est sur cette matière — et sur le retour d’expérience de la communauté, notamment ceux qui ont essuyé les plâtres du firmware sur plusieurs machines — qu’il faut s’appuyer pour comprendre ce qui change vraiment.
La rupture tient à un mot : empilement. Jusqu’ici, un DGX Spark vivait avec un noyau, des pilotes, un CUDA et un runtime conteneurs qui formaient un bloc cohérent mais ancien. Passer à DGX OS 8, c’est accepter de faire bouger toutes ces briques en même temps — et donc de devoir vérifier, après coup, que rien ne s’est décroché.
Sous le capot : noyau, CUDA, conteneurs et la nouvelle carte des composants
Soyons précis sur ce qu’on peut affirmer et sur ce qu’on doit laisser en suspens. Les sources officielles fournies (notes de release, guide de mise à jour, fil d’octobre 2026) attestent l’existence et le périmètre de la release, mais ne donnent pas, dans les extraits disponibles, les numéros exacts de version du noyau Linux ni de CUDA embarqués dans DGX OS 8. Il serait malhonnête d’avancer un « noyau 6.x » ou un « CUDA 13 » de mémoire : ce serait inventer. Ce qu’on peut dire avec certitude, c’est la structure du changement.
DGX OS 8 réorganise la pile en quatre couches distinctes, qu’il faut apprendre à traiter séparément lors d’une migration :
| Couche | Rôle sur GB10 | Ce qui change avec DGX OS 8 | Point de vigilance |
|---|---|---|---|
| Firmware (BIOS/EC, ConnectX-7) | Init matérielle, réseau | Reflashage séparé, ordre imposé | À faire avant l’OS |
| Noyau Linux | Gestion mémoire unifiée, pilotes bas niveau | Nouveau noyau, modules recompilés | Redémarrage obligatoire, vérifier uname -r |
| Pilotes GPU + CUDA | Accès au GPU Blackwell, calcul | Pile rafraîchie, ABI potentiellement différente | Wheels PyTorch à recompiler |
| Runtime conteneurs (Docker/containerd + NVIDIA Container Toolkit) | Isolation des stacks | Réorganisation des composants | Images à reconstruire/tester |
| Outils de gestion (DGX Dashboard, Base Command) | Surveillance, mises à jour | Nouvelle carte des composants | Chemins et habitudes à réapprendre |
Face à DGX OS 7, la différence n’est pas cosmétique : c’est un changement de contrat entre les couches. Là où une Ubuntu de référence (par exemple une 26.04 LTS, noyau 7.0, support cinq ans extensible à quinze via Ubuntu Pro) vous laisse assembler vous-même pilotes et CUDA, DGX OS 8 impose un ensemble validé par NVIDIA. Le compromis est classique : moins de liberté, mais une cohérence testée en usine. Pour un cluster de production, c’est généralement le bon deal — à condition d’accepter que la mise à jour ne soit pas une simple opération de paquets.
Le mécanisme de mise à jour lui-même mérite qu’on s’y arrête. Le DGX Spark embarque un DGX Dashboard intégré, qui permet la surveillance temps réel et l’application des mises à jour système. C’est la voie recommandée pour un utilisateur seul. Pour une machine en production, le guide officiel de mise à jour OS et composants décrit une procédure plus granulaire, où le firmware et l’OS se traitent dans un ordre précis. C’est ce détail — l’ordre — qui a fait trébucher plus d’un utilisateur.
Ce qui gagne, ce qui casse : l’anatomie des régressions
La communauté des premiers jours du GB10 a documenté, parfois douloureusement, ce qui se passe quand on met à jour un DGX Spark sans méthode. Le blog Petronella Tech a publié un retour d’expérience très concret, intitulé « DGX Spark Firmware Update: What We Learned on 8 GB10 Units ». Huit machines, un même firmware, et des enseignements qui valent pour toute la flotte : le firmware ne se met pas à jour comme un paquet, il exige une séquence, et se tromper d’ordre peut laisser la machine dans un état intermédiaire peu engageant.
Les points de rupture typiques d’un saut DGX OS 7 → DGX OS 8 se répartissent en quatre familles :
-
Les wheels PyTorch et les extensions compilées. Un wheel PyTorch compilé contre une version de CUDA donnée ne fonctionne pas nécessairement après un saut de pilote. Sur GB10, l’architecture Arm ajoute une couche : beaucoup de paquets doivent être compilés spécifiquement pour
aarch64, et les roues précompilées sont moins nombreuses que sur x86. Après migration, prévoyez de réinstaller vos environnements Python propres. -
Les conteneurs qui ne redémarrent plus. Une image construite sur DGX OS 7 embarque parfois des bibliothèques liées à l’ancienne ABI. Après passage à DGX OS 8, elle peut refuser de démarrer ou planter silencieusement. La règle : reconstruire les images à partir des bases à jour, ne pas se contenter de relancer les anciennes.
-
Le firmware dans le désordre. C’est le piège le plus coûteux. Le firmware du GB10 et celui de la carte réseau ConnectX-7 doivent être à jour avant l’OS, sinon certaines fonctions réseau (essentielles pour un cluster) peuvent ne pas s’initialiser correctement.
-
Les outils de gestion déplacés. Le DGX Dashboard et les outils de gestion système changent de présentation et parfois de chemins. Les scripts maison qui s’appuyaient sur d’anciens chemins doivent être revus.
À cela s’ajoute un piège spécifique à l’architecture unifiée : l’absence d’OOM killer. Sur un DGX Spark, quand le pool mémoire unifié sature, le système ne tue pas le processus fautif — il gèle. C’est un comportement documenté par des sources tierces (tokios.com), et il devient plus critique encore après une migration, parce qu’on teste de nouveaux modèles et de nouveaux contextes sans toujours surveiller la consommation.
Mesures avant/après : tokens/s, latence et mémoire unifiée sur GB10
Abordons la question que tout le monde se pose : est-ce que DGX OS 8 rend la machine plus rapide ? La réponse honnête est : cela dépend de la charge, et les chiffres constructeur demandent à être lus avec soin.
Commençons par le chiffre qui circule le plus. NVIDIA a communiqué un débit de 82 739 jetons/s pour le DGX Spark. Ce chiffre est souvent cité comme une performance d’inférence — ce qu’il n’est pas. Comme l’a relevé une source tierce (tokios.com), il s’agit d’un débit global de fine-tuning multi-flux, pas d’inférence mono-utilisateur. En inférence interactive, la même source évoque une fourchette de 15 à 120 jetons/s selon la taille du modèle et le moteur (vLLM, llama.cpp). C’est cette fourchette-là qui compte pour un usage quotidien.
Les chiffres canoniques de notre magazine donnent un ordre de grandeur plus concret, mesurés sur DGX Spark en 2026 :
| Configuration | Charge | Débit mesuré |
|---|---|---|
| 1× DGX Spark | DeepSeek-V4-Flash IQ2_XXS (llama.cpp), single-stream | ~14 tok/s |
| 1× DGX Spark | DeepSeek-V4-Flash IQ2_XXS, prefill | 410 t/s |
| 1× DGX Spark | GGUF 35B-A3B (llama.cpp), débit max | jusqu’à 67 tok/s |
| 2× DGX Spark (TP=2, vLLM) | DeepSeek-V4-Flash FP8, single-stream | ~41 tok/s |
| 2× DGX Spark (TP=2, vLLM) | DeepSeek-V4-Flash FP8, agrégé @ c=32 | ~350 tok/s |
| 2× DGX Spark (TP=2, vLLM) | DeepSeek-V4-Flash FP8, prefill | ~1785 t/s |
Ces chiffres sont ceux d’une plateforme en régime, pas d’une comparaison stricte DGX OS 7 vs DGX OS 8. Les sources fournies ne contiennent pas de benchmark avant/après isolant la contribution du nouveau noyau ou des pilotes rafraîchis. C’est une limite qu’il faut assumer : personne, dans la matière disponible, n’a publié une mesure propre de type « même modèle, même moteur, OS 7 vs OS 8 ». Ce qu’on peut dire, c’est que les gains attribuables à une pile rafraîchie se jouent principalement sur trois terrains : le temps de chargement des modèles (moins de recompilation à chaud), la stabilité du prefill sur de longs contextes, et la compatibilité avec les versions récentes de vLLM et TensorRT-LLM — qui, elles, apportent de vraies optimisations.
Un mot sur les optimisations MoE, justement, parce qu’elles illustrent où se trouve le vrai levier de performance sur GB10. Dans un article technique du 27 octobre 2026, NVIDIA détaille trois leviers pour accélérer l’inférence MoE sur DGX Spark, à partir d’une évaluation de Ling-3.0-flash d’Inclusion AI en batch-size-1. Un blog tiers (Netics Labs, 31 octobre 2026) rapporte que ces optimisations font passer le temps par token de sortie de 27,71 ms à 9,72 ms sur DGX Spark, tout en soulignant que le re-run sur GSM8K montre quelle part de ce gain synthétique survit à une charge réelle. C’est exactement le bon réflexe : distinguer le gain de banc d’essai du gain en production.
Fine-tuning local : LoRA, QLoRA et le piège du pool mémoire unifié
Sur le fine-tuning, DGX OS 8 ne change pas la donne fondamentale du GB10 : la mémoire unifiée est à la fois une bénédiction et un piège. Bénédiction, parce qu’un modèle dense 70B en NVFP4 (environ 35 Go de poids) laisse encore de la marge pour le cache KV ; un MoE 35B en NVFP4 (environ 18 Go) permettrait même un contexte de 128K en cache KV FP8 avec de la place à revendre. Piège, parce que si vous poussez trop loin, la machine ne renvoie pas un joli message d’erreur — elle gèle.
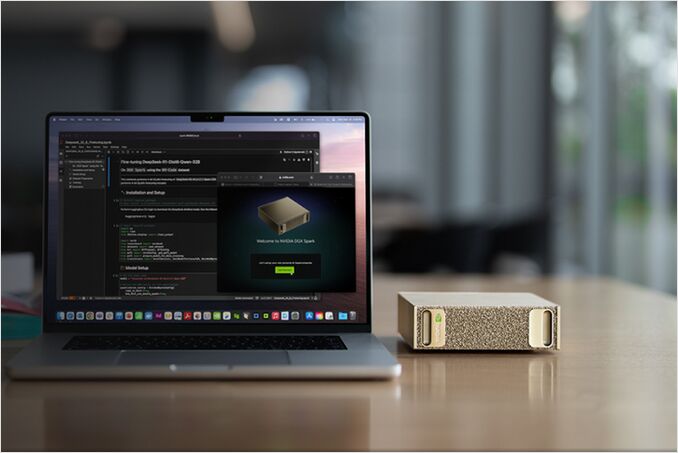
Pour le fine-tuning léger, les stacks de référence (PyTorch, PEFT, Unsloth) doivent être réinstallées après migration, précisément parce que les wheels compilés contre l’ancienne pile CUDA ne sont plus garantis. Unsloth documente d’ailleurs un guide dédié au fine-tuning de LLM sur DGX Spark, ce qui en fait un point de départ raisonnable pour vérifier que votre environnement fonctionne après la mise à jour. La règle pratique : après passage à DGX OS 8, recréez vos environnements virtuels depuis zéro plutôt que de tenter de rafistoler l’existant.
Migrer sans casser : le guide pas-à-pas du GB10 en production
Voici la procédure ordonnée, celle qui évite les mauvaises surprises. Elle s’appuie sur le guide officiel de mise à jour OS et composants et sur les retours de la communauté.
1. Sauvegarder. Pas seulement les données : les recettes d’inférence (fichiers de configuration vLLM, scripts llama.cpp, paramètres TensorRT-LLM), les Dockerfiles, les images conteneurs (docker save), et les environnements Python si vous y tenez. Un tar de votre répertoire de travail ne suffit pas.
2. Mettre à jour le firmware d’abord. C’est l’étape que tout le monde saute et qui coûte le plus cher. Le firmware du GB10 et celui de ConnectX-7 doivent être à jour avant l’OS. Suivez la séquence du guide, redémarrez, vérifiez.
3. Appliquer la mise à jour OS. Via le DGX Dashboard pour un usage simple, via la procédure officielle pour une machine en production. Ne coupez pas l’alimentation.
4. Vérifier les pilotes et CUDA après redémarrage. Contrôlez la version du noyau (uname -r), la version du pilote NVIDIA (nvidia-smi), la version de CUDA. Comparez avec ce que la release annonce.
5. Valider les conteneurs. Reconstruisez vos images depuis les bases à jour. Testez chaque stack séparément : vLLM, llama.cpp, TensorRT-LLM, PyTorch.
6. Prévoir un rollback. Le mécanisme de partitions A/B (si votre machine le propose) ou une image système sauvegardée avant migration est votre filet de sécurité. Ne migrez jamais sans.
7. Attendre, parfois. Si votre cluster tourne en production et que vous n’avez pas de fenêtre de maintenance, attendez que les premiers correctifs post-release soient publiés. L’historique des releases DGX Spark (avril, juin, juillet 2026) montre que NVIDIA corrige rapidement.
Clusters DGX Spark : ce que la mise à jour change quand on est deux
Le cluster, c’est le cas où la prudence paie le plus. Deux DGX Spark peuvent être clusterisés via ConnectX-7 et le NVIDIA Sync Cluster Assistant, totalisant 128 Go et supportant jusqu’à 200 milliards de paramètres selon NVIDIA. Notre magazine documente d’ailleurs des configurations allant jusqu’à 405 milliards de paramètres sur deux nœuds. NVIDIA revendique jusqu’à +70 % sur Qwen 3.8 27B en cluster — un chiffre constructeur, non reproduit indépendamment dans nos sources, à prendre pour ce qu’il est.
La règle d’or en cluster : mettre à jour les nœuds dans le bon ordre, et ne jamais laisser deux nœuds sur des versions différentes. Un nœud en DGX OS 7 et un nœud en DGX OS 8 ne formeront pas un cluster sain. La procédure : arrêter le cluster, mettre à jour le nœud secondaire d’abord (ou le primaire, selon la documentation NVIDIA), vérifier, puis l’autre. Ne redémarrez jamais les deux simultanément.
Après la migration : ce que DGX OS 8 rend enfin possible
Une fois la poussière retombée, que gagne-t-on vraiment ? D’abord, l’accès aux stacks récentes : vLLM, TensorRT-LLM et PyTorch dans leurs versions alignées sur la pile CUDA rafraîchie. Ensuite, la possibilité de tirer parti des optimisations MoE documentées par NVIDIA — celles qui font passer le temps par token de 27,71 ms à 9,72 ms sur banc d’essai. Enfin, un socle plus sain pour les charges de fine-tuning local, avec des outils comme Unsloth qui suivent la cadence.
Ce qu’il faut encore surveiller : la compatibilité des frameworks au fil de l’eau (toutes les roues ne sont pas disponibles en aarch64), le support communautaire (moins de monde que sur x86, donc des réponses plus lentes sur les forums), et la cadence des correctifs. La release d’octobre 2026 s’inscrit dans un cycle semestriel ; attendez-vous à des correctifs intermédiaires dans les semaines qui viennent.
Face à la prochaine échéance, la posture raisonnable est celle de l’administrateur méthodique : migrer tôt sur une machine de test, migrer tard sur la production, et toujours avec un rollback prêt. DGX OS 8 n’est pas une révolution — c’est un assainissement. Et sur une machine où le système d’exploitation fait partie intégrante de la gestion mémoire de la charge IA, un assainissement bien mené vaut mieux qu’une course à la dernière version.
Sources
- DGX Spark Software Updates — October 2026 Release (forum NVIDIA)
- DGX Spark Release Notes — NVIDIA Documentation Hub
- OS and Component Update Guide — DGX Spark User Guide
- DGX Spark Software Updates — July 2026 Release
- DGX Spark Software Updates — June 2026 Release
- DGX Spark Software Updates 04/2026
- DGX Spark Firmware Update: What We Learned on 8 GB10 Units — Petronella Tech
- 3 Ways to Boost MoE Inference on NVIDIA DGX Spark — NVIDIA Technical Blog
- Three MoE Inference Optimizations on DGX Spark — Netics Labs
- NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM — blockchain.news
- NVIDIA makes DGX Spark more accessible with a new 64 GB model — MSN
- NVIDIA Unveils 64GB DGX Spark Starting at $4,999 — Techaeris
- Guide DGX Spark — Ultralytics Docs
- NVIDIA DGX Spark — Rost Glukhov
- DGX Spark Memory Tuning — Tokios Docs
- Fine-tuning LLMs with NVIDIA DGX Spark and Unsloth — Unsloth Docs
- NVIDIA @ GTC Berlin 2026: Big upgrades to DGX Spark + Station — Tech-Critter
- RLC Pro AI delivers top AI performance on NVIDIA DGX Spark — Business Insider
Article recherché et rédigé automatiquement · Magazine Electrosens