
 NVIDIA DGX Spark · 31 August 2026
DGX Spark en 2026 : clusters désagrégés, DeepSeek V4 Flash et fine-tuning BF16 — le GB10 a-t-il enfin tenu ses promesses ?
Le DGX Spark est une petite merveille de calcul — 128 Go de mémoire unifiée, 1 pétaflop en FP4, un SoC Grace Blackwell qui fait tourner des modèles de 70 milliards de paramètres sur un bureau. Mais dès qu’on branche un deuxième Spark, la question change de nature : comment faire travailler ensemble des machines dont le point fort est la puissance locale, pas le réseau ? La réponse, explorée par une poignée de pionniers depuis quelques mois, s’appelle la désagrégation matérielle — et elle pourrait bien transformer votre cluster personnel en véritable petite infrastructure d’inférence. Un an et demi après son annonce au CES 2025, le mini-supercalculateur de NVIDIA a-t-il enfin tenu ses promesses ? Entre benchmarks impressionnants sur les modèles MoE récents comme DeepSeek V4 Flash 0731 et Ant Ling-3.0-Flash, mise à jour logicielle majeure et clusters multi-nœuds enfin matures, l’été 2026 restera comme la saison où le supercalculateur personnel est devenu une réalité tangible.
Le Spark, une fusée à un étage : pourquoi la puissance locale bute sur le réseau
Posons le décor. Le DGX Spark, lancé en 2025, repose sur le SoC GB10 Grace Blackwell : un CPU ARM à 20 cœurs (10 Cortex-X925, 10 Cortex-A725) couplé à un GPU Blackwell de génération consumer (SM121) avec 6 144 cœurs CUDA, 192 Tensor Cores de 5e génération et 48 RT Cores de 4e génération. Le tout délivre 1 pétaflop de performance IA en FP4, avec 128 Go de mémoire unifiée LPDDR5X à 273 Go/s. De quoi faire tourner localement des modèles jusqu’à 200 milliards de paramètres en quantification NVFP4, et des modèles de 70B en pleine précision FP8. La machine ne mesure que 15 cm de côté pour 5,05 cm d’épaisseur, consomme 240 watts et se pose sur un bureau — un contraste saisissant avec le DGX-1 de 2016, qui pesait plus de 60 kilos, occupait un rack entier et coûtait 129 000 dollars.
En solo, le Spark impressionne. Les benchmarks officiels NVIDIA pour le fine-tuning donnent le vertige : 13 519,54 tokens/s pour Llama 3.2 3B en full fine-tuning, 6 969,59 tokens/s pour Llama 3.1 8B en LoRA, et 759,79 tokens/s pour Llama 3.3 70B en QLoRA. Côté génération d’images, Flux.1 12B en FP4 produit une image 1K en 2,6 secondes sous TensorRT. Pour une machine de bureau à moins de 5 000 dollars, c’est remarquable.
Mais voilà le paradoxe. Dès qu’on veut passer à l’échelle — deux, quatre, huit Spark — la donne change. Le Spark n’a pas de NVLink-C2C inter-nœuds. Les liaisons entre machines passent par l’Ethernet, et la version de base plafonne à 10GbE. En option, on peut installer une carte ConnectX-7 qui monte à 200 Gbps en RoCE (RDMA over Converged Ethernet), mais ce n’est pas le défaut. Résultat : la bande passante inter-nœuds est entre 10 et 100 fois inférieure à celle d’un cluster DGX H100 équipé de NVLink/NVSwitch. Le Spark est une fusée à un étage : puissant au décollage, mais incapable de propulser une charge utile qui dépasse sa propre soute.
Ce contraste entre la puissance de calcul embarquée et la faiblesse relative des liens réseau pose une question centrale : comment exploiter plusieurs Spark sans que le réseau ne tue les performances ? La réponse naïve — faire du tensor parallelism classique, comme sur un DGX H100 — se heurte immédiatement au mur de la bande passante. La réponse intelligente, explorée par la communauté depuis le printemps 2026, consiste à ne pas faire travailler les machines ensemble sur le même calcul, mais à leur confier des tâches différentes. C’est exactement ce que recouvre la désagrégation matérielle.
Découper pour régner : la désagrégation matérielle, ou comment spécialiser chaque nœud
L’idée est simple en apparence, révolutionnaire dans ses implications : au lieu de faire tourner l’intégralité du modèle sur chaque machine, on répartit les phases d’un cycle d’inférence sur des nœuds dédiés. Un Spark s’occupe du prefill — le calcul des clés et valeurs initiales du prompt —, un autre du decode — la génération token par token —, un troisième du fine-tuning, un quatrième des agents. Chaque machine fait une seule chose, mais elle la fait parfaitement.
Cette approche, connue sous le nom de PD-disaggregation (Prefill/Decode disaggregation), n’est pas nouvelle dans les data centers. Elle est au cœur de l’architecture de DistServe et des déploiements industriels depuis 2024. Mais l’appliquer à un cluster de DGX Spark, c’est-à-dire à des machines de bureau connectées par un réseau modeste, change la donne. Pourquoi ? Parce que le prefill et le decode n’ont pas les mêmes besoins. Le prefill est limité par le calcul : il faut traiter des milliers de tokens de prompt en parallèle, une opération très intensive en opérations matricielles. Le decode, lui, est limité par la bande passante mémoire : à chaque token généré, il faut recharger l’intégralité des poids du modèle depuis la mémoire. Sur un Spark avec 273 Go/s de bande passante, le decode d’un modèle 70B en FP8 plafonne mécaniquement autour de 15-20 tokens/s, quel que soit le nombre de cœurs CUDA.
En séparant les deux phases, on peut optimiser chaque nœud pour sa tâche. Le nœud de prefill peut utiliser des batchs énormes, saturer les Tensor Cores, et renvoyer le KV-cache — l’ensemble des clés et valeurs calculées — au nœud de decode. Le nœud de decode, lui, n’a plus qu’à générer, sans se soucier du prompt. Cette séparation permet aussi de réduire la latence perçue (le TTFT, time to first token) puisque le prefill n’attend pas que le decode ait fini de générer les tokens précédents.
Concrètement, sur un cluster de deux Spark, le gain est double. D’abord, la mémoire combinée de 256 Go permet de charger des modèles plus gros : environ 140 milliards de paramètres en FP8, contre 70B sur un seul nœud. Ensuite, l’inférence concurrente est multipliée par deux : deux requêtes simultanées peuvent être traitées en parallèle, une sur chaque nœud, sans contention. Des tests communautaires récents, notamment sur les forums NVIDIA, montrent qu’un déploiement de DeepSeek V4 Flash-0731 sur deux Spark — avec 13 milliards de paramètres actifs par token — atteint environ 30 tokens/s en configuration par défaut, et davantage après ajustement des paramètres d’acceptance. C’est un exemple frappant de ce que la désagrégation permet : un modèle d’agent de 200 milliards de paramètres totaux, tournant sur deux machines de bureau, avec un débit utilisable pour des agents autonomes.
Le talon d’Achille : un réseau qui change toute l’équation
Il faut être honnête : le réseau est le point faible du Spark, et c’est lui qui rend la désagrégation à la fois nécessaire et difficile. Les sources officielles NVIDIA ne mentionnent pas de NVLink-C2C inter-nœuds pour le Spark. La connectivité standard est de l’Ethernet 10GbE — largement suffisant pour de l’administration, mais très insuffisant pour du tensor parallelism. En option, une carte ConnectX-7 permet de monter à 200 Gbps en RoCE (RDMA), avec des câbles QSFP112 DAC. C’est cette option qui rend les clusters multi-Spark réellement viables pour la désagrégation, car elle permet des transferts de KV-cache à grande vitesse entre nœuds.
Le guide officiel de clustering NVIDIA précise que chaque DGX Spark possède deux ports QSFP (parfois appelés « ports ConnectX-7 ») à l’arrière de l’appareil. Chaque port fournit jusqu’à 200 Gb/s, mais la vitesse effective dépend aussi du câble utilisé — il faut des câbles connus pour fournir au moins 200 Gb/s. La documentation recommande notamment des câbles approuvés comme l’Amphenol NJAAKK-N911 (400 mm, 32 AWG). Attention au piège : la topologie PCIe unique du Spark peut semer la confusion lors de la configuration IP, et la documentation officielle consacre une section entière à ce sujet.
Comparons avec un cluster DGX H100 : là-bas, le NVLink et le NVSwitch offrent une bande passante inter-GPU de 900 Go/s, soit près de 30 fois celle d’un lien ConnectX-7 à 200 Gbps (25 Go/s). Le tensor parallelism, qui consiste à découper les poids du modèle sur plusieurs GPU et à synchroniser les activations à chaque couche, est impensable sur des Spark : la latence de synchronisation serait plus élevée que le temps de calcul lui-même. Le pipeline parallelism, qui découpe le modèle en couches séquentielles, est possible mais sous-optimal : il introduit des bulles de calcul et une latence accrue.
La désagrégation Prefill/Decode contourne élégamment ce problème. Elle ne nécessite qu’un seul transfert de KV-cache par requête, du nœud de prefill vers le nœud de decode. Pour un modèle 70B avec un contexte de 4 000 tokens, le KV-cache représente quelques centaines de mégaoctets — transférable en quelques dizaines de millisecondes sur un lien 200 Gbps. C’est acceptable, surtout si on compare au temps de génération total qui se compte en secondes. En revanche, sur un lien 10GbE, le même transfert prendrait plusieurs secondes, ce qui rendrait la désagrégation inutile. D’où l’importance cruciale de l’option ConnectX-7 pour tout usage multi-nœuds sérieux.
Monter un cluster : 2, 4, 8 Spark, quelles topologies pour quels gains ?
Voyons maintenant les configurations concrètes. Le prix unitaire du Spark a évolué : les faits datés du magazine indiquent 4 699 USD pour un nœud en juillet 2026 (contre 3 999 USD à la sortie). Un cluster de deux Spark revient donc à environ 9 400 USD, un cluster de quatre à environ 18 796 USD. À ces coûts s’ajoutent le réseau (cartes ConnectX-7, câbles QSFP112 DAC, éventuellement un switch) et l’administration.
Configuration 2 nœuds : c’est la plus simple et la plus documentée. Un Spark dédié au prefill, l’autre au decode. La mémoire combinée de 256 Go permet de charger des modèles jusqu’à ~140B en FP8. Des exemples réels existent : le dépôt GitHub elizabetht/spark contient des notebooks de "disaggregated-serving" qui décrivent exactement cette architecture, avec spark-01 en prefill et spark-02 en decode, utilisant NIXL pour le transfert de KV-cache sur RDMA. Le gain en fine-tuning est mesuré : le temps de QLoRA sur Llama 3 70B est divisé par 1,8 par rapport à un nœud unique. Pour l’inférence concurrente, le débit double : deux requêtes simultanées sont traitées en parallèle.
Configuration 4 nœuds : on peut pousser la spécialisation plus loin. Un nœud pour le prefill, deux pour le decode (pour gérer plus de requêtes concurrentes), un pour le fine-tuning ou les agents. La mémoire totale atteint 512 Go, permettant de charger des modèles de l’ordre de 700B en FP8 — en théorie, car la bande passante réseau devient alors le facteur limitant. Il faut aussi prévoir un switch 200 Gbps pour interconnecter les quatre machines, ce qui ajoute un coût non négligeable.
Configuration 8 nœuds : à ce stade, on est dans le domaine du "cluster personnel" haut de gamme, avec un budget matériel de l’ordre de 37 000 USD. La topologie recommandée serait un nœud de prefill, quatre nœuds de decode, deux nœuds de fine-tuning, et un nœud de routage/agents. Mais attention : plus le nombre de nœuds augmente, plus la complexité de gestion et la latence réseau pèsent. La désagrégation n’est pas une baguette magique ; elle exige une orchestration fine. NVIDIA a d’ailleurs officialisé le support multi-nœuds pour le DGX Spark, promettant des modèles jusqu’à 700 milliards de paramètres — mais la réalité du terrain nuance ce chiffre : la bande passante réseau reste le facteur limitant, et les benchmarks publiés en août 2026 montrent que les gains réels dépendent fortement de la topologie choisie (full-mesh, étoile ou 8 nœuds).
| Configuration | Coût matériel (2026) | Mémoire unifiée | Taille max modèle (FP8) | Usage typique |
|---|---|---|---|---|
| 1 Spark | 4 699 USD | 128 Go | ~70B | Inférence mono-utilisateur, fine-tuning léger |
| 2 Spark | ~9 400 USD | 256 Go | ~140B | PD-disaggregation, agents, fine-tuning QLoRA |
| 4 Spark | ~18 796 USD | 512 Go | ~700B (théorique) | Multi-agents, inférence concurrente, fine-tuning |
| 8 Spark | ~37 000 USD | 1 To | >1T (théorique) | Cluster personnel "data center" |
Les modèles qui tournent vraiment sur le GB10 en août 2026
L’été 2026 a vu l’arrivée de modèles open-weight qui changent la donne pour le Spark. Le plus emblématique est DeepSeek V4 Flash 0731, un modèle MoE de 284 milliards de paramètres totaux mais seulement 13 milliards d’actifs par token. Cette architecture le rend particulièrement adapté au Spark : la mémoire unifiée de 128 Go suffit pour charger les poids en quantification Q8 (162 Go en UD-Q8_K_XL, seulement 7 Go de plus que le Q4), et le faible nombre de paramètres actifs permet des vitesses d’inférence impressionnantes. Sur un seul Spark, des tests communautaires rapportent 1 000 tokens/s en prefill et 59 tokens/s en multi-agent serving. Sur deux Spark en configuration désagrégée, le débit atteint environ 30 tokens/s par défaut, et davantage après ajustement des paramètres d’acceptance — un correctif de configuration documenté sur les forums NVIDIA.
Un autre modèle qui fait sensation est Ant Ling-3.0-Flash, publié le 23 juillet 2026 par Ant Group. Avec 124 milliards de paramètres totaux et seulement 5 milliards d’actifs, il surpasse leur précédent modèle 1T sur presque tous les benchmarks. Son architecture hybride (attention KDA et MLA empilées dans un ratio 5:1) et sa fenêtre de contexte native de 256K (extensible à 1M) en font un candidat idéal pour le Spark. Les tests préliminaires indiquent un débit de 15-20 tokens/s sur un seul Spark — remarquable pour un modèle de cette taille.
Côté occidental, Poolside Laguna S 2.1 (118B) a été saluée comme la première grande ouverture de poids américaine depuis 11 mois. Conçue pour le codage agentique, elle tient dans un seul desktop et rivalise avec des modèles dix fois plus grands. Enfin, les modèles Qwen3.6 bénéficient d’améliorations de performance spécifiques au Spark, selon l’annonce NVIDIA au Computex 2026.
La boîte à outils : vLLM, SGLang, NemoClaw, qui tient vraiment la route sur ARM ?
La pile logicielle est un enjeu crucial. Le Spark utilise un CPU ARM (aarch64) et un GPU Blackwell SM121, ce qui n’est pas le combo le plus courant. Heureusement, vLLM — le framework d’inférence open-source le plus utilisé — offre un support officiel pour le DGX Spark depuis le printemps 2026. Le blog vLLM du 1er juin 2026 détaille les bonnes pratiques : utiliser le flag --gpu-memory-utilization pour laisser de la marge dans le pool de mémoire unifiée, et --max-num-seqs à une valeur basse, car le Spark est conçu pour l’inférence en petits batchs. vLLM active les CUDA graphs par défaut, supporte les kernels FP4 et le décodage spéculatif MTP (Multi-Token Prediction) pour améliorer le débit. Un dashboard Grafana officiel (ID 23991) permet de surveiller les métriques en temps réel.
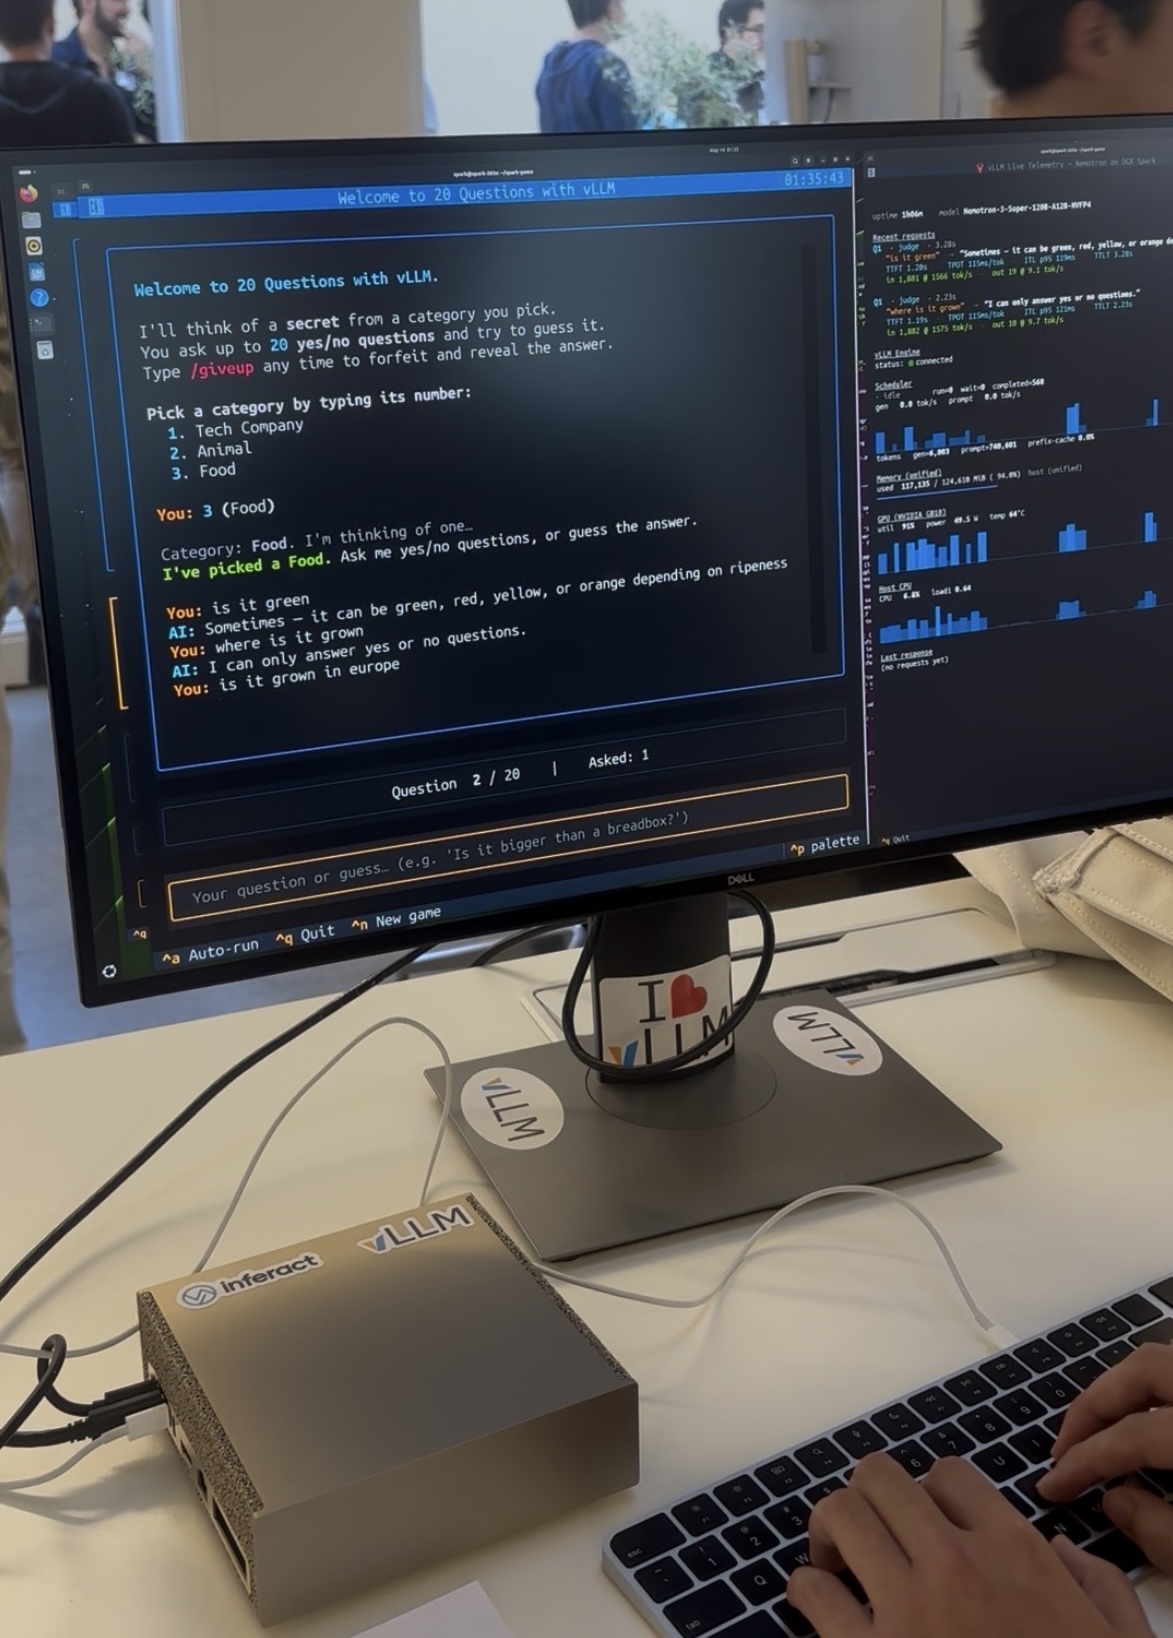
Pour la désagrégation, vLLM 0.13+ intègre un NixlConnector qui permet le transfert de KV-cache entre nœuds via NIXL (NVIDIA’s collective communication library). C’est l’outil de référence pour monter un cluster désagrégé. SGLang propose également une option avec sglang-router pour router les requêtes entre les nœuds de prefill et de decode. Cependant, la stabilité de SGLang et de DistServe sur CPU ARM Grace n’est pas confirmée par des sources officielles ; il faut les tester soi-même. Le dépôt GitHub elizabetht/spark contient des notebooks qui utilisent guidellm pour produire des métriques TTFT/TPOT/ITL et des courbes charge-vs-latence — un excellent point de départ pour qui veut mesurer sa propre configuration.
La grande nouveauté de 2026 est NemoClaw, un blueprint open source de NVIDIA qui empaquette en une seule installation trois éléments : des modèles ouverts, un runtime d’agents et un orchestrateur. Annoncé au Computex 2026, il promet un chemin simplifié de l’ouverture de la boîte à l’exécution d’agents locaux en quelques minutes (hors téléchargement initial du modèle). La version de juin 2026 du système DGX Spark offre l’expérience out-of-box la plus fluide à ce jour, avec des mises à jour over-the-air désormais optionnelles lors de la configuration initiale. Pour les équipes qui veulent passer à l’échelle, NVIDIA propose un guide de configuration de clusters multi-nœuds.
Côté fine-tuning, la nouvelle stack NemoClaw s’ajoute à NeMo, vLLM et llama.cpp. L’exploit du moment : le fine-tuning BF16 d’un modèle 35B sur un seul Spark, rendu possible par la mémoire unifiée de 128 Go et les optimisations logicielles récentes. Les frameworks de fine-tuning comme Unsloth, Axolotl, TRL et LLaMA-Factory ont tous été testés sur le Spark, avec des résultats variables — Unsloth se distingue par sa vitesse, mais la compatibilité ARM reste à vérifier au cas par cas.
Monitoring : que se passe-t-il vraiment sous le capot ?
Vous venez d’installer vLLM sur votre DGX Spark, le modèle tourne, les tokens s’affichent… mais que se passe-t-il vraiment sous le capot ? Latence, throughput, mémoire unifiée, KV cache : sans un bon dashboard, vous pilotez à l’aveugle. Le guide du magazine sur le monitoring vLLM sur DGX Spark en 2026 identifie quatre candidats sérieux (dont le dashboard Grafana officiel ID 23991) et un cinquième qui sort du lot. Les points de rupture documentés incluent la gestion de la mémoire unifiée (nvidia-smi ne rapporte pas la mémoire de la même façon sur le Spark) et la configuration des CUDA graphs. Pour les clusters, le monitoring passe à l’échelle : il faut surveiller le transfert de KV-cache entre nœuds, la latence réseau et l’équilibrage de charge entre prefill et decode.
Fine-tuning local : l’exploit BF16 d’un 35B sur un seul Spark
Le DGX Spark a fait basculer le fine-tuning local dans une nouvelle ère : 128 Go de mémoire unifiée sur un bureau, pour un coût d’accès cloud annoncé à 0,65 $/heure. Mais transformer un notebook de recherche en pipeline de production reproductible demande de la méthode. Le choix entre LoRA, QLoRA et full fine-tuning dépend du modèle et du budget mémoire. L’exploit de l’été 2026 : le fine-tuning BF16 d’un modèle 35B sur un seul Spark, une première qui ouvre des perspectives pour l’adaptation locale de modèles de taille moyenne. Les benchmarks officiels NVIDIA restent impressionnants : 13 519,54 tokens/s pour Llama 3.2 3B en full fine-tuning, 6 969,59 tokens/s pour Llama 3.1 8B en LoRA, et 759,79 tokens/s pour Llama 3.3 70B en QLoRA.
Conclusion : le Spark a-t-il tenu ses promesses ?
Un an et demi après son annonce au CES 2025, le DGX Spark est devenu une référence de l’IA locale. Les promesses initiales — 1 pétaflop FP4, 128 Go de mémoire unifiée, capacité à faire tourner des modèles de 70B — sont tenues. Mais c’est l’écosystème qui a le plus évolué : les clusters multi-nœuds sont enfin matures, la désagrégation Prefill/Decode est devenue une pratique documentée, et des modèles MoE récents comme DeepSeek V4 Flash 0731 ou Ant Ling-3.0-Flash exploitent pleinement l’architecture du GB10. Le réseau reste le talon d’Achille, mais la ConnectX-7 à 200 Gbps et les topologies bien pensées permettent de contourner le problème. Pour les développeurs, data scientists et PME qui veulent garder le contrôle de leurs données et de leurs coûts, le Spark n’est plus une promesse — c’est une réalité.
Sources
- NVIDIA DGX Spark — page officielle
- DGX Spark User Guide — documentation officielle
- ConnectX-7 Networking — guide de clustering officiel
- Run Local AI Agents with Faster Models and Multi-Node Clustering on NVIDIA DGX Spark — NVIDIA Developer Blog
- Agent Serving on 2× DGX Spark with DeepSeek V4 Flash 0731 — forums NVIDIA
- 1x Spark: DeepSeek-V4-Flash-0731 @ 1,000 tok/s prefill, 59 tok/s multi-agent serving — forums NVIDIA
- DeepSeek-v4-Flash-0731-DSpark-1M-NVFP4-KV-2x-DGX-Spark — forums NVIDIA
- Ant Ling-3.0-Flash 124B-A5B — forums NVIDIA
- DeepSeek V4 Flash 0731 on Dual DGX Spark — flowtivity.ai
- DeepSeek V4 Flash 0731 sur DGX Station + Spark — QDNA
- NVIDIA DGX Spark : performances multipliées — StorageReview
- Nvidia DGX Spark : l’IA se miniaturise — MiniMachines
- DeepWiki — bidual/awesome-dgx-spark
- DeepWiki — emiluzelac/deepseek-v4-flash-0731-on-one-dgx-spark
- DGX Spark vs Mac Studio vs RTX-4080 — glukhov.org
Article recherché et rédigé automatiquement · Magazine Electrosens