
2026 : l’année où le LLM a quitté le cloud
Un état des lieux des meilleurs modèles open-weight à faire tourner chez soi en 2026, en s’appuyant sur les guides et leaderboards récents (Hugging Face, ComputingForGeeks, Spheron, etc.). L’article dresse une vue d’ensemble structurée par catégorie d’usage (généraliste, code, agentique) et par cont
llama.cpp 2026 : la réécriture qui change vraiment la donne pour vos LLM locaux
La réécriture majeure de llama.cpp en 2026 est passée presque inaperçue, mais elle redéfinit les performances, la compatibilité matérielle et l’écosystème des LLM locaux. Cet article décrypte en profondeur ce qui a réellement changé dans l’architecture, les gains concrets (vitesse, VRAM, support CPU
Décodage spéculatif : la technique qui double la vitesse de vos LLM locaux sans dépenser un euro
Le décodage spéculatif s’impose en 2026 comme la méthode la plus efficace pour accélérer l’inférence de LLM open source sur du matériel grand public, sans surcoût matériel. Cet article décrypte en profondeur le principe (un petit modèle draft propose, un grand modèle vérifie), les implémentations ré
85% plus rapide, vraiment ? — Ce que promet DeepSeek DSpark et pourquoi ça mérite un examen
Décryptage en profondeur de la sortie de DeepSeek DSpark, un framework open-source qui prétend accélérer l’inférence des LLM jusqu’à 85%. L’article analyse les mécanismes techniques (optimisation du calcul, gestion mémoire, intégration matérielle), confronte les benchmarks annoncés aux tests indépen
Kimi K3 et la bascule open-weight : ce que la sortie qui a tout changé signifie pour votre setup local
Décryptage en profondeur de la sortie de Kimi K3 (juillet 2026) et du signal de convergence qu’elle envoie à toute l’industrie : les poids ouverts ne sont plus un compromis mais la nouvelle norme. L’article analyse ce que ce modèle change concrètement pour ceux qui veulent faire tourner des LLM chez
GPU pour LLM en 2026 : le guide du budget malin pour faire tourner l’IA chez soi sans se ruiner
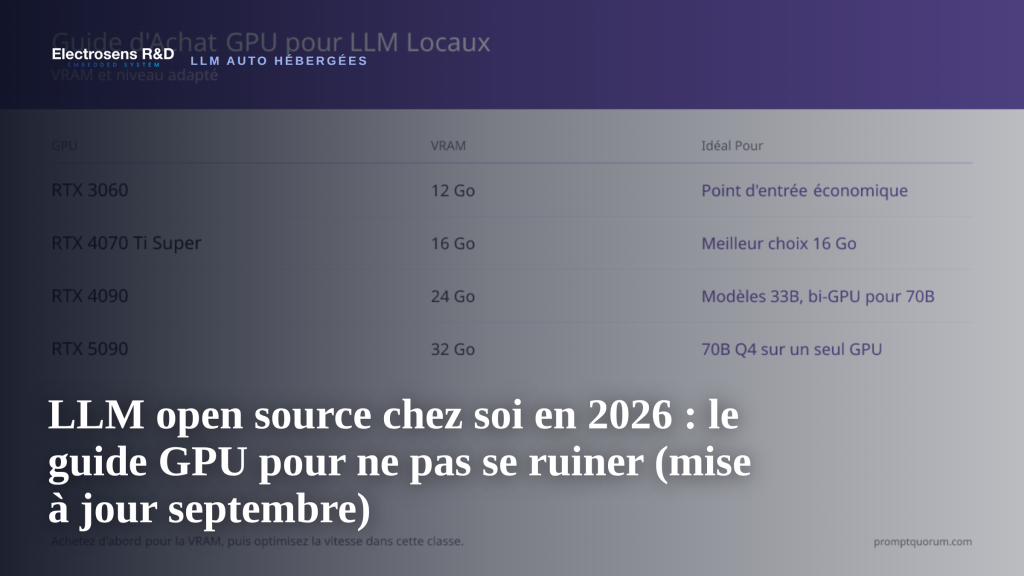
Dossier de fond sur le choix d’un GPU pour exécuter des LLM open-source localement sans se ruiner en 2026. Le sujet couvre les critères techniques essentiels (VRAM, bande passante mémoire, précision), l’évolution récente du marché (RTX 50xx, cartes d’occasion, alternatives comme les M4 Max ou les ac
Ollama, vLLM, llama.cpp, MLX, LM Studio : quel runtime local choisir en 2026 pour ne pas se ruiner ?
Comparatif approfondi des cinq principaux runtimes open-source pour exécuter des LLM localement en 2026 : Ollama, vLLM, llama.cpp, MLX et LM Studio. L’article analyse leurs forces et faiblesses respectives en matière de coût matériel (de 8 Go à 70B de VRAM), de facilité d’utilisation, de performance
TurboQuant : la compression qui promet de faire tourner des LLM géants sur votre PC — mythe ou réalité ?
Décryptage approfondi de l’algorithme TurboQuant de Google, présenté comme capable de réduire la mémoire des LLM par 6 sans perte de qualité. L’article explique son fonctionnement (quantification vectorielle), le compare aux méthodes classiques (GPTQ, AWQ, GGUF), analyse les benchmarks et les implic