
 LLM auto hébergées · 14 October 2026
Faire tourner des LLM open-source chez soi sans se ruiner : le guide matériel 2026
En octobre 2026, faire tourner un LLM open-source sur sa propre machine n’est plus un luxe réservé aux initiés. Mais entre la pénurie de mémoire qui a fait flamber les prix, une génération de cartes aux specs alléchantes, des alternatives inattendues comme les mini PC à mémoire unifiée et l’irruption de moteurs d’inférence comme FreeToken ou Strata, le choix du bon matériel relève plus que jamais du casse-tête. Voici comment naviguer ce marché sous tension avec méthode, sans céder au syndrome de la carte la plus chère.
Introduction : le paradoxe de l’automne 2026
Nous sommes en octobre 2026. L’écosystème des LLM open-source n’a jamais été aussi dynamique — mais il a changé de visage. En mai 2026, cinq modèles de niveau « frontier » sont sortis en moins de 30 jours : Qwen 3.5 (Alibaba), DeepSeek V4 (Pro + Flash), Gemma 4 (Google), Mistral Medium 3.5, et côté Meta, la donne a basculé. Le nom « Llama » a disparu : après avoir fermé la porte à l’open source le 8 avril 2026 avec Muse Spark (propriétaire, API seulement), Meta a fait volte-face le 10 août en publiant Muse Glimmer, un modèle 30B en Apache 2.0 pensé pour les agents locaux. Le « Behemoth » annoncé à deux trillions de paramètres n’est jamais sorti — abandonné en route.
Côté runtimes, l’outillage a mûri à toute vitesse. Ollama, l’outil d’inférence locale le plus populaire, a enchaîné les versions : 0.23.0 → 0.24.0 en onze jours en mai, avec le support de Codex App, le speculative decoding Gemma 4 MTP via le runner MLX et un sampler MLX retravaillé. vLLM v0.21.0 a stabilisé DeepSeek V4 sur Blackwell avec un nouveau backend TOKENSPEED_MLA. llama.cpp a franchi un cap symbolique avec sa v0.5.0 (documentée fin septembre 2026), qui consolide le backend, les changements de modèles et le serveur local, après avoir fusionné le support de Qwen 3.6 MTP (PR #22673) et publié des prebuilts Windows CUDA 13.1. MLX 0.31.x, couplé à macOS 26.2, exploite les Neural Accelerators des puces M5 pour un TTFT jusqu’à 4x plus rapide. Et deux nouveaux venus bousculent les règles : FreeToken, un moteur d’inférence open-source qui promet de faire tourner des MoE massifs sur GPU grand public en utilisant la RAM système, et Strata, un moteur qui revendique l’exécution d’un Qwen 125B sur une carte graphique ordinaire — au point que r/LocalLLaMA débatte désormais de la « philosophie des moteurs d’inférence sur-entraînés ».
Pourtant, le marché du matériel est paradoxalement hostile. Une pénurie mondiale de mémoire a poussé les prix des GPU entre 1,5 et 2 fois au-dessus de leur tarif de lancement. En juillet 2026, un RTX 5090 se négocie entre 3 500 et 3 950 €, un RTX 4090 entre 2 900 et 3 200 €, un RTX 4080 Super entre 1 500 et 1 700 €. Même les cartes d’entrée de gamme ont pris l’ascenseur : le RTX 3060 12 Go, sorti en 2021, se vend encore entre 340 et 400 € neuf — mais on le trouve désormais entre 170 et 200 € d’occasion, ce qui en fait la meilleure affaire du moment.
Dans ce contexte, bien choisir son matériel n’est pas une question de puissance brute, mais de stratégie. La bonne nouvelle ? Les règles du jeu sont plus claires que jamais. Les critères décisifs — VRAM, bande passante mémoire, quantification — sont désormais bien documentés, et des alternatives crédibles émergent, y compris du côté d’AMD, d’Apple et des mini PC à mémoire unifiée. Ce dossier vous donne la méthode pour trancher selon votre usage réel, sans vous ruiner.
Les trois piliers techniques : VRAM, bande passante, calcul
La VRAM : le critère roi
Pour faire tourner un LLM localement, la première question n’est pas « quelle carte est la plus rapide ? » mais « combien de mémoire vidéo ai-je besoin ? ». La règle empirique, confirmée en 2026, est simple : en quantification Q4_K_M (le format standard pour l’inférence locale), il faut compter environ 0,6 Go de VRAM par milliard de paramètres, plus 2 à 4 Go pour le contexte et l’outillage.
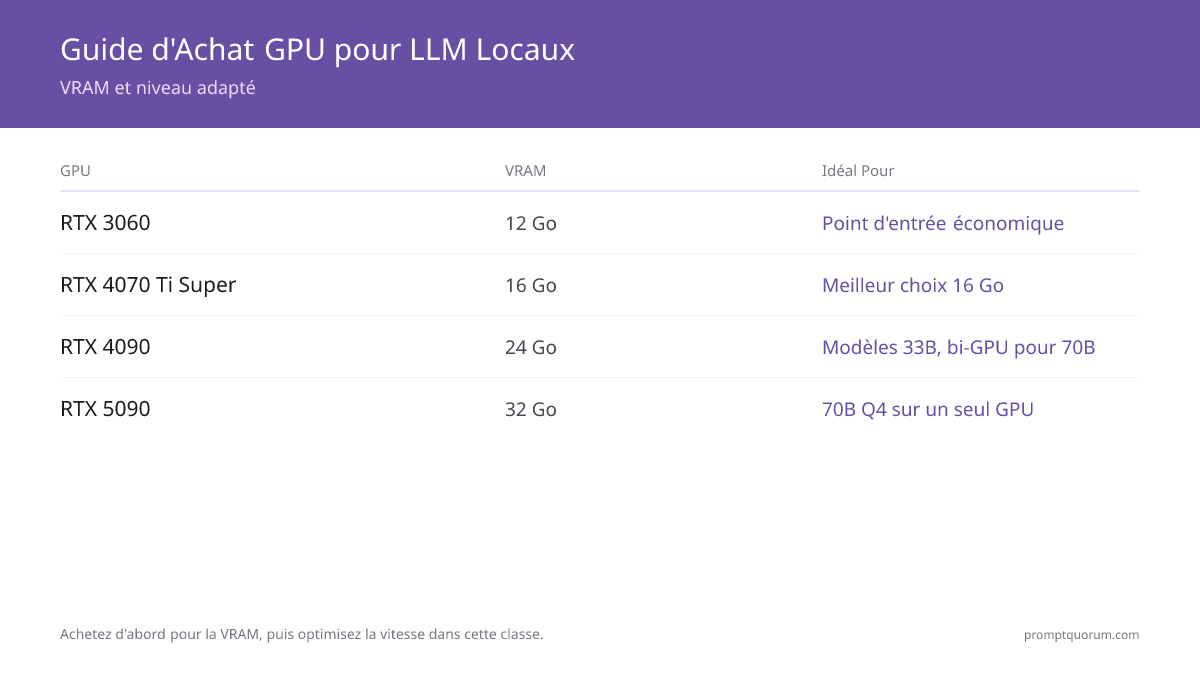
Concrètement, un modèle 7B quantifié en 4 bits exige entre 4 et 5 Go de VRAM. Un modèle 13B en Q8 ou 20B en Q4 demande environ 12 à 16 Go. Un modèle 34B en Q4_K_M tourne confortablement dans 24 Go. Et un modèle 70B en Q4 nécessite environ 44 à 50 Go de VRAM — ce qui dépasse largement les 24 Go du RTX 4090 et même les 32 Go du RTX 5090, la seule carte grand public capable de faire tenir un 70B en Q4 sans configuration bi-GPU.
Cette règle des 0,6 Go par milliard est corroborée par les mesures de terrain : le Qwen3-30B-A3B (MoE, 30 milliards de paramètres) tourne sur une RTX 4090 en Q4 avec 17 Go de VRAM occupés et génère 40 tokens par seconde — un résultat qui relevait de la science-fiction il y a dix-huit mois. Le Qwen3.6-27B (dense, publié le 22 avril 2026) tient en environ 17 Go en Q4_K_M, confortable sur une RTX 4090. Attention toutefois aux modèles multimodaux : Muse Glimmer de Meta annonce ~20 Go pour les poids seuls en Q4, mais une enveloppe de 24 à 32 Go une fois le cache KV et l’encodeur visuel comptés — sur une carte de 22 Go, ça ne passe pas.
La VRAM détermine non seulement si le modèle tient, mais aussi la longueur maximale du contexte que vous pouvez utiliser. Un 8B avec un contexte de 128K en pleine précision consomme 10-20 Go de KV-cache à lui seul — un point crucial pour les usages agentiques, où les « harnais » (ces couches d’orchestration, de mémoire et de vérification qui encadrent le modèle) sont devenus, depuis le printemps 2026, aussi déterminants que la taille du modèle lui-même.
La bande passante mémoire : le vrai goulot d’étranglement
Une fois le modèle chargé en VRAM, c’est la bande passante mémoire qui dicte la vitesse de génération. L’inférence d’un LLM est fondamentalement une opération de lecture de poids : à chaque token généré, le GPU doit relire l’intégralité des poids du modèle. Plus la bande passante est élevée, plus vite les tokens sortent.
Les études de 2026 convergent : une bande passante supérieure à 1 To/s améliore la latence d’inférence jusqu’à 30 % par rapport à des cartes moins rapides, à nombre de cœurs égal. C’est pourquoi le RTX 4090, avec ses 1 008 Go/s, reste une référence pour la vitesse de génération, malgré ses 24 Go seulement.
À l’inverse, la puissance de calcul brute (TFLOPS) est largement surévaluée dans le choix d’un GPU pour LLM. Un RTX 5090 avec ses 575 W de TDP et ses milliers de cœurs CUDA n’est pas « 2 fois plus rapide » qu’un RTX 4090 pour l’inférence — la bande passante mémoire plafonne le gain. Les benchmarks comparatifs le montrent : à VRAM égale, deux cartes avec des TFLOPS très différents produisent des vitesses de génération étonnamment proches.
C’est précisément ce constat qui explique l’engouement pour les architectures à mémoire unifiée (mini PC, Mac, Strix Halo) : elles échangent de la bande passante brute contre de la capacité, un arbitrage souvent gagnant quand on veut faire tenir un gros modèle plutôt que générer vite un petit.
L’interaction avec la quantification
La quantification (Q4_K_M, Q8_0, etc.) joue sur les deux tableaux. D’un côté, elle réduit la taille des poids, donc la VRAM nécessaire. De l’autre, elle augmente la vitesse effective en réduisant la quantité de données à lire par token. Un modèle 13B en Q8 (16 Go) sera plus lent qu’en Q4 (8 Go) sur la même carte, simplement parce qu’il faut lire deux fois plus de poids à chaque token.
Le choix du niveau de quantification est donc un arbitrage entre qualité et vitesse. En 2026, Q4_K_M est devenu le standard de facto pour l’inférence locale : il offre un bon rapport qualité/performance, et les modèles récents (Qwen 3.6, Muse Glimmer, DeepSeek V4) sont entraînés pour bien résister à cette compression. Attention toutefois aux modèles entraînés par RL (RLHF, GRPO) : leurs logits « pointus » peuvent mal réagir à une quantification trop agressive — un point souligné par les analyses du post-training en 2026, alors que le Ray Summit 2026 a acté la convergence forcée de l’infrastructure open source autour de ces contraintes. Le consensus est de rester en Q4_K_M ou Q5_K_M pour un usage sérieux, et de réserver Q8_0 aux modèles plus petits où la VRAM le permet.
Un rappel utile pour comprendre l’enjeu : un LLM n’est jamais qu’un modèle de langage à très grand nombre de paramètres, entraîné par apprentissage auto-supervisé à prédire le token suivant. Toute l’astuce du self-hosting consiste à faire tenir ces milliards de paramètres dans une mémoire finie sans effondrer la qualité — d’où l’importance du format GGUF et de ses variantes de quantification, désormais bien documentés pour Windows, macOS et Linux.
Le marché GPU en 2026 : une pénurie qui redessine la carte
Des prix sous tension
La pénurie de mémoire de 2026 a bouleversé les repères. Les prix de lancement officiels des RTX 50xx ont été largement dépassés dès les premières semaines. Voici un instantané des prix relevés en juillet 2026 sur le marché européen, neuf et occasion :
| Carte | VRAM | Prix juillet 2026 (neuf) | Prix occasion | Consommation | Usage recommandé |
|---|---|---|---|---|---|
| RX 6700 XT | 12 Go | 140-190 € | — | 230 W | 7B-13B en Q4, budget ultra-serré (config AMD) |
| RTX 3060 12 Go | 12 Go | 340-400 € | 170-200 € | 170 W | 7B-13B en Q4, meilleur rapport qualité/prix |
| RTX A4000 | 16 Go | — | <220 € | 140 W | Meilleur rapport VRAM/€ en occasion |
| RTX 5060 Ti 16 Go | 16 Go | 400-420 € | — | 180 W | 13B-14B avec marge de contexte, meilleur neuf budget |
| RTX 4070 Super | 12 Go | ~450 € | — | 220 W | 7B-14B rapide (25-30 tok/s) |
| RX 7800 XT | 16 Go | ~500-600 € | — | 263 W | 14B confortable, alternative AMD |
| RTX 4060 Ti 16 Go | 16 Go | 780-820 € | — | 165 W | 13B en Q8 / 20B en Q4, meilleur rapport VRAM/prix NVIDIA |
| RTX 5070 Ti 16 Go | 16 Go | non précisé | — | non précisé | Meilleure carte 16 Go GDDR7 (Blackwell) |
| RTX 4080 Super | 16 Go | 1 500-1 700 € | — | 320 W | 14B/22B, choix durable |
| RTX 3090 | 24 Go | — | variable | 350 W | 34B en Q4_K_M, meilleure valeur occasion |
| RTX 4090 | 24 Go | 2 900-3 200 € | — | 450 W | 33B, vitesse de génération maximale |
| RTX 5090 | 32 Go | 3 500-3 950 € | — | 575 W (alim 850-1000 W) | 70B en Q4, seule carte grand public |
Ce tableau révèle plusieurs tendances fortes.
Le budget : le RTX 3060 12 Go reste la valeur reine. À 170-200 € d’occasion, il fait tourner tous les modèles 7B-8B en Q4/Q5 et la plupart des denses 13B-14B en Q4. Les tests de terrain confirment : un Qwen3 14B en Q4_K_M utilise ~9 Go de VRAM et génère 9-12 tokens/s ; un Qwen3 8B atteint 16-20 tok/s ; un DeepSeek-R1 7B (raisonnement) tourne à 10-12 tok/s. C’est le meilleur choix pour débuter sans se ruiner.
Le nouveau venu : le RTX 5060 Ti 16 Go. À 400-420 € neuf, cette carte de génération actuelle offre 4 Go de VRAM de plus que la 3060 — de quoi accueillir confortablement les modèles 13B-14B avec une marge pour des fenêtres de contexte plus larges. C’est le meilleur choix neuf pour les budgets serrés, et il est moins touché par la flambée des prix que les cartes haut de gamme.
Le milieu de gamme : le RTX 4060 Ti 16 Go. À 780-820 €, il est recommandé par le guide llmhardware.io (mis à jour en mai 2026) comme « meilleur rapport VRAM/prix (NVIDIA) » pour les modèles 13B en Q8 ou 20B en Q4. Il offre 16 Go de VRAM, soit le minimum confortable pour les contextes de plus de 16 000 tokens. C’est aussi le GPU le plus proche de son tarif de lancement, donc le moins touché par la flambée.
Le haut de gamme : le RTX 4080 Super. À 1 500-1 700 €, c’est la carte 16 Go la plus rapide, et après les mouvements de prix de 2026 elle coûte à peu près autant que le RTX 4070 Ti Super, plus lent. Pour les modèles 14B rapides et un travail 22B léger, c’est le choix durable.
Le marché de l’occasion reste une option sérieuse. Le RTX 3090 24 Go, recommandé comme « meilleure valeur sur le marché de l’occasion » pour les modèles 34B en Q4_K_M, offre une capacité mémoire que seules les cartes à plus de 3 000 € peuvent égaler en neuf. Attention toutefois : sa consommation de 350 W et son encombrement imposent une alimentation adaptée.
AMD : viable mais plus exigeant
Les cartes AMD offrent une VRAM par euro compétitive : le RX 6700 XT (12 Go) se trouve à 140-190 €, le RX 7800 XT (16 Go) autour de 500-600 €. La nouvelle génération RDNA 4 change la donne côté rapport qualité/prix : la Radeon RX 9070 XT 16 Go GDDR6 se négocie autour de 690 à 740 $, ce qui en fait une alternative sérieuse aux cartes NVIDIA 16 Go pour qui accepte l’écosystème ROCm.
Mais la configuration ROCm ajoute des heures de travail face à NVIDIA CUDA — les guides 2026 le rappellent : si vous êtes prêt à bricoler, AMD peut être rentable ; sinon, restez sur NVIDIA pour un déploiement sans friction. Bonne nouvelle pour les configurations modestes : les iGPU ont beaucoup progressé. L’AMD Radeon 780M, avec les optimisations Vulkan de llama.cpp (gain global d’environ +50 %, dont +12,9 % via le réglage MMVQ), atteint désormais ~10-12 tok/s sur Llama 3 8B Q4 et Qwen 2.5 7B, et 8-11 tok/s sur Mistral 7B Q4_K_M. De quoi faire tourner un petit modèle sur un mini PC ou un laptop sans GPU dédié.
Le cas particulier du RTX 5090
Le RTX 5090, avec ses 32 Go de VRAM, est présenté comme la seule carte grand public capable de faire tenir un modèle 70B en Q4 sans configuration bi-GPU. C’est un argument de poids pour les passionnés qui veulent exécuter les plus gros modèles open-source (DeepSeek V4, Qwen 3.6) en local. Mais son prix de 3 500-3 950 € et sa consommation de 575 W (nécessitant une alimentation de 850-1000 W) le réservent à un public averti.
Pour la plupart des usages, un 70B en Q4 est un luxe : les modèles 30B-34B en Q4_K_M, qui tiennent dans 24 Go, offrent déjà des performances très honorables pour le chat, le codage et la plupart des tâches agentiques. Le RTX 4090, à 2 900-3 200 €, reste donc un excellent compromis pour ceux qui veulent de la vitesse sans atteindre les sommets.
L’alternative des mini PC à mémoire unifiée
Une tendance forte de 2026 : les mini PC à mémoire unifiée, qui font tenir de gros modèles en RAM partagée plutôt qu’en VRAM dédiée. Le pionnier reste l’AMD Strix Halo (Ryzen AI Max), lancé en 2025 : 16 cœurs Zen 5, GPU intégré RDNA 3.5, bus mémoire de 256 bits et 256 Go/s de bande passante. Ce débit, modeste face à une RTX 4090, suffit pour un usage confortable : ~40-60 tok/s sur Llama 3 8B Q4 en Vulkan, et ~5-10 tok/s sur un Mixtral 8x7B Q4_K_M — un MoE qui ne tiendrait pas sur une carte 16 Go.
La génération 2026 pousse le curseur beaucoup plus loin. Le AMD Ryzen AI Halo, mini PC officiel à 128 Go de mémoire unifiée, est annoncé pour supporter des modèles jusqu’à 120B+, au prix de 3 999 $. La plateforme AMD Gorgon Halo vise encore plus haut, avec 192 Go de mémoire unifiée et une prise en charge des modèles 200B+. Et le camp des mini PC IA s’élargit : Acer propose lui aussi une machine à 128 Go de mémoire unifiée, annoncée pour des modèles jusqu’à 200B.
L’intérêt de ces machines est limpide : pour le prix d’une RTX 5090 (voire moins), vous obtenez 4 à 6 fois plus de mémoire, donc l’accès à des modèles qu’aucune carte grand public ne peut charger seule. Le revers de la médaille est la bande passante : à 256 Go/s, on génère lentement un gros modèle, mais on le génère. Pour un usage agentique, du RAG ou du traitement par lots, c’est souvent un meilleur compromis qu’une carte rapide mais limitée à 24 Go.
Apple : la troisième voie
Côté Apple, la donne évolue aussi. Le Mac mini M6 avec 32 Go de mémoire unifiée accélère sensiblement l’IA locale (analyses récentes sur OpenClaw à l’appui), mais ses limites face au cloud restent réelles dès qu’on monte en taille de modèle. Pour les gros besoins, c’est le Mac Studio M5 Max qui s’impose : avec 96 à 128 Go de mémoire unifiée, il fait tourner confortablement les modèles 70B, dans un silence et une consommation sans équivalent côté PC. Le couplage MLX 0.31.x + macOS 26.2 exploite les Neural Accelerators des puces M5 pour un TTFT jusqu’à 4x plus rapide — un argument de poids pour les usages interactifs.
Le guide VRAM par palier, désormais bien balisé (du laptop 8 Go à la station 128 Go), résume la situation : 8 Go pour les petits modèles quantifiés, 12-16 Go pour le sweet spot des cartes milieu de gamme, 24 Go pour le plafond des 70B sur GPU dédié, 48 Go comme no man’s land des doubles GPU et Mac Studio, et 96-128 Go pour les 70B confortables sur mémoire unifiée.
Les runtimes : le logiciel compte autant que le matériel
Le choix du matériel ne fait sens qu’à la lumière du moteur d’inférence que vous utiliserez. En 2026, « faire tourner un LLM en local » n’est plus une décision unique mais cinq, tant l’écosystème s’est bifurqué selon les usages.
Ollama reste le point d’entrée idéal pour le prototypage mono-développeur, tous OS confondus. LM Studio séduit par son navigateur de modèles graphique sur Mac et Windows. vLLM s’impose pour le service multi-utilisateurs sur GPU NVIDIA ou AMD — il atteint environ 16 à 20 fois le débit concurrent d’Ollama grâce à PagedAttention et au continuous batching. llama.cpp, désormais en v0.5.0, est la référence pour les déploiements embarqués ou les matériels exotiques, avec son format GGUF et son serveur local. Enfin, MLX est devenu la voie la plus rapide sur Apple Silicon — Ollama 0.19+ l’utilise d’ailleurs sous le capot sur les puces M-series.
À ces cinq historiques s’ajoutent les nouveaux venus. FreeToken promet de faire tourner des MoE massifs (jusqu’à 284B) sur GPU grand public en résidant en RAM système, avec un cache LRU et une politique q* documentés dans un article arXiv (2608.16157) — jusqu’à 3x plus rapide qu’Ollama selon ses promoteurs, mais avec la bande passante PCIe et la latence mémoire comme vrais goulots d’étranglement. Strata, émergé début octobre 2026, revendique l’exécution d’un Qwen 125B sur une carte ordinaire. Ces moteurs ne remplacent pas le matériel : ils changent l’équation en déportant une partie du modèle hors de la VRAM.
La leçon pratique : avant d’acheter une carte à 3 000 €, vérifiez ce que votre runtime préféré sait faire de votre configuration existante. Un MoE bien servi par FreeToken ou un dense bien quantifié en GGUF peuvent transformer une machine modeste en plateforme d’inférence crédible.
Choisir selon son usage : la méthode en quatre profils
Plutôt que de courir après la carte la plus chère, partez de votre usage réel.
Profil « découverte et petits modèles » (budget < 250 €). Un RTX 3060 12 Go d’occasion (170-200 €) ou un mini PC à iGPU Radeon 780M suffisent pour les modèles 7B-8B en Q4/Q5 et la plupart des denses 13B-14B. C’est le meilleur point d’entrée : vous apprendrez les rudiments (quantification, contexte, runtimes) sans immobiliser un capital.
Profil « usage quotidien sérieux » (budget 400-850 €). Le RTX 5060 Ti 16 Go (400-420 €) ou le RTX 4060 Ti 16 Go (780-820 €) offrent les 16 Go qui font la différence pour les contextes longs et les modèles 13B-20B. C’est le sweet spot 2026 pour le chat, le code et l’agentique légère.
Profil « gros modèles sur GPU dédié » (budget 1 500-3 200 €). Le RTX 4080 Super (1 500-1 700 €) pour la vitesse en 14B-22B, ou le RTX 3090/4090 24 Go pour les 30B-34B en Q4_K_M. Le RTX 5090 (3 500-3 950 €) ne se justifie que si vous visez réellement les 70B en Q4 sur une seule carte.
Profil « gros modèles sans se ruiner » (budget ~4 000 $). Les mini PC à mémoire unifiée (AMD Ryzen AI Halo 128 Go à 3 999 $, Acer 128 Go, Gorgon Halo 192 Go en approche) ou un Mac Studio M5 Max 96-128 Go. Vous générez plus lentement, mais vous accédez à des modèles 120B-200B qu’aucune carte grand public ne peut charger. Pour l’agentique, le RAG et le traitement par lots, c’est souvent le meilleur calcul.
Conclusion : la stratégie prime sur la puissance
Le paradoxe de 2026 tient en une phrase : jamais les modèles open-source n’ont été aussi bons, jamais le matériel n’a été aussi cher. La réponse n’est pas d’attendre une hypothétique accalmie des prix — la pénurie de mémoire s’installe dans la durée — mais d’aligner trois variables : la taille des modèles que vous voulez réellement faire tourner, la vitesse dont vous avez besoin, et le runtime qui sait tirer parti de votre configuration.
Pour la grande majorité des lecteurs, la bonne décision tient en deux lignes : un RTX 3060 12 Go d’occasion pour apprendre, un RTX 5060 Ti 16 Go neuf pour durer. Pour les passionnés de gros modèles, la mémoire unifiée (mini PC AMD, Mac Studio M5 Max) offre aujourd’hui le meilleur rapport capacité/prix, à condition d’accepter une bande passante plus modeste. Et quel que soit votre choix, gardez un œil sur les runtimes : FreeToken, Strata et consorts redessinent les règles plus vite que les cartes ne changent de génération.
Faire tourner un LLM chez soi sans se ruiner en 2026, ce n’est plus une question de budget, c’est une question de méthode.
Sources
- Comparatif LLM & API IA gratuites en français — Iatrust (28 septembre 2026)
- Modèles d’IA chinois en 2026 : DeepSeek, Qwen, Kimi, GLM… lequel pour quoi ? — Iatrust (5 septembre 2026)
- llama.cpp v0.5.0 in 2026: What Changed, How to Install, Run GGUF & Use the Local API — gyanaangan.in (27 septembre 2026)
- Performance LLM sur GPU AMD Radeon 9070XT — QuelLLM.fr (25 septembre 2026)
- Open-weights ou open-source ? La différence qui compte — QuelLLM.fr (27 août 2026)
- LLM sur Raspberry Pi 5 : IA locale embarquée — QuelLLM.fr (27 août 2026)
- Modèles GGUF : types de quantification et exécution — convly.ai (9 septembre 2026)
- Plateforme IA locale et LLM open source — qdna.fr (5 septembre 2026)
- FreeToken : Exécutez d’énormes modèles d’IA MoE 3x plus vite qu’avec Ollama — stork.ai (29 août 2026)
- FreeToken llama: Guía y consejos para configurar MoE local — freetoken.wiki (29 août 2026)
- Почему все говорят о Strata: эпоха переобученных движков — ai-stat.ru (5 octobre 2026)
- Mac mini M6 et OpenClaw : le vrai gain en IA locale — lokan.fr (30 août 2026)
- Ray Summit 2026: RL Post-Training Forces Open-Source AI Infrastructure to Converge — techtimes.com (25 août 2026)
- Perplexity et Nvidia lancent Portable Computer — iaexpertos.net (25 août 2026)
- La nouvelle obsession de la tech : de bons « harnais » pour maîtriser les IA — latribune.fr (1er septembre 2026)
- Ollama vs LM Studio vs vLLM vs llama.cpp vs MLX 2026 — codersera.com
- Large language model — Wikipedia
 Article recherché et rédigé automatiquement · Magazine Electrosens