
 ElectroTech · 5 September 2026
Bolt Graphics Zeus : un GPU « exaflop » sur TSMC 12 nm ? Ce que vaut vraiment ce tape-out
Le 22 avril 2026, une startup californienne nommée Bolt Graphics annonçait avoir réussi le tape-out de sa puce de test pour son GPU Zeus, gravée sur un nœud TSMC 12 nm. Dans un marché où Nvidia et AMD se disputent les nœuds 3 nm et 4 nm pour l’IA et le HPC, ce choix de nœud mature interpelle. Derrière la promesse d’un « exaflop » et d’une réduction des coûts de calcul par 17, se cache une stratégie d’ingénierie audacieuse — ou un coup marketing risqué. Décryptage.
Le pari fou de Sunnyvale : défier Nvidia avec un nœud de 2012
En cette année 2026, le marché des GPU est plus verrouillé que jamais. Nvidia règne sans partage sur le calcul intensif et l’IA, avec des architectures gravées en 3 nm et 4 nm, des systèmes comme le DGX GH200 qui enchaîne 256 superpuces Grace Hopper pour atteindre 1 exaflop en précision FP8, et 144 To de mémoire partagée. AMD n’est pas en reste, avec ses Instinct qui propulsent les supercalculateurs les plus rapides du monde : El Capitan a ainsi atteint 1,742 exaflops au classement TOP500, et le français Alice Recoque, construit par Eviden avec des puces AMD, doit dépasser l’exaflop en double précision FP64 d’ici 2027. Dans ce paysage, l’arrivée d’un acteur inconnu, Bolt Graphics, qui annonce un tape-out sur un nœud TSMC 12 nm — un procédé dont la maturité remonte au début des années 2010 — a de quoi surprendre.
Le communiqué, diffusé via PRNewswire et relayé par Yahoo Finance, est pourtant sans ambiguïté : Bolt Graphics a « complété le tape-out de sa puce de test pour son GPU Zeus haute performance ». La puce est conçue sur le nœud TSMC 12 FFC (12 nm), avec une architecture scalable prévue pour des nœuds avancés jusqu’à 5 nm. L’entreprise vise une production en volume au quatrième trimestre 2027. Et surtout, elle revendique une réduction du coût total de calcul (TCO) allant jusqu’à 17 fois par rapport aux architectures existantes.
Ce choix contre-intuitif pose immédiatement la question : est-ce une révolution d’ingénierie ou un aveu de faiblesse financière ? Car si le 12 nm est un nœud éprouvé, à haut rendement et relativement abordable, il est aussi limité en densité de transistors et en fréquence maximale par rapport aux nœuds avancés. Pour un GPU qui se prétend « exaflop », le pari semble physiquement difficile à tenir — à moins de jouer sur la précision de calcul, un terrain glissant que nous examinerons plus loin.
Zeus sur le papier : un GPU modulaire taillé pour le ray tracing
Le communiqué de presse de Bolt Graphics est un modèle du genre : court, ambitieux, et remarquablement avare en détails techniques. On y apprend que Zeus est un GPU « haute performance » conçu pour le calcul intensif et le rendu, avec un accent particulier sur l’accélération du path tracing — une technique de rendu photoréaliste qui simule le trajet de la lumière, extrêmement coûteuse en calcul. Le Dr. Ian Cutress, analyste en chef chez More Than Moore, est cité dans le communiqué pour saluer le tape-out comme « une étape importante pour le path tracing accéléré ». Une citation flatteuse, mais qui émane d’un tiers dont la déclaration est relayée par l’entreprise elle-même — pas d’une source indépendante.
L’architecture revendiquée est « scalable », conçue pour évoluer vers des nœuds plus avancés, jusqu’à 5 nm. Cela suggère une conception modulaire, où les blocs de calcul pourraient être réutilisés sur différentes gravures. C’est une approche classique dans l’industrie : on conçoit d’abord sur un nœud mature pour valider la logique, puis on transpose vers des nœuds plus denses. Mais le communiqué ne précise ni le nombre de cœurs, ni le type de mémoire (HBM, GDDR ?), ni l’interface (PCIe, CXL ?), ni la largeur de bus. Rien non plus sur la précision de calcul utilisée pour atteindre le fameux « 1 exaflop » que les médias ont repris en titre.
Il faut ici être clair : le communiqué officiel ne mentionne pas explicitement « exaflop ». C’est le titre de l’article de Yahoo Tech qui évoque « firm touts 1… » (probablement 1 exaflop), et TweakTown, un média indépendant, rapporte des benchmarks « pré-silicon » annonçant une performance 10 fois supérieure à la RTX 5090 en rendu path-tracing pour la variante Zeus 4c. Mais ces chiffres sont hypothétiques, basés sur des simulations de l’entreprise, et non sur des mesures réelles. Le tape-out d’une puce de test, c’est la première étape de la validation silicon : on grave un prototype pour vérifier que la logique fonctionne, que les horloges tiennent, que la consommation est conforme. Ce n’est pas un produit finalisé. Entre ce tape-out et un GPU commercialisable, il reste des mois de tests, de corrections, et de nouvelles itérations.
12 nm, le choix de la raison ou de la survie ? Décryptage d’un nœud mature
Pourquoi une startup choisit-elle le 12 nm en 2026, alors que Nvidia et AMD se battent sur du 3 nm et du 4 nm ? La réponse tient en trois mots : coût, rendement, et risque. Un tape-out sur un nœud avancé comme le 5 nm ou le 4 nm coûte des dizaines de millions de dollars, uniquement pour les masques. Sur du 12 nm, le coût des masques est d’un ordre de grandeur inférieur, et le rendement de production est bien plus élevé — les défauts de gravure sont mieux maîtrisés sur un procédé mature. Pour une startup sans levée de fonds publique connue, c’est souvent la seule voie viable.
Mais ce choix a un prix physique. Le 12 nm FFC de TSMC est un nœud « FinFET » de première génération, avec une densité de transistors d’environ 30 à 40 millions de transistors par mm², contre plusieurs centaines de millions pour le 5 nm. La fréquence maximale est également plafonnée : on peut difficilement dépasser 2 à 2,5 GHz sur du 12 nm, là où les nœuds avancés montent à 3 GHz et plus. Et la consommation électrique par transistor est plus élevée, ce qui oblige à des compromis sur le nombre de cœurs actifs et la dissipation thermique.
Pour atteindre un exaflop sur un tel nœud, il faudrait soit une puce énorme (plusieurs centaines de mm²), soit une précision de calcul très réduite (FP8, INT8), soit un système multi-puces massif. Le communiqué ne précise rien. On peut toutefois noter que Nvidia atteint 1 exaflop en FP8 avec un système de 256 puces GH200 — soit un rack entier. Si Bolt Graphics vise un exaflop avec une seule puce en 12 nm, cela semble physiquement impossible en FP32 ou FP64. En FP8, avec une architecture très optimisée et une mémoire à très haute bande passante, c’est peut-être envisageable, mais à quel prix en consommation et en surface de silicium ?
L’exaflop en question : FP8, FP16 ou simple effet d’annonce ?
Le chiffre « 1 exaflop » est devenu un argument marketing incontournable dans le HPC. Nvidia l’utilise pour le DGX GH200, mais en précisant bien qu’il s’agit de FP8 — une précision réduite, adaptée à l’inférence IA mais pas au calcul scientifique de haute précision. AMD, de son côté, a atteint 1,742 exaflops avec El Capitan, mais en FP64, la double précision, la référence pour la simulation numérique. Le supercalculateur Frontier, lui, dépasse 1,2 exaflop sur le benchmark Linpack, toujours en FP64.
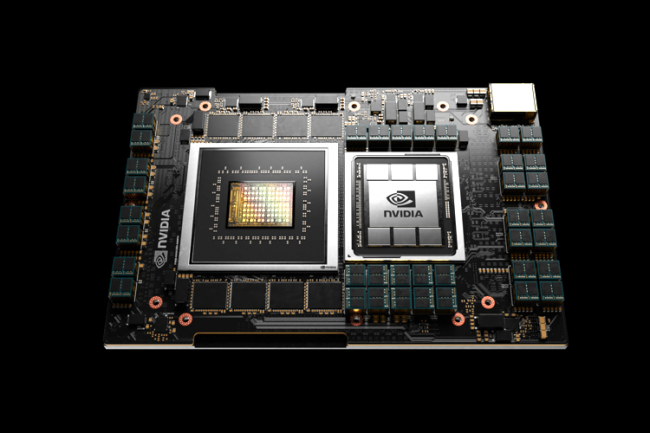
Quelle précision Bolt Graphics utilise-t-elle pour revendiquer l’exaflop ? Le communiqué ne le dit pas. Les médias qui ont repris l’annonce parlent de « 1 exaflop » sans plus de détail. C’est un problème majeur : un exaflop en FP8 n’a pas la même valeur qu’un exaflop en FP32 ou FP64. Pour le rendu path-tracing, on travaille généralement en FP32, parfois en FP16 pour les calculs intermédiaires. Si Zeus atteint l’exaflop en FP8, cela ne dit rien de ses performances réelles en rendu photoréaliste, qui nécessite une précision plus élevée.
Il faut aussi s’interroger sur la crédibilité technique. Sur un nœud 12 nm, avec une densité de transistors limitée, atteindre un exaflop en FP8 nécessiterait une puce d’une surface considérable — probablement plus de 800 mm², le maximum de ce que permet un réticule de lithographie — et une consommation électrique de plusieurs kilowatts. C’est techniquement possible, mais cela place Zeus dans la catégorie des monstres de puissance, à l’opposé de l’image d’efficacité que Bolt Graphics essaie de véhiculer avec sa promesse de réduction du TCO par 17. Cette affirmation, d’ailleurs, n’est étayée par aucun benchmark indépendant. Elle repose uniquement sur les calculs de l’entreprise, qui n’a pas publié de spécifications détaillées.
Bolt Graphics, une startup fantôme ou un futur géant ? Enquête sur une crédibilité à prouver
Le plus troublant dans cette annonce, c’est le manque total d’informations vérifiables sur l’entreprise elle-même. Le fondateur, CEO et CTO, Darwesh Singh, est présenté comme le créateur de Bolt Graphics, mais aucune source indépendante ne documente son parcours professionnel. A-t-il travaillé chez Nvidia, AMD, Apple, ou dans des startups HPC ? Rien dans le corpus fourni ne permet de le dire. Aucune donnée non plus sur les levées de fonds : pas de série A, pas de série B, pas d’investisseurs VC identifiés. Le siège social est à Sunnyvale, en Californie, mais c’est à peu près tout.
Le communiqué ne s’appuie que sur une seule source, PRNewswire, et la citation de Ian Cutress est relayée par l’entreprise elle-même. Aucun média technique indépendant n’a pu tester la puce, ni même la voir. TweakTown, qui a relayé l’information, précise bien que les chiffres de performance sont « pré-silicon », c’est-à-dire basés sur des simulations, pas sur des mesures. C’est un signal d’alarme : dans l’industrie des semi-conducteurs, les annonces tape-out sont fréquentes, mais la plupart des startups ne survivent pas à la phase de validation silicon. Les échecs sont nombreux, et les retards de plusieurs trimestres sont la norme.
Il faut aussi noter que le communiqué ne mentionne pas explicitement l’exaflop. C’est un ajout des médias, probablement basé sur des déclarations antérieures de l’entreprise ou des posts sur les réseaux sociaux. Cette ambiguïté est révélatrice : Bolt Graphics joue sur l’effet d’annonce sans s’engager sur des chiffres précis. En l’absence de spécifications techniques détaillées, de benchmarks indépendants, et d’une équipe dirigeante identifiable, la crédibilité de l’entreprise reste à prouver.
Face aux géants : quand Nvidia empile les milliards, Bolt mise sur l’ingénierie
Mettons les choses en perspective. Nvidia a investi des dizaines de milliards de dollars dans ses architectures, ses usines, et son écosystème CUDA. AMD a fait de même avec ROCm et ses partenariats avec les grands centres de calcul. Le supercalculateur El Capitan, propulsé par les Instinct d’AMD, a coûté plus de 600 millions de dollars. Alice Recoque, le premier exascale européen, est un projet de plusieurs centaines de millions d’euros porté par Eviden et le CEA. Face à cela, Bolt Graphics, avec son tape-out sur 12 nm et son équipe invisible, semble jouer dans une autre catégorie.

Mais c’est peut-être justement là que réside la stratégie. Bolt Graphics ne cherche pas à concurrencer Nvidia sur le terrain de l’IA massive, où les budgets se comptent en milliards. Elle vise une niche : le rendu path-tracing temps réel, un domaine où les performances des GPU traditionnels sont encore limitées, et où une architecture spécialisée pourrait faire la différence. TweakTown rapporte que la variante Zeus 4c serait 10 fois plus rapide que la RTX 5090 en rendu path-tracing — un chiffre impressionnant, mais qui reste à confirmer sur du silicium réel.
La promesse de réduction du TCO par 17 est également un argument de vente : si Zeus peut faire le travail de plusieurs GPU Nvidia avec une seule puce, même sur un nœud mature, le coût total d’acquisition et d’exploitation pourrait être inférieur. C’est une approche séduisante pour les studios d’animation, les bureaux d’études, et les centres de calcul qui n’ont pas les budgets des hyperscalers. Mais elle repose sur des hypothèses non vérifiées : consommation électrique, refroidissement, fiabilité, et surtout, disponibilité d’un écosystème logiciel.
| Critère | Bolt Graphics Zeus (annoncé) | Nvidia DGX GH200 (2023) | AMD El Capitan (2025) |
|---|---|---|---|
| Nœud de gravure | TSMC 12 nm (test chip) | 4 nm (H100) | 5 nm (MI300A) |
| Précision pour l’exaflop | Non précisée | FP8 | FP64 |
| Configuration | Puce unique (?) | 256 superpuces GH200 | Système massivement parallèle |
| Mémoire | Non précisée | 144 To partagés | Non précisée |
| Performance annoncée | 1 exaflop (?) | 1 exaflop FP8 | 1,742 exaflops FP64 |
| Statut | Tape-out test chip, production Q4 2027 | Commercialisé | En production |
Et pour nous, ingénieurs ? SDK, intégration et promesses d’un écosystème à construire
Pour les ingénieurs et les makers, la question cruciale est : pourrai-je utiliser cette puce ? Bolt Graphics promet un kit développeur pour 2026, selon TweakTown, et une production de masse pour 2027. Mais un GPU sans SDK, sans drivers, et sans support communautaire est un caillou inerte. Nvidia a bâti son empire sur CUDA, un écosystème logiciel mature que des millions de développeurs maîtrisent. AMD a ROCm, qui progresse mais reste en retard. Bolt Graphics devra proposer des outils de développement, des bibliothèques de rendu, et des interfaces standard (PCIe, CXL, HBM ou GDDR) pour s’intégrer dans les systèmes existants.
Le communiqué ne dit rien de tout cela. Aucune mention d’un SDK, d’une API, ou d’une compatibilité avec des frameworks existants comme Vulkan, OptiX, ou HIP. C’est un vide préoccupant. Même si la puce est techniquement brillante, sans écosystème logiciel, elle restera confinée à quelques early adopters prêts à tout réécrire. Les risques pour les premiers utilisateurs sont considérables : drivers bogués, support limité, et la possibilité que l’entreprise fasse faillite avant la production en volume.
Il faut aussi considérer l’intégration système. Un GPU « exaflop » sur 12 nm aura probablement une consommation électrique élevée, nécessitant un refroidissement liquide et une alimentation dédiée. Les serveurs standard ne pourront pas l’accueillir sans modifications. Bolt Graphics devra fournir des cartes filles, des châssis, et des solutions de refroidissement — un métier que les startups sous-estiment souvent. Nvidia et AMD ont des équipes entières dédiées à l’intégration système ; Bolt Graphics, avec son équipe réduite, devra faire des miracles.
De la puce test au datacenter : le chemin de croix de Zeus jusqu’en 2027
Le calendrier annoncé est ambitieux : tape-out réussi en avril 2026, production en volume visée pour Q4 2027. Cela laisse environ 18 mois pour valider le silicium, corriger les bugs, produire les premières cartes, et développer l’écosystème logiciel. C’est un délai très court pour une startup. Les étapes critiques sont nombreuses : validation fonctionnelle de la puce de test, tests de performance réels, benchmarks indépendants, qualification des drivers, certification des serveurs, et enfin, montée en cadence de la production.

Chaque étape peut révéler des problèmes. La fréquence maximale sur 12 nm pourrait être inférieure aux simulations. La consommation électrique pourrait dépasser les prévisions. Les défauts de conception pourraient nécessiter une nouvelle itération de masques, repoussant la production de plusieurs trimestres. Et même si la puce fonctionne parfaitement, Bolt Graphics devra convaincre des clients de lui faire confiance, alors que Nvidia et AMD proposent des solutions éprouvées avec un support mondial.
Que cette annonce change-t-elle pour le marché ? Peu de choses, à court terme. Les géants du HPC ne vont pas délaisser Nvidia ou AMD pour une startup dont la puce n’existe pas encore. Mais l’annonce a le mérite de rappeler que l’innovation ne se limite pas aux nœuds les plus avancés. Le 12 nm, avec son coût abordable et son rendement élevé, reste une option viable pour des architectures spécialisées. Si Bolt Graphics parvient à tenir ses promesses, elle pourrait ouvrir une voie alternative pour le calcul haute performance, basée sur l’efficacité architecturale plutôt que sur la course à la miniaturisation.
Le verdict final est nuancé. D’un côté, l’ambition est réelle, et le choix du 12 nm est défendable d’un point de vue économique. De l’autre, l’absence de preuves indépendantes, le flou sur les spécifications, et l’opacité de l’entreprise jettent un doute sérieux sur la crédibilité de l’annonce. Le tape-out d’une puce de test est une étape, pas une victoire. La route vers un GPU commercialisable est longue, semée d’embûches, et la plupart des startups n’y survivent pas. Bolt Graphics a fait un premier pas ; il lui reste à prouver qu’elle peut marcher jusqu’au bout.
Sources
- Bolt Graphics completes tape-out of test chip for its high-performance Zeus GPU (PRNewswire via Yahoo Finance)
- Bolt Graphics tapes out its first Zeus GPU test chip on TSMC 12nm — firm touts 1 exaflop (Yahoo Tech)
- Bolt Graphics Zeus GPU: up to 10x faster than RTX 5090 in rendering workloads, expandable RAM (TweakTown)
- NVIDIA DGX GH200: 256 puces Grace Hopper, 144 To de mémoire et 1 exaflop en FP8 (Next.ink)
- El Capitan propulsé par les puces AMD Instinct atteint 1,742 exaflops (HPC Developpez)
- Alice Recoque : le HPC exascale français qui va propulser le TGCC (ITforBusiness)
- Supercalculateur Frontier : AMD au cœur du plus puissant ordinateur au monde (Coop-r)
Article recherché et rédigé automatiquement · Magazine Electrosens