
 ElectroTech · 29 October 2026
Bolt Graphics tape-out son GPU Zeus en 12 nm : derrière le « 17× moins cher », ce que le silicium dit vraiment
Le 22 avril 2026, la startup californienne Bolt Graphics annonçait avoir bouclé le tape-out de sa puce de test pour son GPU Zeus, gravée sur le nœud TSMC 12 nm FFC. Dans un marché où Nvidia et AMD se disputent les nœuds 3 nm et 4 nm pour l’IA et le HPC, ce choix de procédé mature interpelle. Mais entre la promesse d’un « 17× moins cher » et les chiffres — désormais publics — de la fiche produit, il faut trier ce qui relève de l’ingénierie et ce qui relève du communiqué. Décryptage à froid, sources à l’appui.
Le pari de Sunnyvale : défier Nvidia avec un nœud de 2012
En cette fin 2026, le marché des GPU est plus verrouillé que jamais. Nvidia règne sans partage sur le calcul intensif et l’IA, avec des architectures gravées en 3 nm et 4 nm, des systèmes comme le DGX GH200 qui enchaîne 256 superpuces Grace Hopper pour atteindre 1 exaflop en précision FP8, et 144 To de mémoire partagée. AMD n’est pas en reste : ses Instinct propulsent les supercalculateurs les plus rapides du monde, El Capitan a atteint 1,742 exaflop au classement TOP500, et le français Alice Recoque, construit par Eviden avec des puces AMD, doit dépasser l’exaflop en double précision FP64 d’ici 2027. Dans ce paysage, l’arrivée d’un acteur inconnu, Bolt Graphics, qui annonce un tape-out sur un nœud TSMC 12 nm — un procédé dont la maturité remonte au début des années 2010 — a de quoi surprendre.
Le communiqué, diffusé via PRNewswire et relayé notamment par Tom’s Hardware, est sans ambiguïté : Bolt Graphics a « complété le tape-out de sa puce de test pour son GPU Zeus haute performance ». C’est, selon Tom’s Hardware, le premier passage de l’entreprise de l’émulation FPGA au silicium réellement fabriqué. La puce est conçue sur le nœud TSMC 12 FFC (12 nm), avec une architecture scalable prévue pour des nœuds avancés jusqu’à 5 nm. L’entreprise vise une montée en production au quatrième trimestre 2027. Et surtout, elle revendique une réduction du coût total de calcul (TCO) allant jusqu’à 17 fois par rapport aux architectures existantes.
Ce choix contre-intuitif pose immédiatement la question : est-ce une révolution d’ingénierie ou un aveu de faiblesse financière ? Car si le 12 nm est un nœud éprouvé, à haut rendement et relativement abordable, il est aussi limité en densité de transistors et en fréquence maximale par rapport aux nœuds avancés. Pour un GPU qui se veut « haute performance », le pari est physiquement exigeant — mais il faut désormais le juger sur les chiffres publiés, pas sur les rumeurs.
Zeus sur le papier : ce que la fiche produit dit (enfin) vraiment
Longtemps, l’annonce de Bolt Graphics est restée remarquablement avare en détails. Ce n’est plus tout à fait vrai : la fiche produit reprise par Tom’s Hardware précise désormais les formats et les puissances. Zeus doit être commercialisé en carte PCIe et en serveur 2U. Les cartes PCIe vont d’un modèle simple slot de 120 W affichant 5/10/20 TFLOPS en FP64/FP32/FP16, jusqu’à une carte double slot de 250 W offrant le double de ces valeurs. Toutes les cartes embarquent de la mémoire HBM (la source tronque le détail de la capacité, mais confirme la présence de HBM).
Ce détail change la lecture de l’annonce. On est très loin d’un « exaflop sur une puce » : les variantes annoncées plafonnent à 10/20/40 TFLOPS selon la précision pour la carte 250 W. Autrement dit, Zeus se positionne d’abord comme un accélérateur de rendu et de simulation à coût maîtrisé, pas comme un monstre de calcul IA. La promesse initiale, formulée lors de la présentation de Zeus début 2025, était d’ailleurs différente : Bolt affirmait alors jusqu’à 10 fois le débit de path tracing d’une GeForce RTX 5090. C’est ce chiffre-là — et non un exaflop — qui a fait le tour de la presse spécialisée, et qui reste, à ce jour, non mesuré sur silicium.
Le communiqué cite le Dr. Ian Cutress, analyste en chef chez More Than Moore, pour saluer le tape-out comme « une étape importante pour le path tracing accéléré ». Une citation flatteuse, mais qui émane d’un tiers dont la déclaration est relayée par l’entreprise elle-même — pas d’une source indépendante. Bolt cible explicitement trois marchés : le HPC, la simulation électromagnétique et le rendu graphique, qu’il valorise à plus de 55 milliards de dollars cumulés, et vise les entreprises qui « ne peuvent pas se permettre le niveau de calcul nécessaire à leurs applications ». C’est un positionnement de niche assumé, pas une attaque frontale contre le DGX de Nvidia.
12 nm, le choix de la raison ou de la survie ? Décryptage d’un nœud mature
Pourquoi une startup choisit-elle le 12 nm en 2026, alors que Nvidia et AMD se battent sur du 3 nm et du 4 nm ? La réponse tient en trois mots : coût, rendement, et risque. Un tape-out sur un nœud avancé comme le 5 nm ou le 4 nm coûte des dizaines de millions de dollars, uniquement pour les masques. Sur du 12 nm, le coût des masques est d’un ordre de grandeur inférieur, et le rendement de production est bien plus élevé — les défauts de gravure sont mieux maîtrisés sur un procédé mature. Pour une startup sans levée de fonds publique connue, c’est souvent la seule voie viable.
Tom’s Hardware confirme d’ailleurs la logique : le 12 nm FFC de TSMC appartient à la famille FinFET mature 16 nm/12 nm, qui offre un coût plus bas et des bibliothèques d’IP bien établies par rapport aux procédés de pointe. C’est exactement ce que l’on attend d’un tape-out de validation : on grave un prototype pour vérifier que la logique fonctionne, que les horloges tiennent, que la consommation est conforme, avant d’envisager une transposition.
Mais ce choix a un prix physique. Le 12 nm FFC est un nœud FinFET de première génération, avec une densité de transistors nettement inférieure à celle du 5 nm, et une fréquence maximale plafonnée autour de 2 à 2,5 GHz, là où les nœuds avancés montent plus haut. La consommation par transistor est plus élevée, ce qui oblige à des compromis sur le nombre de cœurs actifs et la dissipation thermique. C’est précisément pourquoi Bolt annonce des cartes à 120 W et 250 W plutôt qu’un accélérateur de plusieurs kilowatts : le nœud mature impose la sobriété.
L’exaflop en question : d’où venait le chiffre, et pourquoi il faut l’oublier
Le chiffre « 1 exaflop » a circulé dans certains titres au moment de l’annonce. Il faut être clair : ni le communiqué officiel ni la fiche produit reprise par Tom’s Hardware ne l’établissent. Les spécifications publiées parlent de 5/10/20 TFLOPS (FP64/FP32/FP16) pour la carte 120 W et du double pour la carte 250 W. Un exaflop, c’est un million de gigaflops : on en est à des ordres de grandeur radicalement différents. Le « 1 exaflop » relève donc de l’effet de titre, pas de la donnée technique vérifiable.
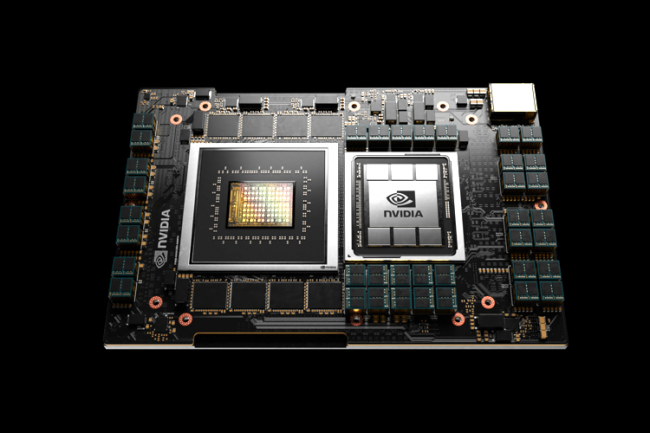
Cette mise au point est essentielle, car elle change la nature du débat. Un exaflop en FP8 n’a pas la même valeur qu’un exaflop en FP64, et c’est précisément le terrain sur lequel Nvidia (DGX GH200, FP8) et AMD (El Capitan, 1,742 exaflop en FP64) se mesurent. Mais Zeus ne joue pas dans cette cour. Sa cible, c’est le rendu path tracing et la simulation électromagnétique à coût contenu — des charges de travail où l’on travaille en FP32, parfois en FP16 pour les calculs intermédiaires, et où la question pertinente n’est pas « combien d’exaflops » mais « combien coûte l’image rendue ».
C’est là que la promesse des 17× prend son sens — et ses limites. Une réduction du TCO par 17 ne signifie pas 17 fois plus de calcul brut : elle signifie qu’à charge de travail égale, le coût total (acquisition, énergie, exploitation) serait divisé. Sur un nœud mature, avec des cartes à 120-250 W et de la HBM, l’argument est plausible sur le papier pour des charges spécialisées. Mais il n’est étayé par aucun benchmark indépendant : il repose sur les calculs de l’entreprise, et Tom’s Hardware rappelle que les performances revendiquées ont jusqu’ici reposé « entièrement sur des simulations internes et des tests FPGA ».
Du FPGA au silicium : ce que le tape-out change (et ne change pas)
Il faut mesurer l’étape franchie sans la surinterpréter. Jusqu’à présent, Bolt Graphics n’avait rien fabriqué : ses chiffres venaient de simulations et de FPGA. Dans une FAQ publiée avec l’annonce, l’entreprise affirme que son architecture tourne sur FPGA et est évaluée par des clients depuis quatre ans. Le tape-out d’une puce de test marque donc le premier contact avec du silicium réel — une étape concrète, mais qui reste une étape de validation.
Car un tape-out de puce de test, ce n’est pas un produit finalisé. On grave un prototype pour vérifier que la logique fonctionne, que les horloges tiennent, que la consommation est conforme. Entre ce tape-out et un GPU commercialisable, il reste des mois de tests, de corrections, et de nouvelles itérations. Bolt le sait : la puce de test servira explicitement à des benchmarks clients avant une montée en production prévue au quatrième trimestre 2027. C’est un calendrier crédible pour un premier produit, mais qui laisse près d’un an et demi de validation — et l’histoire des semi-conducteurs regorge de startups qui ne franchissent pas cette marche.
Le point positif, objectivement, est que Bolt a fait ce que beaucoup de startups HPC ne font jamais : passer de la diapositive au masque de lithographie. Le point négatif, tout aussi objectif, est qu’aucun média technique indépendant n’a pu tester la puce, ni même la voir fonctionner. Guru3D a relayé l’annonce d’une puce de test « fonctionnelle », mais il s’agit de la reprise du communiqué, pas d’une mesure tierce. La prudence reste donc de mise sur les performances réelles.
Bolt Graphics, startup fantôme ou futur géant ? Une crédibilité encore à prouver
Le plus troublant dans cette annonce reste le manque d’informations vérifiables sur l’entreprise elle-même. Le fondateur, CEO et CTO, Darwesh Singh, est présenté comme le créateur de Bolt Graphics, mais aucune source indépendante du corpus ne documente son parcours professionnel. Aucune donnée non plus sur les levées de fonds : pas de série A, pas de série B, pas d’investisseurs VC identifiés. Le siège social est à Sunnyvale, en Californie, et c’est à peu près tout ce que l’on peut affirmer sans spéculer.

Attention toutefois à un piège de recherche évident : « Bolt » est aussi le nom d’une super-application européenne de mobilité, qui exploite trottinettes et VTC dans plus de 850 villes et revendique plus de 4,5 millions de partenaires. Les résultats web mélangent allègrement les deux entités. Il ne faut évidemment pas confondre Bolt Graphics (semi-conducteurs, Sunnyvale) avec Bolt (mobilité, Tallinn). Cette homonymie n’aide pas à la vérification, mais elle n’enlève rien au fond : sur Bolt Graphics, le corpus fourni ne contient ni organigramme détaillé, ni tour de table, ni client nommé.
Le communiqué ne s’appuie que sur PRNewswire, et la citation de Ian Cutress est relayée par l’entreprise elle-même. C’est un signal à surveiller : dans l’industrie des semi-conducteurs, les annonces de tape-out sont fréquentes, mais la plupart des startups ne survivent pas à la phase de validation silicium. Les retards de plusieurs trimestres sont la norme. La crédibilité de Bolt Graphics se jugera donc sur un seul critère : la publication, d’ici la production de 2027, de benchmarks indépendants sur silicium réel.
Face aux géants : quand Nvidia empile les milliards, Bolt mise sur la niche
Mettons les choses en perspective. Nvidia a investi des dizaines de milliards de dollars dans ses architectures, son écosystème CUDA et ses systèmes. AMD a fait de même avec ROCm et ses partenariats avec les grands centres de calcul. Le supercalculateur El Capitan, propulsé par les Instinct d’AMD, a coûté plus de 600 millions de dollars. Alice Recoque, le premier exascale européen, est un projet de plusieurs centaines de millions d’euros porté par Eviden et le CEA. Face à cela, Bolt Graphics, avec son tape-out sur 12 nm et son équipe discrète, semble jouer dans une autre catégorie.
Mais c’est peut-être justement là que réside la stratégie. Bolt ne cherche pas à concurrencer Nvidia sur le terrain de l’IA massive, où les budgets se comptent en milliards. Elle vise une niche : le rendu path tracing et la simulation électromagnétique, un domaine où les GPU traditionnels restent coûteux, et où une architecture spécialisée sur nœud mature pourrait faire la différence. La promesse de réduction du TCO par 17 est un argument de vente : si Zeus peut faire le travail de plusieurs GPU avec une carte de 120 à 250 W, même sur un nœud mature, le coût total d’acquisition et d’exploitation pourrait être inférieur. C’est séduisant pour les studios d’animation, les bureaux d’études et les centres de calcul qui n’ont pas les budgets des hyperscalers.
Mais elle repose sur des hypothèses non vérifiées : consommation réelle, refroidissement, fiabilité, et surtout disponibilité d’un écosystème logiciel. Car c’est là que se joue la vraie bataille. Un accélérateur sans compilateur mature, sans bibliothèques de rendu optimisées et sans communauté de développeurs reste une belle fiche technique. Nvidia a mis quinze ans à bâtir CUDA ; Bolt devra répondre à cette question avant 2027, et le communiqué n’en dit rien.
Ce que cela change pour l’ingénieur : trois leçons concrètes
Au-delà du cas Bolt, l’annonce offre trois enseignements utiles pour quiconque conçoit de l’électronique en 2026.

Premièrement, le nœud mature n’est plus synonyme de retard. Alors que le GaN s’invite dans les racks IA de 800 V et que les circuits de gestion de batterie migrent vers des architectures distribuées, une partie de l’innovation se joue désormais sur l’optimisation coût/rendement plutôt que sur la course au nanomètre. Le 12 nm FFC de TSMC, avec ses bibliothèques d’IP établies, reste un terrain de jeu légitime pour valider une architecture avant de la transposer.
Deuxièmement, il faut se méfier des chiffres sans unité. « 17× moins cher », « 10× plus rapide », « 1 exaflop » : sans précision de charge de travail, de précision numérique et de méthode de mesure, ces valeurs ne veulent rien dire. La fiche produit de Zeus, avec ses 5/10/20 TFLOPS en FP64/FP32/FP16, est bien plus informative que n’importe quel superlatif — et elle raconte une histoire beaucoup plus modeste que les titres.
Troisièmement, la validation silicium reste le juge de paix. Un tape-out de puce de test est une étape réelle, mais ce n’est ni un produit, ni une preuve de performance. La règle vaut pour Bolt comme pour tous les acteurs : tant qu’aucun benchmark indépendant n’a été publié sur du silicium, les promesses restent des promesses. Rendez-vous est pris pour le quatrième trimestre 2027 — et, espérons-le, pour des mesures tierces bien avant.
Sources
- Tom’s Hardware — Bolt Graphics tapes out its first Zeus GPU test chip on TSMC 12nm (avril 2026) : nœud TSMC 12nm FFC, passage FPGA → silicium, TCO 17×, formats PCIe/2U, 120 W et 250 W, 5/10/20 TFLOPS FP64/FP32/FP16, HBM, production Q4 2027, marchés HPC/simulation EM/rendu (>55 Md$), architecture prévue jusqu’au 5 nm, FAQ « quatre ans de FPGA ».
- Guru3D — Bolt Graphics Reports Zeus GPU Test Chip Successfully Operating : reprise du communiqué sur la puce de test fonctionnelle.
- Generation-NT — Bolt Graphics finalise sa puce Zeus : reprise francophone de l’annonce et du comparatif avec la RTX 5090.
- Lego-SIA — Bolt Graphics Tapes Out Zeus GPU on TSMC 12nm, Delivering a 17x… : synthèse de l’annonce et du chiffre de TCO.
- Bolt (entreprise) — Wikipédia et bolt.eu : précision sur l’homonymie — Bolt (mobilité, Tallinn) n’a aucun lien avec Bolt Graphics (semi-conducteurs, Sunnyvale).
- Contexte marché HPC : TOP500 (El Capitan, 1,742 exaflop), DGX GH200 (1 exaflop FP8, 144 To), projet Alice Recoque (Eviden/AMD, >1 exaflop FP64 d’ici 2027) — éléments de comparaison repris du corpus du magazine.
Article recherché et rédigé automatiquement · Magazine Electrosens