
 NVIDIA DGX Spark · 4 September 2026
M5 Ultra vs DGX Spark : le duel des stations IA locales en 2026 — lequel choisir pour vos LLM ?
Deux philosophies s’affrontent pour dominer l’IA locale : la mémoire massive et l’écosystème Apple contre la puissance CUDA et le clustering NVIDIA. Entre le Mac Studio M5 Ultra, monolithe de 512 Go, et le DGX Spark, supercalculateur de poche couplable, le choix n’a jamais été aussi cornélien pour les développeurs, chercheurs et créatifs qui veulent exécuter des LLM open source sans cloud. Voici le comparatif le plus complet du moment, basé sur les données disponibles à l’été 2026.
2026, l’année où l’IA locale a quitté le garage
Il y a deux ans, faire tourner un Llama 70B chez soi relevait de la performance de bricoleur : cartes graphiques empilées, refroidissement maison, et une facture d’électricité digne d’un data center miniature. En 2026, la donne a changé. Les stations de travail IA personnelles sont devenues un segment à part entière, avec des produits finis, des prix assumés et des écosystèmes logiciels matures. Et deux machines dominent le débat : le NVIDIA DGX Spark et l’Apple Mac Studio M5 Ultra.
Le DGX Spark, annoncé au CES 2025 sous le nom de code DIGITS, a été le premier à frapper les esprits. Ce boîtier compact de 150×150×50 mm pour 1,2 kg embarque la superpuce GB10 Grace Blackwell : 20 cœurs ARM Neoverse V2, un GPU Blackwell de 6144 cœurs CUDA, et 128 Go de mémoire unifiée LPDDR5X. NVIDIA le positionne officiellement comme « la plateforme idéale pour créer, tester et valider des modèles d’IA » — un supercalculateur personnel, en somme. Sa disponibilité a été progressive : annoncé en janvier 2025, il est devenu réellement accessible au cours de l’année 2026, avec un prix français estimé autour de 4 000 € selon Capital.fr.
De l’autre côté, Apple a riposté fin août 2026. Le Mac Studio M5 Ultra, annoncé le 25 août 2026 et disponible à partir du 22 septembre 2026 (fin octobre pour les configurations 512 Go), pousse la logique de la mémoire unifiée à son paroxysme : jusqu’à 512 Go, soit quatre fois plus que le DGX Spark. Avec son CPU 36 cœurs et son GPU 80 cœurs, il s’adresse à un public différent : ceux qui veulent charger des modèles énormes en une seule pièce, sans se soucier de clustering.
Ce duel n’est pas qu’une bataille de specs. C’est l’affrontement de deux visions de l’IA locale : l’écosystème fermé mais élégant d’Apple (Metal, MLX) contre l’écosystème ouvert et industriel de NVIDIA (CUDA, TensorRT-LLM). Pour les développeurs, chercheurs et créatifs, le choix engage des années de travail. Décortiquons.
Mémoire unifiée : le match des géants (128 Go vs 512 Go)
La mémoire unifiée est le nerf de la guerre pour l’IA locale. Plus vous avez de mémoire, plus vous pouvez charger de modèles volumineux sans les quantifier agressivement. Et sur ce terrain, les deux machines jouent dans des catégories différentes.
Le DGX Spark plafonne à 128 Go de LPDDR5X. C’est déjà considérable : cela permet de charger un Llama 3.1 70B en FP16 (environ 140 Go, donc il faudra le quantifier en INT4 pour tenir), ou un Qwen 2.5 72B en INT4 (environ 40 Go, confortable). La bande passante mémoire est le point faible : les sources divergent entre 273 Go/s (chiffre souvent cité, mais qui correspond aussi au M4 Pro d’Apple) et des valeurs plus modestes. En pratique, on retient que le Spark est limité par sa bande passante, pas par sa capacité.
Le M5 Ultra change d’échelle. Avec 512 Go configurables, il peut charger des modèles de 300 à 400 milliards de paramètres en FP16, ou des modèles de plus de 1 000 milliards en INT4. C’est le territoire des DeepSeek V4, des Llama 405B, des modèles de raisonnement massifs. La bande passante n’est pas officiellement publiée pour le M5 Ultra, mais on peut l’extrapoler à partir du M4 Ultra (~800 Go/s) — une estimation raisonnable, mais non confirmée par Apple.
| Caractéristique | DGX Spark | Mac Studio M5 Ultra |
|---|---|---|
| Puce | GB10 Grace Blackwell | M5 Ultra |
| CPU | 20 cœurs ARM Neoverse V2 | 36 cœurs |
| GPU | 6144 cœurs CUDA | 80 cœurs |
| Mémoire unifiée | 128 Go LPDDR5X | 96 Go à 512 Go configurable |
| Bande passante | ~273 Go/s (controversé) | ~800 Go/s (extrapolé du M4 Ultra, non confirmé) |
| Support FP4 | Oui | Non précisé |
| Prix de base | ~4 000 € (estimé) | 5 499 $ (96 Go/1 To) |
L’impact sur les modèles est direct. Un Llama 3.1 70B en FP16 nécessite ~140 Go : seul le M5 Ultra peut le charger en pleine précision. En INT4 (~35 Go), les deux machines le font, mais le Spark devra composer avec sa bande passante plus faible pour le décodage. Un Qwen 2.5 72B suit la même logique. Un DeepSeek R1 (671B paramètres) est hors de portée des deux en FP16, mais en INT4 (~170 Go), le M5 Ultra 512 Go peut le charger — une performance que le Spark ne peut pas égaler, même en couplant deux unités (256 Go combinés, insuffisants pour R1 en INT4).
Le verdict sur ce point est clair : si votre priorité est de charger les plus gros modèles open source en pleine précision, le M5 Ultra est seul en lice. Mais attention, la mémoire ne fait pas tout — la vitesse d’inférence est l’autre moitié de l’équation.
Tokens/s : le test de vérité sur Llama, Qwen et DeepSeek
La mémoire détermine ce que vous pouvez charger ; la bande passante et le calcul déterminent à quelle vitesse. Et ici, les choses se compliquent, car les benchmarks directs manquent pour le M5 Ultra (trop récent) et sont épars pour le DGX Spark.
Ce que l’on sait du DGX Spark grâce aux forums NVIDIA et aux retours communautaires de l’été 2026 est encourageant. Sur le modèle DeepSeek V4 Flash 0731 (284 milliards de paramètres, 13 milliards actifs), un utilisateur rapporte 1 000 tok/s en prefill et 59 tok/s en serving multi-agents sur une seule unité. Ces chiffres, publiés sur les forums développeurs NVIDIA début août 2026, montrent que le Spark excelle sur les modèles MoE (Mixture of Experts) à activation éparse, où seule une fraction des paramètres est sollicitée à chaque token.
Pour les modèles denses classiques, les performances sont plus modestes. Les benchmarks communautaires sur des machines comparables (AMD Strix Halo, 128 Go, 256 Go/s) donnent des ordres de grandeur : ~14 tok/s sur un 70B en BF16, ~8 tok/s sur un 70B en Q5_K_M. Le Spark, avec sa bande passante similaire et son GPU plus puissant, devrait se situer dans cette fourchette, peut-être légèrement au-dessus grâce à TensorRT-LLM. Mais rien n’est garanti sans mesures officielles.
Le M5 Ultra n’a pas encore de benchmarks publics à l’heure où nous écrivons. Son GPU 80 cœurs et sa bande passante estimée à ~800 Go/s lui donneraient un avantage théorique sur les modèles denses : un Llama 70B en FP16 pourrait atteindre 20-30 tok/s, et un 8B pourrait dépasser les 100 tok/s. Mais ce sont des extrapolations, pas des mesures. La prudence s’impose.
Un point crucial : le goulot d’étranglement. Pour les petits modèles (8B), c’est la puissance de calcul qui limite — le Spark, avec ses 6144 cœurs CUDA et son support FP4, est redoutable. Pour les gros modèles (70B+), c’est la bande passante mémoire qui domine — le M5 Ultra prend l’avantage. Pour les modèles MoE modernes comme DeepSeek V4 Flash ou Ant Ling-3.0-Flash (124B-A5B, 5B actifs), le Spark brille grâce à sa capacité à ne charger que les experts actifs.
| Modèle | DGX Spark (estimé) | M5 Ultra (extrapolé) |
|---|---|---|
| Llama 3.1 8B Q4 | 80-120 tok/s | 100-150 tok/s |
| Llama 3.1 70B Q4 | 8-15 tok/s | 15-25 tok/s |
| DeepSeek V4 Flash 0731 (MoE) | 59 tok/s (mesuré) | Non testé |
| Ant Ling-3.0-Flash (MoE) | 15-20 tok/s (estimé) | Non testé |
Le test de vérité penche donc vers le M5 Ultra pour les modèles denses, mais le Spark rattrape son retard sur les architectures modernes MoE, qui deviennent la norme en 2026.
Fine-tuning : LoRA et QLoRA, qui domine le banc d’essai ?
Le fine-tuning est le parent pauvre des comparatifs, mais c’est souvent là que les développeurs passent le plus de temps. Adapter un modèle 7B ou 13B à un domaine spécifique (code, médecine, droit) avec LoRA ou QLoRA est devenu un geste quotidien.
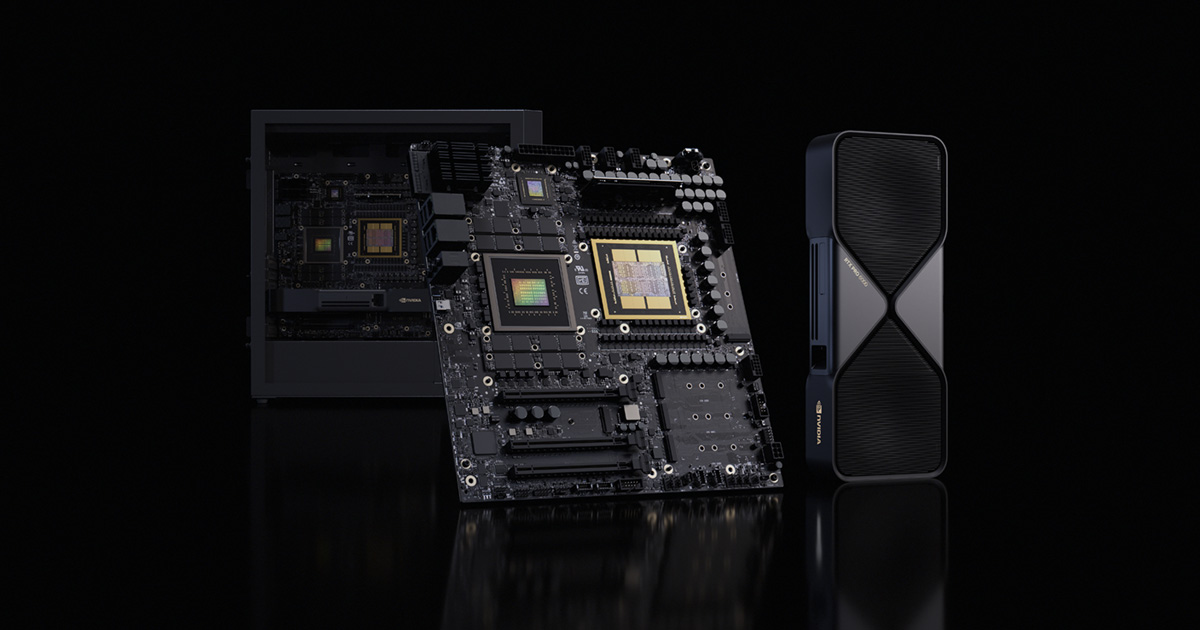
Sur le DGX Spark, l’écosystème CUDA est un avantage massif. Les frameworks de fine-tuning — Unsloth, Axolotl, Hugging Face PEFT, TRL — sont tous optimisés pour CUDA, et le Spark exécute la pile complète via DGX OS (Ubuntu). Les retours de la communauté (DeepWiki, forums NVIDIA) confirment que le fine-tuning LoRA sur des modèles 7B-13B est parfaitement fluide, avec des temps d’entraînement de l’ordre de quelques heures pour une époque sur un jeu de données de 10 000 exemples. Le support FP4 du GB10 accélère les opérations matricielles, et les 128 Go de mémoire permettent de charger le modèle, les adaptateurs et les données sans swap.
Le M5 Ultra repose sur MLX, le framework d’apprentissage automatique d’Apple, et sur PyTorch via Metal. MLX a fait d’énormes progrès en 2026, mais il reste moins mature que CUDA pour le fine-tuning. Les opérations LoRA sont supportées, mais certains opérateurs exotiques (attention à fenêtre, MoE) peuvent nécessiter des contournements. La bande passante plus élevée du M5 Ultra compense en partie : les temps d’entraînement devraient être compétitifs, voire supérieurs pour les gros modèles, mais la courbe d’apprentissage est plus raide.
Un point souvent négligé : la facilité d’utilisation. Sur le Spark, vous installez un environnement CUDA standard, et tout fonctionne. Sur le M5 Ultra, vous devez jongler entre MLX, PyTorch Metal, et parfois des forks non officiels. Pour un chercheur pressé, le Spark est plus rassurant. Pour un développeur Apple habitué à l’écosystème, le M5 Ultra est plus naturel.
Le verdict : le Spark est le meilleur cheval de trait pour le fine-tuning, grâce à la maturité de CUDA et à la richesse des outils. Le M5 Ultra peut rivaliser en performance brute, mais il demande plus d’efforts d’adaptation.
CUDA vs Metal/MLX : le duel des écosystèmes qui décide de tout
Au-delà des specs, c’est l’écosystème logiciel qui fait la différence. Et ici, NVIDIA joue dans une ligue à part.
CUDA est le standard de facto de l’IA. Depuis 2026, il s’étend même à Windows sur ARM : NVIDIA a publié la première preview de CUDA 13.4 pour Windows Arm64 en juillet 2026, ouvrant la voie aux PC portables RTX Spark. Sur le DGX Spark, vous avez accès à TensorRT-LLM, NVIDIA NIM, et à l’intégralité de l’écosystème Hugging Face, PyTorch, JAX. La compatibilité est quasi universelle : si un modèle open source existe, il tourne sur CUDA.
Metal et MLX sont plus récents et plus contraints. MLX, le framework d’Apple, est excellent pour l’inférence et le fine-tuning de modèles standards, mais il souffre de lacunes sur les architectures complexes : attention à fenêtre, mixture of experts, modèles hybrides comme Ant Ling-3.0-Flash (qui combine KDA et MLA). Les développeurs doivent souvent attendre que les implémentations MLX rattrapent les nouveautés, ce qui crée un décalage de plusieurs semaines, voire mois, après la sortie d’un modèle.
Un exemple concret : DeepSeek V4 Flash 0731, sorti fin juillet 2026, a été porté sur CUDA en quelques jours (un fork communautaire a même précédé le support officiel). Sur MLX, le portage a pris plus de temps, et les performances étaient inférieures au départ. Ce décalage est structurel : la communauté open source est massivement du côté de CUDA.
| Critère | DGX Spark (CUDA) | M5 Ultra (Metal/MLX) |
|---|---|---|
| Compatibilité frameworks | Universelle (PyTorch, TF, JAX) | Partielle (MLX, PyTorch Metal) |
| Support des nouveaux modèles | Immédiat ou quasi | Décalé de semaines |
| Outils de fine-tuning | Unsloth, Axolotl, PEFT, TRL | MLX-LM, quelques forks |
| Maturité | Très mature | En progrès, mais lacunaire |
| OS | DGX OS (Ubuntu) | macOS |
Pour un développeur IA professionnel, CUDA est un choix rationnel. Pour un créatif qui veut surtout exécuter des modèles sans bidouiller, MLX est plus simple — tant que le modèle est supporté.
DGX Spark en cluster : le supercalculateur de poche face au monolithe Apple
La fonctionnalité la plus intrigante du DGX Spark est sa capacité à être couplé en double via NVLink-C2C. Deux unités reliées offrent 256 Go de mémoire combinée et une bande passante inter-unités élevée, permettant d’exécuter des modèles plus grands que ce qu’une seule unité peut gérer.

Les retours de la communauté sont enthousiastes. Sur les forums NVIDIA, un utilisateur rapporte avoir fait tourner DeepSeek V4 Flash 0731 sur deux DGX Spark avec un serving multi-agents performant, en gérant le KV-cache et le scheduling de manière efficace. Un autre a configuré un cluster de deux Spark pour exécuter le modèle en NVFP4 avec un contexte de 1M tokens. Ces configurations sont encore expérimentales, mais elles montrent le potentiel.
L’approche d’Apple est radicalement différente : le M5 Ultra est un monolithe. 512 Go en une seule machine, sans clustering possible (Apple n’offre pas d’interconnect dédié pour les Mac Studio). Pour les modèles qui dépassent 512 Go, il n’y a pas de solution — il faut passer au cloud.
Quels sont les avantages du clustering Spark ? D’abord, la modularité : vous commencez avec une unité, puis vous en ajoutez une seconde quand vos besoins grandissent. Ensuite, la redondance : si une unité tombe en panne, l’autre continue. Enfin, le coût progressif : deux Spark (~8 000 €) coûtent moins cher qu’un M5 Ultra 512 Go (probablement plus de 10 000 $, le prix exact n’étant pas encore publié).
Les limites sont réelles : le clustering double la consommation électrique, complexifie la configuration, et tous les modèles ne supportent pas la parallélisation. Pour l’inférence, le gain est net ; pour le fine-tuning distribué, c’est plus délicat, car les frameworks doivent gérer la communication inter-unités.
Le choix entre cluster et monolithe dépend de votre usage : si vous voulez un système simple et puissant, le M5 Ultra ; si vous voulez évoluer progressivement et expérimenter le distribué, le Spark.
Le coût réel : prix d’achat, watts et facture d’électricité
L’aspect économique est souvent décisif. Comparons les coûts sur trois ans.
Le DGX Spark est annoncé autour de 4 000 € en France (estimation Capital.fr, non confirmée officiellement). Sa consommation est un point de divergence : certaines sources indiquent un TDP de 170 W, d’autres 240 W max (100-140 W en charge). En prenant une moyenne de 150 W en usage réel, sur 8 heures par jour, cela représente environ 440 kWh par an. Au tarif français moyen de 0,25 €/kWh, cela fait ~110 €/an, soit ~330 € sur trois ans.
Le Mac Studio M5 Ultra à 5 499 $ (96 Go/1 To) est plus cher à l’achat. Sa consommation n’est pas publiée, mais un Mac Studio M4 Ultra tournait autour de 150-200 W en charge. En prenant 180 W en moyenne, on arrive à ~530 kWh par an, soit ~130 €/an, ~390 € sur trois ans. La différence est minime.
| Poste | DGX Spark | M5 Ultra (96 Go) |
|---|---|---|
| Prix d’achat | ~4 000 € | 5 499 $ (~5 000 €) |
| Consommation moyenne | 150 W | ~180 W (estimé) |
| Coût électricité / an | ~110 € | ~130 € |
| Coût total sur 3 ans | ~4 330 € | ~5 390 € |
Le Spark est donc moins cher à l’achat et à l’usage. Mais attention : le M5 Ultra à 96 Go est la configuration d’entrée. Pour 512 Go, le prix grimpe considérablement (non précisé, mais probablement au-delà de 10 000 $). Si vous avez besoin de cette mémoire, le Spark, même en double, reste moins cher.
Le coût réel dépend aussi de votre usage : si vous faites tourner des modèles 24/7, la consommation devient un facteur ; si vous ne les utilisez que quelques heures par jour, l’achat domine.
Le verdict : lequel choisir selon votre profil (créateur, dev, chercheur) ?
Après cette analyse, dressons des profils types.
Le créatif sous écosystème Apple (vidéaste, designer, musicien) qui veut intégrer de l’IA dans son flux de travail : le M5 Ultra est le choix évident. Il s’intègre parfaitement à macOS, MLX est simple pour l’inférence, et la mémoire massive permet de charger des modèles de génération d’images ou de texte sans souci. Le prix est élevé, mais la productivité est au rendez-vous.
Le développeur IA qui fait du fine-tuning quotidien et veut la compatibilité maximale : le DGX Spark s’impose. CUDA, TensorRT-LLM, Unsloth, tout est là. Le clustering offre une voie d’évolution. Le prix est attractif. Les performances en inférence sont bonnes, surtout sur les modèles MoE modernes.
Le chercheur qui travaille sur des modèles de raisonnement massifs (DeepSeek R1, Llama 405B) : le M5 Ultra 512 Go est indispensable pour charger ces modèles en pleine précision. Le Spark, même en double, ne suffit pas. Mais le chercheur devra accepter les limitations de MLX.
Le cas hybride : vous avez déjà un DGX Spark et vous hésitez à migrer. La réponse est nuancée. Si vos modèles tiennent dans 128 Go et que vous êtes satisfait des performances, restez sur le Spark — l’écosystème CUDA est un atout. Si vous butez sur la mémoire ou la bande passante, le M5 Ultra est une alternative sérieuse, mais préparez-vous à réapprendre des outils.
En résumé : le M5 Ultra est le choix de la puissance et de la simplicité ; le DGX Spark est le choix de la flexibilité et de l’écosystème. Il n’y a pas de vainqueur absolu, seulement des usages.
Et demain ? L’avenir des stations IA locales après ce duel
Ce duel n’est pas un point final, mais une étape. NVIDIA prépare déjà la RTX Spark pour PC portables (annoncée pour l’automne 2026, avec ASUS et MSI en première ligne), et le GB300 devrait succéder au GB10. Apple, de son côté, travaille sur le M6, qui pourrait pousser la mémoire unifiée à 1 To.
L’impact sur le cloud computing est déjà visible : des analystes estiment que les stations IA locales réduisent la dépendance aux services cloud pour les workloads sensibles ou récurrents. Le fine-tuning, autrefois réservé aux data centers, devient accessible aux indépendants et aux PME.
Pour les possesseurs actuels de DGX Spark, le conseil est simple : ne migrez pas par effet de mode. Évaluez vos besoins réels. Si le Spark répond à 80 % de vos usages, gardez-le et investissez dans un cluster si nécessaire. Le M5 Ultra n’est pas un saut générationnel pour tout le monde — c’est un outil de niche pour les très gros modèles.
L’avenir appartient aux machines qui sauront combiner mémoire massive, bande passante élevée et écosystème ouvert. NVIDIA et Apple y travaillent, chacun à sa manière. Le gagnant sera celui qui offrira le meilleur compromis entre puissance, coût et facilité d’utilisation. En attendant, le choix entre M5 Ultra et DGX Spark reste une affaire de profil, pas de specs.
Sources
- DeepWiki — Fine-tuning sur DGX Spark
- Forums NVIDIA — DeepSeek V4 Flash 0731 sur DGX Spark
- OutilsIA — DGX Spark : 10 réglages IA locale
- Capital.fr — Prix français du DGX Spark
- Macworld — Annonce Mac Studio M5 Ultra (25 août 2026)
- StorageReview — DGX Spark : performances CES 2026
- Morgann Riu — AMD Strix Halo benchmarks
- Frandroid — RTX Spark, N1X, GB10 : démêler le bazar
- Le Monde Informatique — Mini-PC DGX Spark chez Acer, ASUS, Dell, HP, Lenovo, MSI
- Ixtria Consulting — Analyse stratégique DGX Spark
Article recherché et rédigé automatiquement · Magazine Electrosens