
 NVIDIA DGX Spark · 8 September 2026
DGX Spark en septembre 2026 : les LLM open-source qui tournent vraiment sur GB10, fine-tuning, clusters et mises à jour
Depuis janvier 2026, la DGX Spark de NVIDIA a redéfini ce qu’on peut attendre d’un ordinateur de bureau : 128 Go de mémoire unifiée, un petaflop FP4, et la capacité d’exécuter localement des modèles open-source de 120 milliards de paramètres. Neuf mois plus tard, l’écosystème a explosé : Nemotron, Llama, Qwen, DeepSeek, Ant Ling, Poolside Laguna, et une myriade de runtimes optimisés se disputent la machine. Voici l’état des lieux complet, chiffres à l’appui.
Un petaflop dans une boîte de 1,2 kg : la promesse GB10 tient-elle ?
Quand NVIDIA a dévoilé la DGX Spark au CES 2025, l’annonce avait des airs de gadget marketing : un ordinateur de bureau de 150 × 150 × 50,5 mm pesant 1,2 kg, capable de délivrer environ 1 petaflop de performance IA en FP4. Neuf mois après sa commercialisation, la machine s’est imposée comme une catégorie à part entière, entre le PC gaming haut de gamme et la station de travail professionnelle.
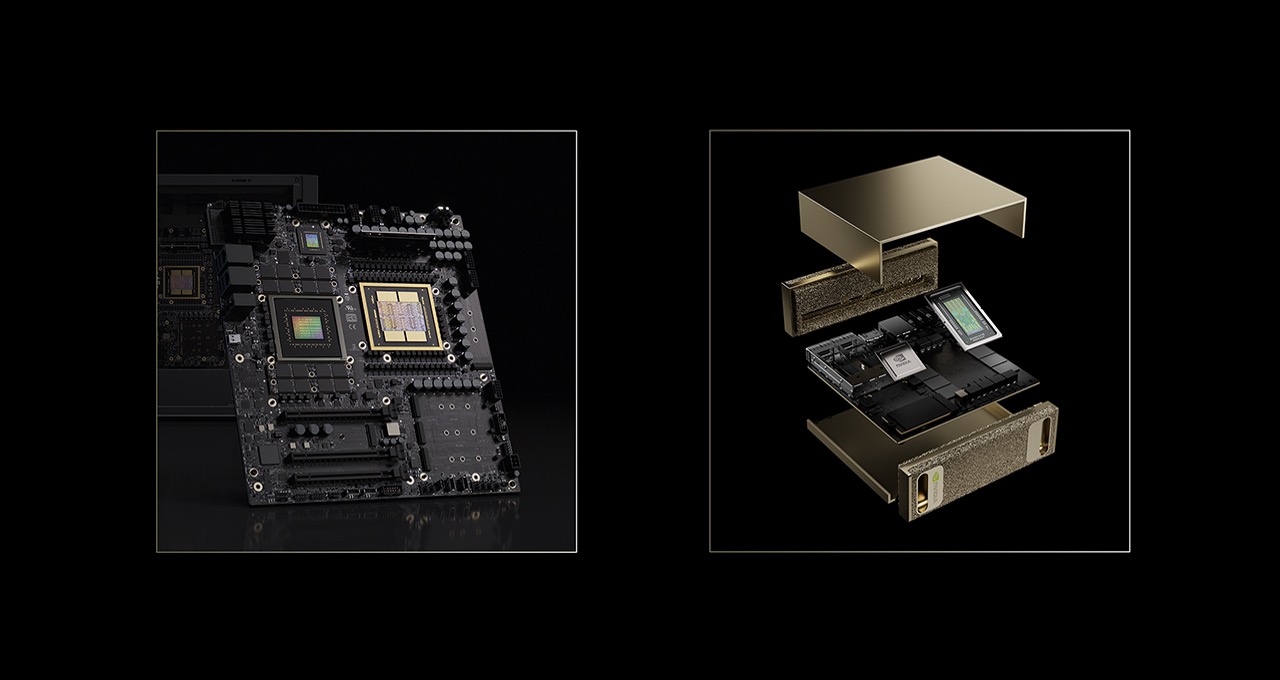
Le cœur de la bête est la superpuce Grace Blackwell GB10, qui combine un CPU ARM Grace et un GPU Blackwell dans un même package, reliés par une interconnexion NVLink-C2C. La mémoire unifiée LPDDR5X de 128 Go est accessible par le CPU et le GPU sans copie, ce qui change radicalement la donne par rapport à une architecture classique où la VRAM est un goulot d’étranglement. La bande passante annoncée de 273 Go/s — bien que non confirmée par NVIDIA officiellement — place la machine dans une catégorie intermédiaire entre un Mac Studio M2 Ultra (800 Go/s) et un PC portable équipé d’une RTX 5090 (32 Go de VRAM, mais avec une bande passante GDDR7 bien supérieure).
Le prix, lui, a connu des soubresauts. Annoncée initialement autour de 3 999 $, la DGX Spark a vu son tarif grimper à 4 699 $ en février 2026, selon HackerNoon, en raison de pénuries de mémoire. D’autres sources, comme dev.to, mentionnent un coût initial de 7 999 $ — une contradiction que NVIDIA n’a jamais officiellement tranchée. En pratique, les revendeurs européens la proposent entre 3 000 et 5 000 €, selon les configurations.
Côté logiciel, la machine a bénéficié de mises à jour régulières. En juin 2026, NVIDIA a déployé une mise à jour logicielle majeure promettant un gain de performance de 2,6× grâce au format de quantification propriétaire NVFP4, une pile logicielle enrichie et un support CUDA étendu. Le blog officiel « New Software and Model Optimizations Supercharge NVIDIA DGX Spark » documente ces évolutions, notamment l’optimisation de TensorRT-LLM et la collaboration avec llama.cpp. La machine supporte désormais CUDA 12.x pour TensorRT-LLM, avec des prérequis précis : Docker, et les ports TCP 8355 (LLM) et 8356 (VLM) pour les services d’inférence. En juillet 2026, une nouvelle mise à jour (DGX Spark Software Updates – July 2026 Release) a encore amélioré le support CUDA, les performances d’inférence et ajouté de nouveaux SDK.
Le 3 septembre 2026, NVIDIA a officialisé PAIR, un outil pour orchestrer l’IA locale sur ses machines, et une gamme de PC « Spark » pré-construits qui arriveront en octobre. Cette annonce marque un tournant : la DGX Spark n’est plus seulement un mini-supercalculateur pour développeurs, mais la tête de pont d’un écosystème plus large, avec des PC portables RTX Spark (ASUS, MSI, Microsoft Surface) et des mini-PC concurrents comme celui d’Acer, qui promet 128 Go de mémoire unifiée et le support de modèles à 200 milliards de paramètres pour 500 à 1 000 $ de moins que la DGX Spark.
128 Go de mémoire unifiée : le vrai game-changer pour les LLM open-source
La spécification la plus importante de la DGX Spark n’est ni le petaflop FP4 ni le CPU ARM, mais bien ses 128 Go de mémoire unifiée LPDDR5X. C’est elle qui permet d’exécuter des modèles que même les GPU les plus chers ne peuvent pas charger en VRAM.
Un GPU classique comme la RTX 5090 dispose de 32 Go de VRAM. Pour faire tourner un modèle de 70 milliards de paramètres en FP16, il faut environ 140 Go — impossible. Même en FP4, un modèle 70B pèse environ 35 Go, ce qui passe tout juste, mais sans laisser de place pour le cache KV (le contexte). La DGX Spark, avec ses 128 Go, peut charger des modèles jusqu’à environ 200 milliards de paramètres en quantification FP4, selon les estimations de la communauté. En pratique, les utilisateurs rapportent des exécutions fluides de modèles 120B (GPT-OSS, Nemotron-3-Super, Poolside Laguna S 2.1) et même de MoE massifs comme DeepSeek V4 Flash (284B de paramètres totaux, mais seulement 13B actifs par token).
La bande passante de 273 Go/s est le facteur limitant pour la génération de tokens (le « decode »), qui est essentiellement liée à la mémoire. C’est pourquoi les benchmarks montrent des débits de 35 à 80+ tokens/s pour des modèles 120B, et des vitesses bien plus élevées pour les petits modèles. Le « prefill » (le traitement du prompt) est, lui, limité par le calcul, et la machine excelle dans ce domaine grâce à ses cœurs Tensor de 5e génération.
Comparons avec les alternatives : un Mac Studio M2 Ultra avec 128 Go unifiés offre une bande passante de 800 Go/s, ce qui le rend plus rapide pour le decode, mais son écosystème logiciel pour l’IA est moins mature (pas de TensorRT-LLM, support CUDA absent). La RTX 5090, avec ses 32 Go, ne peut tout simplement pas charger les gros modèles. L’AMD Ryzen AI Halo (Strix Halo), avec ses 128 Go LPDDR5X et 256 Go/s de bande passante, est un concurrent sérieux : il atteint 34-39 tok/s sur des modèles 120B, mais son écosystème logiciel reste moins optimisé que celui de NVIDIA. La DGX Spark occupe donc un créneau unique : la capacité d’un petit serveur dans un format de mini-PC, avec le meilleur support logiciel du marché.
Nemotron, Llama, Qwen, DeepSeek, Ant Ling, Poolside : qui tient vraiment la cadence sur Spark ?
Le paysage des modèles open-source optimisés pour la DGX Spark a considérablement évolué depuis janvier 2026. NVIDIA a publié une matrice de support officielle pour TensorRT-LLM, listant les modèles testés et optimisés. En voici la synthèse, mise à jour avec les sorties de l’été 2026 :
| Famille | Modèles notables | Taille | Quantification supportée | Retours communauté |
|---|---|---|---|---|
| Nemotron | Nemotron-3-Super-120B | 120B | NVFP4, FP8 | 35-80+ tok/s, excellent raisonnement |
| GPT-OSS | GPT-OSS-120B | 120B | NVFP4 | Débit ~4x supérieur à Qwen 3.5 27B, mais moins bon en code |
| Llama | Llama 3.3-70B, Llama 4 (Scout/Maverick) | 70B-400B | NVFP4, INT8 | Llama 3 70B plus rapide que les 120B |
| Qwen | Qwen 3 (235B), Qwen 3.6 35B A3B, Qwen3.6-27B, Qwen3.8-27B | 27B-235B | NVFP4, UD-Q4_K_XL | Qwen 3.6 35B A3B : 200+ tok/s en NVFP4 ; Qwen3.6-27B : 163 tok/s en pic, 136 tok/s en multi-agents |
| DeepSeek | V3/R1 (671B MoE), V4 Flash 0731 (284B, 13B actifs) | 284B-671B | NVFP4, Q8 | V4 Flash : 30 tok/s sur 2× Spark, 59 tok/s en multi-agent sur 1× Spark |
| Ant Ling | Ling-3.0-Flash 124B-A5B | 124B (5B actifs) | NVFP4 | 15-20 tok/s sur 1× Spark, 256K contexte |
| Poolside | Laguna S 2.1 | 118B (8,5B actifs) | NVFP4 | Premier grand open-weight américain depuis 11 mois, domine les benchmarks code |
Les retours de la communauté, notamment sur les forums NVIDIA et Spark Arena, montrent que les modèles MoE (Mixture of Experts) sont particulièrement adaptés à la machine. DeepSeek V4 Flash 0731, sorti fin juillet 2026, est un cas d’école : avec seulement 13 milliards de paramètres actifs, il offre des performances « frontier-level » pour l’agentique, selon les tests de flowtivity.ai, et tourne sur deux DGX Spark en cluster avec un débit d’environ 30 tok/s par défaut — un chiffre qui peut être amélioré par une configuration du cache KV. Sur une seule Spark, un fork CUDA d’antirez/ds4 atteint 1 000 tok/s en prefill et 59 tok/s en multi-agent serving, selon un post du forum NVIDIA du 1er août 2026.
Ant Ling-3.0-Flash, publié le 23 juillet 2026 par Ant Group, est un autre exemple frappant : 124 milliards de paramètres totaux, mais seulement 5 milliards d’actifs par token, grâce à une architecture hybride (attention KDA et MLA empilées 5:1). Sur une seule DGX Spark, il atteint 15-20 tok/s, avec une fenêtre de contexte native de 256K tokens extensible à 1M. C’est un modèle pensé pour l’agentique, capable de traiter des documents entiers en une seule passe.
Poolside a frappé fort le 23 juillet 2026 avec Laguna S 2.1, un modèle de 118B paramètres (8,5B actifs) taillé pour le code et l’agentique. C’est le premier grand open-weight américain depuis 11 mois, et il domine les benchmarks de codage face à des modèles 10 fois plus gros, tout en tenant dans un seul desktop. Les tests communautaires sur Spark Arena confirment des débits de 35-80+ tok/s en NVFP4.
Qwen3.6-27B, sorti le 22 avril 2026 avec une version NVFP4 le 26 juin 2026, reste une valeur sûre : 27B paramètres, 256K de contexte, 163 tok/s en pic de decode, 136 tok/s en multi-agents (10 agents), et un score MMLU de 0,8446 en NVFP4. La version Qwen3.8-27B, testée le 20 août 2026, atteint 34-38 tok/s en génération. Llama 4 (Scout et Maverick) est également supporté, mais les benchmarks précis manquent encore dans les sources publiques. Les utilisateurs rapportent que Llama 3.3-70B en NVFP4 est plus rapide que les modèles 120B, ce qui en fait un choix pragmatique pour les usages quotidiens.
TensorRT-LLM, vLLM, llama.cpp, SGLang : la guerre des runtimes fait rage
Le choix du runtime d’inférence est aussi important que le choix du modèle. Sur DGX Spark, quatre acteurs se disputent les faveurs des utilisateurs : TensorRT-LLM (officiel NVIDIA), vLLM, SGLang et llama.cpp.

TensorRT-LLM est la bibliothèque open-source de NVIDIA, spécifiquement optimisée pour l’architecture Blackwell. Elle compile le graphe du modèle en kernels optimisés, fusionne les opérations, et exploite la quantification NVFP4 native. Le playbook officiel (build.nvidia.com/spark/trt-llm) détaille les prérequis : CUDA 12.x, Docker, et la release 1.3.0rc13. Les ports TCP 8355 et 8356 sont réservés aux services LLM et VLM. C’est le runtime qui offre les meilleures performances en FP4, mais sa configuration est plus complexe.
vLLM, de son côté, est plébiscité pour sa gestion du cache KV via PagedAttention, qui réduit la fragmentation mémoire et permet de servir plusieurs requêtes simultanément. Le blog vllm.ai a publié en juin 2026 un article dédié à la DGX Spark, mais les benchmarks communautaires utilisent souvent des versions obsolètes (vLLM 0.2.2), ce qui fausse les comparaisons. Les utilisateurs de Spark Arena recommandent de vérifier la version exacte avant de se fier aux chiffres.
llama.cpp, le runtime C++ minimaliste, a bénéficié d’une collaboration directe avec NVIDIA : selon le blog officiel, cette collaboration augmente les performances en moyenne de 35 % sur DGX Spark. C’est le runtime le plus simple à déployer, et il supporte les quantifications GGUF (Q4, Q8, UD-Q4_K_XL, UD-Q8_K_XL, etc.), ce qui le rend très populaire pour les tests rapides. Pour DeepSeek-V4-Flash-0731, la version Q8 (UD-Q8_K_XL) pèse 162 Go, seulement 7 Go de plus que la Q4, et permet une exécution en précision quasi sans perte.
SGLang, moins connu, est apprécié pour son support des modèles MoE et son scheduling avancé. Spark Arena le référence systématiquement dans ses benchmarks.
| Runtime | Points forts | Points faibles | Version recommandée |
|---|---|---|---|
| TensorRT-LLM | Kernels FP4 natifs, parallélisme | Configuration complexe | 1.3.0rc13 |
| vLLM | PagedAttention, KV cache efficace | Versions obsolètes fréquentes | Dernière stable (juil. 2026) |
| llama.cpp | Simple, GGUF, +35% perf avec NVIDIA | Moins optimisé pour FP4 | Dernière nightly |
| SGLang | MoE, scheduling avancé | Communauté plus restreinte | Dernière stable |
NVFP4 et sparsity : la compression qui fait tourner des 120B sur un bureau
La quantification NVFP4 (FP4 natif) est l’arme secrète de l’architecture Blackwell. NVIDIA annonce une compression des modèles jusqu’à 70 % par rapport au FP16, avec une perte de qualité minimale grâce à une mise à l’échelle adaptative par blocs. Concrètement, un modèle de 120 milliards de paramètres qui pèserait 240 Go en FP16 ne pèse plus que ~70 Go en NVFP4 — ce qui tient dans les 128 Go de la DGX Spark, avec de la place pour le cache KV. La mise à jour de juin 2026 a apporté un gain de performance de 2,6× grâce à une optimisation plus poussée de ce format.
Les gains en vitesse sont spectaculaires. GPT-OSS-120B en NVFP4 atteint des débits de 35 à 80+ tokens/s selon les configurations, soit environ 4 fois plus rapide que Qwen 3.5 27B en FP8, selon les tests de tokenstead.ai. Qwen 3.6 35B A3B, un modèle MoE avec 3 milliards d’actifs, dépasse les 200 tok/s sur le chemin NVFP4 optimisé — un chiffre qui le rend utilisable pour des applications temps réel.
La sparsity (2:4) est une autre optimisation clé : elle consiste à ne calculer que la moitié des poids, en exploitant le fait que les cœurs Tensor de Blackwell sont conçus pour cette structure. Combinée au FP4, elle permet de doubler encore le débit théorique. Cependant, tous les modèles ne supportent pas la sparsity — elle doit être intégrée lors de l’entraînement ou du fine-tuning. Les playbooks NVIDIA documentent les modèles compatibles, mais la liste reste limitée.
En pratique, les utilisateurs de Spark Arena rapportent que la quantification NVFP4 est devenue le standard de fait pour les modèles 70B et plus. Pour les petits modèles (8B-27B), les quantifications GGUF (Q4_K_M, UD-Q4_K_XL) sont souvent préférées car elles offrent un meilleur compromis qualité/vitesse, avec des débits qui dépassent largement les 100 tok/s.
Benchmarks communautaires : ce que Spark Arena révèle vraiment
Spark Arena (spark-arena.com) est devenu la référence pour comparer les performances réelles des LLM sur DGX Spark. Ce leaderboard communautaire s’appuie sur des exécutions standardisées via llama-benchy, un outil open source qui mesure les tokens/s, le temps de premier token (TTFT) et l’utilisation mémoire. Les configurations sont transparentes : runtime, version, quantification, nombre de requêtes concurrentes.
Les chiffres clés qui ressortent des données agrégées :
- Modèles 120B (GPT-OSS, Nemotron-3-Super, Laguna S 2.1) : 35 à 80+ tok/s en NVFP4, selon le runtime et la longueur du contexte. TensorRT-LLM est généralement le plus rapide, suivi de près par SGLang.
- DeepSeek V4 Flash 0731 : 30 tok/s sur 2× Spark en configuration par défaut, jusqu’à 59 tok/s en multi-agent serving sur 1× Spark avec le fork CUDA d’antirez/ds4, et 1 000 tok/s en prefill.
- Llama 3.3-70B : plus rapide que les 120B, avec des débits de 50 à 100 tok/s en NVFP4.
- Qwen3.6-27B : 163 tok/s en pic de decode, 136 tok/s en multi-agents (10 agents), 28-33 tok/s en session unique.
- Petits modèles (8B-27B) : quasi instantanés, avec des débits de 100 à 200+ tok/s.
Le protocole de test de Spark Arena a été adopté par la plupart des reviewers, ce qui permet des comparaisons fiables entre modèles et runtimes. Les résultats sont régulièrement mis à jour, et la communauté y ajoute des tests de fine-tuning et de clusters.
Fine-tuning sur DGX Spark : LoRA, QLoRA, Unsloth et full fine-tune en BF16
Le fine-tuning est devenu un usage majeur de la DGX Spark, grâce à ses 128 Go de mémoire unifiée et à la prise en charge de CUDA 12.x. Les workflows documentés sur DeepWiki (bidual/awesome-dgx-spark) couvrent plusieurs approches :
- LoRA (Low-Rank Adaptation) : la méthode la plus populaire. Elle consiste à entraîner de petits adaptateurs (quelques millions de paramètres) tout en gelant les poids du modèle de base. Sur la DGX Spark, un LoRA sur un modèle 70B en NVFP4 prend quelques heures et consomme moins de 20 Go de mémoire supplémentaire.
- QLoRA : variante de LoRA avec quantification 4-bit des poids de base. C’est la méthode recommandée pour les modèles 120B+ : elle permet de fine-tuner un modèle 120B avec seulement 30-40 Go de mémoire active, laissant de la place pour le cache KV et les gradients.
- Unsloth : la bibliothèque d’optimisation de fine-tuning, désormais compatible avec la DGX Spark, offre des gains de vitesse de 2-3× par rapport à Hugging Face PEFT, grâce à des kernels Triton optimisés pour Blackwell.
- Full fine-tune en BF16 : possible pour les modèles jusqu’à 30B (environ 60 Go en BF16), mais déconseillé au-delà à cause du coût mémoire des gradients et de l’optimiseur. Pour les modèles 70B+, le full fine-tune nécessite un cluster de plusieurs Spark ou des techniques de gradient checkpointing avancées.
Les outils comme NemoClaw (la suite NVIDIA de fine-tuning) et les playbooks officiels documentent les recettes pour chaque famille de modèles. La communauté rapporte que le fine-tuning LoRA sur Qwen3.6-27B ou Llama 3.3-70B est devenu un workflow standard, avec des résultats de qualité comparable à ceux obtenus sur des serveurs GPU bien plus chers.
Clusters DGX Spark : quand un seul ne suffit plus
La DGX Spark peut être mise en cluster pour exécuter des modèles trop gros pour une seule machine, ou pour augmenter le débit. NVIDIA a officialisé le support de clusters jusqu’à 8 machines via NVLink-C2C et Ethernet 10GbE (1,25 Go/s de throughput théorique), bien que l’annonce initiale mentionnait 100 GbE. En pratique, les utilisateurs montent des clusters de 2 à 4 Spark avec des résultats impressionnants.
Le cas le plus documenté est celui de DeepSeek V4 Flash 0731 sur 2× DGX Spark. Selon les tests de flowtivity.ai et les posts du forum NVIDIA, la configuration par défaut atteint 30 tok/s, mais une optimisation du cache KV et du scheduling permet de monter à 40-50 tok/s. Le post « Agent Serving on 2× DGX Spark with DeepSeek V4 Flash 0731 » détaille les findings sur le KV-cache, le scheduling et l’UMA (Unified Memory Architecture), avec des corrections importantes sur les mesures de decode-share.
Pour les modèles MoE massifs comme DeepSeek V3/R1 (671B), un cluster de 4 à 8 Spark permet de les charger en NVFP4 (environ 350 Go) et d’obtenir des débits utilisables pour de l’agentique. Les utilisateurs de Spark Arena rapportent que la configuration de clusters est simplifiée par les outils NVIDIA (NCCL, TensorRT-LLM avec parallélisme tensoriel), mais qu’il faut être attentif à la bande passante réseau : le 10GbE est le facteur limitant pour les modèles qui nécessitent beaucoup de communication entre les nœuds.
PAIR, PC Spark et RTX Spark : l’écosystème s’élargit
Le 3 septembre 2026, NVIDIA a officialisé PAIR (Personal AI Runtime), un outil pour orchestrer l’IA locale sur ses machines, et une gamme de PC « Spark » pré-construits qui arriveront en octobre. PAIR simplifie le déploiement des agents IA locaux, la gestion des modèles et le fine-tuning, avec une interface unifiée pour TensorRT-LLM, vLLM et llama.cpp. Les PC Spark, eux, matérialisent la promesse d’une IA locale accessible au plus grand nombre, avec des configurations pré-validées par NVIDIA.
Parallèlement, l’écosystème Windows s’ouvre à la puce RTX Spark (variante mobile du GB10). ASUS et MSI lanceront leurs PC portables RTX Spark dès cet automne, avant Acer et Gigabyte (dont les mini-PC arriveront début 2027). Microsoft a présenté à sa conférence Build le Surface Laptop Ultra (écran 15" mini-LED 2000 nits, puce RTX Spark) et le Surface RTX Spark Dev Box, un mini-PC au boîtier en aluminium imprimé en 3D avec 1000 orifices d’aération et une enveloppe thermique de 100 W. NVIDIA a aussi publié la première version préliminaire de CUDA 13.4 pour Windows sur Arm, native à Arm64, permettant aux développeurs de préparer leurs applications pour RTX Spark.
Cette expansion ne fait pas que concurrencer la DGX Spark : elle renforce l’écosystème logiciel (CUDA, TensorRT-LLM, llama.cpp) qui profite à toutes les machines de la famille. La DGX Spark reste la référence pour les développeurs et les chercheurs, mais les PC Spark et RTX Spark élargissent le marché de l’IA locale à de nouveaux publics.
Sources
- NVIDIA DGX Spark Software Updates – July 2026 Release
- New Software and Model Optimizations Supercharge NVIDIA DGX Spark
- Spark Arena – Leaderboard communautaire
- DeepSeek V4 Flash 0731 on Dual DGX Spark – flowtivity.ai
- Agent Serving on 2× DGX Spark with DeepSeek V4 Flash 0731 – forums.developer.nvidia.com
- 1x Spark: DeepSeek-V4-Flash-0731 @ 1,000 tok/s prefill – forums.developer.nvidia.com
- Ant Ling-3.0-Flash 124B-A5B – forums.developer.nvidia.com
- Laguna S 2.1 – Poolside
- Fine-tuning – bidual/awesome-dgx-spark – DeepWiki
- emiluzelac/deepseek-v4-flash-0731-on-one-dgx-spark – DeepWiki
- NVIDIA PAIR et les PC Spark – article du magazine
- DGX Spark et LLM open-source en septembre 2026 – article du magazine
- Muse Spark, quatre mois après – article du magazine
- LLM open-source sur NVIDIA DGX Spark en septembre 2026 – article du magazine
- DGX Spark en septembre 2026 – article du magazine
- Microsoft Surface Laptop Ultra et Surface RTX Spark Dev Box – branchez-vous.com
- NVIDIA RTX Spark : ASUS et MSI – clubic.com
- Asus et MSI dans les starting-blocks – lesnumeriques.com
- NVIDIA frappe fort : les premiers PC RTX Spark – tomshardware.fr
- NVIDIA lance le premier kit de développement CUDA 13.4 Windows Arm – mundowin.com
- Acer mini-PC IA pour défier le DGX Spark – msn.com
Article recherché et rédigé automatiquement · Magazine Electrosens