
 Magazine LLM Opensource · 13 October 2026
vLLM, SGLang, TensorRT-LLM : le match des serveurs d’inférence open source en 2026
Choisir son serveur d’inférence, c’est aujourd’hui décider si l’on divise sa facture GPU par deux ou si l’on condamne ses utilisateurs à une latence de chatbot à la ramasse. En cette fin 2026, trois moteurs dominent le paysage open source — vLLM, SGLang et TensorRT-LLM — et leurs philosophies s’opposent autant que leurs benchmarks. Mais le terrain de jeu s’élargit : TGI est entré en maintenance, Modular MAX et TokenSpeed frappent à la porte, SGLang s’est mué en startup commerciale sous le nom de RadixArk, et les modèles chinois comme Qwen3.8-Max, GLM-5.3, Hy4 ou DeepSeek V4 Pro redéfinissent les workloads — sans oublier le retour fracassant de Mistral avec « Le Chonk » et l’arrivée de Beam chez Reflection AI. Plongée dans un duel où la mémoire paginée, les arbres radix et les moteurs compilés font la pluie et le beau temps.
2026 : L’inférence open source a cessé d’être un goulot d’étranglement
Il y a trois ans, servir un LLM open source à grande échelle relevait de l’exploit technique : il fallait bricoler des scripts de batching, gérer manuellement la mémoire GPU, et accepter des taux d’occupation désastreux. Cette époque est révolue. En 2026, l’inférence open source est devenue un marché mature, structuré autour de trois serveurs de référence — vLLM, SGLang et TensorRT-LLM — qui se livrent une guerre feutrée mais intense.
L’enjeu n’a jamais été aussi stratégique. L’explosion des modèles Mixture-of-Experts (MoE) comme DeepSeek V4 (1,6 trillion de paramètres, 49 milliards actifs), GLM-5.3 (743 milliards de paramètres, sorti le 14 août 2026), Qwen3.8-Max (2,4 trillions de paramètres, dévoilé le 3 août 2026) ou encore Hy4 de Tencent (770 milliards, 49 milliards actifs, ouvert le 28 août 2026), l’essor des agents multi-tours qui enchaînent les appels API, et la flambée des coûts de calcul GPU ont transformé le choix du serveur d’inférence en décision financière majeure. Un serveur mal calibré peut doubler la facture GPU d’une entreprise ; un serveur bien choisi peut tripler la latence perçue par les utilisateurs finaux. Les chiffres parlent d’eux-mêmes : sur un benchmark tiers réalisé par Spheron sur H100 80GB avec Llama 3.3 70B en FP8, le débit varie de 1 850 à 2 100 tokens par seconde selon le moteur — un écart de 13 % qui, à l’échelle d’un cluster de production, représente des centaines de milliers d’euros par an.
Mais les performances brutes ne font pas tout. Derrière ces trois noms se cachent trois visions radicalement différentes de ce que doit être un serveur d’inférence : un projet académique devenu industriel, un laboratoire d’innovations algorithmiques transformé en startup, et un outil taillé pour le hardware NVIDIA. Comprendre ces ADN, c’est comprendre pourquoi tel moteur brillera sur un workload d’agents RAG là où un autre excellera sur un modèle dense en production.
Le paysage s’est toutefois enrichi. Hugging Face a placé TGI en mode maintenance en décembre 2025, orientant officiellement les nouveaux déploiements vers vLLM ou SGLang — les propres Inference Endpoints de Hugging Face utilisent désormais vLLM par défaut, avec SGLang en alternative. Et de nouveaux venus bousculent le trio : Modular MAX, avec ses kernels Mojo compilés par graphe, et TokenSpeed, qui revendique un avantage de 9 % en latence et 11 % en débit sur B200 pour les workloads de codage agentique. L’écosystème n’a jamais été aussi dynamique — et jamais aussi multipolaire, entre une déferlante de modèles open-weights chinois, le retour de Mistral en Europe et l’émergence d’acteurs américains comme Reflection AI.
Trois philosophies, trois ADN : Berkeley, Stanford et le géant vert
Les origines des trois projets racontent déjà beaucoup de leur trajectoire. vLLM est né à UC Berkeley, dans le laboratoire Sky Computing ; SGLang a émergé du Sky Computing Lab de Berkeley, porté par l’équipe LMSYS.org ; TensorRT-LLM est un produit NVIDIA, conçu par et pour le géant vert. La filiation de SGLang est désormais bien documentée par les sources primaires du projet ; celle de vLLM et de TensorRT-LLM relève davantage de la doxa communautaire, que les trajectoires observables confirment largement.
Cette généalogie explique les priorités de développement. vLLM, avec son ADN académique, a toujours privilégié la flexibilité et la largeur du support matériel : multi-GPU, AMD, Intel, AWS Trainium, TPU, CPU, et une intégration poussée avec l’écosystème Python. C’est le couteau suisse de l’inférence, celui qu’on installe en cinq minutes et qui fonctionne partout. Sa communauté est la plus large du segment — plus de 17 000 étoiles GitHub — et son chemin vers la production est éprouvé sur AWS, GCP et Azure.
SGLang, porté par une culture de recherche plus algorithmique, a misé sur l’innovation de pointe : son arbre radix pour la réutilisation des préfixes, l’expert parallelism pour les modèles MoE, et une attention constante aux workloads émergents comme les agents. Mais l’année 2026 a marqué un tournant : en janvier, le projet est devenu RadixArk, une startup commerciale valorisée à environ 400 millions de dollars lors d’un tour mené par Accel, avec un investissement providentiel de Lip-Bu Tan, PDG d’Intel. Le cofondateur et PDG Ying Sheng a précédemment travaillé comme chercheur scientifique chez xAI. Cette mutation ne change pas la licence (Apache 2.0) ni l’ouverture du code, mais elle change la donne stratégique : SGLang est désormais poussé par une entreprise qui a intérêt à sa diffusion massive. Le projet tourne sur plus de 400 000 GPU dans le monde et génère des billions de tokens quotidiennement, avec des utilisateurs de production notables incluant xAI (comme moteur LLM par défaut), AMD, NVIDIA, LinkedIn et Cursor.
TensorRT-LLM, enfin, incarne la philosophie industrielle de NVIDIA : performance brute maximale sur son propre hardware, au prix d’un verrouillage assumé et d’une complexité opérationnelle non négligeable.
Ces différences se lisent dans les versions stables de 2026 : vLLM 0.23.0, SGLang 0.5.13, TensorRT-LLM 1.2.1. Des rythmes de release différents, des communautés différentes, des priorités différentes. vLLM et SGLang publient fréquemment, portés par des centaines de contributeurs académiques et industriels ; TensorRT-LLM suit le calendrier NVIDIA, plus lent mais plus lourd en optimisations kernels.
PagedAttention vs RadixAttention vs moteur compilé : la guerre des mémoires
Le cœur du match se joue dans la gestion du cache KV — cette mémoire qui stocke les états intermédiaires des tokens déjà générés et qui conditionne à la fois la vitesse et la capacité de traitement. Les trois moteurs ont fait des choix architecturaux fondamentalement différents.
vLLM a popularisé PagedAttention : le cache KV est découpé en pages de taille fixe, gérées comme la mémoire virtuelle d’un système d’exploitation. Cette approche minimise la fragmentation GPU et permet un batching compact — c’est ce qui a fait le succès initial de vLLM, avec des gains spectaculaires par rapport aux approches naïves. SGLang a poussé le concept plus loin avec RadixAttention : le cache KV est stocké dans une structure d’arbre radix, permettant la réutilisation automatique et granulaire des préfixes partagés. Concrètement, si deux requêtes partagent un même préfixe (un prompt système, un contexte RAG, un historique de conversation), le second appel peut réutiliser le calcul déjà effectué, réduisant le TTFT à presque zéro pour ces préfixes. C’est un avantage décisif pour les workloads agents et RAG, où les préfixes sont longs et répétés.
TensorRT-LLM, lui, ne s’embarrasse pas de structures de données exotiques : il compile le graphe de calcul en un moteur optimisé au niveau des kernels, spécifiquement pour le matériel NVIDIA (Blackwell, GB200, GB300). Cette compilation permet des optimisations agressives mais impose une étape de build à chaque changement de modèle — nous y reviendrons.
Il faut toutefois nuancer la guerre des architectures : en 2026, les trois moteurs convergent. Tous implémentent le continuous batching, le KV cache paginé et la quantification FP8. Le préfixe caching, autrefois exclusivité de SGLang, est désormais disponible partout — vLLM utilise un hash basé sur les blocs, SGLang un arbre radix au niveau token. Mais les implémentations restent différentes dans le détail, et ces différences se traduisent par des écarts de performance mesurables. SGLang conserve un avantage net sur les sorties structurées : son backend xgrammar offre un décodage JSON jusqu’à 10 fois plus rapide que les alternatives, un atout majeur pour les pipelines agents qui exigent des réponses au format strict.
Chiffres à l’appui : 1 850, 1 920, 2 100 tok/s sur H100
Passons aux chiffres. Le benchmark le plus cité en 2026 est celui de Spheron, réalisé sur H100 80GB avec Llama 3.3 70B en FP8. Les résultats, pour 50 requêtes concurrentes, donnent un débit de 1 850 tokens/s pour vLLM, 1 920 pour SGLang et 2 100 pour TensorRT-LLM. Sur le TTFT (time to first token) en p50 avec 10 requêtes, TensorRT-LLM prend l’avantage avec 105 ms, contre 112 ms pour SGLang et 120 ms pour vLLM.
| Métrique (H100 80GB, Llama 3.3 70B FP8) | vLLM 0.23.0 | SGLang 0.5.13 | TensorRT-LLM 1.2.1 |
|---|---|---|---|
| Throughput (50 requêtes, tok/s) | 1 850 | 1 920 | 2 100 |
| TTFT p50 (10 requêtes, ms) | 120 | 112 | 105 |
| Cold start (temps de chargement) | ~62 s | ~58 s | ~28 min |
Ces chiffres confirment une hiérarchie que plusieurs sources indépendantes corroborent qualitativement. TensorRT-LLM est le plus rapide sur les modèles denses, avec des gains annoncés de 20 à 40 % de latence par token à batch size 1 par rapport à vLLM — un avantage crucial pour les workloads interactifs. SGLang se positionne en deuxième, avec un avantage net sur les workloads à préfixes partagés. vLLM, enfin, reste compétitif tout en offrant la meilleure flexibilité.
Mais attention aux biais. Le benchmark Spheron émane d’un fournisseur de GPU cloud, ce qui crée un conflit d’intérêts potentiel. Les allégations de 20-40 % de gain pour TensorRT-LLM proviennent d’un blog technique sans méthodologie détaillée. Et les chiffres absolus ne sont répliqués par aucune seconde source indépendante. Prenons-les donc comme des ordres de grandeur, pas comme des vérités gravées dans le marbre. Un point méthodologique crucial : les benchmarks synthétiques surestiment systématiquement les performances réelles. Les sources convergent sur une dégradation de 30 à 50 % sous trafic de production réel par rapport aux chiffres de laboratoire.
Sur des modèles plus petits, l’écart se creuse en faveur de SGLang. Un benchmark comparatif vLLM vs SGLang sur Llama 3.1 8B en H100 donne environ 12 500 tok/s pour vLLM contre 16 200 tok/s pour SGLang — soit un avantage de près de 30 % pour le moteur de RadixArk sur les petits modèles à fort débit. Un chiffre à manier avec prudence, là encore, mais qui confirme la tendance : SGLang excelle quand le goulot d’étranglement est le scheduling, pas la mémoire.
Un retour d’expérience communautaire, rapporté par GPUInsights début 2026, illustre bien la réalité du terrain : une entreprise a migré son chatbot de production de vLLM vers TensorRT-LLM et a gagné environ 13 % de tokens par seconde. Mais elle a dû payer 28 minutes de compilation du moteur à chaque mise à jour de modèle. Un gain de performance réel, un coût opérationnel concret.
Le test du MoE : pourquoi DeepSeek V4, GLM-5.3, Qwen3.8-Max et Hy4 changent la donne
Les benchmarks sur modèles denses ne racontent qu’une partie de l’histoire. En 2026, les modèles Mixture-of-Experts représentent une part croissante des workloads de production. DeepSeek V4 (1,6T de paramètres, 49B actifs), GLM-5.3 (743B MoE, sorti le 14 août 2026), Qwen3.8-Max (2,4T, dévoilé le 3 août 2026), Hy4 de Tencent (770B, 49B actifs, ouvert le 28 août 2026) et Kimi K3 se disputent le sommet des classements. Or, ces modèles changent la donne.
Les MoE ont une particularité : à chaque token, seuls quelques experts sont activés. Cela réduit le coût de calcul par token, mais complexifie le routage et la gestion de la mémoire. SGLang est souvent cité comme le meilleur choix pour ces modèles, grâce à RadixAttention et à son support avancé de l’expert parallelism — une technique qui répartit les experts sur plusieurs GPU pour équilibrer la charge. vLLM a également investi massivement dans le support MoE, avec des optimisations de kernels dédiées et une gestion fine du routage. TensorRT-LLM, de son côté, propose des kernels MoE compilés spécifiquement pour Blackwell, avec des gains de performance significatifs mais une flexibilité moindre.
La conséquence pratique est simple : si vous servez un MoE en production, le choix du moteur peut faire varier votre débit d’un facteur deux. Et avec l’arrivée de modèles toujours plus gros — Qwen3.8-Max à 2,4 trillions de paramètres, Mistral Large 4 à 1 000 milliards dont 49 milliards activés — la pression sur les serveurs d’inférence ne fait que croître.
L’onde de choc des modèles open-weights de l’automne 2026
Le choix du serveur d’inférence ne se fait pas dans le vide : il dépend des modèles qu’on veut servir. Et l’automne 2026 a été particulièrement riche en annonces.
Le 5 octobre, Reflection AI a dévoilé Beam, son premier modèle à poids ouverts : un système MoE sparse de 501 milliards de paramètres totaux et 23 milliards actifs, taillé pour le code, le raisonnement et les usages agentiques. Le pitch de Reflection est intéressant : le modèle revendique des performances proches des meilleurs modèles chinois sur le code, mais avec un coût d’inférence 3 à 4 fois inférieur. Les poids sont attendus plus tard dans le mois. Pour les serveurs d’inférence, c’est un cas d’usage idéal : un MoE de taille moyenne, optimisé pour le compute, qui devrait bien passer sur vLLM comme sur SGLang.
Le 6 octobre, Mistral AI a frappé fort avec Mistral Large 4, surnommé « Le Chonk » — un modèle multimodal à plus de 1 000 milliards de paramètres, dont 49 milliards activés par réponse. Entièrement entraîné en Europe, il est présenté comme le meilleur modèle à poids ouverts hors de Chine, avec des performances mises en avant en cybersécurité, en analyse géospatiale et sur les tâches agentiques. L’aperçu public a été ouvert le 6 octobre, avec des poids prévus le 27 octobre et une disponibilité sur Hugging Face dans la foulée. C’est un signal fort pour l’écosystème européen — et un nouveau workload de choix pour les serveurs d’inférence, qui devront gérer un MoE de 1 000 milliards de paramètres avec seulement 49 milliards actifs.
Le 3 octobre, Cloudflare a créé la surprise avec Clef, une famille de modèles de décision ouverts sous Apache 2.0 : Clef 27B et Clef-flash 9B. Particularité : Clef ne rédige pas de prose, il renvoie une distribution de probabilités typée sur vos propres options, en 38,8 ms selon les mesures de Cloudflare — contre 524 ms revendiquées pour Jev, soit un facteur 13. Le modèle ne facture que l’entrée. C’est un changement de paradigme pour les pipelines agents : au lieu de demander à un LLM de « choisir », on lui demande de scorer des options. Un cas d’usage qui pourrait redéfinir certaines architectures RAG et de routage.
Ces trois annonces — Beam, Le Chonk, Clef — dessinent une tendance claire : la spécialisation. Plutôt que de courir après le plus gros modèle généraliste, les acteurs misent sur des architectures adaptées à des tâches précises, avec des coûts d’inférence maîtrisés. Et cela a des conséquences directes sur le choix du serveur : un modèle de décision de 9 milliards de paramètres ne se sert pas comme un MoE de 1 000 milliards.
TGI en maintenance, MAX et TokenSpeed à l’assaut : le reste du paysage
Le trio de tête ne doit pas masquer le reste de l’écosystème. Hugging Face a officiellement placé TGI (Text Generation Inference) en mode maintenance en décembre 2025. Le message est clair : les nouveaux déploiements doivent se tourner vers vLLM ou SGLang. Les Inference Endpoints de Hugging Face utilisent désormais vLLM par défaut, avec SGLang en alternative. TGI reste utilisé en production chez ceux qui l’ont adopté, mais il ne bénéficiera plus des innovations récentes.
Modular MAX est probablement le concurrent le plus intéressant. Sa philosophie : compiler des graphes de calcul via des kernels écrits en Mojo, le langage de Modular. L’objectif est de combiner la performance des moteurs compilés avec la portabilité — MAX supporte NVIDIA, AMD et Apple Silicon. Pour les équipes qui veulent éviter le verrouillage NVIDIA sans sacrifier la performance, c’est une piste sérieuse. La contrepartie : un écosystème plus jeune, moins de modèles supportés nativement, et une courbe d’apprentissage liée à Mojo.
TokenSpeed revendique un avantage de 9 % en latence et 11 % en débit sur B200 pour les workloads de codage agentique. Des chiffres à prendre avec les précautions d’usage — ils proviennent du projet lui-même — mais qui témoignent de la vitalité de l’écosystème. TokenSpeed cible explicitement les agents de code, un segment en forte croissance.
Enfin, il faut mentionner l’écosystème d’outils qui gravite autour de ces moteurs. LM Studio a lancé Bionic le 16 juillet 2026, une application agent autonome qui s’appuie sur llama.cpp et MLX pour l’inférence locale. Ollama, llama.cpp, MLX et DSpark constituent la boîte à outils du déploiement local, complémentaire des serveurs d’inférence de datacenter. Et côté orchestration, Kubernetes, DRA (Dynamic Resource Allocation) et llm-d transforment la gestion des clusters GPU : la désagrégation préfill/decode, en particulier, est présentée comme la vraie rupture de 2026 pour l’inférence à grande échelle.
Ce que cela change pour les praticiens
Comment choisir, concrètement ? Voici une grille de décision fondée sur les sources disponibles.
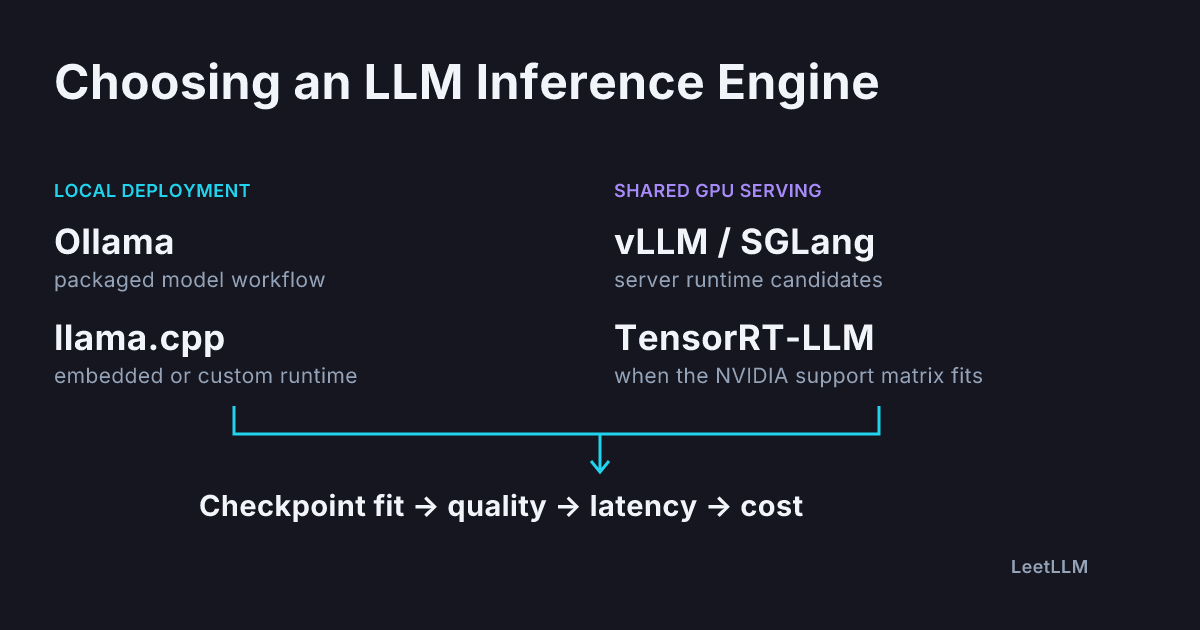
Choisissez vLLM si : vous voulez la plus large compatibilité matérielle (NVIDIA, AMD, Intel, Trainium, TPU, CPU), la plus grande communauté, et un déploiement rapide sans surprise. C’est le choix par défaut pour la plupart des équipes, et il reste compétitif sur tous les workloads. Son support MoE s’est considérablement amélioré en 2026.
Choisissez SGLang si : vous servez des workloads à préfixes partagés (RAG, agents multi-tours, chatbots avec longs system prompts), des modèles MoE, ou si vous avez besoin de sorties structurées JSON à haute performance. RadixAttention et xgrammar sont des avantages réels et mesurables. La commercialisation via RadixArk garantit un développement soutenu, mais introduit une dynamique d’entreprise à surveiller.
Choisissez TensorRT-LLM si : vous êtes sur du hardware NVIDIA récent (Blackwell, GB200, GB300), que vous servez des modèles denses, et que vous pouvez absorber 28 minutes de compilation à chaque changement de modèle. Le gain de performance est réel, mais le coût opérationnel aussi.
Regardez MAX si : vous voulez éviter le verrouillage NVIDIA tout en visant la performance des moteurs compilés. Regardez TokenSpeed si : vous servez des agents de code sur B200. Regardez Clef si : vous avez besoin de modèles de décision rapides et pas chers pour vos pipelines.
Un dernier conseil : ne vous fiez pas aux benchmarks synthétiques. Les sources convergent sur une dégradation de 30 à 50 % en production réelle. Testez sur votre workload, avec vos modèles, sur votre hardware. C’est la seule mesure qui compte.
Sources
- Comparaison des moteurs d’inférence LLM open-source : SGLang, vLLM, MAX et BentoML 2026 — Fish Audio
- Best LLM Inference Engines (2026): vLLM, SGLang & TensorRT-LLM — Yotta Labs
- Reflection AI Unveils Beam, a 501B-Parameter Open-Weight Model — Unite.AI
- Reflection debuts Beam, an open-weight AI model to rival Chinese models at lower compute cost — TechCrunch
- Nvidia-backed Reflection unveils Beam, its first open-weight model — The Next Web
- Reflection’s Beam trails top open models on coding tests but claims lower inference compute — Help Net Security
- Mistral dévoile Large 4, un modèle à plus de 1 000 milliards de paramètres — Le Monde Informatique
- Mistral Large 4, le modèle à 1 000 milliards de paramètres surnommé Le Chonk — Korben
- Mistral Says Its New AI Model ‘Le Chonk’ Is the Best Open-Weight Offering Outside of China — Wired
- Sortie de Mistral Large 4 : aperçu API et poids — NeoTeo
- Cloudflare Clef: открытый ответ Jev в 13 раз быстрее — ai-stat.ru
- Clef-Flash vs Qwen3-8B : Probabilités vs prose — OrcaRouter
- Kubernetes, DRA et llm-d : l’infrastructure LLM-native passe à l’échelle en 2026 — Magazine
- Bionic de LM Studio : l’agent local à l’épreuve de l’écosystème open source d’octobre 2026 — Magazine
- LLM open source en octobre 2026 : Mistral Large 4, Beam, Clef — le grand basculement vers l’open-weights — Magazine
- Kimi K3 vs DeepSeek V4 Pro : le duel des open weights qui redéfinit le haut de gamme — Magazine
Article recherché et rédigé automatiquement · Magazine Electrosens