
 Magazine LLM Opensource · 16 September 2026
Moteurs d’inférence LLM open source en 2026 : vLLM, SGLang, TensorRT-LLM — le duel qui décide de votre facture GPU
Choisir son serveur d’inférence, c’est aujourd’hui décider si l’on divise sa facture GPU par deux ou si l’on condamne ses utilisateurs à une latence de chatbot à la ramasse. En cette fin 2026, trois moteurs dominent le paysage open source — vLLM, SGLang et TensorRT-LLM — et leurs philosophies s’opposent autant que leurs benchmarks. Mais le terrain de jeu s’élargit : TGI est entré en maintenance, Modular MAX et TokenSpeed frappent à la porte, SGLang s’est mué en startup commerciale, et les modèles chinois comme Qwen3.8-Max, GLM-5.3, Hy4 ou DeepSeek V4 Pro redéfinissent les workloads. Plongée dans un duel où la mémoire paginée, les arbres radix et les moteurs compilés font la pluie et le beau temps.
2026 : L’inférence open source a cessé d’être un goulot d’étranglement
Il y a trois ans, servir un LLM open source à grande échelle relevait de l’exploit technique : il fallait bricoler des scripts de batching, gérer manuellement la mémoire GPU, et accepter des taux d’occupation désastreux. Cette époque est révolue. En 2026, l’inférence open source est devenue un marché mature, structuré autour de trois serveurs de référence — vLLM, SGLang et TensorRT-LLM — qui se livrent une guerre feutrée mais intense.
L’enjeu n’a jamais été aussi stratégique. L’explosion des modèles Mixture-of-Experts (MoE) comme DeepSeek V4 (1,6 trillion de paramètres, 49 milliards actifs), GLM-5.3 (743 milliards de paramètres, sorti le 14 août 2026), Qwen3.8-Max (2,4 trillions de paramètres) ou encore Hy4 de Tencent (770 milliards, 49 milliards actifs, ouvert le 28 août 2026), l’essor des agents multi-tours qui enchaînent les appels API, et la flambée des coûts de calcul GPU ont transformé le choix du serveur d’inférence en décision financière majeure. Un serveur mal calibré peut doubler la facture GPU d’une entreprise ; un serveur bien choisi peut tripler la latence perçue par les utilisateurs finaux. Les chiffres parlent d’eux-mêmes : sur un benchmark tiers réalisé par Spheron sur H100 80GB avec Llama 3.3 70B en FP8, le débit varie de 1 850 à 2 100 tokens par seconde selon le moteur — un écart de 13 % qui, à l’échelle d’un cluster de production, représente des centaines de milliers d’euros par an.
Mais les performances brutes ne font pas tout. Derrière ces trois noms se cachent trois visions radicalement différentes de ce que doit être un serveur d’inférence : un projet académique devenu industriel, un laboratoire d’innovations algorithmiques transformé en startup, et un outil taillé pour le hardware NVIDIA. Comprendre ces ADN, c’est comprendre pourquoi tel moteur brillera sur un workload d’agents RAG là où un autre excellera sur un modèle dense en production.
Le paysage s’est toutefois enrichi. Hugging Face a placé TGI en mode maintenance en décembre 2025, orientant officiellement les nouveaux déploiements vers vLLM ou SGLang — les propres Inference Endpoints de Hugging Face utilisent désormais vLLM par défaut, avec SGLang en alternative. Et de nouveaux venus bousculent le trio : Modular MAX, avec ses kernels Mojo compilés par graphe, et TokenSpeed, qui revendique un avantage de 9 % en latence et 11 % en débit sur B200 pour les workloads de codage agentique. L’écosystème n’a jamais été aussi dynamique — et jamais aussi chinois, avec une déferlante de modèles open-weights venus de l’Empire du Milieu qui redessine la carte des benchmarks.
Trois philosophies, trois ADN : Berkeley, Stanford et le géant vert
Les origines des trois projets racontent déjà beaucoup de leur trajectoire. vLLM est né à UC Berkeley, dans le laboratoire Sky Computing ; SGLang a émergé de Berkeley et de Stanford, avec une forte coloration recherche ; TensorRT-LLM est un produit NVIDIA, conçu par et pour le géant vert. Précisons d’emblée : les sources dont nous disposons ne documentent pas formellement ces filiations, ni les financements associés. Mais la doxa communautaire est unanime, et les trajectoires observables confirment largement ces racines.
Cette généalogie explique les priorités de développement. vLLM, avec son ADN académique, a toujours privilégié la flexibilité et la largeur du support matériel : multi-GPU, AMD, Intel, AWS Trainium, TPU, CPU, et une intégration poussée avec l’écosystème Python. C’est le couteau suisse de l’inférence, celui qu’on installe en cinq minutes et qui fonctionne partout. Sa communauté est la plus large du segment — plus de 17 000 étoiles GitHub — et son chemin vers la production est éprouvé sur AWS, GCP et Azure.
SGLang, porté par une culture de recherche plus algorithmique, a misé sur l’innovation de pointe : son arbre radix pour la réutilisation des préfixes, l’expert parallelism pour les modèles MoE, et une attention constante aux workloads émergents comme les agents. Mais l’année 2026 a marqué un tournant : en janvier, le projet est devenu RadixArk, une startup commerciale valorisée à environ 400 millions de dollars lors d’un tour mené par Accel, avec un investissement providentiel de Lip-Bu Tan, PDG d’Intel. Le cofondateur et PDG Ying Sheng a précédemment travaillé comme chercheur scientifique chez xAI. Cette mutation ne change pas la licence (Apache 2.0) ni l’ouverture du code, mais elle change la donne stratégique : SGLang est désormais poussé par une entreprise qui a intérêt à sa diffusion massive. Le projet tourne sur plus de 400 000 GPU dans le monde et génère des billions de tokens quotidiennement, avec des utilisateurs de production notables incluant xAI (comme moteur LLM par défaut), AMD, NVIDIA, LinkedIn et Cursor.
TensorRT-LLM, enfin, incarne la philosophie industrielle de NVIDIA : performance brute maximale sur son propre hardware, au prix d’un verrouillage assumé et d’une complexité opérationnelle non négligeable.
Ces différences se lisent dans les versions stables de juin 2026 : vLLM 0.23.0, SGLang 0.5.13, TensorRT-LLM 1.2.1. Des rythmes de release différents, des communautés différentes, des priorités différentes. vLLM et SGLang publient fréquemment, portés par des centaines de contributeurs académiques et industriels ; TensorRT-LLM suit le calendrier NVIDIA, plus lent mais plus lourd en optimisations kernels.
PagedAttention vs RadixAttention vs moteur compilé : la guerre des mémoires
Le cœur du match se joue dans la gestion du cache KV — cette mémoire qui stocke les états intermédiaires des tokens déjà générés et qui conditionne à la fois la vitesse et la capacité de traitement. Les trois moteurs ont fait des choix architecturaux fondamentalement différents.
vLLM a popularisé PagedAttention : le cache KV est découpé en pages de taille fixe, gérées comme la mémoire virtuelle d’un système d’exploitation. Cette approche minimise la fragmentation GPU et permet un batching compact — c’est ce qui a fait le succès initial de vLLM, avec des gains spectaculaires par rapport aux approches naïves. SGLang a poussé le concept plus loin avec RadixAttention : le cache KV est stocké dans une structure d’arbre radix, permettant la réutilisation automatique des préfixes partagés. Concrètement, si deux requêtes partagent un même préfixe (un prompt système, un contexte RAG, un historique de conversation), le second appel peut réutiliser le calcul déjà effectué, réduisant le TTFT à presque zéro pour ces préfixes. C’est un avantage décisif pour les workloads agents et RAG, où les préfixes sont longs et répétés.
TensorRT-LLM, lui, ne s’embarrasse pas de structures de données exotiques : il compile le graphe de calcul en un moteur optimisé au niveau des kernels, spécifiquement pour le matériel NVIDIA (Blackwell, GB200, GB300). Cette compilation permet des optimisations agressives mais impose une étape de build à chaque changement de modèle — nous y reviendrons.
Il faut toutefois nuancer la guerre des architectures : en 2026, les trois moteurs convergent. Tous implémentent le continuous batching, le KV cache paginé et la quantification FP8. Le préfixe caching, autrefois exclusivité de SGLang, est désormais disponible partout — vLLM utilise un hash basé sur les blocs, SGLang un arbre radix au niveau token. Mais les implémentations restent différentes dans le détail, et ces différences se traduisent par des écarts de performance mesurables. SGLang conserve un avantage net sur les sorties structurées : son backend xgrammar offre un décodage JSON jusqu’à 10 fois plus rapide que les alternatives, un atout majeur pour les pipelines agents qui exigent des réponses au format strict.
Chiffres à l’appui : 1 850, 1 920, 2 100 tok/s sur H100
Passons aux chiffres. Le benchmark le plus cité en 2026 est celui de Spheron, réalisé sur H100 80GB avec Llama 3.3 70B en FP8. Les résultats, pour 50 requêtes concurrentes, donnent un débit de 1 850 tokens/s pour vLLM, 1 920 pour SGLang et 2 100 pour TensorRT-LLM. Sur le TTFT (time to first token) en p50 avec 10 requêtes, TensorRT-LLM prend l’avantage avec 105 ms, contre 112 ms pour SGLang et 120 ms pour vLLM.
| Métrique (H100 80GB, Llama 3.3 70B FP8) | vLLM 0.23.0 | SGLang 0.5.13 | TensorRT-LLM 1.2.1 |
|---|---|---|---|
| Throughput (50 requêtes, tok/s) | 1 850 | 1 920 | 2 100 |
| TTFT p50 (10 requêtes, ms) | 120 | 112 | 105 |
| Cold start (temps de chargement) | ~62 s | ~58 s | ~28 min |
Ces chiffres confirment une hiérarchie que plusieurs sources indépendantes corroborent qualitativement. TensorRT-LLM est le plus rapide sur les modèles denses, avec des gains annoncés de 20 à 40 % de latence par token à batch size 1 par rapport à vLLM — un avantage crucial pour les workloads interactifs. SGLang se positionne en deuxième, avec un avantage net sur les workloads à préfixes partagés. vLLM, enfin, reste compétitif tout en offrant la meilleure flexibilité.
Mais attention aux biais. Le benchmark Spheron émane d’un fournisseur de GPU cloud, ce qui crée un conflit d’intérêts potentiel. Les allégations de 20-40 % de gain pour TensorRT-LLM proviennent d’un blog technique sans méthodologie détaillée. Et les chiffres absolus ne sont répliqués par aucune seconde source indépendante. Prenons-les donc comme des ordres de grandeur, pas comme des vérités gravées dans le marbre. Un point méthodologique crucial : les benchmarks synthétiques surestiment systématiquement les performances réelles. Les sources convergent sur une dégradation de 30 à 50 % sous trafic de production réel par rapport aux chiffres de laboratoire.
Sur des modèles plus petits, l’écart se creuse en faveur de SGLang. Un benchmark comparatif vLLM vs SGLang sur Llama 3.1 8B en H100 donne environ 12 500 tok/s pour vLLM contre 16 200 tok/s pour SGLang — soit un avantage de près de 30 % pour le moteur de RadixArk sur les petits modèles à fort débit. Un chiffre à manier avec prudence, là encore, mais qui confirme la tendance : SGLang excelle quand le goulot d’étranglement est le scheduling, pas la mémoire.
Un retour d’expérience communautaire, rapporté par GPUInsights début 2026, illustre bien la réalité du terrain : une entreprise a migré son chatbot de production de vLLM vers TensorRT-LLM et a gagné environ 13 % de tokens par seconde. Mais elle a dû payer 28 minutes de compilation du moteur à chaque mise à jour de modèle. Un gain de performance réel, un coût opérationnel concret.
Le test du MoE : pourquoi DeepSeek V4, GLM-5.3, Qwen3.8-Max et Hy4 changent la donne
Les benchmarks sur modèles denses ne racontent qu’une partie de l’histoire. En 2026, les modèles Mixture-of-Experts représentent une part croissante des workloads de production. DeepSeek V4 (1,6T de paramètres, 49B actifs), GLM-5.3 (743B MoE, sorti le 14 août 2026), Qwen3.8-Max (2,4T), Hy4 de Tencent (770B, 49B actifs, ouvert le 28 août 2026) et Kimi K3 se disputent le sommet des classements. Or, ces modèles changent la donne.
Les MoE ont une particularité : à chaque token, seuls quelques experts sont activés. Cela réduit le coût de calcul par token, mais complexifie le routage et la gestion de la mémoire. SGLang est souvent cité comme le meilleur choix pour ces modèles, grâce à RadixAttention et à son support avancé de l’expert parallelism (EP). Cette technique répartit les experts sur plusieurs GPU de manière optimisée, réduisant la communication inter-GPU et améliorant le throughput global. Les sources convergent sur ce point, même si aucune ne fournit de chiffres précis de gain pour DeepSeek V4 sur H100.
TensorRT-LLM, lui, excelle sur les modèles denses grâce à ses kernels optimisés, mais son avantage s’amenuise sur les MoE où la flexibilité du routage devient cruciale. vLLM, quant à lui, a rattrapé son retard sur le support MoE mais reste souvent un cran derrière SGLang sur ces workloads. Les versions récentes de vLLM (v0.18+) atteignent néanmoins 2 200+ tokens/sec sur H200 avec DeepSeek V3, un chiffre qui montre que l’écart se resserre.
Le TTFT pour les préfixes partagés est un autre terrain de bataille. Dans les scénarios agents ou chatbots, chaque nouvelle requête partage un long préfixe avec les requêtes précédentes (prompt système, historique, contexte RAG). RadixAttention permet à SGLang de réutiliser ces calculs, réduisant drastiquement le TTFT. Les données précises manquent — aucun benchmark public ne quantifie ce gain pour Llama-405B ou Qwen-72B — mais l’avantage qualitatif est largement documenté. Les sources rapportent des gains de throughput jusqu’à 6,4x sur les workloads à préfixes partagés pour SGLang, et la plateforme a dépassé les 400 000 GPU déployés en production.
Le cas GLM-5.3 est particulièrement instructif. Sorti le 14 août 2026, ce modèle de 743 milliards de paramètres (MoE) réutilise la base de GLM-5.2 sans aucun nouveau paramètre : tout le gain vient du post-entraînement. Z.ai a poussé Terminal-Bench 3.0 de 4,6 à 28,3 % par le seul post-entraînement, et s’impose en tête du benchmark cybersécurité CyberGym avec 84,5 %, devant Claude Sonnet 5 et GPT-5.6 Sol. Côté inférence, GLM-5.3 illustre la tendance lourde de 2026 : des modèles toujours plus gros (743B, 770B, 1,6T, 2,4T) qui exigent des moteurs capables de gérer l’expert parallelism à grande échelle — un terrain où SGLang et vLLM dominent, et où TensorRT-LLM doit batailler.
Hy4 de Tencent, ouvert le 28 août 2026, ajoute une nouvelle pièce au puzzle : 770 milliards de paramètres, 49 milliards actifs, un contexte d’un million de tokens, pensé pour le codage, la productivité bureautique et la recherche scientifique. Avec DeepSeek V4 Pro (sorti le 12 août 2026, à 0,14 $/M tokens en entrée), la guerre des prix chinoise ne ralentit pas — et elle pousse les équipes d’inférence à optimiser chaque token.
Le cauchemar de l’ops : 28 minutes de compilation et autres douleurs
Passons du laboratoire à la salle des machines. La facilité de déploiement est le grand oublié des comparatifs, et pourtant c’est elle qui fait la différence en production.
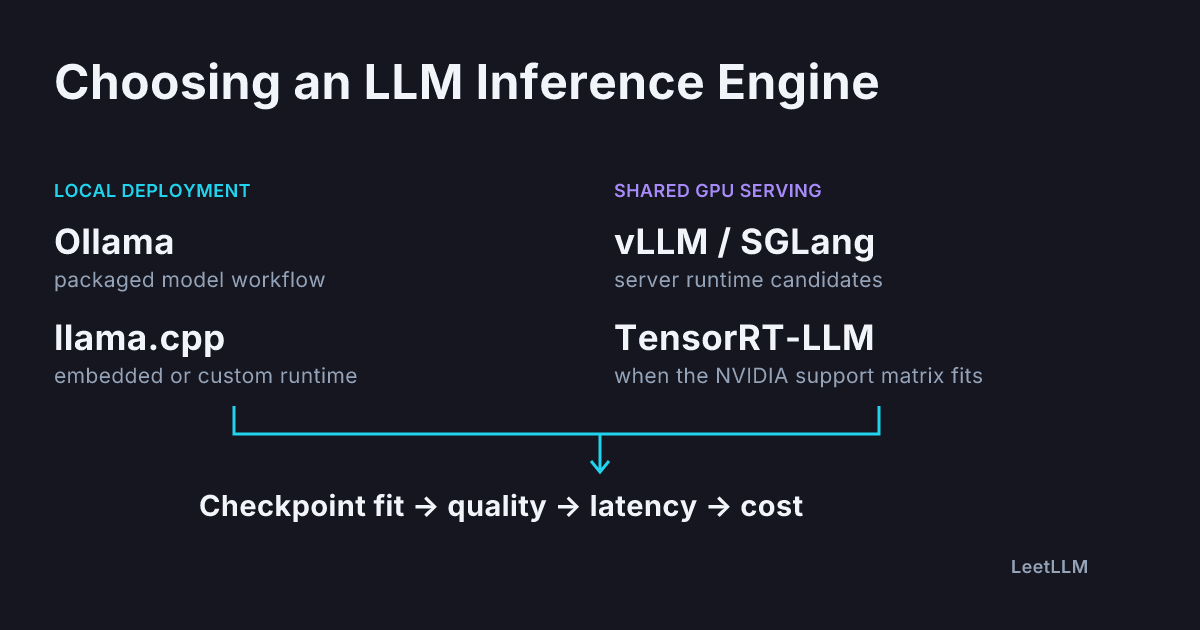
vLLM se distingue par sa simplicité : une installation pip, une configuration minimale, un support matériel étendu (multi-GPU, AMD, Intel, Trainium, TPU, CPU). C’est le choix par défaut pour les équipes qui veulent déployer rapidement sans se perdre dans des couches de configuration. Sa maturité Docker et Kubernetes est la meilleure du trio : docs matures, charts Helm, et un chemin éprouvé vers la production sur les trois grands clouds. SGLang offre une expérience similaire, avec quelques optimisations spécifiques (notamment pour les MoE) mais une courbe d’apprentissage légèrement plus raide et un écosystème plus petit — même si la création de RadixArk a accéléré la maturation des outils autour du projet.
TensorRT-LLM est un autre monde. La performance maximale exige un moteur compilé, ce qui implique une étape de build à chaque changement de modèle — les fameuses 28 minutes de compilation observées dans le retour d’expérience GPUInsights. Pour une équipe qui itère rapidement sur ses modèles, ce coût peut annihiler l’avantage de performance. TensorRT-LLM n’a par ailleurs aucun sens sans GPU NVIDIA : c’est un verrouillage matériel assumé, qui exclut AMD, les CPU et les accélérateurs alternatifs. Pour une entreprise qui veut garder la liberté de changer de fournisseur GPU, c’est un point de vigilance majeur.
Le choix d’un moteur d’inférence est donc une décision d’infrastructure qui engage l’équipe sur plusieurs mois. Quatre critères structurent le choix : le débit (pour les usages batch : résumés en masse, pipelines RAG à fort volume), la latence (pour les usages interactifs : chatbots, assistants, génération de code temps réel), la quantification supportée (GPTQ, AWQ, int8, GGUF — tous les runtimes ne supportent pas tous les formats), et le matériel disponible. TensorRT-LLM n’a aucun sens sans GPU NVIDIA ; llama.cpp reste le seul choix sérieux pour du CPU pur ; vLLM et SGLang couvrent le spectre NVIDIA/AMD/Intel.
L’écosystème en ébullition : RadixArk, Ox Alpha et la bascule chinoise
Au-delà du trio historique, l’écosystème de l’inférence open source vit une mutation profonde en cette fin 2026. Trois phénomènes méritent l’attention.
La consolidation commerciale. La transformation de SGLang en RadixArk (janvier 2026, valorisation ~400 M$, tour mené par Accel) n’est pas un cas isolé. Elle signale que l’inférence open source est devenue un marché stratégique, où les investisseurs parient sur les infrastructures. xAI utilise SGLang comme moteur LLM par défaut ; AMD, NVIDIA, LinkedIn et Cursor sont des utilisateurs de production. Le Ray Summit 2026, qui s’est tenu à San Francisco du 24 au 26 août, a d’ailleurs accueilli la première conférence vLLM en parallèle — un signe de la convergence entre l’inférence et le post-entraînement par renforcement (RL), qui devient le nouveau moteur de l’infrastructure LLM.
Le phénomène Ox Alpha. Le 20 août 2026, un modèle de raisonnement inconnu est apparu sur OpenRouter, gratuit pendant une semaine, avec une fenêtre de contexte d’un million de jetons et des performances impressionnantes en code et en raisonnement. Personne ne sait qui l’a créé — certains soupçonnent un laboratoire chinois, d’autres pointent le tokenizer qui accuserait Zhipu, Xiaomi ou Meituan. Ce « modèle fantôme » illustre une tendance lourde : la shadow AI, où des modèles open source ou furtifs deviennent des boîtes noires non maîtrisées. Pour les équipes d’inférence, c’est un rappel que le choix du moteur ne fait pas tout : la provenance et la traçabilité des modèles servis deviennent des enjeux de sécurité.
La bascule chinoise. Jamais l’open source n’a été aussi chinois. GLM-5.3 (Z.ai, 14 août), Hy4 (Tencent, 28 août), DeepSeek V4 Pro (12 août), Qwen3.8-Max (2,4T) : les modèles open-weights venus de Chine dominent les classements et cassent les prix. DeepSeek V4 Pro est proposé à 0,14 $/M tokens en entrée sur OpenRouter, loin sous Kimi K3, avec la même fenêtre de contexte d’un million de tokens. Cette guerre des prix a un impact direct sur l’inférence : elle pousse à l’optimisation maximale du coût par token, et donc à des choix de moteurs de plus en plus sophistiqués. Côté local, Meta a riposté avec Muse Glimmer (30B, Apache 2.0, sorti le 14 août), un modèle agentique multimodal conçu pour l’exécution sur appareil — un segment où l’inférence légère (llama.cpp, MLX, Ollama) reste reine.
Verdict : quel moteur pour quel workload ?
Après ce tour d’horizon, la réponse honnête est : ça dépend. Mais quelques lignes directrices se dégagent.
Choisissez vLLM si vous voulez la prise en charge matérielle la plus large, la plus grande communauté et un chemin éprouvé vers la production sur AWS, GCP et Azure. C’est le choix par défaut, le plus sûr, celui qui ne vous enfermera jamais. Sa simplicité de déploiement et sa maturité Kubernetes en font le meilleur allié des équipes sans profil MLOps dédié.
Choisissez SGLang si votre charge de travail est intensive en conversations multi-tours, en sorties structurées (JSON, décodage contraint) ou en pipelines lourds en préfixes comme le RAG — et si vous servez des modèles MoE à grande échelle. L’avantage RadixAttention sur les préfixes partagés et le backend xgrammar pour les sorties structurées en font le moteur des workloads agents. La création de RadixArk est un signal de pérennité, même si l’écosystème reste plus petit que celui de vLLM.
Choisissez TensorRT-LLM si vous êtes 100 % NVIDIA, si vos workloads sont dominés par des modèles denses en production, et si vous pouvez absorber le coût de compilation (28 minutes par changement de modèle). L’avantage de latence à batch size 1 est réel pour les usages interactifs. Mais c’est un choix d’engagement : vous épousez la roadmap NVIDIA.
Et gardez un œil sur Modular MAX et TokenSpeed, qui frappent à la porte avec des promesses de gains à deux chiffres sur B200. En 2026, l’inférence open source est devenue un marché où l’innovation ne s’arrête jamais — et où le bon choix aujourd’hui peut être obsolète dans six mois.
Sources
- Spheron — LLM Inference Optimization: vLLM vs TensorRT-LLM vs SGLang Decision Framework (2026)
- Fish Audio — Comparaison des moteurs d’inférence LLM open-source : SGLang, vLLM, MAX et BentoML 2026
- Techsy — vLLM vs SGLang 2026 : Benchmarks H100 en conditions réelles
- Tensoria — Top serveurs d’inférence LLM open-source en 2026
- The Agent Report — GLM-5.3: Z.ai Tops the Open Coding Leaderboard on Post-Training Alone
- SiliconANGLE — Z.ai debuts GLM-5.3 with long-horizon coding, cybersecurity upgrades
- Techgenyz — Hy4 preview: 770B Remarkable Open Model Launch
- Techbooky — DeepSeek V4-Pro Shows China’s AI Price War Is Not Slowing
- IT Social — Qui est derrière Ox Alpha, le modèle furtif d’OpenRouter ?
- TechTimes — Ray Summit 2026: RL Post-Training Forces Open-Source AI Infrastructure to Converge
- Context Studios — Muse Glimmer : Le modèle agentique ouvert de 30B de Meta
- HackerNoon — 7 Best Self-Hosted Inference Servers for Open Source Models Compared 2026
Article recherché et rédigé automatiquement · Magazine Electrosens