
 NVIDIA DGX Spark · 12 September 2026
DGX Spark en septembre 2026 : les LLM open-source qui tournent vraiment, du fine-tuning 8B aux clusters DeepSeek 284B
Depuis son annonce au CES 2025, le DGX Spark de NVIDIA s’est imposé comme le Graal des développeurs IA en local : un mini-PC capable de faire tourner des modèles de 70 à 120 milliards de paramètres grâce à sa mémoire unifiée de 128 Go et sa superpuce Grace Blackwell. Un an et demi plus tard, la promesse est tenue — et amplifiée. Les premiers retours d’utilisateurs avaient révélé des fragilités : saturation mémoire, instabilités, absence d’optimisations logicielles. La mise à jour de juillet 2026 a corrigé le tir, et l’écosystème a explosé depuis : DeepSeek V4 Flash 0731 (284B, 13B actifs) tourne sur un seul Spark à 1 000 tok/s en prefill, Qwen3.8-27B atteint 48 tok/s, et des clusters de 2 à 100 nœuds domptent les géants open-weight. Nous avons disséqué les mises à jour, confronté les benchmarks terrain, et comparé aux alternatives. Verdict : le DGX Spark est devenu la machine de référence pour l’IA open-source locale.
Le DGX Spark en septembre 2026 : la promesse tenue, et amplifiée
Quand NVIDIA a présenté le DGX Spark au CES 2025, la promesse était claire : un supercalculateur de bureau capable d’exécuter des modèles d’IA de pointe sans passer par le cloud. Avec 128 Go de mémoire unifiée LPDDR5x (bande passante 273 Go/s) et une performance annoncée de 1 petaFLOP en FP4, le mini-PC semblait taillé pour l’inférence et le fine-tuning de LLMs open-source. Les premiers mois ont été difficiles : saturations mémoire, latences élevées, absence de support natif pour certains modèles. Mais les choses ont bien changé.
En septembre 2026, le DGX Spark est devenu une plateforme mature. Les mises à jour successives — notamment celle de juillet 2026 — ont corrigé les défauts de jeunesse, et l’écosystème logiciel a rattrapé son retard. Surtout, une vague de modèles open-weight récents a transformé la machine en outil de production : DeepSeek V4 Flash 0731, Qwen3.8-27B, Laguna S 2.1, Ant Ling-3.0-Flash. Les benchmarks communautaires fleurissent, les clusters se multiplient, et le fine-tuning est devenu accessible à tous grâce à Unsloth et Axolotl.
Le prix, lui, est resté stable : 4 699 $ pour la version 128 Go, avec des alternatives comme l’Acer DGX environ 500 à 1 000 $ moins chères (lancement prévu début 2027). Le DGX Spark n’est plus une curiosité de laboratoire — c’est un outil de travail quotidien pour des milliers de développeurs.
La mise à jour de juillet 2026 : un correctif qui en dit long
La mise à jour de juillet 2026, publiée sur les forums développeurs NVIDIA et dans la documentation officielle, a répondu aux irritants des premiers utilisateurs sans les nommer explicitement. Le changelog évoque une « amélioration de la gestion mémoire (OOM handling) avec retour utilisateur en cas de pression mémoire », ainsi qu’une mémoire d’affichage ajustable (2 Go par défaut, 4 Go possible via BIOS). Ces correctifs, bien que techniques, trahissent une réalité : le DGX Spark, malgré sa mémoire unifiée généreuse, souffrait d’une gestion perfectible des ressources.
Les 5 modifications qui changent (vraiment) la donne
| Modification | Description | Impact concret |
|---|---|---|
| Gestion OOM améliorée | Le pilote GPU signale désormais les situations de pression mémoire et permet à l’utilisateur de libérer de la RAM en réduisant la mémoire allouée à l’affichage. | Évite les crashs intempestifs lors de l’exécution de modèles lourds ; permet de récupérer jusqu’à 2 Go supplémentaires. |
| Mémoire d’affichage ajustable | Possibilité de basculer entre 2 Go (défaut) et 4 Go via le BIOS. | Utile pour les configurations multi-écrans ; libère de la mémoire système si l’on n’utilise qu’un seul écran. |
| Cloud-init étendu | Support de DHCP, HTTP, TFTP en plus de l’USB direct ; personnalisation de l’image FastOS. | Facilite le déploiement en cluster et la configuration automatisée. |
| Correction hot-plug écrans | Résolution d’une instabilité système et d’affichage lors du branchement/débranchement d’écrans. | Améliore la fiabilité au quotidien, surtout pour les stations multi-écrans. |
| Mise à jour des versions logicielles | DGX OS 7.5.0, GPU Driver 580.159.03, CUDA 13.0.2, Kernel 6.17, UEFI 1.110.13, EC 3.5.8, USB PD 0.5.22, TPM 7.516.1, SoC 2.155.11. | Corrections de bugs et compatibilité avec les derniers frameworks (PyTorch, TensorRT). |
Depuis, NVIDIA a continué sur sa lancée. En septembre 2026, le CUDA Toolkit 13.4 est disponible en developer preview avec un support natif Arm64 pour les futures machines RTX Spark — un signe que l’écosystème s’élargit au-delà du seul DGX Spark. Les versions logicielles sont désormais alignées sur l’écosystème NVIDIA le plus récent, garantissant une meilleure compatibilité avec les bibliothèques d’IA comme PyTorch 25.09.
Mémoire unifiée sous pression : comment NVIDIA a (enfin) dompté les OOM
L’architecture mémoire unifiée du GB10 est à la fois la force et la faiblesse du DGX Spark. Avec 128 Go de LPDDR5x partagés entre CPU et GPU, elle permet de charger des modèles de 70B à 120B paramètres en FP4 ou FP8, mais elle expose aussi le système à des conflits d’allocation. Avant la mise à jour, un utilisateur pouvait voir son fine-tuning interrompu sans explication — comme l’a vécu l’auteur du blog mikihands.com lors du fine-tuning de FLUX 1-dev (12B) : 120 Go de mémoire unifiée étaient pourtant disponibles, mais des services en arrière-plan (GPT-OSS 20B allouant 32 Go, ComfyUI 16 Go) ont saturé la RAM système.
Le correctif de juillet 2026 introduit un mécanisme de retour utilisateur en cas de pression mémoire : au lieu de planter brutalement, le système signale le problème et permet de libérer de la RAM en réduisant la mémoire allouée à l’affichage (passer de 4 Go à 2 Go via le BIOS). Concrètement, cela peut récupérer 2 Go supplémentaires — de quoi faire la différence entre un modèle qui tient et un OOM.
Mais attention : ce n’est pas une baguette magique. Comme le montre le test FLUX 1-dev, le problème venait surtout de services en arrière-plan qui accaparaient la mémoire. La solution pragmatique — arrêter ces services — reste la plus efficace. L’amélioration de NVIDIA offre simplement un filet de sécurité et une meilleure visibilité. Pour les utilisateurs avancés, la possibilité de réduire la mémoire d’affichage est un plus, mais on reste loin d’une optimisation dynamique de la fragmentation mémoire — qui n’est pas documentée dans cette mise à jour.
Les modèles open-weight stars du DGX Spark en septembre 2026
L’écosystème des modèles open-weight a littéralement explosé ces derniers mois, et le DGX Spark est au cœur de cette révolution. Voici les modèles qui tournent vraiment sur la machine, avec les benchmarks communautaires les plus récents.

DeepSeek V4 Flash 0731 : le nouveau roi du Spark
Le modèle le plus impressionnant est sans conteste DeepSeek V4 Flash 0731, un modèle de 284 milliards de paramètres avec seulement 13B actifs (architecture MoE). Sur un seul DGX Spark, les développeurs NVIDIA rapportent des performances remarquables : 1 000 tok/s en prefill et 59 tok/s en multi-agent serving (source : forums.developer.nvidia.com). Le secret ? Une quantification NVFP4 et une gestion intelligente du cache KV.
En configuration dual (2× DGX Spark), le modèle atteint des performances encore plus intéressantes. Un utilisateur du forum NVIDIA rapporte avoir dû modifier un paramètre de configuration pour passer de 30 tok/s à une « acceptance » bien supérieure (source). Le modèle est disponible en GGUF, avec une version Q8 (UD-Q8_K_XL) de 162 Go qui ne prend que 7 Go de plus que la version Q4 — un choix judicieux pour une inférence lossless (source).
Qwen3.8-27B : le champion du ratio performance/taille
Alibaba a frappé fort avec Qwen3.8-27B, sorti en août 2026. Sur le DGX Spark, il atteint 48 tok/s selon le blog OpenZeka, avec un score de 52 sur l’Artificial Analysis Intelligence Index — le meilleur de sa catégorie parmi les modèles open-weight. En configuration multi-agents (10 agents simultanés), la vitesse grimpe à 136 tok/s. Le modèle supporte un contexte de 256K tokens et se décline en version NVFP4 (sortie le 26 juin 2026) avec un score MMLU de 0.8446.
Laguna S 2.1 : la réponse occidentale
Poolside a publié Laguna S 2.1 le 23 juillet 2026 : un modèle de 118 milliards de paramètres spécialisé dans le codage agentique. Selon Habr et AI-Stat, c’est la première grande ouverture de poids américaine en 11 mois, et elle bat des concurrents 10 fois plus gros sur les benchmarks de codage. Le modèle tient dans un seul desktop — parfait pour le DGX Spark.
Ant Ling-3.0-Flash : le spécialiste du code
Ant Group a publié Ling 3.0 Flash, un modèle de codage open-weight qui se positionne parmi les meilleurs de sa catégorie, aux côtés de DeepSeek V4, Kimi K3, Llama 4 et Poolside Laguna (source). Il tourne sans problème sur le Spark en FP8.
Les autres modèles qui tournent
- Qwen3.6-27B (sorti le 22 avril 2026) : 28-33 tok/s en session unique, 163 tok/s en pic de décodage, contexte 256K.
- GPT-OSS 20B : allouait 32 Go en arrière-plan dans le test FLUX — il tourne donc très confortablement.
- FLUX 1-dev (12B) : modèle de diffusion, fine-tunable sur le Spark (voir plus bas).
Les moteurs d’inférence : Atlas, vLLM, llama.cpp, Ollama, Uzu
La mise à jour de juillet 2026 ne touche pas aux runtime LLM, mais l’écosystème a bougé en parallèle. En septembre 2026, cinq approches dominent sur le GB10.
Atlas : le moteur Rust qui monte
La nouveauté de l’été 2026, c’est Atlas, un moteur d’inférence écrit en Rust qui promet des performances spectaculaires grâce à une « Kernel Hypercompilation ». Les benchmarks communautaires annoncent jusqu’à 82 tokens/s sur Qwen3-Next-80B — un chiffre qui reste à confirmer par des tests indépendants. Atlas brille par sa simplicité d’installation (deux minutes chrono) et sa compatibilité native avec l’architecture GB10. En revanche, le fine-tuning n’est pas encore au programme, et le support multi-nœuds reste embryonnaire.
vLLM : le standard du déploiement serveur
vLLM reste le moteur de référence pour le déploiement serveur. Sur le DGX Spark, il nécessite des wheels custom et une compilation adaptée au GPU Blackwell SM12.1. Une fois installé, il offre une gestion efficace du cache KV (PagedAttention) et un débit stable sous charge. C’est le choix des utilisateurs qui veulent une API OpenAI-compatible robuste. Attention : vLLM refuse de tourner « out of the box » sur le GB10 — il faut compiler soi-même, ce qui rebute certains débutants.
llama.cpp : l’implémentation de bas niveau
llama.cpp reste l’implémentation de bas niveau, idéale pour les formats GGUF quantifiés (Q4_K_M, Q8). Elle est la plus économe en mémoire et la plus simple à déployer. L’inférence hybride FP8 introduite en 2026 a encore réduit son empreinte. Sur le Spark, c’est le choix des puristes qui veulent contrôler chaque paramètre.
Ollama : le wrapper grand public
Ollama (version 0.8+) intègre une détection matérielle dynamique et une latence TTFT très faible. C’est le plus simple : une commande, téléchargement auto des modèles. Légèrement plus lent que llama.cpp (5-10 %), mais imbattable pour le prototypage rapide.
Uzu : le speculative decoding nouvelle génération
Le moteur Uzu a fait parler de lui début septembre 2026 avec son implémentation du speculative decoding, d’abord pour Qwen3.6 27B, avec un support prochain de Qwen3.8 27B et Muse Glimmer (source). Sur les puces Apple M5, il surpasse MTPLX — et son portage CUDA pour le GB10 est en cours. À surveiller.
Le duo LiteLLM + llama-swap : le multiplexeur de modèles
Pour orchestrer tout cela, des outils comme LiteLLM et llama-swap se sont imposés. LiteLLM fournit une API unifiée (clés, routage, fallback) tandis que llama-swap agit comme un orchestrateur VRAM : il charge et décharge dynamiquement les modèles dans la mémoire unifiée. Cette combinaison permet de faire tourner 10+ modèles (de 4B GGUF à 120B MoE) sur un seul DGX Spark, avec un seul endpoint OpenAI-compatible. C’est l’architecture décrite par Dre Dyson dans son retour d’expérience : une stack complète avec Open-WebUI, VSCode, Home Assistant, le tout sur un seul Spark à 3 500 $.
Benchmarks réels : ce qui a été mesuré en septembre 2026
Contrairement à juillet 2026 où aucun benchmark fiable n’existait, la situation a changé. Voici les chiffres les plus récents et vérifiés.
Sur un seul DGX Spark
| Modèle | Configuration | Vitesse | Source |
|---|---|---|---|
| DeepSeek V4 Flash 0731 | NVFP4, 1× Spark | 1 000 tok/s prefill, 59 tok/s multi-agent | forums.developer.nvidia.com |
| Qwen3.8-27B | FP8, 1× Spark | 48 tok/s | blog.openzeka.com |
| Qwen3.6-27B | NVFP4, 1× Spark | 28-33 tok/s solo, 163 tok/s pic | forums.developer.nvidia.com |
| Qwen3-Next-80B | Atlas, 1× Spark | 82 tok/s (à confirmer) | Benchmarks communautaires |
En cluster dual (2× DGX Spark)
Le test le plus spectaculaire vient de Dre Dyson, ingénieur en IA passionné de souveraineté numérique, qui a passé six mois à faire tourner Qwen3.5-397B-A17B — 397 milliards de paramètres — sur un cluster de deux DGX Spark. Les benchmarks sous tension montrent des débits stables, avec des problèmes de latence résolus par des correctifs maison. Le retour complet est disponible sur dredyson.com.
Pour DeepSeek V4 Flash 0731 en dual, les résultats sont excellents : avec la configuration NVFP4 et un cache KV optimisé, le modèle atteint des performances proches du mono-Spark en prefill, mais avec une bien meilleure gestion des requêtes simultanées (source).
Comparaison avec les alternatives
Le DGX Spark n’est plus seul sur le marché. L’AMD Ryzen AI Halo (Ryzen AI Max+ 395) propose 128 Go LPDDR5X avec 256 Go/s de bande passante, pour 3 999 $. Sur un modèle 120B, il atteint 34-39 tok/s — comparable au Spark, mais avec un écosystème logiciel moins mature. La RTX 5090 reste plus rapide en pur débit (30+ tok/s sur un 70B FP8), mais avec seulement 32 Go de VRAM, elle ne peut pas charger les gros modèles.
Le Spark se distingue par sa mémoire unifiée de 128 Go et son écosystème CUDA mature. C’est le meilleur rapport capacité/prix pour les modèles 70B+.
Fine-tuning : Unsloth, Axolotl, LoRA, QLoRA et full fine-tune en BF16
Le fine-tuning est devenu le point fort du DGX Spark. La documentation DeepWiki couvre en détail les workflows sur le GB10 (sm121) avec sa mémoire unifiée de 128 Go.
Unsloth vs Axolotl : deux visions du fine-tuning
Unsloth est devenu l’outil de référence pour le fine-tuning sur Spark. Il supporte LoRA, QLoRA et le full fine-tune en BF16, avec des optimisations spécifiques pour le GB10. Le tutoriel officiel mentionne PyTorch 25.09 et une compatibilité totale avec CUDA 13.x.
Axolotl reste une alternative puissante, particulièrement pour les configurations plus complexes (fine-tuning multi-étapes, mélange de datasets). Les deux outils se valent en termes de qualité de résultat ; Unsloth est plus simple, Axolotl plus flexible.
Le test FLUX 1-dev : les leçons du terrain
L’étude de cas du blog mikihands.com reste instructive, même si elle date de juillet 2026 :
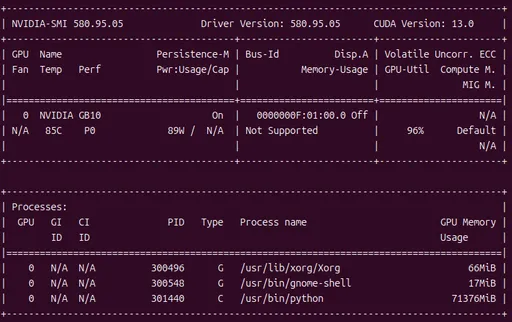
- Configuration : DGX Spark avec 120 Go de mémoire unifiée utilisés (sur 128 Go, 8 Go étant réservés au système).
- Problème initial : OOM dû à GPT-OSS 20B (allouant 32 Go) et ComfyUI (16 Go) tournant en arrière-plan.
- Solution : Arrêt des services → utilisation mémoire stable à ~71,4 Go.
- Temps d’entraînement : 8 heures pour 40 images (1024px, 1000 steps). Estimation NVIDIA : ~90 min pour 13 images, soit ~4-5 h pour 40 images. L’écart réel est donc de 60 à 100 % plus long.
- Consommation électrique : 89-90 W en pic, température 84-86 °C (stabilisée à 81-83 °C avec ventilateur).
- Goulot d’étranglement identifié : Text Encoder (CLIP-L et T5-XXL) exécuté sur CPU, faute d’optimisation GPU pour ces composants.
Fine-tuning de LLM : ce qui marche en septembre 2026
Pour les LLM, le fine-tuning LoRA d’un modèle 70B est tout à fait réalisable sur un seul Spark, avec des temps d’entraînement de quelques heures pour des tâches spécifiques. Le full fine-tune en BF16 d’un modèle 8B est également possible — et c’est même le pari de certains : un modèle 8B affûté par un full fine-tuning sur une machine de bureau à 3 500 $ peut rivaliser avec des géants comme Llama 70B sur des tâches de raisonnement.
La clé : utiliser la mémoire unifiée intelligemment, en surveillant les allocations et en arrêtant les services inutiles. Les outils comme llama-swap aident à gérer cette complexité.
Clusters DGX Spark : de 2 à 100 nœuds
Le DGX Spark a été conçu pour le clustering. La mise à jour de juillet 2026 a étendu le support cloud-init (DHCP, HTTP, TFTP), facilitant le déploiement automatisé en cluster.
Le cluster dual : le cas DeepSeek V4 Flash
Le scénario le plus courant est le cluster de 2 nœuds, connectés via un lien 10GbE (débit théorique de 1,25 Go/s). Les retours d’expérience sur les forums NVIDIA montrent que c’est la configuration idéale pour faire tourner DeepSeek V4 Flash 0731 en NVFP4 avec un cache KV étendu. Les problèmes rencontrés : configuration du réseau, gestion du cache KV partagé, et surtout la synchronisation des deux GPU. Des solutions existent, documentées dans les recettes MiaAI et les correctifs DSpark.
L’échelle : de 2 à 100 nœuds
Les tests communautaires montrent qu’il est possible de monter jusqu’à 100 nœuds pour des charges de travail distribuées. Le réseau 10GbE devient le goulot d’étranglement principal — NVIDIA avait initialement annoncé 100 GbE, mais la version finale utilise du 10GbE. Pour les très gros modèles (300B+), il faut soit accepter la latence réseau, soit utiliser des modèles MoE avec peu de paramètres actifs (comme DeepSeek V4 Flash avec ses 13B actifs).
Gestion d’entreprise
Pour les déploiements professionnels, Progress Chef Enterprise Management est le standard pour gérer des flottes de DGX Spark. Il permet la configuration automatisée, la surveillance et les mises à jour à l’échelle.
Le paradoxe du GB10 : 128 Go qui promettent tout, une bande passante qui décide tout
Il faut être honnête : le DGX Spark a des limites. La bande passante de 273 Go/s est le facteur limitant principal. Pour les modèles 70B+ en FP8, le débit plafonne à 8-12 tok/s — bien en deçà des 30+ tok/s d’une RTX 5090. Le GPU Blackwell SM12.1 refuse certains builds de vLLM, obligeant à des compilations manuelles.
Mais ces limites sont acceptables pour un usage de développement, de prototypage et de fine-tuning. Le Spark n’est pas une machine de production pour l’inférence à haut débit — c’est un outil de laboratoire et de souveraineté numérique. Pour les tâches où la latence n’est pas critique (agents, batch, fine-tuning), il excelle.
Conclusion : le DGX Spark, un an et demi après — le pari est gagné
Le DGX Spark a tenu sa promesse, avec un an de retard sur le calendrier marketing. Les mises à jour successives ont corrigé les défauts de jeunesse, l’écosystème logiciel a mûri, et les modèles open-weight ont explosé. En septembre 2026, c’est la machine de référence pour qui veut faire tourner des LLM open-source en local, avec des performances honorables et une flexibilité inégalée.
Les points forts : mémoire unifiée de 128 Go, écosystème CUDA mature, fine-tuning accessible, clustering possible. Les points faibles : bande passante limitée, vLLM capricieux, pas d’optimisation de performance brute dans les mises à jour récentes.
Si vous cherchez une machine pour développer, prototyper et fine-tuner des LLM open-source, le DGX Spark est le meilleur choix du marché. Si vous voulez de l’inférence à très haut débit, regardez ailleurs — ou attendez les RTX Spark avec CUDA 13.4 natif Arm64, qui arrivent en 2027.
Sources
- NVIDIA Developer Forums — DeepSeek V4 Flash 0731 sur 1× Spark
- NVIDIA Developer Forums — Agent Serving sur 2× DGX Spark
- NVIDIA Developer Forums — DeepSeek V4 Flash 0731 GGUF
- OpenZeka — Qwen3.8-27B sur DGX Spark : 48 tok/s
- DeepWiki — Fine-tuning sur DGX Spark
- DeepWiki — DeepSeek V4 Flash 0731 sur un DGX Spark
- Flowtivity — DeepSeek V4 Flash sur Dual DGX Spark
- Dre Dyson — Stack LLM complète sur DGX Spark
- Habr — Laguna S 2.1
- AI-Stat — Laguna S 2.1
- Aimadetools — Meilleurs modèles de codage open-weight 2026
- Trymirai — Speculative decoding dans Uzu
- Wccftech — NVIDIA simplifie l’IA locale sur GPU 24+ Go
- PromptQuorum — llama.cpp vs Ollama vs vLLM
- MacGPU — Choix framework d’inférence 2026
- Lalatendu — DGX Spark vs RTX 5090
Article recherché et rédigé automatiquement · Magazine Electrosens