
 NVIDIA DGX Spark · 11 November 2026
LLM open source sur NVIDIA GB10 DGX Spark : la machine de référence de l’automne 2026 (DGX OS 8, MoE, fine-tuning, clusters)
Depuis son annonce au CES 2025, le DGX Spark de NVIDIA s’est imposé comme le Graal des développeurs IA en local : un mini-PC capable de faire tourner des modèles de 70 à 120 milliards de paramètres grâce à sa mémoire unifiée de 128 Go et sa superpuce Grace Blackwell. Un an après sa livraison (semaine du 13 octobre 2025), la promesse est tenue — mais avec des nuances que les benchmarks d’une année entière ont fini par clarifier. La mise à jour d’octobre 2026 (DGX OS 8) a soldé la dette technique des débuts, les trois optimisations MoE publiées par NVIDIA fin octobre ont fait passer le temps par token de 27,71 ms à 9,72 ms sur Ling-3.0-flash, et une gamme s’est dédoublée avec une Spark 64 Go à 4 999 $. DeepSeek V4 Flash 0731 (284B, 13B actifs) tourne sur un seul Spark, Qwen3.8-27B atteint 34-38 tok/s, et des clusters de 2 à 8 nœuds domptent les géants open-weight. Verdict : le DGX Spark est devenu la machine de référence pour l’IA open-source locale — à condition de comprendre que c’est une machine de capacité et de prefill, pas un démon du décodage.
Le DGX Spark en octobre 2026 : la promesse tenue, et une gamme qui se dédouble
Quand NVIDIA a présenté le DGX Spark au CES 2025 (sous le nom de Project DIGITS, le 6 janvier 2025), la promesse était claire : un supercalculateur de bureau capable d’exécuter des modèles d’IA de pointe sans passer par le cloud. Renommé et tarifé au GTC de mars 2025, l’appareil a commencé à être livré la semaine du 13 octobre 2025. Avec 128 Go de mémoire unifiée LPDDR5x (bande passante 273 Go/s), une performance annoncée allant jusqu’à 1 petaFLOP en FP4 et un port ConnectX-7 200 GbE pour le clustering, le mini-PC de 150 × 150 × 51 mm (1,2-1,5 kg, sous DGX OS, une base Ubuntu) semblait taillé pour l’inférence et le fine-tuning de LLMs open-source. Les premiers mois ont été difficiles : saturations mémoire, latences élevées, absence de support natif pour certains modèles.
En octobre 2026, le DGX Spark est devenu une plateforme mature. Les mises à jour successives — celle de juillet 2026, puis surtout la release d’octobre 2026 qui fait passer la machine de DGX OS 7 à DGX OS 8 — ont corrigé les défauts de jeunesse, et l’écosystème logiciel a rattrapé son retard. Surtout, une vague de modèles open-weight récents a transformé la machine en outil de production : DeepSeek V4 Flash 0731, Qwen3.8-27B, Laguna S 2.1, Ling-3.0-Flash, MiMo-V2.6. Les benchmarks communautaires fleurissent, les clusters se multiplient, et le fine-tuning est devenu accessible à tous grâce à Unsloth et Axolotl.
Mais la véritable actualité de cette rentrée, c’est le dédoublement de la gamme. NVIDIA a officialisé le 2 octobre 2026 une DGX Spark à 64 Go de mémoire unifiée, vendue 4 999 $ et disponible à la vente le 23 octobre — soit 1 000 $ de plus que le prix de lancement de la version 128 Go en 2025 (kod.ru, Hardwareluxx Russia). Dans un marché mémoire en pleine flambée, cette SKU au rabais apparent cache une réalité économique cruelle : le prix des 128 Go s’envole, et la 64 Go devient paradoxalement l’entrée la moins chère… tout en étant plus chère que ne l’était la 128 Go à son lancement. Un renversement qui divise la communauté.
Le prix de référence de la version 128 Go reste nominalement de 4 699 $, avec des alternatives comme l’Acer DGX environ 500 à 1 000 $ moins chères (livraison des mini-PC RTX Spark d’Acer le 8 septembre 2026). Face à cela, la concurrence compacte s’organise : l’AMD Ryzen AI Halo 192 Go, lancé à 7 299,99 $ chez Micro Center, est la première machine de bureau compacte capable de charger des modèles open-weight de 300 milliards de paramètres — mais les benchmarks indépendants montrent que le DGX Spark garde l’avantage en vitesse (TechTimes, 14 octobre 2026). Le DGX Spark n’est plus une curiosité de laboratoire — c’est un outil de travail quotidien pour des milliers de développeurs, et désormais une famille de produits.
La mise à jour d’octobre 2026 : DGX OS 8, et ce que ça change vraiment
La mise à jour de juillet 2026, publiée sur les forums développeurs NVIDIA et dans la documentation officielle, avait répondu aux irritants des premiers utilisateurs sans les nommer explicitement. Le changelog évoquait une « amélioration de la gestion mémoire (OOM handling) avec retour utilisateur en cas de pression mémoire », ainsi qu’une mémoire d’affichage ajustable (2 Go par défaut, 4 Go possible via BIOS). Ces correctifs, bien que techniques, trahissaient une réalité : le DGX Spark, malgré sa mémoire unifiée généreuse, souffrait d’une gestion perfectible des ressources.

Les 5 modifications de juillet 2026 qui ont changé la donne
| Modification | Description | Impact concret |
|---|---|---|
| Gestion OOM améliorée | Le pilote GPU signale désormais les situations de pression mémoire et permet à l’utilisateur de libérer de la RAM en réduisant la mémoire allouée à l’affichage. | Évite les crashs intempestifs lors de l’exécution de modèles lourds ; permet de récupérer jusqu’à 2 Go supplémentaires. |
| Mémoire d’affichage ajustable | Possibilité de basculer entre 2 Go (défaut) et 4 Go via le BIOS. | Utile pour les configurations multi-écrans ; libère de la mémoire système si l’on n’utilise qu’un seul écran. |
| Cloud-init étendu | Support de DHCP, HTTP, TFTP en plus de l’USB direct ; personnalisation de l’image FastOS. | Facilite le déploiement en cluster et la configuration automatisée. |
| Correction hot-plug écrans | Résolution d’une instabilité système et d’affichage lors du branchement/débranchement d’écrans. | Améliore la fiabilité au quotidien, surtout pour les stations multi-écrans. |
| Mise à jour des versions logicielles | DGX OS 7.5.0, GPU Driver 580.159.03, CUDA 13.0.2, Kernel 6.17, UEFI 1.110.13, EC 3.5.8, USB PD 0.5.22, TPM 7.516.1, SoC 2.155.11. | Corrections de bugs et compatibilité avec les derniers frameworks (PyTorch, TensorRT). |
Octobre 2026 : la release qui rebat les cartes
Le 21 octobre 2026, NVIDIA a déployé sa release d’octobre 2026 sur les DGX Spark, avec un lot de nouveautés documenté sur les forums développeurs (forums.developer.nvidia.com). Les systèmes partenaires équipés du même SoC GB10 Grace Blackwell bénéficient des mêmes mises à jour. Sur le papier, c’est une simple release ; sous le capot, c’est un changement de socle logiciel qui impose de reflasher le firmware dans le bon ordre — un point que nous détaillons dans notre article dédié à DGX OS 8.
Le saut de version DGX OS 7 → DGX OS 8 solde une dette technique accumulée depuis le lancement : noyau rafraîchi, pilotes alignés, conteneurs réorganisés. Côté CUDA, le CUDA Toolkit 13.4 est disponible en developer preview depuis septembre 2026, avec un support natif Arm64 pour les futures machines RTX Spark — un signe que l’écosystème s’élargit au-delà du seul DGX Spark. Les versions logicielles sont désormais alignées sur l’écosystème NVIDIA le plus récent, garantissant une meilleure compatibilité avec les bibliothèques d’IA comme PyTorch 25.09. NVIDIA a par ailleurs annoncé le 3 septembre 2026 un support simplifié de l’IA locale pour ses GPU embarquant 24+ Go de VRAM, avec des optimisations apportées à vLLM et llama.cpp sur les plateformes RTX et DGX (wccftech.com).
Un détail révélateur de la trajectoire : le firmware du DGX Spark intègre désormais un certificat de démarrage Windows UEFI CA, et NVIDIA a confirmé à l’IFA la mise en vente de PC RTX Spark sous Windows en octobre (StorageReview). Le Spark se prépare à un avenir hybride, où il cohabitera avec l’écosystème Windows — un point que nous détaillons plus bas.
Mémoire unifiée sous pression : comment NVIDIA a (enfin) dompté les OOM
L’architecture mémoire unifiée du GB10 est à la fois la force et la faiblesse du DGX Spark. Avec 128 Go de LPDDR5x partagés entre CPU et GPU, elle permet de charger des modèles de 70B à 120B paramètres en FP4 ou FP8, mais elle expose aussi le système à des conflits d’allocation. Avant la mise à jour, un utilisateur pouvait voir son fine-tuning interrompu sans explication — comme l’a vécu l’auteur du blog mikihands.com lors du fine-tuning de FLUX 1-dev (12B) : 120 Go de mémoire unifiée étaient pourtant disponibles, mais des services en arrière-plan (GPT-OSS 20B allouant 32 Go, ComfyUI 16 Go) ont saturé la RAM système.
Le correctif de juillet 2026 introduit un mécanisme de retour utilisateur en cas de pression mémoire : au lieu de planter brutalement, le système signale le problème et permet de libérer de la RAM en réduisant la mémoire allouée à l’affichage (passer de 4 Go à 2 Go via le BIOS). Concrètement, cela peut récupérer 2 Go supplémentaires — de quoi faire la différence entre un modèle qui tient et un OOM.
Mais attention : ce n’est pas une baguette magique. Comme le montre le test FLUX 1-dev, le problème venait surtout de services en arrière-plan qui accaparaient la mémoire. La solution pragmatique — arrêter ces services — reste la plus efficace. L’amélioration de NVIDIA offre simplement un filet de sécurité et une meilleure visibilité. Pour les utilisateurs avancés, la possibilité de réduire la mémoire d’affichage est un plus, mais on reste loin d’une optimisation dynamique de la fragmentation mémoire — qui n’est pas documentée dans cette mise à jour.
Un rappel de fiabilité s’impose toutefois : fin septembre 2026, un rapport GitHub documentait un cas de perte totale d’hôte (whole-host loss) lors d’une inférence MiniMax H3 FL2VA en 864×480 sur un DGX Spark GB10 mono-GPU, après des exécutions pourtant réussies (github.com). La mémoire unifiée reste une ressource à surveiller de près pour les charges vidéo lourdes, même après les correctifs.
Les modèles open-weight stars du DGX Spark à l’automne 2026
L’écosystème des modèles open-weight a littéralement explosé ces derniers mois, et le DGX Spark est au cœur de cette révolution. Voici les modèles qui tournent vraiment sur la machine, avec les benchmarks communautaires les plus récents.

DeepSeek V4 Flash 0731 : le nouveau roi du Spark
Le modèle le plus impressionnant est sans conteste DeepSeek V4 Flash 0731, un modèle de 284 milliards de paramètres avec seulement 13B actifs (architecture MoE). Sur un seul DGX Spark, les développeurs NVIDIA rapportent des performances remarquables : 1 000 tok/s en prefill et 59 tok/s en multi-agent serving (source : forums.developer.nvidia.com). Le secret ? Une quantification NVFP4 et une gestion intelligente du cache KV.
Les benchmarks indépendants nuancent toutefois le tableau. La suite antirez ds4 (DeepSeek-V4-Flash IQ2_XXS) mesure environ 14 tok/s en single-stream et 410 tok/s en prefill sur un seul Spark (août 2026). En configuration dual (2× DGX Spark, TP=2, vLLM, FP8), le débit single-stream monte à ~41 tok/s, le débit agrégé à ~350 tok/s à une concurrence de 32, et le prefill à ~1 785 tok/s (août 2026). Le pool de cache KV partagé sur deux nœuds atteint 1 105 096 tokens. Le modèle est disponible en GGUF, avec une version Q8 (UD-Q8_K_XL) de 162 Go qui ne prend que 7 Go de plus que la version Q4 — un choix judicieux pour une inférence quasi lossless (source).
Qwen3.8-27B : le champion du ratio performance/taille
Alibaba a frappé fort avec Qwen3.8-27B, sorti en août 2026. Sur le DGX Spark, il atteint 34-38 tok/s (mesure du 20 août 2026) selon le blog OpenZeka, avec un score de 52 sur l’Artificial Analysis Intelligence Index — le meilleur de sa catégorie parmi les modèles open-weight. En configuration multi-agents (10 agents simultanés), la vitesse grimpe à 136 tok/s. Le modèle supporte un contexte de 256K tokens et se décline en version NVFP4 (sortie le 26 juin 2026) avec un score MMLU de 0.8446.
Laguna S 2.1 : la réponse occidentale
Poolside a publié Laguna S 2.1 le 23 juillet 2026 : un modèle de 118 milliards de paramètres spécialisé dans le codage agentique. Selon Habr et AI-Stat, c’est la première grande ouverture de poids américaine en 11 mois, et elle bat des concurrents 10 fois plus gros sur les benchmarks de codage. Le modèle tient dans un seul desktop — parfait pour le DGX Spark.
Ling-3.0-Flash : le spécialiste du code, et le banc d’essai des optimisations MoE
Ant Group a publié Ling 3.0 Flash le 23 juillet 2026, un modèle de codage open-weight à attention hybride-linéaire (KDA et MLA dans un ratio 5:1) qui se positionne parmi les meilleurs de sa catégorie, aux côtés de DeepSeek V4, Kimi K3, Llama 4 et Poolside Laguna (source). Il tourne sans problème sur le Spark en FP8, avec un débit estimé de 15-20 tok/s. Surtout, c’est Ling-3.0-flash qu’Inclusion AI a servi de cobaye à NVIDIA pour ses trois optimisations MoE d’octobre 2026 — le modèle est donc devenu la référence de mesure du gain de 42,5 % (voir plus bas).
MiMo-V2.6 : l’entrée fracassante de Xiaomi
Le 22 septembre 2026, Xiaomi a ouvert les poids de sa famille MiMo-V2.6 (Pro, Flash, 9B) sous licence MIT (SiliconANGLE, eWeek). Le MiMo-V2.6-Pro égale Grok 4.7 sur l’Intelligence Index et dépasse Claude Opus 5 sur plusieurs benchmarks clés, selon Forkast. Sur le Spark, les variantes Flash et 9B sont les plus réalistes en mono-nœud ; la version Pro exige un cluster.
Le tournant MoE : pourquoi le GB10 est fait pour ces modèles
Ce qui relie tous ces modèles, c’est l’architecture mixture-of-experts. Un MoE à 284B de paramètres dont seulement 13B sont actifs par token ne sollicite qu’une fraction de la bande passante mémoire à chaque pas de décodage — exactement le compromis qui convient à un GB10 limité à ~273 Go/s. C’est la raison pour laquelle le Spark, médiocre sur les denses de 70B, devient excellent sur les MoE récents. Notre cartographie dédiée recense les MoE ouverts qui tiennent sur un seul Spark en 2026.
Les trois optimisations MoE de NVIDIA : 27,71 ms → 9,72 ms par token
Le 27 octobre 2026, NVIDIA a publié sur son blog technique trois techniques d’optimisation de l’inférence mixture-of-experts sur DGX Spark (developer.nvidia.com), avec un gain de débit mesuré de 42,5 % sur Ling-3.0-flash. Le 31 octobre, le blog Netics Labs a reproduit l’expérience et publié une analyse critique : sur un re-run GSM8K, une partie du gain synthétique survit à une charge réelle, mais pas la totalité (blog.neticslabs.com). Derrière le chiffre marketing, il y a une réalité mesurable.
Le point de départ de NVIDIA est une évaluation en batch-size 1 de Ling-3.0-flash : à cette taille de lot, le décodage est limité non par le calcul mais par la bande passante mémoire et par l’ordonnancement des experts. Les trois leviers consistent à :
- Ordonnancer les experts pour regrouper les appels et réduire les accès mémoire dispersés ;
- Gérer le cache des poids d’experts les plus fréquemment sollicités, afin d’éviter de recharger depuis la LPDDR5x ;
- Optimiser la précision des routes (routing) pour limiter les calculs inutiles sur les experts peu contributeurs.
Le résultat canonique : le temps par token de sortie passe de 27,71 ms à 9,72 ms. Attention à l’interprétation : ce chiffre est mesuré sur un workload synthétique en batch 1. En production, avec des lots plus grands et des prompts variables, le gain se réduit — mais reste réel. Pour reproduire les gains chez soi, la recette de configuration (variables d’environnement, réglages vLLM, pinning mémoire) est documentée dans notre article dédié aux 42,5 % de NVIDIA.
Moteurs d’inférence : vLLM, llama.cpp, Atlas — et le piège du « out of the box »
La question du moteur reste centrale sur le GB10. vLLM offre le meilleur débit agrégé en multi-requêtes et le support du tensor parallelism pour les clusters, mais il refuse de tourner « out of the box » sur le GB10 : il faut compiler pour l’architecture SM12.1 du Blackwell embarqué, ajuster les flags de mémoire unifiée et souvent patcher les kernels. llama.cpp reste le plus simple à démarrer (GGUF, quantification flexible) et le plus économe en mémoire, au prix d’un débit inférieur en concurrence. Atlas, plus récent, se positionne comme un intermédiaire.
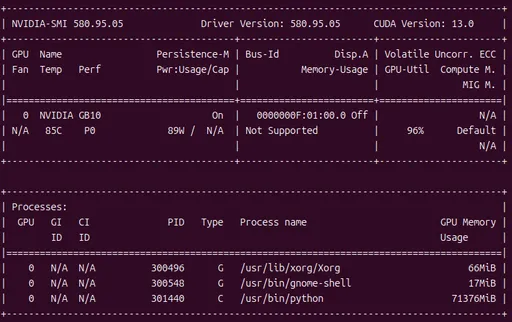
Le duo LiteLLM + llama-swap transforme les 128 Go en multiplexeur de modèles : LiteLLM expose une API unifiée, llama-swap charge et décharge les modèles à la demande selon la requête, ce qui permet de faire cohabiter plusieurs LLM spécialisés sur une seule machine sans saturer la mémoire. C’est aujourd’hui l’architecture recommandée pour un Spark en production mono-utilisateur ou petite équipe.
Côté edge, NVIDIA a détaillé le 30 octobre 2026 un workflow en ligne de commande pour faire tourner Nemotron-3.5 Lightning sur le DGX Spark 64 Go, avec données de benchmark et résultats de décodage spéculatif (blockchain.news). Une démonstration que la SKU 64 Go n’est pas qu’une version au rabais : elle a son propre cas d’usage, l’inférence edge optimisée.
Fine-tuning sur GB10 : LoRA, QLoRA et la chaîne complète
Le DGX Spark a été vendu comme une machine d’inférence et d’agents locaux. Mais en 2026, une autre pratique s’y est installée sans tambour ni trompette : le post-entraînement. LoRA, QLoRA, RL, diffusion — les retours terrain convergent : la mémoire unifiée change la donne, à condition de comprendre ce qu’elle permet et ce qu’elle interdit.
La chaîne complète, du dataset brut à l’adaptateur, est désormais bien balisée. Unsloth documente officiellement le fine-tuning de LLMs sur DGX Spark (unsloth.ai), et des guides pas à pas existent pour la prise en main (spark.enverge.ai, awesomeagents.ai). Les étapes : préparation du dataset (format chat, tokenisation), choix de la méthode (LoRA, QLoRA, DoRA), réglage du rang, de l’alpha, du learning rate et de la longueur de séquence, puis entraînement et fusion de l’adaptateur.
Le match des trois méthodes sur GB10 donne un verdict nuancé. LoRA offre le meilleur compromis qualité/vitesse quand le modèle tient en mémoire avec ses poids en BF16/FP8. QLoRA (quantification 4-bit des poids de base) permet de fine-tuner des modèles plus gros — jusqu’à ~70B sur un seul Spark — au prix d’une légère perte de qualité et d’un surcoût de déquantification. DoRA améliore la stabilité pour les petits rangs mais coûte plus cher en calcul. Le piège principal reste le pool mémoire unifié : pendant l’entraînement, les activations, les gradients et les optimiseurs s’ajoutent aux poids du modèle, et un run qui « tient » en inférence peut exploser en fine-tuning. La règle empirique : prévoir 2 à 3× la taille du modèle en mémoire pour un run LoRA confortable.
Côté logiciel, la release d’octobre 2026 (DGX OS 8) a rafraîchi les conteneurs PyTorch et les pilotes, ce qui simplifie l’installation d’Unsloth et d’Axolotl. Notre recette complète, avec chiffres vérifiés et pièges documentés, est disponible dans l’article dédié au fine-tuning sur DGX Spark (mise à jour novembre 2026).
Clusters DGX Spark : de 2 à 8 nœuds, et jusqu’où ça tient
Le clustering est l’un des arguments les plus solides du Spark, grâce au port ConnectX-7 200 GbE. En configuration 2 nœuds (TP=2, vLLM), on atteint les chiffres cités plus haut sur DeepSeek-V4-Flash FP8 : ~41 tok/s single-stream, ~350 tok/s agrégés à concurrence 32, ~1 785 tok/s en prefill, avec un pool KV partagé de plus d’un million de tokens. La taille maximale de modèle supportée en 2 nœuds est de 405 milliards de paramètres — de quoi couvrir la quasi-totalité des MoE ouverts de 2026.
Au-delà de 2 nœuds, la complexité croît : la latence d’interconnexion et la synchronisation du tensor parallelism deviennent limitantes, et tous les moteurs ne supportent pas proprement le multi-nœuds sur GB10. Les clusters de 4 à 8 nœuds existent et fonctionnent pour l’entraînement distribué et le serving à grande échelle, mais ils exigent une ingénierie réseau sérieuse. Pour la majorité des développeurs, le sweet spot reste 1 ou 2 nœuds ; au-delà, on entre dans le territoire des équipes qui savent ce qu’elles font.
Windows « hybrid intelligence » et RTX Spark : ce que ça change pour le GB10
Le 7 octobre 2026, Microsoft a publié un billet fondateur qui acte un changement de doctrine : Windows ne se contente plus d’héberger des runtimes IA, il prétend devenir le chef d’orchestre de votre parc de calcul (blogs.windows.com). Le concept de « tissu de calcul unifié » place NPU, GPU et accélérateurs comme le GB10 dans le même sac. Pour le DGX Spark, cela signifie que la machine pourrait, à terme, être pilotée depuis un écosystème Windows — mais les tests concrets manquent encore, et ce qui n’a jamais été testé ne doit pas être présenté comme acquis.
En parallèle, NVIDIA a dévoilé la plateforme RTX Spark (puce N1X, Arm + Blackwell + mémoire unifiée), pensée pour les PC portables et mini-PC taillés pour l’IA locale (lesnumeriques.com, clubic.com). Les premières analyses soulignent une plateforme cohérente mais chère et encore tributaire de logiciels en chantier. La DGX Station for Windows (748 Go de mémoire cohérente, 20 PFLOPs FP4, lancement Q4 2026 via 6 partenaires OEM) montre où va NVIDIA : un continuum du Spark de bureau à la station Windows (tech-insider.org).
Pour l’utilisateur du Spark sous DGX OS, la conséquence pratique est double : d’une part, l’écosystème logiciel s’élargit (CUDA 13.4 Arm64, conteneurs réorganisés) ; d’autre part, il faut rester vigilant sur les régressions introduites par les mises à jour croisées. Notre article dédié à Windows « hybrid intelligence » décortique ce qui marche, ce qui coince et ce qui n’a jamais été testé.
Verdict : une machine de capacité et de prefill, pas un démon du décodage
Un an après sa livraison, le DGX Spark tient sa promesse — avec des nuances désormais bien documentées. C’est une machine de capacité (128 Go unifiés qui font tenir des MoE de 284B) et de prefill (jusqu’à ~1 785 tok/s en dual sur DeepSeek-V4-Flash FP8). Ce n’est pas un démon du décodage : ~14 tok/s single-stream sur un dense de 284B en mono-nœud, ~41 tok/s en dual, c’est correct mais pas spectaculaire. Les optimisations MoE d’octobre 2026 (27,71 ms → 9,72 ms par token sur Ling-3.0-flash) changent la donne pour les charges MoE, mais pas pour les denses.
La release d’octobre 2026 (DGX OS 8) a soldé la dette technique, le fine-tuning est devenu accessible via Unsloth et Axolotl, et les clusters de 2 nœuds couvrent jusqu’à 405B de paramètres. La gamme s’est dédoublée avec une Spark 64 Go à 4 999 $, dans un marché mémoire en flambée qui rend la 128 Go plus chère que jamais. Face à l’AMD Ryzen AI Halo 192 Go (7 299,99 $, capable de charger des modèles de 300B mais plus lent), le Spark garde l’avantage en vitesse et en maturité logicielle.
Le DGX Spark est devenu la machine de référence pour l’IA open-source locale. À condition de comprendre ce qu’on lui demande : de la capacité, du prefill, des MoE, et un peu de patience en décodage single-stream.
Sources
- DGX Spark Software Updates – October 2026 Release — forums.developer.nvidia.com, 21 octobre 2026
- 3 Ways to Boost MoE Inference on NVIDIA DGX Spark — NVIDIA Technical Blog, 27 octobre 2026
- Three MoE Inference Optimizations on DGX Spark — Netics Labs, 31 octobre 2026
- NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM — blockchain.news, 30 octobre 2026
- Trois leviers pour accélérer l’inférence MoE sur NVIDIA DGX Spark — fellow.news, 27 octobre 2026
- AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed — TechTimes, 14 octobre 2026
- NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs — tech-insider.org, 8 octobre 2026
- Building Windows for hybrid intelligence — blogs.windows.com, 7 octobre 2026
- Nvidia RTX Spark face aux puces Apple, AMD, Intel et Qualcomm — lesnumeriques.com, 16 octobre 2026
- Nvidia RTX Spark : la puce qui a deux ans de retard, mais reste en avance sur son temps — lesnumeriques.com, 15 octobre 2026
- NVIDIA prépare la révolution du PC portable : voici ce que ses ingénieurs m’ont dévoilé — clubic.com, 15 octobre 2026
- Fine-tuning LLMs with NVIDIA DGX Spark and Unsloth — unsloth.ai
- How to Fine-Tune an LLM on NVIDIA DGX Spark — spark.enverge.ai
- NVIDIA DGX Spark Setup and Usage Guide for 2026 — awesomeagents.ai
- kod.ru et Hardwareluxx Russia — annonce de la DGX Spark 64 Go, 2 octobre 2026
- wccftech.com — support IA locale 24+ Go VRAM, 3 septembre 2026
- StorageReview — PC RTX Spark sous Windows, IFA 2026
- SiliconANGLE, eWeek, Forkast — MiMo-V2.6 de Xiaomi, 22 septembre 2026
- Habr, AI-Stat — Laguna S 2.1 de Poolside, 23 juillet 2026
- aimadetools.com — Ling 3.0 Flash d’Ant Group, 23 juillet 2026
- OpenZeka — benchmarks Qwen3.8-27B, 20 août 2026
- github.com — rapport de perte d’hôte MiniMax H3 FL2VA, fin septembre 2026
Article recherché et rédigé automatiquement · Magazine Electrosens