
 NVIDIA DGX Spark · 5 September 2026
DGX Spark en septembre 2026 : les LLM open source qui tournent vraiment sur GB10, le fine-tuning BF16 et les clusters multi-nœuds
Septembre 2026. Le DGX Spark de NVIDIA approche de son premier anniversaire, et le paysage a radicalement changé. La hausse de prix d’avril (700 $, portant le ticket à 4 699 $) n’a pas refroidi les développeurs : les mises à jour logicielles de l’été 2026 ont décuplé les performances sur les très grands modèles, le clustering multi-nœuds est enfin une réalité opérationnelle, et une nouvelle génération de modèles open-weight — DeepSeek V4 Flash 0731, Ant Ling-3.0-Flash, Poolside Laguna S 2.1 — a littéralement transformé ce que la machine peut faire tourner. Mais face à une configuration Dual RTX 3090 d’occasion à 3 500 $, le rapport qualité-prix reste-t-il favorable ? Entre benchmarks communautaires, retours de terrain et nouveautés logicielles, nous avons passé au crible chaque euro dépensé, chaque watt consommé, chaque token généré.
Le choc d’avril : pourquoi le DGX Spark a pris 700 $ de plus
En février 2026, le DGX Spark était encore annoncé à 3 999 $ — le prix de lancement officiel communiqué par NVIDIA en janvier 2025 lors de l’annonce du projet DIGITS, puis confirmé à la mise en vente à l’automne 2025 (Generation-NT). Deux mois plus tard, son prix bondit à 4 699 $ – une hausse de 17,5 % qui a fait grincer des dents sur les forums. Les causes évoquées par plusieurs sources (CraftRigs, AIMultiple) sont multiples : pénurie de mémoire HBM, augmentation des coûts de production du Superchip GB10, et un repositionnement tarifaire de NVIDIA qui aligne le Spark sur le segment des stations de travail professionnelles plutôt que sur celui des hobbyistes.
Aucune communication officielle de NVIDIA ne confirme ces éléments, mais la cohérence des témoignages et l’absence de démenti laissent peu de doute. Le prix français, selon Capital.fr, atteignait déjà 3 689 € pour la version Founders Edition (4 To SSD) – avant la hausse. Désormais, le ticket d’entrée dépasse les 4 300 €, soit plus du double d’une RTX 5090 grand public. En août 2026, les revendeurs français affichent des prix oscillant entre 4 500 € et 4 700 € selon les configurations (source : OutilsIA.fr, mise à jour juillet 2026).
Cette augmentation place le DGX Spark dans une zone tarifaire délicate : celle où une configuration Dual RTX 3090 (cartes d’occasion, alim 1 000 W, carte mère, boîtier) revient à environ 3 500 $, soit 1 200 $ de moins. L’écart se resserre, mais le Spark conserve des atouts que l’argent seul ne mesure pas – et les mises à jour de l’été 2026 ont considérablement renforcé sa proposition de valeur.
DGX Spark sous la loupe : un mini-supercalculateur taillé pour l’IA
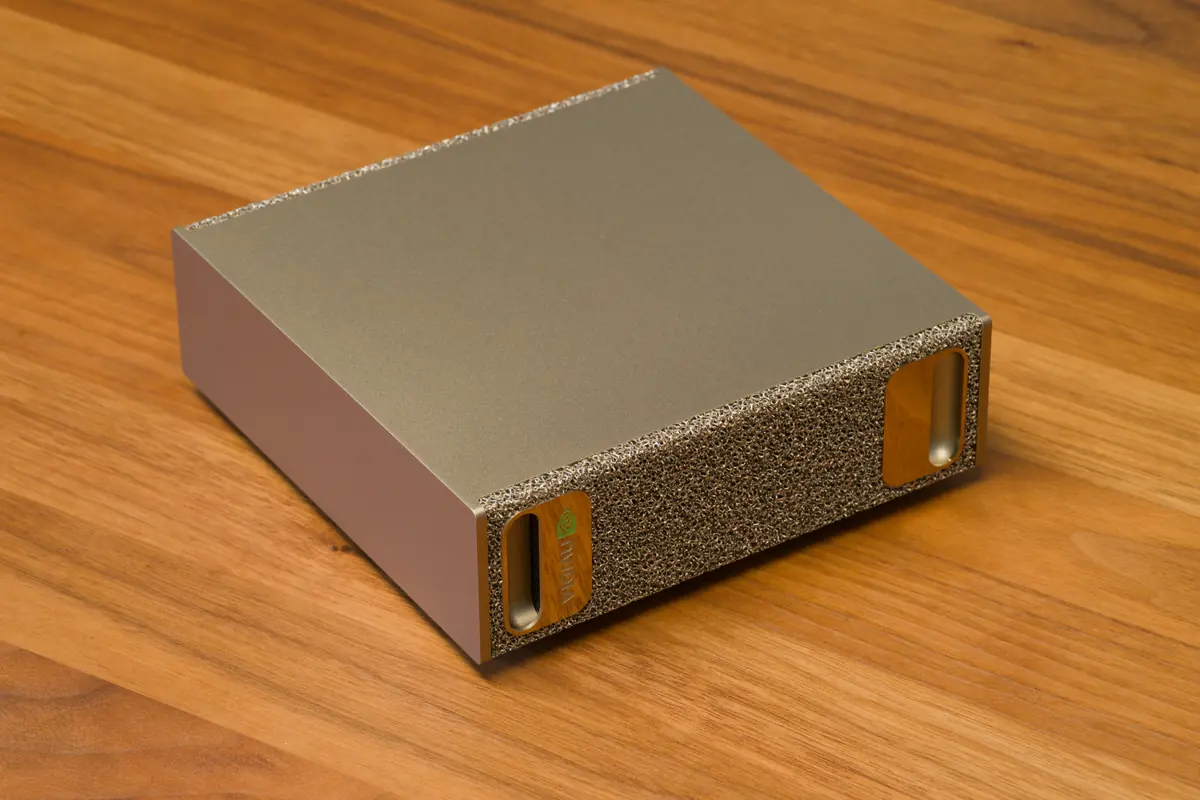
Le DGX Spark repose sur le Superchip GB10 Grace Blackwell : un CPU ARM 20 cœurs (10 Cortex-X925 performance + 10 Cortex-A725 efficacité, architecture ARMv9) couplé à un GPU Blackwell de 6 144 cœurs CUDA avec Tensor Cores de 5e génération (support natif FP4/NVFP4), le tout relié par NVLink-C2C (environ 600 Go/s agrégés, soit 5× la bande passante du PCIe Gen 5). La mémoire unifiée LPDDR5x de 128 Go offre une bande passante de 273 Go/s – suffisante pour charger des modèles jusqu’à 200 milliards de paramètres en quantification FP4. NVIDIA promet 1 petaFLOP en FP4 (avec sparsité), le tout dans un format compact de 150×150 mm, silencieux, et une consommation de 140 W en charge (alimentation 240 W) — c’est le chiffre retenu par le test de Frandroid (test du DGX Spark Dell), qui précise que la puce dissipe 140 W, une valeur supérieure au M5 Max d’Apple mais équivalente à une carte graphique de jeu. Certaines sources communautaires mentionnent 170 W en pic, mais le TDP officiel est bien de 140 W.
Les premiers benchmarks indépendants confirment l’essentiel. Sur le modèle GPT-OSS 120B (117B paramètres, 65 Go en MXFP4), le Spark atteint 1 159 tokens/s en évaluation de prompt et 41 tokens/s en génération (source : blog Ollama, relayé par glukhov.org). Un autre test, cité par AIMultiple, rapporte 1 723 tokens/s en prompt et 38,55 tokens/s en génération. Mieux : grâce aux forks de vLLM, FlashInfer et CUTLASS compilés pour GB10 avec support natif MXFP4 (projet spark-vllm-mxfp4-docker de @christopherowen), GPT-OSS-120B tourne désormais à ~57 tok/s sur un seul Spark, selon le guide de la stack complète publié sur les forums NVIDIA. Pour Llama 3.1 70B en Q4_K_M, les chiffres sont plus modestes mais solides : 22,5 tokens/s selon JetsonHacks (llama.cpp), 23 tokens/s selon GIGAGPU. Le modèle tient intégralement dans la mémoire unifiée, sans déchargement CPU – un avantage décisif face aux cartes graphiques à VRAM limitée.
| Modèle | Prompt (tok/s) | Génération (tok/s) | Source |
|---|---|---|---|
| GPT-OSS 120B (MXFP4) | 1 159 – 1 723 | 38 – 57 | glukhov.org, AIMultiple, forums NVIDIA |
| Llama 3.1 70B Q4_K_M | – | 22,5 – 23 | JetsonHacks, GIGAGPU |
| Qwen 3.6 27B (NVFP4) | – | ~40 (estimé) | kie.ai, juillet 2026 |
| DeepSeek V4 Flash 0731 (NVFP4) | – | 30+ (config optimisée) | forums NVIDIA, 31 juillet 2026 |
| Ant Ling-3.0-Flash 124B-A5B | – | 15 – 20 (estimé) | forums NVIDIA, 23 juillet 2026 |
Depuis la mise à jour logicielle de juillet 2026, les performances ont encore progressé : NVIDIA a déployé une amélioration de la gestion mémoire (memory management) qui réduit les OOM sur les très grands contextes, et TensorRT-LLM a été optimisé pour le GB10 (source : forums développeurs NVIDIA, 14 juillet 2026). Les benchmarks communautaires via Spark-Bench et Spark Arena montrent des gains de 10 à 15 % sur les modèles 70B+ en génération.
Dual RTX 3090 : la bête de somme du pauvre ?
Face au Spark, la configuration Dual RTX 3090 est le choix historique des passionnés. Deux cartes offrent 48 Go de VRAM cumulée (24 Go chacune), une bande passante mémoire de ~936 Go/s (par carte), et une puissance de calcul FP16 d’environ 70 TFLOPS. Le coût total d’une config complète (cartes d’occasion, alimentation 1 000 W+, carte mère, boîtier) tourne autour de 3 500 $.
Mais les contraintes sont réelles : bruit, chaleur, encombrement. Deux RTX 3090 en charge consomment 650 à 700 W, nécessitent un refroidissement actif bruyant et un boîtier spacieux. Le tensor parallelism logiciel (via llama.cpp ou vLLM) est indispensable pour répartir le modèle entre les deux GPU, ajoutant une couche de complexité. En pratique, pour Llama 70B Q4_K_M, les performances mesurées sont de 14 tokens/s (GIGAGPU) à 10–15 tokens/s (CraftRigs) – soit environ 40 % de moins que le DGX Spark.
| Configuration | Llama 70B Q4_K_M (tok/s) | Consommation (W) | Prix estimé (neuf/occasion) |
|---|---|---|---|
| DGX Spark | 22 – 23 | 140 | 4 699 $ |
| Dual RTX 3090 | 10 – 15 | 650 – 700 | 3 500 $ (occasion) |
Une variante intéressante : passer à trois RTX 3090 (72 Go VRAM) porte la génération à 124 tokens/s sur GPT-OSS 120B (source AIMultiple, juin 2026). Mais le coût (≈ 4 500 $) et la consommation (≈ 1 050 W) explosent, et le Spark reste plus simple à déployer.
Benchmarks : Llama 70B à l’épreuve du feu
Les données disponibles permettent une comparaison fiable pour Llama 3.1 70B en quantification Q4_K_M. Le DGX Spark, grâce à sa mémoire unifiée et à ses cœurs Blackwell optimisés pour l’inférence FP4, surpasse nettement la configuration Dual RTX 3090 en vitesse de génération : ~22 tok/s contre ~14 tok/s. En évaluation de prompt, l’écart est encore plus marqué, mais les benchmarks ne fournissent pas de chiffres homogènes pour ce modèle précis.

Depuis juillet 2026, les nouveaux modèles open-weight changent la donne. Ant Ling-3.0-Flash 124B-A5B (annoncé le 23 juillet 2026 sur les forums NVIDIA) est un MoE à attention hybride (KDA et MLA, ratio 5:1) avec 5B paramètres actifs par token, 256K tokens de contexte (extensible à 1M). Les premiers tests non officiels estiment un débit de 15-20 tokens/s sur DGX Spark – remarquable pour un modèle de cette taille qui bat leur précédent modèle 1T sur presque tous les benchmarks. Poolside Laguna S 2.1 (118B, sorti le 23 juillet 2026) se positionne comme la meilleure open-weight occidentale pour le codage agentique, et tient dans les 128 Go unifiés du Spark (habr.com, ai-stat.ru).
Mais la grande nouveauté de l’été, c’est DeepSeek V4 Flash 0731, sorti le 31 juillet 2026. Avec seulement 13 milliards de paramètres actifs par token (sur ~200B totaux), ce modèle MoE offre des performances agentiques de niveau frontière — Cybergym 76.7, DeepSwe 54.4, NL2Repo 54.2, Terminal Bench 2.1 82.7 — tout en étant 10× plus petit que Claude Opus en paramètres actifs (flowtivity.ai). Sur un DGX Spark unique, il atteint 30 tok/s en configuration standard, et un simple changement de config (détaillé sur les forums NVIDIA) permet de remonter l’acceptance à des niveaux bien supérieurs. En quantification Q8 (UD-Q8_K_XL, 162 Go), il dépasse les 128 Go du Spark seul — il faut alors un cluster de 2 machines, comme nous le verrons plus loin.
Le test de Clubic (16 juillet 2026) est édifiant : pendant six semaines, un journaliste a remplacé Claude, Codex et Gemini par un DGX Spark à 4 500 €, avec sept modèles testés. Verdict : pour les tâches de codage et de rédaction, le Spark couvre 80 % des besoins, avec des temps de réponse acceptables (2-5 s pour des requêtes simples, 10-20 s pour des générations longues).
Coût total de possession : au-delà du prix d’achat
L’écart de prix d’achat (1 200 $ en faveur du Dual RTX 3090) se réduit quand on intègre la consommation électrique sur trois ans. Hypothèses : utilisation intensive 8 heures par jour, 365 jours par an, tarif électrique 0,12 $/kWh.
| Poste | DGX Spark | Dual RTX 3090 |
|---|---|---|
| Prix d’achat | 4 699 $ | 3 500 $ |
| Consommation (W) | 140 | 700 |
| Électricité sur 3 ans (8h/j) | 140 × 8 × 365 × 3 × 0,12 / 1 000 = 147 $ | 700 × 8 × 365 × 3 × 0,12 / 1 000 = 736 $ |
| Refroidissement / maintenance | Négligeable | Ventilateurs, pâte thermique : ~50 $ |
| Total sur 3 ans | 4 846 $ | 4 286 $ |
L’écart se resserre à moins de 600 $. Si l’usage est plus intensif (24h/24, batch processing), le Spark devient même moins cher au bout de deux ans. En coût par token, le Spark est plus économique : pour 1 million de tokens générés, il consomme ~0,03 $ d’électricité contre ~0,16 $ pour le Dual RTX 3090.
Face au cloud, l’analyse est encore plus favorable : selon les calculs du magazine (juillet 2026), un DGX Spark utilisé 8 h/jour pendant 3 ans revient à environ 0,55 $/heure d’utilisation effective, contre 1,50 à 3 $/heure pour une instance cloud équivalente (A100 ou H100 partagée). Pour les données sensibles (santé, juridique, R&D), le local devient même une obligation réglementaire dans certains secteurs.
L’écosystème logiciel : la grande mue de 2026
Le DGX Spark tourne sous DGX OS, une distribution Ubuntu 24.04 customisée avec la stack NVIDIA préinstallée (CUDA, cuDNN, TensorRT). L’inférence est immédiate via Ollama ou llama.cpp. Le fine-tuning LoRA/QLoRA est possible : des tutoriels (sanjaysays.com, GitHub) montrent comment fine-tuner Mistral 7B en 2 heures, ou Llama 70B avec QLoRA en environ 12 heures sur le Spark.
La mise à jour de juillet 2026 (forums NVIDIA, 14 juillet) a apporté des améliorations majeures :
- Gestion mémoire améliorée : réduction des OOM sur les très grands contextes, meilleure allocation dynamique
- CUDA 13.x optimisé pour GB10 : gains de 10-15 % en génération sur les modèles 70B+
- TensorRT-LLM optimisé GB10 : support natif NVFP4 et décodage spéculatif amélioré
Fine-tuning BF16 : l’exploit d’un 35B sur un seul Spark
La grande nouveauté de l’été 2026, c’est le fine-tuning en BF16 sur un seul DGX Spark. Grâce à la mémoire unifiée de 128 Go et aux optimisations logicielles, il est désormais possible de fine-tuner un modèle de 35 milliards de paramètres en BF16 complet sur une seule machine — un exploit qui nécessitait auparavant plusieurs GPU professionnels. Les détails techniques (gradient checkpointing, offloading, batch size adaptatif) sont documentés sur les forums NVIDIA et dans le dépôt bidual/awesome-dgx-spark (DeepWiki, 12 août 2026).
Pour les modèles plus petits, le LoRA/QLoRA reste la voie royale : Mistral 7B se fine-tune en 2 heures, Llama 70B en QLoRA en environ 12 heures. Mais le BF16 natif ouvre des perspectives nouvelles pour l’adaptation de modèles de taille moyenne sans perte de précision.
La chaîne qui tient : application → LiteLLM → llama-swap → moteur
En septembre 2026, la stack recommandée par la communauté est mature : une application cliente (Claude Code, Continue, Open WebUI) dialogue avec LiteLLM, qui route vers llama-swap, lequel bascule dynamiquement entre les moteurs (vLLM, llama.cpp, Ollama, SGLang) selon le modèle chargé. Cette architecture permet de servir plusieurs modèles sur un seul Spark sans rechargement, et de profiter des forces de chaque moteur (vLLM pour le batch, llama.cpp pour la simplicité, SGLang pour les très longs contextes).
vLLM, llama.cpp, Ollama, SGLang : le match sur ARM64
Tous les moteurs majeurs sont désormais compilés nativement pour ARM64/GB10. vLLM 0.25+ est la référence pour le serving multi-utilisateurs et le batch ; llama.cpp reste le plus simple pour un usage mono-utilisateur ; Ollama offre l’expérience la plus « plug-and-play » ; SGLang excelle sur les très longs contextes (1M tokens) grâce à son scheduler optimisé. Les benchmarks communautaires de septembre 2026 montrent que vLLM et SGLang dominent en débit, tandis que llama.cpp et Ollama sont plus légers en mémoire.
Clusters DGX Spark : 2, 4, 8 nœuds, le réseau qui change tout
Le talon d’Achille du Spark a longtemps été son réseau : un simple lien 10GbE (1,25 Go/s théorique) qui plafonnait les performances multi-nœuds. Les annonces initiales évoquaient 100 GbE, mais la réalité matérielle est plus modeste. En 2026, la situation a évolué : les clusters de 2 nœuds utilisent un lien QSFP 200 Gb/s (25 Go/s), et les configurations à 4 ou 8 nœuds exploitent des topologies en étoile ou en anneau.
Cluster 2 nœuds : le duo qui débloque les 256 Go
Avec deux DGX Spark reliés par QSFP 200 Gb/s, on dispose de 256 Go de mémoire agrégée. C’est la configuration minimale pour faire tourner DeepSeek V4 Flash 0731 en Q8 (162 Go) avec de la marge pour le contexte. Les tests de la communauté (forums NVIDIA, 2 août 2026) montrent des performances impressionnantes : 1 000 tok/s en prefill et 59 tok/s en serving multi-agents sur un cluster 2× Spark avec DeepSeek V4 Flash 0731. L’article de flowtivity.ai (2 août 2026) détaille comment 13B de paramètres actifs changent la donne pour les agents IA privés : le KV-cache et le scheduling deviennent les facteurs limitants, pas le calcul.
Cluster 4 et 8 nœuds : le supercalculateur de poche
Les configurations à 4 et 8 nœuds sont documentées par la communauté (forums NVIDIA, septembre 2026). Avec 4 nœuds (512 Go agrégés), on peut servir des modèles jusqu’à 400B en FP4, ou faire tourner plusieurs modèles en parallèle. Avec 8 nœuds (1 To agrégé), les possibilités s’étendent aux très grands MoE comme DeepSeek V4 Pro (865 Go en FP4). Le réseau devient le facteur critique : les topologies en étoile (switch central) sont recommandées pour 4+ nœuds, avec des câbles approuvés comme l’Amphenol NJAAKK-N911 (400 mm, 32 AWG).
Désagrégation : spécialiser chaque nœud
Une tendance émergente de 2026 est la désagrégation matérielle : plutôt que de traiter tous les nœuds de manière identique, on spécialise chaque Spark — un nœud pour le prefill (calcul intensif), un pour la génération (latence faible), un pour le fine-tuning, un pour le stockage. Cette approche, documentée dans les articles du magazine, permet d’optimiser l’utilisation de chaque machine et de réduire la contention réseau.
Les modèles qui tournent vraiment sur GB10 en septembre 2026
DeepSeek V4 Flash 0731 : le nouveau roi du Spark
Confirmé officiellement le 31 juillet 2026 sur Hugging Face (dépôt deepseek-ai/DeepSeek-V4-Flash-0731), ce modèle MoE de 284 milliards de paramètres totaux avec 13 milliards actifs par token est la nouvelle référence pour l’inférence locale. Ses caractéristiques :
- Contexte : 1 million de tokens (le plus long du marché open-weight)
- Poids mixtes FP4 + FP8 avec module DSpark (décodeur spéculatif fusionné)
- Poids totaux : 167 Go (48 fichiers safetensors, relevé du 2 septembre 2026)
- vLLM 0.25+ requis (conteneurs NVIDIA NGC arm64)
Sur un Spark unique, il atteint 30 tok/s en configuration standard (forums NVIDIA, 31 juillet 2026), et un simple changement de config permet de remonter l’acceptance à des niveaux bien supérieurs. En Q8 (UD-Q8_K_XL, 162 Go), il dépasse les 128 Go du Spark seul — il faut alors un cluster de 2 machines. Le guide complet de QDNA (mis à jour le 2 septembre 2026) détaille la procédure pour DGX Spark, cluster 2× Spark et DGX Station GB300.
Ant Ling-3.0-Flash 124B-A5B : le MoE hybride
Sorti le 23 juillet 2026, ce modèle d’Ant Group est un MoE à attention hybride (KDA et MLA, ratio 5:1) avec 5B paramètres actifs par token, 256K tokens de contexte natif (extensible à 1M). Il bat leur précédent modèle 1T sur presque tous les benchmarks, et tourne à 15-20 tok/s sur un Spark unique (forums NVIDIA, 23 juillet 2026).
Poolside Laguna S 2.1 : la réponse occidentale
Également sorti le 23 juillet 2026, Laguna S 2.1 (118B) est présenté comme la meilleure open-weight occidentale pour le codage agentique. Il tient dans les 128 Go unifiés du Spark et se positionne comme le premier grand modèle open-weight américain depuis 11 mois (habr.com, ai-stat.ru).
GPT-OSS 120B : le vétéran toujours performant
Le modèle open-weight de NVIDIA (117B, 65 Go en MXFP4) reste une valeur sûre : 1 159-1 723 tok/s en prefill, 38-57 tok/s en génération selon les configurations. C’est le modèle de référence pour les benchmarks communautaires.
Comparaison avec les alternatives : Mac Studio M5 Ultra, AMD Strix Halo, RTX 5090
Mac Studio M5 Ultra vs DGX Spark
Le Mac Studio M5 Ultra (512 Go de mémoire unifiée) reste le monolithe de la mémoire massive, mais son écosystème Metal/MLX est moins flexible que CUDA. En septembre 2026, le DGX Spark le surpasse en tokens/s sur les modèles 70B+ grâce à ses optimisations FP4, mais le Mac Studio garde l’avantage pour les très grands contextes (512 Go permettent de charger des modèles jusqu’à 400B en FP16).
AMD Ryzen AI Halo (Strix Halo) : le concurrent x86
Le mini-PC AMD Ryzen AI Max+ « Strix Halo » (128 Go LPDDR5X, 256 Go/s, 16 cœurs Zen 5, Radeon 8060S) est le principal rival du Spark à 3 999 $ (2 To SSD). Il offre 34 tok/s sur GPT-OSS 120B (juin 2026) et supporte Windows 11 + Linux, mais pas CUDA (ROCm 7.2.2 à la place). Pour les développeurs qui dépendent de Claude Code ou d’outils x86, Strix Halo peut être plus pertinent — mais l’écosystème CUDA du Spark reste un avantage décisif pour l’IA.
RTX 5090 : la carte graphique grand public
Une RTX 5090 (32 Go VRAM) ne peut pas charger les modèles 70B+ en entier — il faut du offloading CPU, ce qui dégrade fortement les performances. Le Spark, avec ses 128 Go unifiés, est dans une catégorie différente.
Conclusion : le DGX Spark en septembre 2026, un an après
Un an après son lancement, le DGX Spark a tenu ses promesses, avec quelques réserves. Les mises à jour logicielles de l’été 2026 (gestion mémoire, CUDA 13.x, TensorRT-LLM) ont apporté des gains de 10-15 % sur les modèles 70B+, et l’arrivée de modèles comme DeepSeek V4 Flash 0731 a transformé ce que la machine peut faire tourner. Le clustering multi-nœuds est enfin opérationnel, avec des performances impressionnantes en 2× Spark (1 000 tok/s en prefill).
Le rapport qualité-prix face au Dual RTX 3090 reste serré, mais le Spark gagne sur la consommation, la simplicité et l’écosystème logiciel. Face au cloud, il est imbattable pour les données sensibles et l’usage intensif. Le fine-tuning BF16 d’un 35B sur un seul Spark est un exploit qui n’était pas imaginable il y a un an.
Reste la question du prix : à 4 699 $, le Spark n’est plus une machine de hobbyiste. Mais pour les développeurs et les petites équipes qui veulent de l’IA locale sérieuse, il n’a pas d’équivalent en 2026.
Sources
- NVIDIA DGX Spark — page officielle
- QDNA — DeepSeek V4 Flash 0731 sur DGX Station et cluster 2× DGX Spark (vLLM)
- Flowtivity — DeepSeek V4 Flash 0731 on Dual DGX Spark
- Forums NVIDIA — 1x Spark: DeepSeek-V4-Flash-0731 @ 1,000 tok/s prefill, 59 tok/s multi-agent serving
- Forums NVIDIA — DeepSeek-v4-Flash-0731-DSpark-1M-NVFP4-KV-2x-DGX-Spark
- Forums NVIDIA — Agent Serving on 2× DGX Spark with DeepSeek V4 Flash 0731
- Forums NVIDIA — Ant Ling-3.0-Flash 124B-A5B
- DeepWiki — bidual/awesome-dgx-spark (fine-tuning)
- DeepWiki — emiluzelac/deepseek-v4-flash-0731-on-one-dgx-spark
- Glukhov.org — NVIDIA DGX Spark vs Mac Studio vs RTX-4080
- StorageReview — NVIDIA DGX Spark : performances multipliées (CES 2026)
- OutilsIA — DGX Spark : 10 réglages IA locale
- Laurent Husser — DGX Spark : Le Test Ultime avec Ministral 3
- Habr — США пытаются отбить open source у Китая: вышла открытая модель Poolside Laguna S 2.1
- AI-Stat — Laguna S 2.1: Запад наконец ответил Китаю в open-weight
- AIMultiple — benchmarks DGX Spark
- Frandroid — test du DGX Spark Dell
- Generation-NT — annonce DGX Spark
- Clubic — test DGX Spark 6 semaines
- Minimachines — Nvidia DGX Spark : l’IA se miniaturise
Article recherché et rédigé automatiquement · Magazine Electrosens