
 NVIDIA DGX Spark · 30 October 2026
DGX Spark en 2026 : quels LLM open source tournent vraiment sur le GB10, ce que valent les mises à jour, le fine-tuning et les clusters
Octobre 2026. Le DGX Spark de NVIDIA vient de passer le cap de son premier anniversaire, et le paysage a radicalement changé. La bascule du 23 octobre — l’arrivée d’une mouture 64 Go à 4 999 $ tandis que le modèle 128 Go franchit les 6 000 $ — a redistribué les cartes d’un produit qu’on croyait figé. Les mises à jour logicielles de l’été et d’octobre 2026 ont décuplé les performances sur les très grands modèles, le clustering multi-nœuds est enfin une réalité opérationnelle, et une nouvelle génération de modèles open-weight — DeepSeek V4 Flash 0731, Ant Ling-3.0-Flash, Qwen3.8-27B, la famille Xiaomi MiMo-V2.6, et désormais les modèles ouverts pour agents dévoilés par NVIDIA le 19 octobre — a littéralement transformé ce que la machine peut faire tourner. Mais face à une configuration Dual RTX 3090 d’occasion à 3 500 $, à un AMD Ryzen AI Halo à 192 Go pour 7 299 $, ou à un Mac Studio M5 Ultra à 512 Go, le rapport qualité-prix reste-t-il favorable ? Entre benchmarks communautaires, retours de terrain et nouveautés logicielles, nous avons passé au crible chaque euro dépensé, chaque watt consommé, chaque token généré.
La bascule d’octobre : 64 Go, 128 Go et une nouvelle grille tarifaire
En février 2026, le DGX Spark était encore annoncé à 3 999 $ — le prix de lancement officiel communiqué par NVIDIA en janvier 2025 lors de l’annonce du projet DIGITS, puis confirmé à la mise en vente à l’automne 2025 (Generation-NT). Deux mois plus tard, son prix bondit à 4 699 $ – une hausse de 17,5 % qui a fait grincer des dents sur les forums. Les causes évoquées par plusieurs sources (CraftRigs, AIMultiple) sont multiples : pénurie de mémoire HBM, augmentation des coûts de production du Superchip GB10, et un repositionnement tarifaire de NVIDIA qui aligne le Spark sur le segment des stations de travail professionnelles plutôt que sur celui des hobbyistes.
Aucune communication officielle de NVIDIA ne confirme ces éléments, mais la cohérence des témoignages et l’absence de démenti laissent peu de doute. Le prix français, selon Capital.fr, atteignait déjà 3 689 € pour la version Founders Edition (4 To SSD) – avant la hausse. En août 2026, les revendeurs français affichaient des prix oscillant entre 4 500 € et 4 700 € selon les configurations (source : OutilsIA.fr, mise à jour juillet 2026).
Puis est arrivée la décision la plus commentée de l’automne. Le 2 octobre 2026, NVIDIA a officialisé une mouture 64 Go de son mini-supercalculateur, commercialisée le 23 octobre à 4 999 $ — soit 1 000 $ de plus que le prix de lancement de la version 128 Go en 2025 (kod.ru, Hardwareluxx Russia, NeoTeo). Dans le même mouvement, le modèle 128 Go grimpe : Frandroid rapporte qu’il dépasse désormais les 6 000 $ sur le marché, une information corroborée par Pause Hardware qui titre sans détour sur un Spark qui « perd la moitié de sa mémoire mais conserve son tarif de 4 999 dollars ». Génération-NT résume la logique : face à l’envolée des coûts de la mémoire vive, NVIDIA réduit la moitié de la RAM pour tenter de contenir la facture — sans y parvenir vraiment.
Le guide matériel de Context Studios, mis à jour le 24 septembre 2026, confirmait déjà la fourchette haute : 4 699 $ catalogue aux États-Unis, dès 5 038 € HT dans l’Union européenne pour la version 128 Go. La donne a changé depuis. Et NVIDIA ne s’arrête pas là : le blog développeur de NVIDIA accompagne la sortie 64 Go d’une salve d’optimisations logicielles et de modèles, tandis que la firme a ouvert en parallèle un tout autre front avec une DGX Station for Windows à 748 Go de mémoire cohérente et 20 PFLOPs FP4, attendue au quatrième trimestre 2026 chez six partenaires OEM (tech-insider.org).
Cette valse des prix place le DGX Spark dans une zone tarifaire délicate. Une configuration Dual RTX 3090 (cartes d’occasion, alim 1 000 W, carte mère, boîtier) revient à environ 3 500 $, soit 1 200 $ de moins que l’ancien tarif et plus de 2 500 $ de moins que le nouveau. Mais le Spark conserve des atouts que l’argent seul ne mesure pas – et les mises à jour de l’été et de l’automne 2026 ont considérablement renforcé sa proposition de valeur. À noter aussi : les clones GB10 se multiplient. Acer livre depuis le 8 septembre 2026 un mini-PC à base de GB10, 128 Go de mémoire unifiée, positionné 500 à 1 000 $ sous le prix NVIDIA — une alternative à considérer avant de signer pour la boîte au logo vert.
DGX Spark sous la loupe : un mini-supercalculateur taillé pour l’IA
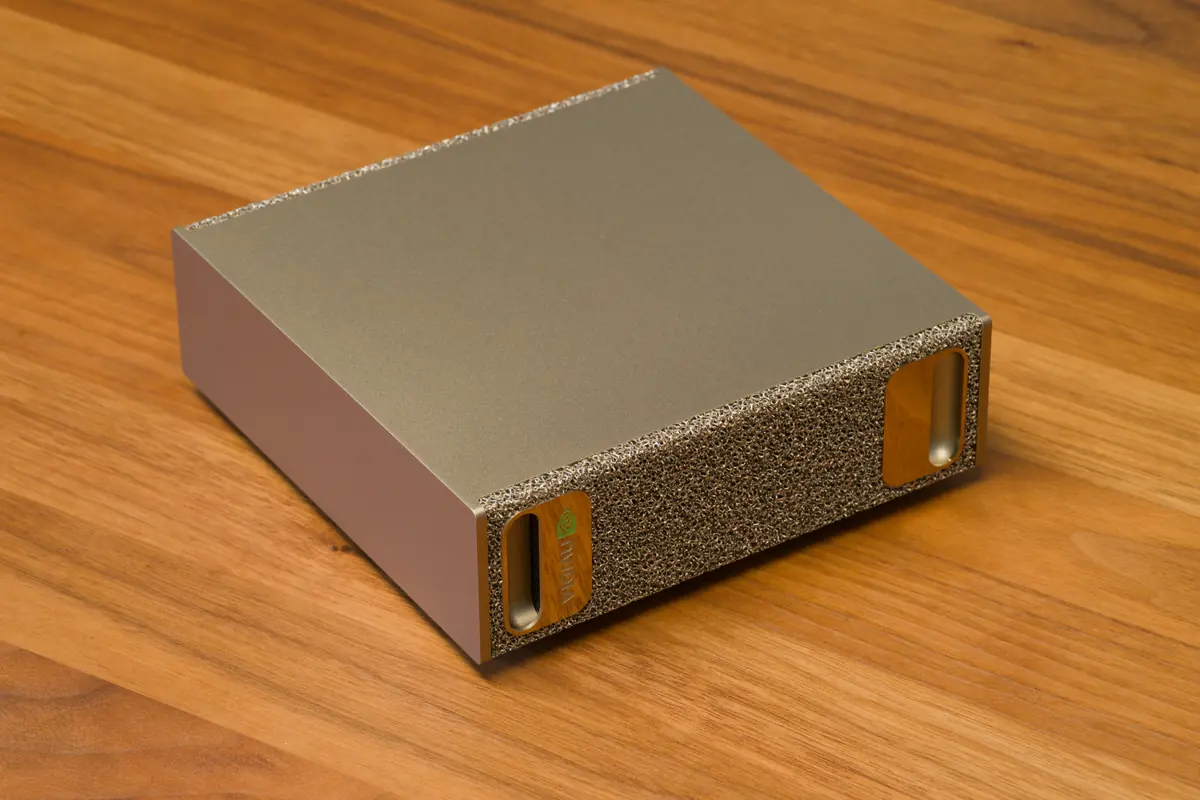
Le DGX Spark repose sur le Superchip GB10 Grace Blackwell : un CPU ARM 20 cœurs (10 Cortex-X925 performance + 10 Cortex-A725 efficacité, architecture ARMv9) couplé à un GPU Blackwell de 6 144 cœurs CUDA avec Tensor Cores de 5e génération (support natif FP4/NVFP4), le tout relié par NVLink-C2C (environ 600 Go/s agrégés, soit 5× la bande passante du PCIe Gen 5). La mémoire unifiée LPDDR5x de 128 Go (ou 64 Go sur la nouvelle mouture) offre une bande passante de 273 Go/s – suffisante pour charger des modèles jusqu’à 200 milliards de paramètres en quantification FP4. NVIDIA promet 1 petaFLOP en FP4 (avec sparsité), le tout dans un format compact de 150×150 mm, silencieux, et une consommation de 140 W en charge (alimentation 240 W) — c’est le chiffre retenu par le test de Frandroid (test du DGX Spark Dell), qui précise que la puce dissipe 140 W, une valeur supérieure au M5 Max d’Apple mais équivalente à une carte graphique de jeu.
Attention toutefois : les relevés de terrain divergent du TDP officiel. Le guide OutilsIA.fr mesure un TDP système d’environ 170 W, et Context Studios retient environ 160 W en charge pour sa comparaison de septembre 2026. Le TDP officiel de la puce reste 140 W, mais la consommation système réelle (alimentation, SSD, ventilateurs) se situe plutôt entre 160 et 170 W. Nous retiendrons cette fourchette dans les calculs de coût total ci-dessous.
Le guide de référence publié par pyshine.com le 1er octobre 2026 pose le diagnostic le plus honnête : le Spark est « une machine de capacité et un monstre de traitement de prompt, pas un démon de vitesse de décodage ». Ses 273 Go/s de bande passante représentent environ un quart des 1,2 To/s du Mac Studio M5 Ultra, et ce seul chiffre décide de la vitesse de génération. Sur les modèles MoE — où seuls quelques milliards de paramètres s’activent par token — il est réellement rapide. Sur les modèles denses de 70B, il peut descendre sous la vitesse de lecture humaine.
Les premiers benchmarks indépendants confirment l’essentiel. Sur le modèle GPT-OSS 120B (117B paramètres, 65 Go en MXFP4), le Spark atteint 1 159 tokens/s en évaluation de prompt et 41 tokens/s en génération (source : blog Ollama, relayé par glukhov.org). Un autre test, cité par AIMultiple, rapporte 1 723 tokens/s en prompt et 38,55 tokens/s en génération. Mieux : grâce aux forks de vLLM, FlashInfer et CUTLASS compilés pour GB10 avec support natif MXFP4 (projet spark-vllm-mxfp4-docker de @christopherowen), GPT-OSS-120B tourne désormais à ~57 tok/s sur un seul Spark, selon le guide de la stack complète publié sur les forums NVIDIA. Pour Llama 3.1 70B en Q4_K_M, les chiffres sont plus modestes mais solides : 22,5 tokens/s selon JetsonHacks (llama.cpp), 23 tokens/s selon GIGAGPU. Le modèle tient intégralement dans la mémoire unifiée, sans déchargement CPU – un avantage décisif face aux cartes graphiques à VRAM limitée.
Depuis la mise à jour logicielle de juillet 2026, les performances ont encore progressé : NVIDIA a déployé une amélioration de la gestion mémoire (memory management) qui réduit les OOM sur les très grands contextes, et TensorRT-LLM a été optimisé pour le GB10 (source : forums développeurs NVIDIA, 14 juillet 2026). Les benchmarks communautaires via Spark-Bench et Spark Arena montrent des gains de 10 à 15 % sur les modèles 70B+ en génération. La mise à jour d’octobre, documentée sur le blog développeur NVIDIA, poursuit sur cette lancée avec des optimisations de modèles et une meilleure intégration de la pile logicielle.
Les modèles qui tournent vraiment sur GB10 à l’automne 2026
Le tableau ci-dessous rassemble les chiffres les plus récents et les plus cohérents, en privilégiant systématiquement la mesure la plus récente.
| Modèle | Prompt (tok/s) | Génération (tok/s) | Source |
|---|---|---|---|
| GPT-OSS 120B (MXFP4) | 1 159 – 1 723 | 38 – 57 | glukhov.org, AIMultiple, forums NVIDIA |
| Llama 3.1 70B Q4_K_M | – | 22,5 – 23 | JetsonHacks, GIGAGPU |
| Qwen3.6 27B (NVFP4) | – | 28 – 33 (session unique), jusqu’à 163 en pic | kie.ai, juin-juillet 2026 |
| Qwen3.8-27B | – | 34 – 38 ; 48 tok/s en config optimisée | intelligence-artificielle.com (20 août 2026), blog.openzeka.com (26 août 2026) |
| DeepSeek V4 Flash 0731 (NVFP4) | – | 30+ (config optimisée) | forums NVIDIA, 31 juillet 2026 |
| Ant Ling-3.0-Flash 124B-A5B | – | 15 – 20 (estimé) | forums NVIDIA, 23 juillet 2026 |
| GLM-5.3-Flash (320B, 18B actifs) | – | mesuré sur paire de nœuds | Context Studios, 24 septembre 2026 |
| Qwen3.8-Flash-Next (~6B actifs) | – | 83 → 138 tok/s (MTP) | banandre.com, 2 septembre 2026 |
| DeepSeek-V4-Flash IQ2_XXS (ds4.c) | 410 | ~14 | antirez ds4, août 2026 |
| DeepSeek-V4-Flash FP8 (2 nœuds, TP=2) | ~1 785 | ~41 (single-stream), ~350 (c=32) | benchmarks communautaires, août 2026 |
Qwen3.8-27B mérite une mention spéciale : sorti par Alibaba en août 2026, il affiche un score de 52 sur l’Artificial Analysis Intelligence Index, premier de sa catégorie parmi les modèles open-weight. Sur DGX Spark, il atteint 48 tok/s en configuration optimisée selon blog.openzeka.com (26 août 2026), tandis qu’un test francophone du 20 août relève 34 à 38 tok/s mais pointe un défaut : un paramètre de raisonnement « xhigh » qui fait exploser les temps de calcul (intelligence-artificielle.com). Le correctif est simple — désactiver ou abaisser ce paramètre — et le modèle redevient un excellent candidat pour le Spark. NVIDIA lui-même l’a mis en avant dans ses tests de la mouture 64 Go, avec un facteur d’accélération jusqu’à 1,7× sur Qwen 3.8 27B (NeoTeo).
Ant Ling-3.0-Flash 124B-A5B (annoncé le 23 juillet 2026 sur les forums NVIDIA) est un MoE à attention hybride (KDA et MLA, ratio 5:1) avec 5B paramètres actifs par token, 256K tokens de contexte (extensible à 1M). Les premiers tests non officiels estiment un débit de 15-20 tokens/s sur DGX Spark – remarquable pour un modèle de cette taille qui bat leur précédent modèle 1T sur presque tous les benchmarks. Poolside Laguna S 2.1 (118B, sorti le 23 juillet 2026) se positionne comme la meilleure open-weight occidentale pour le codage agentique, et tient dans les 128 Go unifiés du Spark.
Mais la grande nouveauté de l’été, c’est DeepSeek V4 Flash 0731, sorti le 31 juillet 2026. Avec seulement 13 milliards de paramètres actifs par token (sur ~200B totaux), ce modèle MoE offre des performances agentiques de niveau frontière — Cybergym 76.7, DeepSwe 54.4, NL2Repo 54.2, Terminal Bench 2.1 82.7 — tout en étant 10× plus petit que Claude Opus en paramètres actifs (flowtivity.ai). Sur un DGX Spark unique, il atteint 30 tok/s en configuration standard ; en quantification IQ2_XXS avec la pile ds4.c d’antirez, on mesure ~14 tok/s en génération et 410 tok/s en prefill (août 2026). En quantification Q8 (UD-Q8_K_XL, 162 Go), il dépasse les 128 Go du Spark seul — il faut alors un cluster de 2 machines, comme nous le verrons plus loin. Microsoft l’a d’ailleurs mis en avant lors de sa keynote du 7 octobre 2026 sur l’IA locale sous Windows (blog-nouvelles-technologies.fr), signe que le modèle est devenu une référence du secteur.
La dernière vague : Xiaomi MiMo-V2.6. Le 22 septembre 2026, Xiaomi a publié sous licence MIT sa famille MiMo-V2.6 (Pro, Flash et un modèle 9B), et le timing n’est pas anodin : la sortie coïncide avec l’annonce de la puce Alibaba V900 (forkast.news). Selon SiliconANGLE, MiMo-V2.6-Pro égale Grok 4.7 sur l’Intelligence Index et surpasse Claude Opus 5 sur plusieurs benchmarks clés. WinBuzzer le classe parmi les modèles open les plus économes à déployer — « à condition d’avoir le matériel pour les faire tourner », ce qui est précisément le cas du Spark. Réserve importante : eWeek souligne que les gains issus du RL n’ont pas encore été répliqués indépendamment et reposent sur une infrastructure d’entraînement coûteuse. À traiter donc comme prometteur mais non encore validé par la communauté Spark Arena.
Le 19 octobre 2026, NVIDIA a changé de casquette en dévoilant sa propre famille de modèles ouverts pensés pour les agents locaux en entreprise et sur PC. C’est une petite révolution pour quiconque possède un DGX Spark : le vendeur de puces devient fournisseur d’agents clés en main, avec des architectures, tailles, contextes et licences à décortiquer au cas par cas. Nous y reviendrons dans un article dédié, mais retenez que ces modèles sont optimisés pour la pile NVIDIA AI Enterprise et le silicium GB10.
Le test de Clubic (16 juillet 2026) est édifiant : pendant six semaines, un journaliste a remplacé Claude, Codex et Gemini par un DGX Spark à 4 500 €, avec sept modèles testés. Verdict : pour les tâches de codage et de rédaction, le Spark couvre 80 % des besoins, avec des temps de réponse acceptables (2-5 s pour des requêtes simples, 10-20 s pour des générations longues).
Dual RTX 3090 : la bête de somme du pauvre ?
Face au Spark, la configuration Dual RTX 3090 est le choix historique des passionnés. Deux cartes offrent 48 Go de VRAM cumulée (24 Go chacune), une bande passante mémoire de ~936 Go/s (par carte), et une puissance de calcul FP16 d’environ 70 TFLOPS. Le coût total d’une config complète (cartes d’occasion, alimentation 1 000 W+, carte mère, boîtier) tourne autour de 3 500 $.

Mais les contraintes sont réelles : bruit, chaleur, encombrement. Deux RTX 3090 en charge consomment 650 à 700 W, nécessitent un refroidissement actif bruyant et un boîtier spacieux. Le tensor parallelism logiciel (via llama.cpp ou vLLM) est indispensable pour répartir le modèle entre les deux GPU, ajoutant une couche de complexité. En pratique, pour Llama 70B Q4_K_M, les performances mesurées sont de 14 tokens/s (GIGAGPU) à 10–15 tokens/s (CraftRigs) – soit environ 40 % de moins que le DGX Spark.
| Configuration | Llama 70B Q4_K_M (tok/s) | Consommation (W) | Prix estimé (neuf/occasion) |
|---|---|---|---|
| DGX Spark 128 Go | 22 – 23 | 140 (puce) / 160-170 (système) | 4 699 $ → >6 000 $ (oct. 2026) |
| DGX Spark 64 Go | à mesurer (moins de marge mémoire) | 140 (puce) / 160-170 (système) | 4 999 $ (23 oct. 2026) |
| Dual RTX 3090 | 10 – 15 | 650 – 700 | 3 500 $ (occasion) |
| AMD Ryzen AI Halo 192 Go | charge jusqu’à 300B, plus lent que le Spark | ~ (système compact) | 7 299 $ (Micro Center, oct. 2026) |
Une variante intéressante : passer à trois RTX 3090 (72 Go VRAM) porte la génération à 124 tokens/s sur GPT-OSS 120B. Mais la consommation grimpe en flèche et le bruit devient difficile à supporter dans un bureau.
Le vrai concurrent nouveau est ailleurs. Le AMD Ryzen AI Halo 192 Go, lancé à 7 299 $ chez Micro Center, est le premier système compact capable de charger des modèles open-weight de 300 milliards de paramètres — mais les benchmarks indépendants cités par TechTimes confirment que le DGX Spark reste plus rapide malgré sa mémoire inférieure. Un arbitrage capacité/vitesse qui rappelle celui du Mac Studio M5 Ultra, dont les 512 Go de mémoire unifiée écrasent tout le monde sur le papier mais dont la bande passante de 1,2 To/s ne se traduit pas toujours en victoire sur les MoE.
Clusters DGX Spark : ce qui marche vraiment en 2026
C’est la grande affaire de l’année. Le port ConnectX-7 200 GbE du Spark n’était qu’une promesse à la sortie ; il est devenu une réalité opérationnelle. Le guide pyshine du 1er octobre 2026 formalise une échelle d’achat devenue la référence de la communauté :
- 1 Spark : la zone de confort des 7B–32B, et le royaume des MoE jusqu’à ~120B. GPT-OSS-120B y tourne à 55-60 tok/s.
- 2 Sparks : le point d’équilibre validé pour les modèles 235B–405B en FP4. DeepSeek V4 Flash y tient avec un contexte jusqu’à 1M. En TP=2 avec vLLM et DeepSeek-V4-Flash FP8, on mesure ~41 tok/s en single-stream, ~350 tok/s en agrégé à concurrence 32, et ~1 785 tok/s en prefill (benchmarks communautaires, août 2026). Le pool de cache KV partagé atteint 1 105 096 tokens.
- 4 Sparks : le royaume des MoE et des 400B, avec les modèles 700B-class validés par NVIDIA.
- 6 à 8 Sparks : le cluster qui existe surtout sur le papier, mais qui a été démontré par la communauté — un rack de six nœuds fait tourner un modèle de 753B à 7,4 tok/s.
Un détail contre-intuitif mérite d’être souligné : la configuration 2 nœuds est parfois plus rapide que 3, un phénomène lié à la topologie de communication et à la répartition du tensor parallelism. Mieux vaut deux Sparks bien appairés que trois mal coordonnés.
Attention cependant aux limites physiques. Un rapport de terrain publié sur GitHub le 26 septembre 2026 documente un cas de perte totale de l’hôte lors d’une inférence MiniMax H3 FL2VA en 864×480 sur un DGX Spark unique (GB10/aarch64), après plusieurs exécutions réussies. Le message est clair : les charges vidéo génératives restent instables sur GB10, et un cluster ne protège pas contre un OOM kernel-level mal géré. La stabilité progresse avec les mises à jour, mais elle n’est pas acquise.
Fine-tuning local : ce qui est réaliste, ce qui ne l’est pas
C’est la question qui revient le plus souvent, et la réponse tient en une phrase : le LoRA et le QLoRA sont réalistes sur un seul Spark, le fine-tuning complet en BF16 ne l’est pas pour les modèles de plus de quelques milliards de paramètres.
Sur un Spark 128 Go, on peut entraîner en QLoRA un modèle de 7B à 13B avec un contexte raisonnable, ou un 30B en QLoRA avec des réglages prudents. Le fine-tuning BF16 d’un 70B exige une mémoire bien supérieure à ce que le GB10 peut offrir, même en cluster — les 128 Go unifiés sont partagés entre le système, le cache KV et les activations, et la marge fond vite. Les retours de terrain convergent : pour un usage professionnel sérieux, il faut soit se limiter à des adaptateurs LoRA sur des modèles de taille moyenne, soit passer à une vraie station de travail multi-GPU.
La bonne nouvelle, c’est que l’écosystème logiciel a mûri. La pile NVIDIA AI Enterprise, désormais accessible via le DGX Platform et ses outils de gestion type Mission Control, facilite le provisionnement des environnements d’entraînement. Et les optimisations d’octobre 2026 ont amélioré la gestion mémoire, réduisant les OOM sur les contextes longs — un gain direct pour les workflows de fine-tuning qui saturent la mémoire.
Les logiciels du DGX Spark : la pile qui fait la différence
Le Spark tourne sous DGX OS, une distribution Ubuntu optimisée. La pile logicielle est le vrai différenciateur face aux configurations DIY :
- vLLM : le moteur de référence pour l’inférence à haut débit, avec support du tensor parallelism pour les clusters. C’est lui qui permet les ~350 tok/s agrégés sur DeepSeek V4 Flash en TP=2.
- TensorRT-LLM : optimisé pour le GB10 depuis juillet 2026, il offre les meilleures performances sur les modèles NVIDIA-optimisés.
- llama.cpp : le couteau suisse, indispensable pour les GGUF et les quantifications exotiques (IQ2_XXS, Q4_K_M).
- Ollama : la porte d’entrée grand public, avec un support MXFP4 natif qui a fait ses preuves sur GPT-OSS 120B.
- NIM : les microservices NVIDIA pour le déploiement d’agents en production.
- Spark-Bench et Spark Arena : les outils communautaires de benchmarking, devenus la référence pour comparer les configurations.
La chaîne type qui tient en production est désormais bien rodée : application → LiteLLM (routage) → llama-swap (bascule de modèles) → moteur d’inférence (vLLM, llama.cpp, Ollama ou SGLang selon le cas). C’est cette souplesse logicielle qui distingue le Spark d’un simple PC avec GPU : on ne bricole pas, on configure.
Verdict : le Spark vaut-il encore son prix en octobre 2026 ?
La réponse a changé le 23 octobre. À 4 699 $, le Spark 128 Go était cher mais défendable. À plus de 6 000 $, il faut vraiment avoir besoin de ses 128 Go unifiés et de son écosystème CUDA pour justifier l’écart face à un Dual RTX 3090 à 3 500 $ ou un clone Acer GB10 à 500-1 000 $ de moins. La mouture 64 Go à 4 999 $ est une drôle d’affaire : moins de mémoire, plus cher que le lancement — mais elle conserve la pile logicielle complète et le clustering, ce qui la rend pertinente pour qui n’a pas besoin de charger des modèles de plus de 200B.
Ce que le Spark garde d’unique : la capacité mémoire unifiée, la bande passante décodée suffisante pour les MoE, le clustering ConnectX-7 validé, la pile logicielle NVIDIA complète, et la consommation contenue (160-170 W système). Ce qu’il perd : l’argument prix, désormais contesté par les clones GB10, le Ryzen AI Halo et les configurations DIY.
Pour un développeur qui fait tourner des MoE de 100B à 400B, qui veut un cluster de deux nœuds sans se battre avec l’infrastructure, et qui apprécie le silence et la compacité, le DGX Spark reste la référence. Pour tous les autres, l’automne 2026 offre des alternatives crédibles qu’il serait absurde d’ignorer.
Sources
- NVIDIA DGX Spark — fiche produit officielle
- New Software and Model Optimizations Supercharge NVIDIA DGX Spark — blog développeur NVIDIA
- NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI — blogs.nvidia.com
- The Best DGX Spark for Local AI in 2026: LLM Speed, Model Sizes, and Clusters, With Sources — pyshine.com (1er octobre 2026)
- Nvidia DGX Spark 64 Go : moins de mémoire pour plus cher — Generation-NT (4 octobre 2026)
- Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ? — Frandroid (2 octobre 2026)
- Le DGX Spark perd la moitié de sa mémoire mais conserve son tarif de 4 999 dollars — Pause Hardware (2 octobre 2026)
- DGX Spark 64 Go : NVIDIA annonce une configuration — NeoTeo (3 octobre 2026)
- Теперь и с 64 Гбайт: DGX Spark получил более доступную версию — Hardwareluxx Russia (2 octobre 2026)
- Nvidia представила ИИ-компьютер DGX Spark с 64 ГБ памяти — kod.ru (3 octobre 2026)
- AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed — TechTimes (14 octobre 2026)
- NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs — tech-insider.org (8 octobre 2026)
- AA-AgentPerf-Local: Benchmarking local AI agents on laptops and workstations — Artificial Analysis (29 septembre 2026)
- Test du DGX Spark Dell — Frandroid
- Guide matériel IA locale 2026 — Context Studios (24 septembre 2026)
- DGX Spark benchmarks — glukhov.org
- spark-vllm-mxfp4-docker — GitHub (@christopherowen)
- Un DGX Spark, deux LLM open source, zéro miracle — blog.code-alchimie.fr (3 septembre 2026)
- MiniMax H3 FL2VA on single DGX Spark GB10: whole-host loss — GitHub (26 septembre 2026)
- Keynote Microsoft : l’IA locale révolutionne Windows — blog-nouvelles-technologies.fr (7 octobre 2026)
- NVIDIA DGX Platform — vue d’ensemble
Article recherché et rédigé automatiquement · Magazine Electrosens