
 NVIDIA DGX Spark · 6 November 2026
LLM open source sur NVIDIA GB10 DGX Spark : NVFP4, PAIR, fine-tuning et clusters — le point complet à l’automne 2026
Le DGX Spark, ce mini-supercalculateur signé Nvidia, promet de mettre le fine-tuning de grands modèles à la portée d’un seul bureau. Un an et demi après son lancement, l’écosystème open-weight a basculé : Nemotron 3.5 Lightning (30B-A3B) est arrivé le 11 août 2026, Qwen3.8-27B a débarqué le 15 août, la famille MiMo-V2.6 de Xiaomi a été ouverte sous licence MIT le 22 septembre, et DeepSeek a retravaillé son V4-Flash en version 4.1. Mais l’automne 2026 a surtout été marqué par une salve de mises à jour décisives : la release logicielle d’octobre 2026 déployée le 21 octobre, l’arrivée en boutique de la DGX Spark 64 Go le 23 octobre à 4 999 $, un workflow edge documenté par NVIDIA le 30 octobre pour faire tourner Nemotron-3.5 Lightning sur cette même machine 64 Go, et les benchmarks indépendants d’AA-AgentPerf-Local publiés le 29 septembre. Entre NVFP4, clustering 4 nœuds, NemoClaw, routeur PAIR et décodage spéculatif, plongeons dans les entrailles du fine-tuning local le plus ambitieux de l’année.
Le DGX Spark, un an et demi après : la promesse tenue, et amplifiée
En mars 2025, Nvidia dévoilait le DGX Spark lors de la GTC : un mini PC à 3 999 $, embarquant l’architecture Grace Blackwell (CPU Grace + GPU Blackwell), 128 Go de mémoire unifiée et 4 To de stockage NVMe. L’ambition ? Offrir une station de travail IA capable de faire tourner des modèles à plusieurs centaines de milliards de paramètres – le tout sur un bureau, sans recourir au cloud. La fiche technique officielle, reprise par 3dvf, confirme jusqu’à 1 000 TOPS en FP4 et une capacité à gérer des modèles allant jusqu’à 200 milliards de paramètres, avec une interconnexion NVIDIA ConnectX pour relier deux systèmes.
Un an et demi plus tard, le constat est sans appel : la machine tient ses promesses, et l’écosystème logiciel a considérablement mûri. La mise à jour de juin 2026 a apporté trois piliers majeurs :
- NVFP4 : format de quantification propriétaire 4 bits qui défie FP8, réduisant l’empreinte mémoire des poids de moitié. Il est désormais supporté nativement par les principaux runtimes (vLLM, TensorRT-LLM) et par les poids de Nemotron 3.5, Qwen3.8-27B, Laguna S 2.1 et DeepSeek V4 Flash. Selon le blog NVIDIA, l’architecture Blackwell permet de compresser les modèles d’IA jusqu’à 70 % et d’augmenter les performances sans perdre l’intelligence.
- NemoClaw : agent de sécurité et d’optimisation qui gère les ressources en temps réel. Comme le détaille le blog NVIDIA, NemoClaw orchestre l’exécution d’agents IA locaux sur les RTX PCs et les DGX Spark, en surveillant la consommation mémoire, le cache KV et la latence.
- Clustering 4 nœuds : possibilité de connecter jusqu’à 4 DGX Spark en cluster pour des charges de travail plus lourdes (fine-tuning distribué, inférence parallélisée). Le guide de déploiement officiel de Nemotron 3 Ultra décrit précisément cette configuration avec vLLM, tensor parallelism, réseau RoCE et décodage spéculatif MTP (SparkDeploymentGuide).
La release d’octobre 2026 : le nouveau socle logiciel
Le fait le plus récent à retenir pour quiconque possède la machine est la mise à jour logicielle d’octobre 2026, dont le déploiement a commencé le 21 octobre, comme l’annonce le forum développeurs NVIDIA. Cette release s’applique aussi bien aux DGX Spark de NVIDIA qu’aux systèmes partenaires équipés du même superchip GB10 Grace Blackwell — un point important, car il aligne les machines Acer, ASUS et les autres sur la même base logicielle. C’est ce socle qui conditionne l’accès aux optimisations les plus récentes : support NVFP4 consolidé, intégration du décodage spéculatif MTP, et compatibilité avec les nouveaux poids publiés cet été et cet automne. Pour un déploiement en production locale, c’est la version à installer avant toute chose.
En septembre 2026, Nvidia avait déjà simplifié l’accès à l’IA locale sur ses GPU, y compris le DGX Spark. Comme le rapporte Wccftech le 3 septembre, la firme apporte des optimisations supplémentaires à vLLM et llama.cpp, et étend le support local aux GPU avec 24+ Go de VRAM – une aubaine pour les utilisateurs de RTX qui veulent reproduire l’expérience Spark sur du matériel plus classique. Le 5 septembre, StorageReview relevait qu’un firmware du DGX Spark ajoutait un certificat de démarrage Windows UEFI, signe que la gamme RTX Spark allait s’ouvrir à Windows dès octobre 2026.
Autre nouveauté logicielle passée relativement inaperçue : PAIR (Personal AI Router), un outil gratuit et open source lancé début septembre 2026 qui transforme des ordinateurs inactifs en mini data center IA personnel. Comme l’analyse ComputeLeap, PAIR route l’inférence à travers votre réseau domestique, avec le DGX Spark et les RTX Spark comme fournisseurs de calcul — une manière pour Nvidia de ménager son empire cloud-GPU tout en poussant le local.
La DGX Spark 64 Go : une nouvelle configuration qui change les arbitrages
Le 23 octobre 2026, NVIDIA a mis en boutique une DGX Spark 64 Go à 4 999 $ — soit, à sa sortie, plus cher que ne l’était la version 128 Go en 2025. kod.ru et NeoTeo confirment tous deux ce prix de lancement et le contexte : la flambée du coût de la mémoire vive a rebattu les cartes tarifaires. generation-nt.com résume l’arbitrage : « moins de mémoire pour plus cher, et toujours pour l’IA locale ». Dans le même temps, le modèle 128 Go a franchi les 6 000 dollars sur certains canaux.
Cette configuration 64 Go n’est pas qu’une mauvaise nouvelle : elle cible explicitement les modèles de 30 à 35 milliards de paramètres et les agents IA locaux, avec 1 pétaFLOP de calcul. C’est exactement le segment où Nemotron 3.5 Lightning et Qwen3.8-27B excellent. Mais elle impose un dimensionnement rigoureux : là où 128 Go laissent respirer le cache KV et les adaptateurs LoRA, 64 Go obligent à recourir à la quantification NVFP4 ou Q4 pour les modèles les plus lourds, et rendent le fine-tuning de gros modèles nettement plus contraint. Pour le fine-tuning LoRA/QLoRA, la version 128 Go reste le choix confortable ; pour l’inférence d’agents 30B, la 64 Go suffit — à condition d’accepter la facture.
Le matériel : ce que disent les tests indépendants
Côté matériel, les tests indépendants confirment les spécifications. Un test réalisé en novembre 2025 sur un DGX Spark Dell (source : mikihands.com) a permis de fine-tuner le modèle FLUX 1-dev (12 milliards de paramètres) avec LoRA :
| Paramètre | Valeur observée |
|---|---|
| Mémoire utilisée (continu) | ~71,4 Go |
| Consommation électrique crête | 89–90 W |
| Température stabilisée | 81–86 °C |
| Temps pour 1000 steps (40 images, 1024px) | ~8 heures |
| Temps moyen par étape | ~2,8 secondes |
La bande passante mémoire de 273 Go/s (confirmée par les tests DeepSeek sur les forums NVIDIA, par l’analyse de vLLM et par le test indépendant de haruni.net) reste l’arme secrète du GB10 : elle permet de charger l’intégralité des poids d’un modèle 30B en FP16 (~60 Go) sans se soucier de la séparation VRAM/RAM. Mais c’est aussi son plafond : 273 Go/s partagés entre CPU et GPU, contre plusieurs To/s sur un H100 de datacenter. Un benchmark indépendant de devtoolstack.mynewit.com a testé 17 LLM locaux sur GB10, confirmant que la machine excelle sur les modèles jusqu’à ~120B en quantification NVFP4.
Ce plafond de bande passante est précisément ce qui rend le décodage spéculatif stratégique sur cette machine : en faisant « parier » un petit modèle brouillon sur plusieurs tokens à la fois, on contourne en partie la limite de débit du décodage natif. Les releases récentes (MTP intégré, draft fusionné) exploitent cette voie, et la release d’octobre 2026 en facilite l’accès.
Nemotron 3.5 Lightning : le nouveau cheval de bataille des agents longue durée
La grande actualité de l’été 2026, c’est la sortie de Nemotron 3.5 Lightning (30B-A3B), publié par NVIDIA le 11 août 2026. Comme le détaille la documentation Unsloth, il s’agit d’un modèle MoE de raisonnement hybride ouvert de 30 milliards de paramètres, dont seulement 3 milliards actifs, conçu pour l’exécution de tâches à grand volume dans des agents longue durée : appels d’outils fréquents, validation des sorties, mise en forme des résultats et délégation à des sous-agents. Le blog développeur NVIDIA insiste sur ce positionnement : exécution rapide et précise de tâches spécialisées pour agents de longue durée.
Ses caractéristiques le rendent particulièrement adapté au GB10 :
- Empreinte mémoire réduite : 20 Go de RAM en quantification 4 bits (UD-Q4-K-XL), 33 Go en 8 bits. Sur les 128 Go unifiés du Spark, cela laisse une marge confortable pour le cache KV, les adaptateurs LoRA et l’OS ; sur la version 64 Go, cela reste largement jouable.
- Contexte jusqu’à 1 million de tokens, ce qui en fait l’un des modèles d’exécution ouverts les plus rapides et les plus précis de sa taille.
- Support jour zéro par Unsloth, avec des GGUF dynamiques disponibles sur Hugging Face.
NVIDIA recommande des paramètres d’inférence distincts selon l’usage : température = 0,6 et top_p = 0,95 en mode réflexion, température = 0,2 en mode instruction. Avec 3 milliards de paramètres actifs par jeton, le modèle est assez rapide pour des appels répétés tout au long de workflows d’agents longue durée — c’est précisément le profil de charge qui convient au Spark, taillé pour le small-batch plutôt que la forte concurrence.
Le workflow edge documenté par NVIDIA (30 octobre 2026) : c’est la preuve la plus concrète de l’adéquation entre Nemotron 3.5 Lightning et la machine. blockchain.news rapporte que NVIDIA a publié une procédure en ligne de commande pour faire tourner Nemotron-3.5 Lightning sur la DGX Spark 64 Go, avec benchmarks et résultats de décodage spéculatif à l’appui. Autrement dit : la configuration 64 Go, la plus récente et la moins chère, est officiellement validée pour le modèle phare de l’automne. C’est un signal fort pour les acheteurs qui hésitent entre 64 et 128 Go.
Le duel des 30B : OrcaRouter a comparé Nemotron 3.5 Lightning à Granite 4.2 30B, deux modèles open-weight de 30B sortis à quatorze jours d’intervalle avec des rôles presque opposés. Le verdict est clair : Nemotron 3.5 Lightning est « l’exécutant » — optimisé pour l’appel d’outils et l’orchestration d’agents — là où Granite 4.2 30B joue « le penseur ». Pour un déploiement sur DGX Spark orienté agents, le choix de NVIDIA s’impose.
À noter que la famille Nemotron 3 continue de vivre en parallèle : la page officielle NVIDIA Developer et les guides de déploiement référencent toujours les déclinaisons Nano (30B-A3,6B), Nano Omni (30B-A3B, multimodal vidéo/audio/image/texte), Super (120B-A12B) et Ultra (550B-A55B). Le rapport technique (arXiv:2512.20848) confirme l’architecture hybride : combinaison de couches Transformer, Mamba 2, attention groupée et routeur perceptron, avec seulement 10 % des paramètres actifs à chaque token. Attention toutefois : un test YouTube de septembre 2026 intitulé « Nemotron Super 120B isn’t practical on a DGX Spark » suggère que ce modèle, bien que supporté, peut s’avérer peu pratique en usage réel sur un seul nœud – le clustering est recommandé pour exploiter pleinement son potentiel.
Qwen3.8-27B : le dense frugal qui tient sur une seule carte
Sorti le 15 août 2026 selon OrcaRouter (34 en Intelligence, 68 en Code), Qwen3.8-27B est un modèle dense — et non un MoE — ce qui change la donne sur le plan du déploiement. Comme le résume Clore.ai, il s’agit d’un « dense VLM, une seule carte » : un modèle vision-langage qui tient sur un seul accélérateur, sans nécessiter de cluster.
Sur le DGX Spark, les chiffres relevés par astoik.ai sont parlants : 34 à 38 tokens/s en session unique (mesuré le 20 août 2026), ce qui en fait l’un des modèles les plus confortables à utiliser au quotidien sur le GB10. Les GGUF sont disponibles chez Unsloth, et le modèle s’inscrit dans une stratégie d’« IA frugale pour PME » — un agent local qui tourne en permanence sans facture cloud.
NVIDIA a d’ailleurs utilisé Qwen 3.8 27B comme cas d’école pour sa configuration 64 Go : NeoTeo rapporte que la firme détaille les tailles de modèles visées sur un ou deux systèmes, avec un test Qwen 3.8 27B jusqu’à 1,7 fois plus rapide. Un chiffre qui, lu à la lumière du décodage spéculatif, confirme que les optimisations logicielles récentes profitent d’abord aux modèles denses de cette taille.
Pour comparaison, son prédécesseur Qwen3.6-27B affichait des chiffres plus contrastés sur le Spark : 28-33 tokens/s en session unique, mais un pic de décodage à 163 tokens/s et surtout 136 tokens/s avec 10 agents en parallèle — un profil qui illustre bien la force du GB10 sur les charges multi-agents légères. La génération 3.8 consolide cette base avec un meilleur score de code (68 contre 34 en Intelligence sur l’index OrcaRouter).
Le contexte de septembre 2026 est également marqué par la sortie de Qwen3.8-Flash-Next avec support MTP (Multi-Token Prediction) : selon banandre.com, le décodage spéculatif intégré apporte un speedup de 1,67× sans perte de qualité, passant de 83 à 138 tok/s en GGUF. Une optimisation qui, transposée sur le Spark, promet de repousser encore le plafond de débit des modèles Qwen.
Xiaomi MiMo-V2.6 : l’outsider chinois qui rebat les cartes
Le 22 septembre 2026, Xiaomi a ouvert les poids de sa famille MiMo-V2.6 sous licence MIT — Pro, Flash et 9B. Comme le rapporte SiliconANGLE, il s’agit d’une introduction en fanfare qui place Xiaomi sur le terrain des laboratoires frontière. Forkast souligne que le MiMo-V2.6-Pro égale Grok 4.7 sur l’Intelligence Index et surpasse Claude Opus 5 sur certains benchmarks clés — le tout publié le même jour qu’une puce Alibaba V900, ce qui n’est pas un hasard.

Le contexte de transparence est notable : Forkast rapporte que Xiaomi a diffusé en direct un tableau de bord d’entraînement RL, avec un burn rate de 432 000 $/jour et un bond de 47 points sur les benchmarks. eWeek tempère toutefois : les gains RL manquent encore de réplication indépendante et reposent sur une infrastructure d’entraînement coûteuse. WinBuzzer résume l’enjeu : MiMo V2.6 Pro et Flash sont parmi les modèles ouverts les plus économiques à déployer — « si vous avez le matériel pour les faire tourner ».
C’est précisément là que le DGX Spark entre en jeu. Un modèle de classe 1T (les rumeurs évoquent une architecture de très grande taille) ne tiendra pas sur un seul nœud, mais les déclinaisons Flash et 9B sont, elles, des candidats crédibles au déploiement local sur GB10, notamment en NVFP4. La famille MiMo-V2.6 rejoint ainsi le catalogue open-weight qui compte vraiment sur le Spark à l’automne 2026.
Laguna S 2.1 et DeepSeek V4.1 : les autres pièces du puzzle open-weight
Le catalogue qui tourne réellement sur GB10 ne se limite pas aux têtes d’affiche. Laguna S 2.1 figure parmi les modèles dont les poids sont compatibles NVFP4 selon le blog NVIDIA, ce qui en fait un candidat sérieux pour l’inférence locale quantifiée. Et DeepSeek V4 Flash, retravaillé en version 4.1, reste la référence pour les charges lourdes : c’est sur ce modèle que les chiffres les plus spectaculaires du Spark ont été mesurés.
Les faits datés de l’été 2026 donnent la mesure du potentiel en cluster :
| Configuration | Métrique | Valeur |
|---|---|---|
| 1× DGX Spark (ds4, DeepSeek-V4-Flash IQ2_XXS) | Débit single-stream | ~14 tok/s |
| 1× DGX Spark (ds4.c IQ2_XXS) | Prefill | 410 tok/s |
| 1× DGX Spark (llama.cpp GGUF, 35B-A3B) | Débit max | jusqu’à 67 tok/s |
| 2× DGX Spark (TP=2, vLLM, DeepSeek-V4-Flash FP8) | Single-stream | ~41 tok/s |
| 2× DGX Spark (TP=2, vLLM, DeepSeek-V4-Flash FP8) | Agrégé @ c=32 | ~350 tok/s |
| 2× DGX Spark (vLLM FP8) | Prefill | ~1 785 tok/s |
| 2× DGX Spark (cache KV partagé) | Pool de cache KV | 1 105 096 tokens |
| 2× DGX Spark | Taille max de modèle | 405 milliards de paramètres |
La lecture est limpide : le passage de un à deux nœuds ne double pas seulement le débit single-stream (de ~14 à ~41 tok/s sur DeepSeek V4 Flash), il démultiplie la capacité de prefill (~410 → ~1 785 tok/s) et ouvre la porte à des modèles de 405 milliards de paramètres. C’est là tout l’intérêt du clustering : sur un seul nœud, le GB10 est un excellent exécutant de modèles 30B ; sur deux, il devient une plateforme capable d’héberger des modèles de classe 400B en FP8.
Fine-tuning sur DGX Spark : ce que la stack permet vraiment
Le fine-tuning est le cœur de la promesse du Spark, et c’est aussi là que les arbitrages mémoire se paient cash. Trois régimes se dessinent à l’automne 2026 :
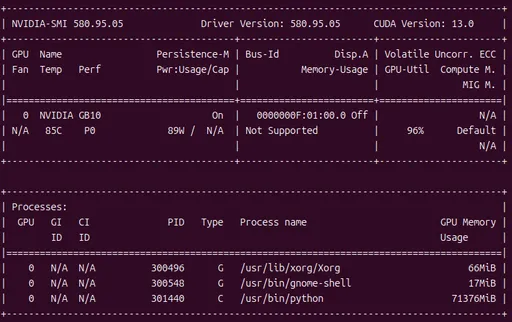
1. LoRA sur modèles de taille moyenne (12–30B). C’est le terrain de jeu naturel de la machine. Le test FLUX 1-dev (12B) cité plus haut, avec ~71,4 Go de mémoire continue et 89–90 W de consommation crête, montre qu’un fine-tuning LoRA tient confortablement sur 128 Go. Sur la version 64 Go, il faut descendre en QLoRA ou réduire la taille du batch et du rang LoRA.
2. QLoRA et quantification 4 bits. Avec NVFP4 et les formats Q4, on peut entraîner des adaptateurs sur des modèles plus gros en compressant la base. C’est la voie recommandée sur la configuration 64 Go, où la marge mémoire est divisée par deux. La contrepartie : un peu de qualité et une ingestion de données plus lente.
3. Fine-tuning distribué en cluster. Pour les modèles de classe 120B et au-delà, le clustering 4 nœuds devient indispensable. Le guide SparkDeploymentGuide de Nemotron 3 Ultra décrit la procédure complète : vLLM, tensor parallelism, réseau RoCE, décodage spéculatif MTP et benchmarking AIPerf. C’est la configuration qui permet d’envisager le post-training de modèles frontière en local — mais elle suppose quatre machines, soit un investissement de l’ordre de 16 000 à 24 000 $ selon la configuration (128 ou 64 Go).
NVIDIA outille d’ailleurs cette démarche : les guides de déploiement Nemotron incluent un Nemotron Post-training Calculator qui donne des estimations directionnelles du nombre de GPU, du temps d’entraînement et du coût de calcul pour personnaliser un checkpoint avec SFT, LoRA ou GRPO. Un outil précieux pour dimensionner un projet avant d’acheter.
Clusters DGX Spark : l’agrégation comme stratégie
La vraie révolution du Spark n’est pas dans un seul boîtier, mais dans sa capacité à s’agréger. La release de juin 2026 a officialisé le clustering 4 nœuds ; les guides NVIDIA en décrivent le mode opératoire pour Nemotron 3 Ultra, avec tensor parallelism, RoCE et MTP. Sur le plan réseau et stockage, l’interconnexion ConnectX et le NVMe de 4 To par nœud constituent les fondations : le cache KV partagé sur deux nœuds atteint déjà 1 105 096 tokens, ce qui autorise des contextes très longs en parallèle.
Le clustering ouvre trois usages distincts :
- Inférence parallélisée : répartir un gros modèle (DeepSeek V4 Flash FP8, Nemotron Super 120B) sur plusieurs nœuds via tensor parallelism, avec un débit agrégé qui grimpe à ~350 tok/s à concurrence 32 sur deux nœuds.
- Fine-tuning distribué : entraîner des adaptateurs sur des modèles que aucun nœud seul ne peut charger.
- Haute disponibilité et routage : avec PAIR, plusieurs Spark sur un réseau domestique ou de bureau peuvent servir de pool de calcul, routé dynamiquement selon la charge.
Reste la question du prix. Avec la DGX Spark 64 Go à 4 999 $ et la 128 Go au-delà de 6 000 $ sur certains canaux, un cluster de quatre nœuds représente un investissement conséquent — mais qui reste dans l’ordre de grandeur d’une seule carte de datacenter, pour une consommation électrique et une empreinte physique sans commune mesure.
Benchmarks indépendants : AA-AgentPerf-Local et le reste
Le 29 septembre 2026, Artificial Analysis a publié AA-AgentPerf-Local, un benchmark dédié aux performances d’agents en local. Au lancement, quatre matériels étaient testés — DGX Spark, Ryzen AI Halo, MacBook Pro (M5 Pro) et RTX 5090 — sur quatre modèles open-weight. C’est la première évaluation indépendante et standardisée de l’usage agentique sur ces machines, et elle tombe à point nommé pour arbitrer entre les plateformes.
La concurrence, justement, s’est intensifiée. TechTimes rapporte que l’AMD Ryzen AI Halo 192 Go est arrivé chez Micro Center à 7 299,99 $, capable de charger des modèles open-weight de 300 milliards de paramètres — mais que, selon les benchmarks indépendants, « le DGX Spark gagne toujours sur la vitesse ». Un arbitrage classique : plus de mémoire chez AMD, plus de débit chez NVIDIA grâce à l’écosystème CUDA et aux optimisations logicielles. À noter aussi que le DGX Station for Windows (748 Go de mémoire cohérente, 20 PFLOPs FP4, lancement Q4 2026 via six partenaires OEM) vient coiffer la gamme par le haut, sans remplacer le Spark.
Côté écosystème partenaire, ASUS a dévoilé le 5 octobre l’Ascent GX10 64 Go, un « supercalculateur agentique compact » propulsé par le même GB10, avec 1 pétaFLOP de calcul et un positionnement sur les modèles 30–35B. Techgenyz souligne que, malgré un matériel identique, les prix, le stockage, le refroidissement et la disponibilité diffèrent nettement du DGX Spark officiel. Et Acer livre ses mini-PC GB10 128 Go depuis le 8 septembre 2026, à 500–1 000 $ sous le prix NVIDIA officiel. La concurrence entre partenaires tire les prix vers le bas — une bonne nouvelle pour l’adoption.
Ce qu’il faut retenir à l’automne 2026
Trois conclusions se dégagent pour qui veut faire tourner des LLM open source sur GB10 aujourd’hui :
- La release d’octobre 2026 est le point de départ obligé. Déployée depuis le 21 octobre sur DGX Spark et systèmes partenaires, elle consolide NVFP4, le décodage spéculatif et la compatibilité avec les poids récents.
- La configuration 64 Go est viable pour l’inférence d’agents 30B, pas pour le fine-tuning lourd. Le workflow edge documenté par NVIDIA le 30 octobre pour Nemotron-3.5 Lightning sur DGX Spark 64 Go le prouve ; mais pour LoRA sur modèles 30B+ et a fortiori pour le clustering, la version 128 Go reste le choix raisonnable.
- Le clustering est la vraie frontière. Deux nœuds suffisent à faire passer le prefill de ~410 à ~1 785 tok/s et à ouvrir les modèles de 405 milliards de paramètres ; quatre nœuds, décrits dans le SparkDeploymentGuide, permettent le fine-tuning distribué de modèles frontière.
Entre Nemotron 3.5 Lightning, Qwen3.8-27B, MiMo-V2.6 et DeepSeek V4.1, le catalogue open-weight n’a jamais été aussi riche — et le GB10, un an et demi après son lancement, n’a jamais été aussi bien outillé pour en tirer parti. La promesse du mini-supercalculateur de bureau tient. À condition d’accepter ses arbitrages mémoire, et de dimensionner son achat selon l’usage réel : agent léger ou fine-tuning de frontière.
Sources
- 3dvf — fiche technique NVIDIA DGX Spark
- Blog NVIDIA — DGX Spark et modèles open source frontière
- Blog NVIDIA — NemoClaw (GTC 2026)
- Forum développeurs NVIDIA — DGX Spark Software Updates, October 2026 Release (21 octobre 2026)
- NVIDIA Documentation Hub — Deployment Guides Nemotron
- GitHub NVIDIA-NeMo — SparkDeploymentGuide (Nemotron 3 Ultra)
- NVIDIA Developer — Nemotron 3.5 Lightning pour agents longue durée
- Unsloth — documentation Nemotron 3.5
- Hugging Face — NVIDIA-Nemotron-3.5-Lightning-30B-A3B-GGUF (Unsloth)
- OrcaRouter — Granite 4.2 30B vs Nemotron 3.5 Lightning
- OrcaRouter — Qwen3.8-27B
- Clore.ai — guide Qwen3.8-27B
- astoik.ai — Qwen 3.8 27B et agents locaux
- Hugging Face — Qwen3.8-27B-GGUF (Unsloth)
- banandre.com — Qwen3.8-Flash-Next et MTP
- SiliconANGLE — ouverture des poids MiMo-V2.6
- Forkast — MiMo-V2.6 et transparence RL
- eWeek — réserve sur les gains RL de MiMo
- WinBuzzer — MiMo V2.6 Pro et Flash
- vLLM — analyse DGX Spark
- haruni.net — test indépendant DGX Spark
- devtoolstack.mynewit.com — benchmark 17 LLM sur GB10
- Wccftech — optimisations vLLM et llama.cpp (3 septembre 2026)
- StorageReview — firmware DGX Spark et certificat Windows UEFI (5 septembre 2026)
- ComputeLeap — analyse du routeur PAIR
- kod.ru — DGX Spark 64 Go à 4 999 $ (3 octobre 2026)
- NeoTeo — DGX Spark 64 Go et test Qwen 3.8 27B (3 octobre 2026)
- generation-nt.com — DGX Spark 64 Go (4 octobre 2026)
- blockchain.news — workflow edge NVIDIA pour Nemotron-3.5 Lightning sur DGX Spark 64 Go (30 octobre 2026)
- TechTimes — AMD Ryzen AI Halo 192 Go vs DGX Spark (14 octobre 2026)
- Techgenyz — ASUS Ascent GX10 vs DGX Spark (5 octobre 2026)
- ASUS — Ascent GX10 64 Go (5 octobre 2026)
- tech-insider.org — NVIDIA DGX Station for Windows (8 octobre 2026)
Article recherché et rédigé automatiquement · Magazine Electrosens