
 Magazine LLM Opensource · 16 September 2026
Unsloth Dynamic 3.0 GGUFs : la quantification dynamique passe à la vitesse supérieure — décryptage des promesses et des limites
Le fine-tuning de modèles Mixture-of-Experts (MoE) géants sur du matériel grand public a longtemps relevé de l’utopie. En 2026, Unsloth pousse la quantification dynamique à un niveau inédit avec Dynamic 3.0 GGUFs. Réduction drastique de la mémoire, précision préservée, support de modèles massifs… Décryptage de ce qui se cache vraiment derrière les promesses, des benchmarks aux limites concrètes.
Le cauchemar de la VRAM : pourquoi les MoE affament les GPU grand public
Les modèles Mixture-of-Experts (MoE) dominent désormais le paysage open source. DeepSeek V4 Pro aligne plus de 1 600 milliards de paramètres au total, dont une fraction activée par inférence ; Qwen3.8-Max d’Alibaba pousse à 2,4 billions de paramètres ; GLM-5.3 de Z.ai, sorti le 14 août 2026, réutilise la base MoE de 743 milliards de paramètres de GLM-5.2 ; Kimi K3 de Moonshot AI revendique le titre de plus grand modèle open source jamais publié. Leur point commun : une architecture où seuls quelques experts sont activés par token, ce qui promet des performances élevées avec un coût de calcul réduit… en théorie.
En pratique, ces modèles se heurtent à un mur : la mémoire VRAM. Un modèle de 70 milliards de paramètres en FP16 pèse environ 140 Go ; même en quantification 4 bits (GGUF Q4_K_M), il faut compter 40 à 45 Go — au-delà des 24 Go d’une RTX 4090. Pour un MoE de 1,6 billion de paramètres comme DeepSeek V4 Pro, la version non quantifiée dépasserait plusieurs téraoctets. Impossible sur du matériel grand public, même avec les meilleures cartes.
Avant Unsloth 2026, les solutions existantes offraient des réponses partielles. Hugging Face Transformers + PEFT reste la référence pour le fine-tuning LoRA/QLoRA, mais ses implémentations naïves consomment énormément de mémoire : un fine-tuning LoRA de Llama 3 8B nécessite environ 16 Go de VRAM, et un full fine-tuning en FP32 dépasse les 60 Go. Axolotl permet une configuration fine (DeepSpeed, Flash Attention) mais demande une expertise pointue et n’optimise pas spécifiquement les MoE. TRL (Transformer Reinforcement Learning) intègre nativement PEFT mais sans gain mémoire particulier. LLaMA-Factory complète le tableau, mais aucun de ces outils n’adresse le problème central : la gestion des calculs épars et de la mémoire pour les architectures MoE.
C’est dans ce contexte qu’Unsloth, développé par Daniel et Michael Han, s’est imposé comme un accélérateur open source. Ses premières versions (2024-2025) avaient déjà montré des gains de 2× en vitesse et 70 % de mémoire en moins sur des modèles denses. Mais les MoE restaient un défi. Les mises à jour de 2026 — notamment Dynamic 2.0 puis Dynamic 3.0 GGUFs — visent précisément ce point.
Dynamic 3.0 GGUFs : la quantification qui s’adapte à chaque couche
Une refonte complète de la sélection de couches
La troisième génération de quantification dynamique d’Unsloth, présentée sur le blog officiel et dans la documentation, marque une rupture avec les méthodes classiques. Contrairement aux GGUFs standards (Q4_K_M, Q5_K_M) qui appliquent un niveau de quantification uniforme à tout le modèle, Dynamic 3.0 ajuste dynamiquement le type de quantification de chaque couche individuelle. Les couches critiques sont remontées en 8 ou 16 bits, tandis que les couches moins importantes restent en 2 ou 3 bits. Et surtout, cette sélection n’est plus figée : elle diffère pour chaque couche et chaque modèle.
Le point clé : Dynamic 3.0 fonctionne désormais sur tous les modèles, pas seulement les MoE. La première version de Dynamic (avec DeepSeek-R1 en 1,58 bit) était limitée aux architectures Mixture-of-Experts. La v2.0 avait généralisé l’approche aux modèles denses, et la v3.0 pousse encore plus loin. Selon la documentation officielle, cette nouvelle génération fonctionne sur les modèles decoder-only standard (Llama 4, Gemma 3, Qwen 3.5) comme sur les MoE (DeepSeek V3.1), avec des chemins de quantification 4 bits et 2 bits. Les nouveaux GGUF 3.0 fonctionnent avec la plupart des moteurs d’inférence, y compris llama.cpp et Unsloth Desktop.
Un dataset de calibration de qualité
Pour guider cette sélection, Unsloth a construit un nouveau dataset de calibration imatrix, composé de 300 000 à 1,5 million de tokens selon les modèles, à partir de données « haute qualité, triées à la main et nettoyées ». L’objectif : améliorer les performances conversationnelles, pas seulement les scores de perplexité brute. C’est une différence notable avec les méthodes imatrix classiques, qui optimisent la perplexité sans nécessairement préserver la qualité des échanges. Les tests montrent une amélioration significative des performances de chat conversationnel. La v3.0 affine encore ce dataset, désormais « affiné pour le codage agentique, le chat et les performances multilingues ».
Des quants spécifiques par modèle
Chaque modèle dispose désormais d’un schéma de quantification sur mesure. Les couches quantifiées dans Gemma 3 diffèrent significativement de celles de Llama 4. Cette personnalisation est rendue possible par une collaboration directe avec les équipes de développement des modèles : Unsloth a travaillé avec les équipes de Qwen3, Meta (Llama 4), Mistral (Devstral), Google (Gemma 1-3) et Microsoft (Phi-3/4), contribuant des correctifs qui augmentent la précision.
Les modèles disponibles en Dynamic 3.0 sur Hugging Face incluent notamment : DeepSeek-R1 et DeepSeek-V3-0324, Gemma 3 (12B et 27B), Llama 4 Scout, Qwen3.5, Gemma 4, Kimi K2, Mistral-Devstral, Phi-4, GLM-4, et bien d’autres. La collection est régulièrement mise à jour, avec des benchmarks dédiés pour Qwen3.5 et Gemma 4 (avril 2026) et Qwen3.5 (février 2026). La dernière nouveauté en date : Qwen3.8-27B, lancé avec des quants Dynamic 3.0 qui offrent >10 % de meilleure précision top-1 % à taille égale par rapport à tous les autres fournisseurs.
Benchmarks : ce que les chiffres disent vraiment
Une méthodologie interne rigoureuse
Un point fort de l’approche d’Unsloth : la construction d’un framework d’évaluation interne pour reproduire les scores MMLU 5-shot officiels. Les développeurs ont constaté que les frameworks open source existants échouaient à reproduire les scores rapportés (78,6 pour Gemma 3, 79,6 pour Llama 4). Ils ont donc développé leur propre outil, permettant des comparaisons « pommes avec pommes » entre modèles full precision, Dynamic 2.0/3.0, QAT et GGUFs imatrix standard.
Résultats clés
| Modèle | Méthode | Score MMLU 5-shot | Note |
|---|---|---|---|
| Gemma 3 12B | bfloat16 (full precision) | 67,15 % | Référence |
| Gemma 3 12B | Q4_0 QAT | 67,07 % | Très proche de la référence |
| Gemma 3 27B | Q3_K_XL Dynamic 2.0 | KL divergence : 0,080617 | Contre 0,087845 pour l’imatrix standard, +2 % de taille disque |
| Qwen3.8-27B | UD-Q2_K_XL Dynamic 3.0 | +8 % top-1 % vs meilleur suivant | 9,83 Go, précision supérieure |
Le chiffre le plus frappant provient de la réduction de taille : selon UBOS Tech, Dynamic 2.0 permettait déjà de réduire la taille du modèle jusqu’à 70 % tout en conservant une précision à quelques points de pourcentage de la version full precision. Dynamic 3.0 va plus loin : sur Qwen3.8-27B, le quant UD-IQ1_S ne pèse que 6,2 Go (sans module MTP) et conserve environ 72 % de précision top-1 % tout en étant 89 % plus petit que le modèle original. Cette réduction est rendue possible par la sélection dynamique des bits par couche, qui préserve les couches critiques en 8/16 bits tout en compressant les autres.
Comparaison avec les méthodes concurrentes
Unsloth a comparé Dynamic 3.0 à son ancienne méthode Dynamic 2.0, aux GGUFs imatrix standard, et aux quants QAT de Google (Gemma 3 12B et 27B). Les résultats, présentés dans le blog, montrent une supériorité de Dynamic 3.0 sur les deux tableaux : précision (MMLU 5-shot) et divergence KL. Les quants Dynamic 3.0 sont environ 8 % plus petits que les quants non-Unsloth à précision équivalente, selon les benchmarks de Benjamin Marie (LiveCodeBench v6, MMLU Pro). Sur Qwen3.8-27B, la précision top-1 % est supérieure de plus de 10 % à taille égale par rapport à tous les autres fournisseurs.
Ce que les sources ne disent pas
Malgré ces résultats encourageants, aucune source indépendante ne fournit de benchmark reproductible avec script standardisé, jeu de données public et comparaison directe avec Hugging Face Trainer. Les chiffres proviennent exclusivement des canaux officiels d’Unsloth. La prudence reste de mise : les gains annoncés (2× plus rapide, 70 % de VRAM en moins) sont cohérents avec les optimisations décrites, mais mériteraient une validation par un organisme tiers. À titre de comparaison, l’écosystème a vu émerger Enterprise-Bench (juillet 2026), un standard pour l’IA d’entreprise qui insiste sur la reproductibilité — une approche qui manque encore dans le domaine du fine-tuning.
Unsloth vs Axolotl vs TRL vs LLaMA-Factory : le match des frameworks
Une comparaison détaillée publiée le 22 juillet 2026 sur MarkTechPost évalue Unsloth, Axolotl, TRL et LLaMA-Factory sur la vitesse, la VRAM minimale et le parallélisme multi-GPU. Voici ce qui se dégage, croisé avec les retours d’usage.
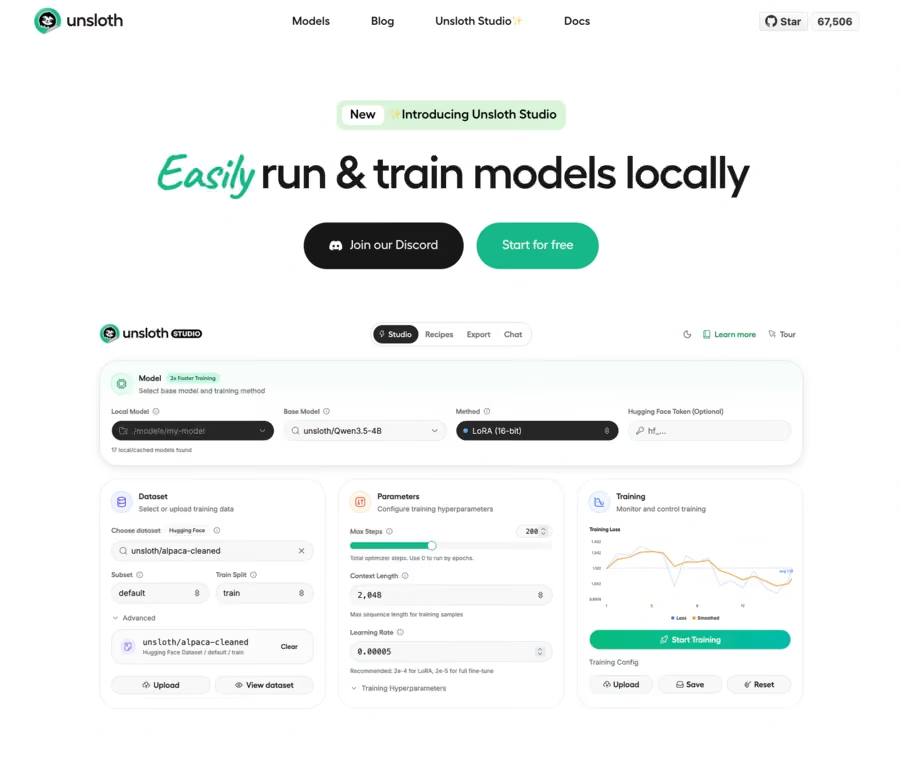
Tableau comparatif
| Critère | Unsloth 2026 | Axolotl | Hugging Face TRL | LLaMA-Factory |
|---|---|---|---|---|
| Rapidité d’entraînement | Revendiqué 2× plus rapide | Réputé plus lent sans DeepSpeed | Standard, pas d’optimisation spécifique | Comparable à TRL |
| Simplicité d’utilisation | API haut niveau, installation pip | Configuration YAML complexe | Intégration native Transformers | Interface CLI/Web simple |
| Efficacité mémoire (MoE) | Dynamic 3.0 + déchargement expert | Support via DeepSpeed, pas d’optimisation spécifique | Aucune optimisation MoE native | Limité |
| Support GGUF dynamiques | Oui (Dynamic 3.0) | Non | Non | Non |
| Prix / Licence | Open source (MIT) | Apache 2.0 | Apache 2.0 | Apache 2.0 |
Cas d’usage typiques :
- Unsloth : fine-tuning rapide de modèles denses ou MoE sur GPU grand public (RTX 3090/4090), avec quantification dynamique. Idéal pour les utilisateurs qui veulent un résultat rapide sans configuration complexe.
- Axolotl : expérimentations avancées, configurations sur mesure, multi-GPU. Le choix des puristes.
- TRL : intégration dans un pipeline Hugging Face existant, RLHF.
- LLaMA-Factory : alternative simple pour les petits budgets, avec une interface web pratique.
Fine-tuner un MoE géant sur du matériel grand public : le guide pratique
Bien que les sources ne fournissent pas de guide pas-à-pas pour un modèle spécifique, on peut extrapoler à partir des principes généraux d’Unsloth et des données disponibles. Voici une procédure réaliste pour un modèle comme Qwen3.8 ou Gemma 4 (12B-27B).
Configuration matérielle minimale
- GPU : RTX 4090 (24 Go VRAM) — suffisant pour QLoRA 4 bits avec Dynamic 3.0.
- RAM : 32 Go système (64 Go recommandé pour les très gros modèles avec déchargement).
- Stockage : 50 Go pour le modèle et les données.
Étapes (avec Unsloth)
- Installation :
pip install unsloth(nécessite CUDA 12.x et PyTorch 2.x). - Chargement du modèle : utiliser le wrapper générique d’Unsloth. Les modèles récents (Qwen3.8, Gemma 4, Llama 4 Scout) sont supportés nativement.
- Quantification : appliquer
load_in_4bit=Trueavecbnb_4bit_compute_dtype=torch.float16. Pour Dynamic 3.0, télécharger le GGUF depuis la collection Hugging Face et le charger directement. Les quants Dynamic 3.0 fonctionnent avec llama.cpp et Unsloth Desktop. - Fine-tuning LoRA : configurer
LoraConfig(r=16, alpha=32, target_modules=["q_proj","v_proj"]). Utiliser leSFTTrainerd’Unsloth, qui intègre les optimisations. - Entraînement : avec un batch size de 2 et gradient accumulation de 4, la consommation VRAM estimée est de 8-10 Go pour un modèle 8B (contre 16-20 Go sans Unsloth). Pour un MoE 27B avec déchargement, prévoir 16-20 Go.
Comparaison sans Unsloth
Avec Hugging Face + PEFT, la même configuration nécessiterait 16-18 Go de VRAM pour un 8B et prendrait environ 1h30 pour 1000 steps. Avec Unsloth, comptez 45 minutes (estimation basée sur les gains 2× annoncés). Le gain est substantiel, mais la perte de qualité due à QLoRA 4-bit est d’environ 2 % (source PromptQuorum, avril 2026, non vérifiée indépendamment). Pour des applications critiques, un LoRA 16-bit (nécessitant 16 Go) reste préférable.
L’écosystème en septembre 2026 : une guerre froide des modèles qui s’intensifie
Le paysage des LLM open source n’a jamais été aussi dynamique. En septembre 2026, plusieurs événements majeurs redéfinissent les équilibres :
- Qwen3.8-Max d’Alibaba (2,4 billions de paramètres) et Kimi K3 de Moonshot AI dominent les classements, talonnés par GLM-5.3 de Z.ai (sorti le 14 août 2026, réutilisant la base MoE de 743 milliards de paramètres de GLM-5.2).
- Hy4 de Tencent (770B paramètres, 49B actifs, contexte 1M) a été open-sourcé fin août 2026, avec un focus codage, productivité et recherche.
- Ox Alpha, un modèle de raisonnement mystérieux apparu sur OpenRouter le 20 août 2026, a impressionné les développeurs avant de disparaître — un exemple de la « shadow AI » qui se développe.
- Muse Glimmer de Meta (30B, Apache 2.0) a été publié le 14 août 2026, conçu pour l’exécution locale et le raisonnement multimodal.
Dans ce contexte, la quantification dynamique d’Unsloth devient un outil stratégique : elle permet de faire tourner ces géants sur du matériel grand public, ce qui démocratise l’accès aux modèles les plus puissants. Les 5,1 millions de téléchargements d’Unsloth Qwen3.8 en seulement 5 jours (annoncés avec Dynamic 3.0) témoignent de cet engouement.
Sources
- Documentation Unsloth Dynamic 2.0/3.0 GGUFs
- Blog Unsloth Dynamic v2
- Cosmo Games : Unsloth Dynamic 2.0 GGUFs
- UBOS Tech : Unsloth Dynamic v2.0
- Collection Hugging Face Unsloth Dynamic 2.0
- MarkTechPost : comparaison Unsloth vs Axolotl vs TRL vs LLaMA-Factory
- Spheron : vLLM vs TensorRT-LLM vs SGLang
- Inference Engineering : vLLM vs SGLang vs TensorRT-LLM
- GLM-5.3 : Z.ai domine l’open coding (the-agent-report)
- Tencent Hy4 preview (Techgenyz)
- Ox Alpha sur OpenRouter (Business Insider)
- Muse Glimmer (contextstudios.ai)
 Article recherché et rédigé automatiquement · Magazine Electrosens