
 Magazine LLM Opensource · 13 October 2026
Unsloth Dynamic 3.0 GGUFs : le fine-tuning et la quantification des MoE géants à l’épreuve du matériel grand public
Le fine-tuning de modèles Mixture-of-Experts (MoE) géants sur du matériel grand public a longtemps relevé de l’utopie. En 2026, Unsloth pousse la quantification dynamique à un niveau inédit avec Dynamic 3.0 GGUFs. Réduction drastique de la mémoire, précision préservée, support de modèles massifs… Décryptage de ce qui se cache vraiment derrière les promesses, des benchmarks aux limites concrètes.
Le cauchemar de la VRAM : pourquoi les MoE affament les GPU grand public
Les modèles Mixture-of-Experts (MoE) dominent désormais le paysage open source. DeepSeek V4 Pro aligne plus de 1 600 milliards de paramètres au total, dont une fraction activée par inférence ; Qwen3.8-Max d’Alibaba pousse à 2,4 billions de paramètres ; GLM-5.3 de Z.ai, sorti le 14 août 2026, réutilise la base MoE de 743 milliards de paramètres de GLM-5.2 ; Kimi K3 de Moonshot AI revendique le titre de plus grand modèle open source jamais publié. Leur point commun : une architecture où seuls quelques experts sont activés par token, ce qui promet des performances élevées avec un coût de calcul réduit… en théorie.
En pratique, ces modèles se heurtent à un mur : la mémoire VRAM. Un modèle de 70 milliards de paramètres en FP16 pèse environ 140 Go ; même en quantification 4 bits (GGUF Q4_K_M), il faut compter 40 à 45 Go — au-delà des 24 Go d’une RTX 4090. Pour un MoE de 1,6 billion de paramètres comme DeepSeek V4 Pro, la version non quantifiée dépasserait plusieurs téraoctets. Impossible sur du matériel grand public, même avec les meilleures cartes.
Avant Unsloth 2026, les solutions existantes offraient des réponses partielles. Hugging Face Transformers + PEFT reste la référence pour le fine-tuning LoRA/QLoRA, mais ses implémentations naïves consomment énormément de mémoire : un fine-tuning LoRA de Llama 3 8B nécessite environ 16 Go de VRAM, et un full fine-tuning en FP32 dépasse les 60 Go. Axolotl permet une configuration fine (DeepSpeed, Flash Attention) mais demande une expertise pointue et n’optimise pas spécifiquement les MoE. TRL (Transformer Reinforcement Learning) intègre nativement PEFT mais sans gain mémoire particulier. LLaMA-Factory complète le tableau, mais aucun de ces outils n’adresse le problème central : la gestion des calculs épars et de la mémoire pour les architectures MoE.
C’est dans ce contexte qu’Unsloth, développé par Daniel et Michael Han, s’est imposé comme un accélérateur open source. Ses premières versions (2024-2025) avaient déjà montré des gains de 2× en vitesse et 70 % de mémoire en moins sur des modèles denses. Mais les MoE restaient un défi. Les mises à jour de 2026 — notamment Dynamic 2.0 puis Dynamic 3.0 GGUFs — visent précisément ce point.
Dynamic 3.0 GGUFs : la quantification qui s’adapte à chaque couche
Une refonte complète de la sélection de couches
La troisième génération de quantification dynamique d’Unsloth, présentée sur le blog officiel et dans la documentation, marque une rupture avec les méthodes classiques. Contrairement aux GGUFs standards (Q4_K_M, Q5_K_M) qui appliquent un niveau de quantification uniforme à tout le modèle, Dynamic 3.0 ajuste dynamiquement le type de quantification de chaque couche individuelle. Les couches critiques sont remontées en 8 ou 16 bits, tandis que les couches moins importantes restent en 2 ou 3 bits. Et surtout, cette sélection n’est plus figée : elle diffère pour chaque couche et chaque modèle.
Le point clé : Dynamic 3.0 fonctionne désormais sur tous les modèles, pas seulement les MoE. La première version de Dynamic (avec DeepSeek-R1 en 1,58 bit) était limitée aux architectures Mixture-of-Experts. La v2.0 avait généralisé l’approche aux modèles denses, et la v3.0 pousse encore plus loin. Selon la documentation officielle, cette nouvelle génération fonctionne sur les modèles decoder-only standard (Llama 4, Gemma 3, Qwen 3.5) comme sur les MoE (DeepSeek V3.1), avec des chemins de quantification 4 bits et 2 bits. Les nouveaux GGUF 3.0 fonctionnent avec la plupart des moteurs d’inférence, y compris llama.cpp et Unsloth Desktop.
Un point méthodologique essentiel, martelé par Unsloth : Dynamic 3.0 est une approche purement PTQ (post-training quantization). Les développeurs précisent explicitement qu’ils n’entraînent pas sur le dataset de calibration imatrix et qu’ils n’utilisent ni QAT (quantization-aware training) ni QAD (quantization-aware distillation). Tout le gain vient du post-traitement des poids existants — une distinction importante face aux quants QAT de Google, qui reposent sur un entraînement conscient de la quantification.
Un dataset de calibration de qualité
Pour guider cette sélection, Unsloth a construit un nouveau dataset de calibration imatrix, à partir de données « haute qualité, triées à la main et nettoyées » issues de sources diverses. L’objectif : améliorer les performances conversationnelles, pas seulement les scores de perplexité brute. C’est une différence notable avec les méthodes imatrix classiques, qui optimisent la perplexité sans nécessairement préserver la qualité des échanges. Le dataset est désormais « affiné pour le codage agentique, le chat et les performances multilingues ». Fait notable pour la reproductibilité : Unsloth rend son fichier imatrix public, afin que la communauté puisse le tester, l’évaluer et l’utiliser pour créer ses propres variantes et fine-tunes de Qwen3.8.
Des quants spécifiques par modèle
Chaque modèle dispose désormais d’un schéma de quantification sur mesure. Les couches quantifiées dans Gemma 3 diffèrent significativement de celles de Llama 4. Cette personnalisation est rendue possible par une collaboration directe avec les équipes de développement des modèles : Unsloth a travaillé avec les équipes de Qwen3, Meta (Llama 4), Mistral (Devstral), Google (Gemma 1-3) et Microsoft (Phi-3/4), contribuant des correctifs qui augmentent la précision.
Les modèles disponibles en Dynamic 3.0 sur Hugging Face incluent notamment : DeepSeek-R1 et DeepSeek-V3-0324, Gemma 3 (12B et 27B), Llama 4 Scout, Qwen3.5, Gemma 4, Kimi K2, Mistral-Devstral, Phi-4, GLM-4, et bien d’autres. La collection est régulièrement mise à jour, avec des benchmarks dédiés pour Qwen3.5 et Gemma 4 (avril 2026) et Qwen3.5 (février 2026). La dernière nouveauté en date : Qwen3.8-27B, lancé avec des quants Dynamic 3.0 qui offrent >10 % de meilleure précision top-1 à taille égale par rapport à tout autre fournisseur. Le succès est au rendez-vous : Unsloth a enregistré plus de 5,1 millions de téléchargements de ses quants Qwen3.8 en seulement 5 jours.
Benchmarks : ce que les chiffres disent vraiment
Une méthodologie interne rigoureuse
Un point fort de l’approche d’Unsloth : la construction d’un framework d’évaluation interne pour reproduire les scores MMLU 5-shot officiels. Les développeurs ont constaté que les frameworks open source existants échouaient à reproduire les scores rapportés (78,6 pour Gemma 3, 79,6 pour Llama 4). Ils ont donc développé leur propre outil, permettant des comparaisons « pommes avec pommes » entre modèles full precision, Dynamic 2.0/3.0, QAT et GGUFs imatrix standard.
Unsloth insiste aussi sur un point souvent négligé : la top-1 accuracy est un argmax sur une seule prédiction, donc un indicateur imparfait de la qualité réelle en inférence. C’est pourquoi l’équipe a introduit Divergence-300 @32, un jeu de 300 exemples tenus à l’écart (absents du dataset de calibration) issus de Terminal-Bench, destiné à mesurer la divergence réelle plutôt qu’un simple score de perplexité. Dynamic 3.0 affiche de meilleurs résultats sur Divergence-300 @32 et sur la divergence KL, à taille de fichier égale.
Résultats clés
| Modèle | Méthode | Score / métrique | Note |
|---|---|---|---|
| Gemma 3 12B | bfloat16 (full precision) | 67,15 % MMLU 5-shot | Référence |
| Gemma 3 12B | Q4_0 QAT | 67,07 % MMLU 5-shot | Très proche de la référence |
| Gemma 3 27B | Q3_K_XL Dynamic 2.0 | KL divergence : 0,080617 | Contre 0,087845 pour l’imatrix standard, +2 % de taille disque |
| Qwen3.8-27B | UD-Q2_K_XL Dynamic 3.0 | +8 % top-1 % vs meilleur suivant | 9,83 Go, précision supérieure |
| Qwen3.8-27B | UD-IQ1_S Dynamic 3.0 | ~72 % de précision top-1 conservée | 6,2 Go (sans MTP), 89 % plus petit |
| Kimi-K3 | Dynamic 1-bit | ~78,9 % top-1 | 62 % plus petit |
Le chiffre le plus frappant provient de la réduction de taille : selon UBOS Tech, Dynamic 2.0 permettait déjà de réduire la taille du modèle jusqu’à 70 % tout en conservant une précision à quelques points de pourcentage de la version full precision. Dynamic 3.0 va plus loin : sur Qwen3.8-27B, le quant UD-IQ1_S ne pèse que 6,2 Go (sans module MTP) et conserve environ 72 % de précision top-1 tout en étant 89 % plus petit que le modèle original. Cette réduction est rendue possible par la sélection dynamique des bits par couche, qui préserve les couches critiques en 8/16 bits tout en compressant les autres.
Détail d’ingénierie révélateur : Unsloth a supprimé le module MTP (Multi-Token Prediction) des quants plus petits (UD-Q2_K_XL à 8,37 Go et en dessous), économisant environ 500 Mo d’espace disque. Un module MTP Q4_0 séparé reste disponible si nécessaire. Autre illustration concrète de la qualité préservée : le quant UD-Q2_K_XL (9,83 Go) a réussi à générer un programme HTML fonctionnel avec un seul petit bug JavaScript — là où il échouait auparavant.
Comparaison avec les méthodes concurrentes
Unsloth a comparé Dynamic 3.0 à son ancienne méthode Dynamic 2.0, aux GGUFs imatrix standard, et aux quants QAT de Google (Gemma 3 12B et 27B). Les résultats, présentés dans le blog, montrent une supériorité de Dynamic 3.0 sur les deux tableaux : précision (MMLU 5-shot) et divergence KL. Les quants Dynamic 3.0 sont environ 8 % plus petits que les quants non-Unsloth à précision équivalente, selon les benchmarks de Benjamin Marie (LiveCodeBench v6, MMLU Pro). Sur Qwen3.8-27B, la précision top-1 % est supérieure de plus de 10 % à taille égale par rapport à tous les autres fournisseurs.
Ce que les sources ne disent pas
Malgré ces résultats encourageants, aucune source indépendante ne fournit de benchmark reproductible avec script standardisé, jeu de données public et comparaison directe avec Hugging Face Trainer. Les chiffres proviennent exclusivement des canaux officiels d’Unsloth. La prudence reste de mise : les gains annoncés (2× plus rapide, 70 % de VRAM en moins) sont cohérents avec les optimisations décrites, mais mériteraient une validation par un organisme tiers. À titre de comparaison, l’écosystème a vu émerger Enterprise-Bench (juillet 2026), un standard pour l’IA d’entreprise qui insiste sur la reproductibilité — une approche qui manque encore dans le domaine du fine-tuning. Unsloth fait toutefois un pas dans cette direction en publiant son fichier imatrix et en documentant une analyse anti-surapprentissage sur des jeux de données non vus (Wikitext, code).
Unsloth vs Axolotl vs TRL vs LLaMA-Factory : le match des frameworks
Une comparaison détaillée publiée le 22 juillet 2026 sur MarkTechPost évalue Unsloth, Axolotl, TRL et LLaMA-Factory sur la vitesse, la VRAM minimale et le parallélisme multi-GPU. Voici ce qui se dégage, croisé avec les retours d’usage.
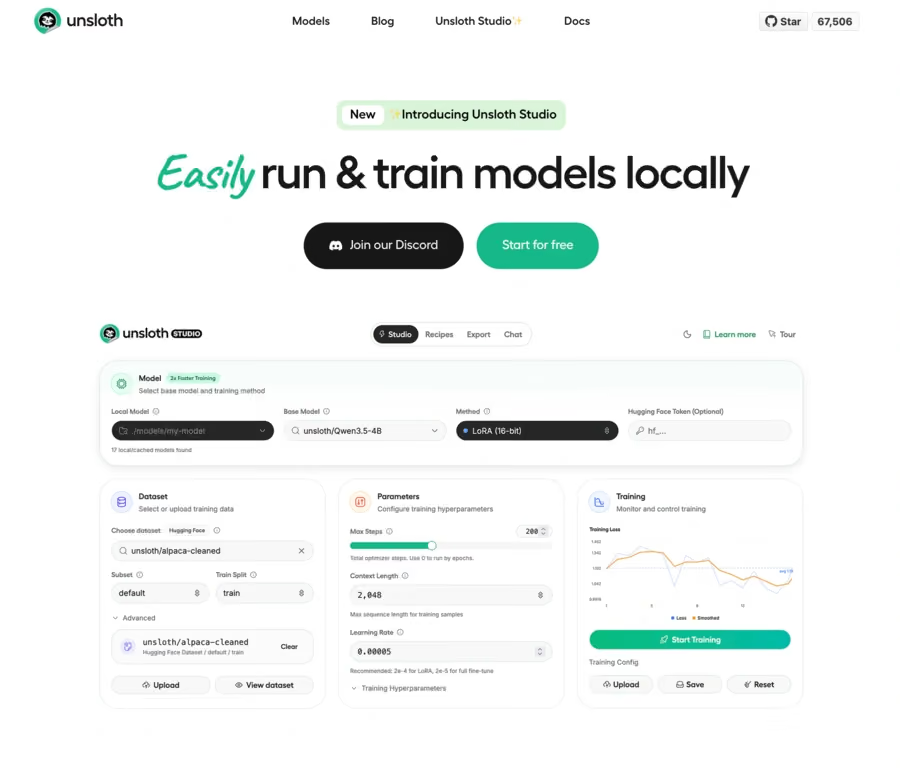
Tableau comparatif
| Critère | Unsloth 2026 | Axolotl | Hugging Face TRL | LLaMA-Factory |
|---|---|---|---|---|
| Rapidité d’entraînement | Revendiqué 2× plus rapide | Réputé plus lent sans DeepSpeed | Standard, pas d’optimisation spécifique | Comparable à TRL |
| Simplicité d’utilisation | API haut niveau, installation pip | Configuration YAML complexe | Intégration native Transformers | Interface CLI/Web simple |
| Efficacité mémoire (MoE) | Dynamic 3.0 + déchargement expert | Support via DeepSpeed, pas d’optimisation spécifique | Aucune optimisation MoE native | Limité |
| Support GGUF dynamiques | Oui (Dynamic 3.0) | Non | Non | Non |
| Prix / Licence | Open source (MIT) | Apache 2.0 | Apache 2.0 | Apache 2.0 |
Cas d’usage typiques :
- Unsloth : fine-tuning rapide de modèles denses ou MoE sur GPU grand public (RTX 3090/4090), avec quantification dynamique. Idéal pour les utilisateurs qui veulent un résultat rapide sans configuration complexe.
- Axolotl : expérimentations avancées, configurations sur mesure, multi-GPU. Le choix des puristes.
- TRL : intégration dans un pipeline Hugging Face existant, RLHF.
- LLaMA-Factory : alternative simple pour les petits budgets, avec une interface web pratique.
Fine-tuner un MoE géant sur du matériel grand public : le guide pratique
Bien que les sources ne fournissent pas de guide pas-à-pas pour un modèle spécifique, on peut extrapoler à partir des principes généraux d’Unsloth et des données disponibles. Voici une procédure réaliste pour un modèle comme Qwen3.8 ou Gemma 4 (12B-27B).
Configuration matérielle minimale
- GPU : RTX 4090 (24 Go VRAM) — suffisant pour QLoRA 4 bits avec Dynamic 3.0.
- RAM : 32 Go système (64 Go recommandé pour les très gros modèles avec déchargement).
- Stockage : 50 Go pour le modèle et les données.
À titre indicatif, les quants Dynamic 3.0 les plus agressifs de Qwen3.8-27B tiennent dans des enveloppes mémoire bien plus modestes : le UD-IQ1_S (6,2 Go) et le UD-Q2_K_XL (9,83 Go) laissent entrevoir une exécution possible sur des configurations à 17 Go de RAM, ce qui ouvre la porte à des machines non équipées de GPU haut de gamme.
Étapes (avec Unsloth)
- Installation :
pip install unsloth(nécessite CUDA 12.x et PyTorch 2.x). - Chargement du modèle : utiliser le wrapper générique d’Unsloth. Les modèles récents (Qwen3.8, Gemma 4, Llama 4 Scout) sont supportés nativement.
- Quantification : appliquer
load_in_4bit=Trueavecbnb_4bit_compute_dtype=torch.float16. Pour Dynamic 3.0, télécharger le GGUF depuis la collection Hugging Face et le charger directement dans llama.cpp ou Unsloth Desktop. - Fine-tuning LoRA : configurer les adaptateurs LoRA (rang, alpha, cibles) et lancer l’entraînement. Le déchargement des experts permet de tenir la VRAM.
- Fusion et export : fusionner les adaptateurs dans les poids de base, puis exporter en GGUF via les outils Unsloth pour l’inférence locale.
L’écosystème 2026 : où situer Unsloth dans la vague open-weights
L’automne 2026 a été marqué par une accélération sans précédent des sorties open-weights, qui rebat les cartes pour les praticiens du fine-tuning local. Le 6 octobre 2026, Mistral AI a dévoilé Mistral Large 4 (surnommé « Le Chonk »), un modèle de frontière à plus de 1 000 milliards de paramètres dont environ 49 milliards activés par réponse, multimodal et doté de capacités agentiques. Entièrement entraîné en Europe, il est présenté comme le meilleur modèle à poids ouverts hors de Chine, avec des poids attendus sur Hugging Face le 27 octobre 2026. Le même jour, Reflection AI a dévoilé Beam, un MoE open-weight de 501 milliards de paramètres (23 milliards actifs), taillé pour le code et le raisonnement, qui revendique un coût d’inférence 3 à 4 fois inférieur à ses concurrents — les poids étant eux aussi attendus plus tard dans le mois.
Ces sorties confirment la tendance de fond : les architectures MoE à activation éparse s’imposent comme le standard des modèles de frontière open-weights, ce qui rend d’autant plus critique la question de la quantification et du déploiement sur matériel contraint. C’est précisément le créneau qu’occupe Unsloth. Là où les serveurs d’inférence comme vLLM, SGLang ou TensorRT-LLM optimisent le débit en production sur des clusters de GPU, Unsloth s’attaque à l’autre bout de la chaîne : permettre à un développeur isolé de faire tourner et d’affiner ces mêmes familles de modèles sur une seule carte.
La convergence est d’ailleurs notable : les quants Dynamic 3.0 sont conçus pour fonctionner avec llama.cpp et Unsloth Desktop, tandis que les moteurs de serving de production (vLLM 0.23.0, SGLang 0.5.13, TensorRT-LLM 1.2.1 en juin 2026) traitent le MoE via des stratégies de mémoire et de partitionnement expert. Les deux mondes se rejoignent sur un même constat : la gestion de la mémoire est devenue le champ de bataille central de l’IA open source.
Ce que cela change pour les développeurs et les entreprises
Trois enseignements se dégagent pour les praticiens.
1. La barrière matérielle s’effondre, mais pas la barrière de compétence. Pouvoir faire tourner un Qwen3.8-27B quantifié en 6,2 Go ne signifie pas que le fine-tuning d’un MoE géant est devenu trivial. La configuration des adaptateurs LoRA, le choix du quant et la gestion du déchargement des experts restent des compétences à acquérir.
2. La reproductibilité reste le maillon faible. Les gains d’Unsloth sont réels et documentés, mais proviennent de ses propres canaux. La publication du fichier imatrix et de l’analyse anti-surapprentissage constituent des gages de transparence bienvenus, mais l’absence de benchmark tiers indépendant invite à la prudence avant tout déploiement critique.
3. Le PTQ pur change l’équation économique. Parce que Dynamic 3.0 n’utilise ni QAT ni QAD, il n’exige aucun entraînement supplémentaire : les quants peuvent être produits rapidement à partir des poids publiés, y compris pour des modèles fraîchement sortis comme Mistral Large 4 ou Beam dès que leurs poids seront disponibles. Pour les équipes qui veulent spécialiser un modèle de frontière sur leur domaine sans budget de pré-entraînement, c’est une porte d’entrée concrète.
Reste une question ouverte : à mesure que les modèles de frontière open-weights franchissent le cap des 1 000 milliards de paramètres, la quantification dynamique suffira-t-elle à maintenir l’illusion du « local d’abord » ? La réponse dépendra moins des algorithmes de compression que de la capacité de l’écosystème à produire des benchmarks indépendants et reproductibles. C’est là, plus que dans les chiffres marketing, que se jouera la crédibilité du fine-tuning local en 2027.
Sources
- Unsloth Dynamic 3.0 GGUFs — Documentation officielle (FR)
- Unsloth Dynamic 3.0 GGUFs — Documentation officielle (EN)
- Unsloth Dynamic 3.0 GGUF Quantization Explained — Oflight (août 2026)
- Unsloth has developed ‘Unsloth Dynamic 3.0 GGUF’ — Gigazine (26 août 2026)
- Unsloth Dynamic 3.0 GGUFs: 10% Better Accuracy for Local LLMs — AIToolly (20 août 2026)
- Unsloth GGUF Dynamic 3.0: Where Small Quants Break — Sakutto
- Unsloth Dynamic 3.0 GGUFs: Run Qwen3.8-27B on 17GB RAM — Byteiota
- Unsloth Dynamic GGUF 3.0: Faster Local Inference Without Sacrificing Quality
- Collection Hugging Face Unsloth Dynamic Quants
- Comparaison Unsloth / Axolotl / TRL / LLaMA-Factory — MarkTechPost (22 juillet 2026)
- Mistral dévoile Large 4, un modèle à plus de 1 000 milliards de paramètres — Le Monde Informatique (7 octobre 2026)
- Mistral Large 4, le modèle à 1 000 milliards de paramètres surnommé Le Chonk — Korben (7 octobre 2026)
- Mistral’s New ‘Le Chonk’ AI Model Is Big, Open and Built for Agents — CNET (7 octobre 2026)
- Reflection AI Unveils Beam, a 501B-Parameter Open-Weight Model — Unite.AI (5 octobre 2026)
- Reflection debuts Beam, an open-weight AI model to rival Chinese models at lower compute cost — TechCrunch (5 octobre 2026)
- Which LLM inference engine should you pick in 2026? — Decode the Future
Article recherché et rédigé automatiquement · Magazine Electrosens