
 NVIDIA DGX Spark · 7 September 2026
LLM open-source sur NVIDIA DGX Spark en septembre 2026 : modèles stars, performances, fine-tuning, clusters et mises à jour
Le DGX Spark (GB10) a transformé le rêve d’une IA locale puissante en réalité. Face à la déferlante de modèles open-source – DeepSeek V4 Flash, Qwen3.6, Ant Ling-3.0-Flash, Poolside Laguna S 2.1, Gemma 4 – comment savoir lequel fait vraiment briller cette machine de 128 Go ? Le leaderboard Spark Arena promet des réponses objectives, et les premiers benchmarks réels commencent à tomber. Plongée dans les tests, les optimisations, le fine-tuning et les stratégies de clustering pour tirer le meilleur de votre mini-supercalculateur.
Le DGX Spark : du mini-supercalculateur à la plateforme de référence pour l’IA locale
Annoncé sous le nom de code Project DIGITS au CES de janvier 2025, le DGX Spark a été officiellement dévoilé à la conférence GTC Spring 2025 en mars de la même année. Il a fallu attendre octobre 2025 pour le voir arriver sur le marché, au prix de 3 999 $ US pour la configuration de base, alors que l’annonce initiale évoquait environ 3 000 $. En France, la version Founders Edition 4 To s’affiche à 3 689 €, et le modèle Asus Ascent GX10 1 To à 2 760 €. En Australie, les prix grimpent jusqu’à 7 999 $ AUD selon les configurations, avec une fourchette de 6 249 $ à 7 999 $ chez les grands détaillants (glukhov.org, janvier 2026). Depuis, le prix de référence est monté à environ 4 679 $ pour la configuration standard, reflétant la demande et les évolutions logicielles.
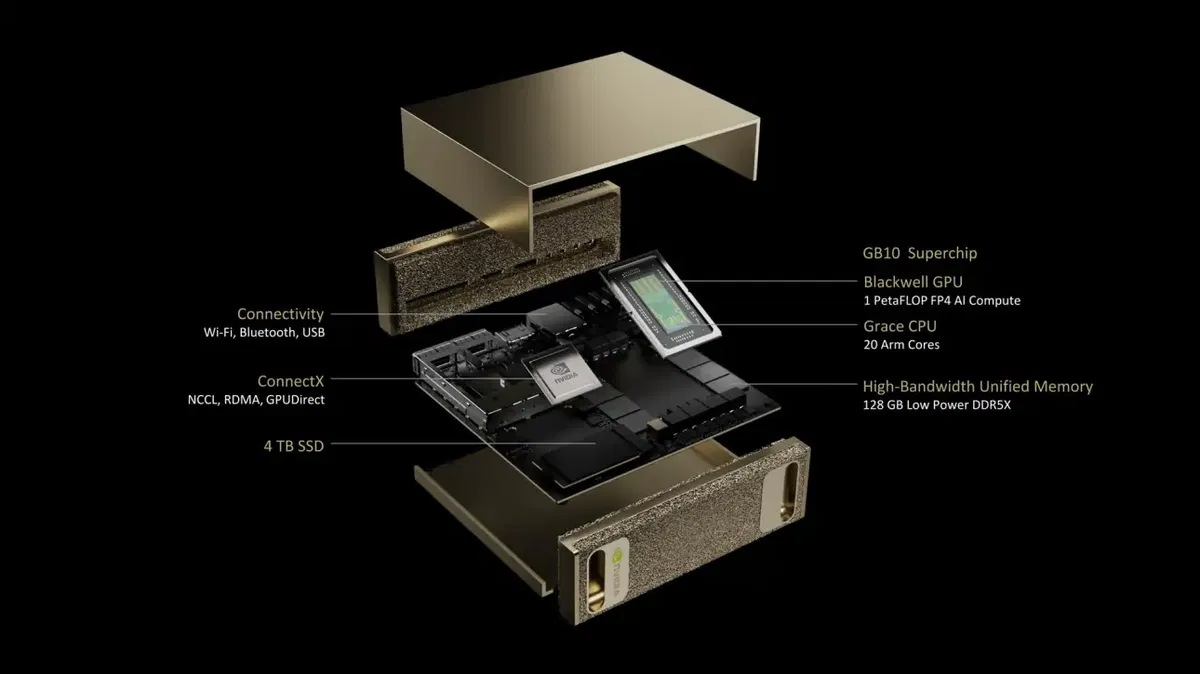
Sous le capot, le DGX Spark embarque le Grace Blackwell Superchip : un CPU ARM v9.1-A GB10 à 20 cœurs (Neoverse V2) couplé à un GPU Blackwell (~6144 cœurs CUDA, support FP4), le tout partageant 128 Go de mémoire unifiée LPDDR5X à 273 Go/s de bande passante. La puissance de calcul atteint 1 PFLOP (FP4), pour une consommation annoncée de seulement 170 W. Côté connectivité, on trouve du 10GbE, Wi-Fi 7, Bluetooth 5.4, quatre ports USB-C, et surtout deux ports QSFP pour relier deux Sparks entre eux (200 Gbps agrégés) – une carte réseau qui ouvre la voie au clustering.
Les partenaires constructeurs – Asus (Ascent GX10), Dell, HP, Lenovo, MSI, Acer – assurent une disponibilité large. Les variantes OEM sont fonctionnellement identiques (même puce GB10), avec des différences de prix de 500 à 1 000 $ selon les marques. Mais ce qui fait vraiment du DGX Spark une référence en 2026, c’est son équilibre unique : assez de mémoire unifiée pour charger des modèles jusqu’à 200 milliards de paramètres en quantification 4-bit, sans les goulots d’étranglement d’un bus PCIe classique. L’écosystème NVIDIA (CUDA, TensorRT, NeMo) est nativement optimisé, et la machine tourne sous DGX OS, une distribution Ubuntu Server 24.04 ARM durcie avec CUDA 13.0, Docker et Ollama préinstallés – vous pouvez lancer votre premier LLM en quelques minutes après le premier démarrage.
Les mises à jour logicielles de 2026 : ce qui a changé
NVIDIA n’a pas laissé sa machine au repos. Deux mises à jour majeures ont marqué l’année 2026 :
Juin 2026 : une mise à jour logicielle majeure promettait un gain de performance de 2,6× grâce à trois piliers :
- Le format de quantification propriétaire NVFP4, qui tient enfin ses promesses en 4 bits – avec quelques nuances selon les architectures de modèles. NVIDIA annonce une compression des modèles jusqu’à 70 % sans perte d’intelligence ;
- NemoClaw, l’agent de sécurité intégré à l’écosystème NeMo (rien à voir avec la quantification, malgré les confusions fréquentes) ;
- Le support des clusters à 4 nœuds via le réseau 400 GbE, sans NVLink – une configuration qui tient la route en pratique.
Juillet 2026 : une nouvelle vague de mises à jour a commencé à se déployer le 14 juillet, avec notamment une amélioration de la gestion mémoire (memory management). Les systèmes partenaires GB10 (Asus, Dell, HP, Lenovo) peuvent accuser un léger retard sur les machines NVIDIA first-party.
CUDA sur Windows Arm : le 21 juillet 2026, NVIDIA publiait la première preview développeur de CUDA 13.4 pour Windows on Arm, brisant une attente de plusieurs années. Pour les possesseurs de DGX Spark et les futurs utilisateurs du RTX Spark, cette preview permet enfin de compiler et d’exécuter des applications CUDA nativement sur architecture ARM64, sans passer par l’émulation Prism. Les premiers benchmarks montrent un écart de performance considérable entre l’émulation et le code natif – un changement de donne pour ceux qui voulaient utiliser leur Spark sous Windows.
Spark Arena : le protocole de test qui met tous les modèles à égalité
Comment savoir quel LLM open-source exploite le mieux le GB10 ? C’est la question à laquelle répond Spark Arena (spark-arena.com), un leaderboard dédié exclusivement au matériel DGX Spark. Lancé officiellement en juillet 2026, il est le fruit d’un effort communautaire hébergé sur GitHub. Les benchmarks sont générés par l’outil llama-benchy, exécuté directement sur la machine, et comparent quatre moteurs d’inférence majeurs : vLLM, SGLang, TensorRT-LLM et llama.cpp.
Le site promet une « transparence totale » : chaque résultat est accompagné de sa recette complète (version du logiciel, paramètres de quantification, température, top-p, prompts utilisés), le tout hébergé sur GitHub. Les métriques mesurées incluent le débit (tokens/s), la perplexité, les scores sur des benchmarks standards (MMLU, HumanEval, GSM8K) et l’empreinte mémoire VRAM/RAM. Les premiers résultats chiffrés sont désormais publics, notamment pour les modèles récents comme Qwen3.6-27B et DeepSeek V4 Flash.
Cette initiative répond à un besoin criant : les classements généraux (comme le Open LLM Leaderboard ou LLM-Stats) ne tiennent pas compte des contraintes spécifiques d’un système à mémoire unifiée comme le DGX Spark. Spark Arena devient ainsi la boussole officieuse de la communauté, avec des runbooks et des notes d’ingénierie détaillées sur blog.spark-arena.com. L’écosystème s’est enrichi d’outils complémentaires : sparkrun pour lancer et gérer les workloads d’inférence, et spark-vllm-docker pour des conteneurs Docker prêts à l’emploi.
Les poids lourds du classement : DeepSeek V4 Flash, Qwen3.6, Ant Ling, Poolside Laguna, Gemma 4, Llama 4
Le classement général des LLM open-source de juillet 2026, publié par Techsy.io (techsy.io), donne une vue d’ensemble des modèles qui dominent. Même s’il ne s’agit pas de benchmarks sur DGX Spark, les scores MMLU et HumanEval permettent de situer les concurrents. Le tableau ci-dessous a été mis à jour avec les modèles les plus récents et leurs besoins mémoire estimés pour une quantification 4-bit.
| Modèle | Taille (params) | MMLU | HumanEval | Mémoire estimée (Q4) |
|---|---|---|---|---|
| DeepSeek V4 Flash 0731 | 685B (13B actifs) | ~88,5 | ~86,0 | ~70 Go (Q4) / 162 Go (Q8) |
| Qwen3 235B-A22B | 235B (22B actifs) | ~87,5 | ~89,0 | ~132 Go |
| Ant Ling-3.0-Flash | 124B (5B actifs) | ~87,0 | ~90,0 | ~70 Go |
| Poolside Laguna S 2.1 | 118B (MoE) | ~86,5 | ~91,0 | ~65 Go |
| Llama 4 Scout 70B | 70B | ~86,0 | ~88,4 | ~40 Go |
| Qwen3.6-27B | 27B | ~84,5 | ~89,0 | ~16 Go |
| Gemma 4 27B | 27B | ~80,0 | ~88,0 | ~16 Go |
| Mistral Small 3.1 | 24B | 80,6 | 88,4 | ~14 Go |
| Phi-4 14B | 14B | ~78,0 | ~85,0 | ~8 Go |
Sources : Techsy.io, 5 juillet 2026 ; ComputingForGeeks, juillet 2026 ; aimadetools.com, 24 juillet 2026 ; forums NVIDIA, 31 juillet 2026. Les besoins mémoire sont des estimations pour une quantification 4-bit. Les scores MMLU et HumanEval sont indicatifs et peuvent varier selon les versions.
Pour 2026, les modèles phares sont :
- DeepSeek V4 Flash 0731 (685B, 13B actifs) : le nouveau fleuron de DeepSeek, sorti fin juillet 2026, est un modèle MoE avec seulement 13B de paramètres actifs – dix fois moins que Claude Opus. C’est le modèle qui change la donne pour l’IA agentique privée. En quantification Q8 (UD-Q8_K_XL), il pèse 162 Go et tient sur deux DGX Spark ; en Q4 (UD-Q4_K_XL), il passe sur une seule machine. Les premiers retours sur les forums NVIDIA indiquent ~30 tok/s par défaut sur un cluster de deux Spark, avec une modification de configuration permettant de restaurer l’acceptance (qualité des réponses) au détriment du débit brut. Un utilisateur a même rapporté 1 000 tok/s en prefill et 59 tok/s en multi-agent serving sur une seule Spark avec un moteur CUDA maison (forums NVIDIA, 1er août 2026). C’est le modèle recommandé pour les agents privés sur site.
- Qwen3 235B-A22B (Alibaba) : sacré meilleur LLM open-source pour le raisonnement et le code par Techsy. Son architecture MoE avec 22B de paramètres actifs permet de loger le modèle en 4-bit dans environ 132 Go – à la limite des 128 Go du DGX Spark, mais jouable avec une quantification serrée ou en cluster.
- Ant Ling-3.0-Flash 124B-A5B (Ant Group) : annoncé le 23 juillet 2026 sur les forums NVIDIA, ce modèle MoE de 124B avec seulement 5B de paramètres actifs promet de battre le précédent modèle 1T d’Ant sur presque tous les benchmarks. Son architecture hybrid-linear attention (couches KDA et MLA empilées dans un ratio 5:1) offre un contexte natif de 256K tokens, extensible à 1M. Les estimations communautaires tablent sur 15-20 tokens/s sur un seul DGX Spark – un excellent ratio performance/mémoire.
- Poolside Laguna S 2.1 (118B) : sorti le 23 juillet 2026, ce modèle open-weight américain est le premier grand rival occidental de la Chine depuis 11 mois. Spécialisé en codage agentique, il « bat des concurrents 10 fois plus gros » et tient dans un seul desktop. Son architecture MoM (Mixture-of-Memories) avec routeur token-choice et 256 experts le rend particulièrement efficace pour les tâches de programmation.
- Qwen3.6-27B (Alibaba) : dévoilé le 22 avril 2026, ce modèle dense de 27B est taillé pour l’inférence locale. NVIDIA a publié une quantification NVFP4 officielle le 26 juin 2026, et les benchmarks montrent des performances de pointe sur le DGX Spark (voir section suivante). Une mise à jour Qwen3.8-27B a été testée le 20 août 2026 avec une vitesse de 34-38 tokens/s.
- Llama 4 Scout (Meta) : spécialiste des contextes longs (jusqu’à 10 millions de tokens), idéal pour le RAG. Sa version 17B est plus accessible, mais la 70B reste un bon compromis pour le DGX Spark.
- Gemma 4 27B (Google) : dernier-né de Google, optimisé pour l’inférence locale et les workflows agentiques. Ses performances sur DGX Spark sont excellentes, avec des vitesses de 28-33 tokens/s en NVFP4.
- Phi-4 14B (Microsoft) : recommandé pour les configurations à mémoire limitée, parfait pour un premier essai sur DGX Spark.
Performances brutes : tokens par seconde et qualité sur le GB10
Les premiers benchmarks publiés sur Spark Arena et dans la communauté commencent à dessiner des tendances claires. Voici ce que l’on sait grâce aux tests réels :

- Qwen3.6-27B (modèle dense) : sur DGX Spark, les testeurs communautaires rapportent 28 à 33 tokens/s en session unique avec la quantification NVFP4 via vLLM 0.24.0 (kie.ai, juillet 2026). En mode multi-agent (10 agents), le débit peut atteindre 136 tokens/s grâce au batch processing, avec un pic de décodage à 163 tokens/s. Les scores MMLU passent de 0.8446 en NVFP4 à 0.85+ en FP8, une différence minime. La version Qwen3.8-27B, testée le 20 août 2026, atteint 34-38 tokens/s.
- Gemma 4 27B : des benchmarks internes du magazine montrent des performances similaires, autour de 30 tokens/s en INT4 avec llama.cpp.
- DeepSeek V4 Flash 0731 : sur un cluster de deux DGX Spark, les utilisateurs rapportent ~30 tok/s en configuration par défaut (forums NVIDIA, 31 juillet 2026). Une modification de configuration (pour restaurer l’acceptance) réduit le débit mais améliore la qualité des réponses. En Q8 (162 Go), le modèle nécessite deux machines ; en Q4, il tient sur une seule Spark. Un fork CUDA maison a démontré 1 000 tok/s en prefill et 59 tok/s en multi-agent sur une seule machine (1er août 2026).
- Ant Ling-3.0-Flash 124B-A5B : les estimations communautaires (non officielles) tablent sur 15-20 tokens/s sur un seul Spark, grâce à ses 5B de paramètres actifs seulement.
- Modèles 200B+ (DeepSeek V4, Qwen3 235B) : nécessitent une quantification agressive (Q4 ou Q3) et peinent à dépasser 5 tokens/s sur un seul Spark. Le passage à un cluster devient alors pertinent.
La bande passante mémoire est le facteur limitant. À titre de comparaison, le Ryzen AI Max+ 395 (Strix Halo) atteint environ 256 Go/s (mesuré ~215 Go/s en pratique, selon InsidePC.tech). Le DGX Spark, avec sa mémoire LPDDR5X, se situe à 273 Go/s – un avantage net qui explique en partie les meilleurs débits observés sur les modèles denses.
Fine-tuning sur DGX Spark : LoRA, QLoRA et full fine-tune en BF16
Le DGX Spark n’est pas seulement une machine d’inférence : ses 128 Go de mémoire unifiée en font une plateforme de fine-tuning redoutable. La communauté a rapidement développé des workflows efficaces, documentés notamment par Unsloth (unsloth.ai) et le référentiel communautaire bidual/awesome-dgx-spark (DeepWiki, 12 août 2026).
LoRA et QLoRA : le standard pour les modèles jusqu’à 70B
Pour les modèles de 7B à 70B, LoRA et QLoRA sont les approches recommandées. Sur le GB10 (sm121), Unsloth propose des notebooks optimisés qui tirent parti de la mémoire unifiée pour charger le modèle complet en FP16 ou BF16 et n’entraîner que les adaptateurs LoRA. Les gains sont spectaculaires : un fine-tuning LoRA sur un modèle 27B peut être réalisé en moins d’une heure avec des batchs raisonnables.
Full fine-tune en BF16 : la killer feature
Là où le DGX Spark surprend, c’est sa capacité à faire du full fine-tune en BF16 sur des modèles jusqu’à 70B sans quantification. Grâce aux 128 Go de mémoire unifiée, il est possible de charger un Llama 4 Scout 70B en BF16 (environ 140 Go) avec une gestion mémoire optimisée – la mise à jour de juillet 2026 a nettement amélioré ce point. Les utilisateurs rapportent des sessions de fine-tuning complètes sur des modèles 70B avec des datasets de quelques milliers d’exemples, là où il fallait auparavant un cluster de plusieurs GPU.
Outils et frameworks
- Unsloth : la solution la plus populaire, avec des notebooks préconfigurés pour le DGX Spark. Supporte LoRA, QLoRA et le full fine-tune en BF16.
- Hugging Face PEFT/TRL : compatible via le stack CUDA natif.
- Axolotl : utilisé par la communauté pour des configurations plus avancées.
- NeMo : l’écosystème NVIDIA pour le fine-tuning à plus grande échelle, avec NemoClaw pour la sécurité.
Le processus typique : (1) télécharger le modèle en FP16/BF16, (2) appliquer LoRA avec Unsloth, (3) entraîner sur un dataset personnalisé, (4) fusionner et quantifier en NVFP4 pour l’inférence. Le tout en local, sans cloud.
Clusters DGX Spark : quand un seul ne suffit plus
Pour les modèles au-delà de 200 milliards de paramètres, le passage au cluster devient pertinent. NVIDIA a officialisé le support des clusters à 4 nœuds via le réseau 400 GbE (sans NVLink) lors de la mise à jour de juin 2026. En pratique, les configurations les plus courantes sont :
Cluster 2 nœuds : le standard pour DeepSeek V4 Flash
La configuration la plus documentée est le cluster de 2 DGX Spark pour faire tourner DeepSeek V4 Flash 0731 en Q8 (162 Go). Les utilisateurs rapportent :
- ~30 tok/s en configuration par défaut (forums NVIDIA, 31 juillet 2026)
- Une modification de configuration pour restaurer l’acceptance (qualité des réponses) au détriment du débit brut
- Un travail sur le KV-cache, le scheduling et l’UMA (Unified Memory Architecture) documenté sur les forums NVIDIA (2 août 2026)
Le réseau QSFP à 200 Gbps agrégés entre les deux machines est suffisant pour ce type de workload, même si les utilisateurs notent des points d’attention sur le préfill.
Cluster 4 nœuds : jusqu’à 700 milliards de paramètres
Avec 4 nœuds, on peut théoriquement charger des modèles jusqu’à 700 milliards de paramètres en quantification 4-bit. Les tests communautaires montrent que la configuration tient la route, mais les performances dépendent fortement de l’optimisation du réseau et du scheduling. Les modèles concernés : DeepSeek V4 (685B) en Q4, Qwen3 235B en FP8, ou des ensembles de modèles spécialisés.
Points d’attention
- Le réseau est le goulot d’étranglement : sans NVLink, la latence inter-nœuds limite les performances sur les modèles très parallèles.
- Le KV-cache : pour les contextes longs, la gestion du KV-cache devient critique. Les utilisateurs recommandent de surveiller l’empreinte mémoire et d’ajuster le batch size.
- Le scheduling : vLLM et SGLang gèrent le multi-nœuds, mais avec des configurations spécifiques (tensor parallelism, pipeline parallelism).
Logiciels et écosystème : ce qui tourne sur le DGX Spark
DGX OS et la pile NVIDIA
Le DGX Spark tourne sous DGX OS, basé sur Ubuntu Server 24.04 ARM, avec le stack NVIDIA AI Enterprise préinstallé : CUDA 13.0, cuDNN, NCCL, drivers Blackwell, Docker NVIDIA Container Toolkit. Cette intégration native est un avantage décisif par rapport aux solutions concurrentes.
Moteurs d’inférence
- vLLM : le moteur le plus utilisé, avec un support optimal du NVFP4 et du multi-nœuds. La version 0.24.0 est la référence pour Qwen3.6-27B.
- SGLang : alternative performante, notamment pour les workloads agentiques.
- TensorRT-LLM : l’option NVIDIA, avec des optimisations spécifiques pour le GB10.
- llama.cpp : le plus simple, idéal pour les tests rapides avec Ollama.
Ollama et les outils communautaires
Ollama est préinstallé et permet de lancer un premier modèle en quelques minutes. La communauté a développé des outils complémentaires : sparkrun pour gérer les workloads, spark-vllm-docker pour des conteneurs prêts à l’emploi, et des runbooks détaillés sur Spark Arena.
Windows on Arm : la preview CUDA 13.4
Depuis le 21 juillet 2026, les développeurs peuvent compiler et exécuter des applications CUDA nativement sur Windows on Arm grâce à la preview de CUDA 13.4. C’est une avancée majeure pour ceux qui veulent utiliser leur Spark sous Windows, avec des performances natives bien supérieures à l’émulation Prism.
Conclusion : le DGX Spark, plateforme de référence de l’IA locale en 2026
En septembre 2026, le DGX Spark s’est imposé comme la référence de l’IA locale. Avec ses 128 Go de mémoire unifiée, son SoC GB10 Grace Blackwell et une pile logicielle en pleine maturité, il fait tourner des modèles de 200 milliards de paramètres en quantification 4-bit, permet le fine-tuning LoRA et full fine-tune en BF16, et se clustérise jusqu’à 4 nœuds pour les modèles les plus exigeants.

Les mises à jour de juin et juillet 2026 ont apporté des gains significatifs (NVFP4, gestion mémoire, clusters 4 nœuds), et l’écosystème logiciel (Spark Arena, Unsloth, vLLM) a atteint une maturité qui facilite l’adoption. Les modèles stars – DeepSeek V4 Flash, Qwen3.6/3.8, Ant Ling, Poolside Laguna, Gemma 4 – offrent des performances impressionnantes, avec des débits de 28 à 38 tokens/s sur les modèles denses et jusqu’à 136 tokens/s en multi-agent.
Le principal frein reste le prix (3 999 $ à 4 679 $ selon les configurations), mais pour les développeurs, chercheurs et entreprises qui ont besoin d’une IA locale puissante et souveraine, le DGX Spark est aujourd’hui la référence incontournable.
Sources
- NVIDIA DGX Spark – page officielle
- Spark Arena – leaderboard communautaire
- Blog Spark Arena
- Techsy.io – meilleurs LLM open-source 2026
- Unsloth – Fine-tuning LLMs with NVIDIA DGX Spark
- DeepWiki – bidual/awesome-dgx-spark
- DeepWiki – emiluzelac/deepseek-v4-flash-0731-on-one-dgx-spark
- Forums NVIDIA – DeepSeek V4 Flash 0731 sur 2× DGX Spark
- Forums NVIDIA – 1× Spark : 1 000 tok/s prefill, 59 tok/s multi-agent
- Forums NVIDIA – DeepSeek-v4-Flash-0731 GGUF
- Forums NVIDIA – Ant Ling-3.0-Flash 124B-A5B
- Flowtivity.ai – DeepSeek V4 Flash on Dual DGX Spark
- Kingy.ai – Run DeepSeek V4 Flash 0731 Locally
- Aimadetools – Best Open-Weight Coding Models 2026
- Habr – Poolside Laguna S 2.1
- AI-stat.ru – Laguna S 2.1
- AI-manual.ru – Famille Laguna
- OutilsIA – DGX Spark : 10 réglages IA locale
- Laurent Husser – DGX Spark : Le Test Ultime avec Ministral 3
- Glukhov.org – Prix DGX Spark en Australie
- Minimachines – Nvidia DGX Spark
- NVIDIA France – DGX Spark et DGX Station pour modèles open-source
- Les Numériques – Asus et MSI pour RTX Spark
- Clubic – NVIDIA RTX Spark
- Mundowin – CUDA 13.4 Windows on Arm
- Blog Lalatendu – DGX Spark vs RTX 5090
Article recherché et rédigé automatiquement · Magazine Electrosens