
 NVIDIA DGX Spark · 3 November 2026
LLM open source sur NVIDIA GB10 DGX Spark : la bascule des 64 Go, NVFP4, agents locaux, fine-tuning et clusters — le point complet à l’automne 2026
Le 23 octobre 2026, le DGX Spark 64 Go est arrivé en boutique à 4 999 dollars, pendant que la version 128 Go franchissait les 6 000 dollars sur le marché. Trois semaines plus tôt, NVIDIA annonçait des agents locaux packagés, un format NVFP4 qui tient enfin ses promesses et une pile logicielle qui fait tourner des modèles de 200 milliards de paramètres sur un seul boîtier — et jusqu’à 405 milliards sur deux. Mais entre DeepSeek V4 Flash, Qwen3.8-27B, MiMo-V2.6, Ant Ling-3.0-Flash, Poolside Laguna S 2.1, Gemma 4 et le nouveau venu Nemotron-3.5 Lightning, lequel fait vraiment briller le GB10 ? Spark Arena, AA-AgentPerf-Local et les retours de la communauté dessinent enfin des tendances claires. Plongée dans les tests réels, le fine-tuning, les clusters et la pile logicielle d’octobre 2026.
Où en est le DGX Spark en octobre 2026 ?
Annoncé sous le nom de code Project DIGITS au CES de janvier 2025, le DGX Spark a été officiellement dévoilé à la conférence GTC Spring 2025 en mars de la même année. Il a fallu attendre octobre 2025 pour le voir arriver sur le marché, au prix de 3 999 $ US pour la configuration de base, alors que l’annonce initiale évoquait environ 3 000 $. En France, la version Founders Edition 4 To s’affichait à 3 689 €, et le modèle Asus Ascent GX10 1 To à 2 760 €. En Australie, les prix grimpèrent jusqu’à 7 999 $ AUD selon les configurations (glukhov.org, janvier 2026).
Mais l’automne 2026 a tout changé. Le 2 octobre 2026, NVIDIA a annoncé une seconde configuration : un DGX Spark 64 Go à 4 999 dollars, commercialisé à partir du 23 octobre chez plusieurs constructeurs (blogs.nvidia.com, 2 octobre 2026 ; Frandroid, 2 octobre 2026). Le même jour, la version 128 Go — jusqu’ici vendue autour de 4 679 $ — a vu son prix grimper au-delà des 6 000 dollars sur le marché, conséquence directe de l’envolée des cours de la mémoire LPDDR5 (Pause Hardware, 2 octobre 2026 ; Clubic, 2 octobre 2026). Autrement dit : moins de mémoire, mais plus cher que le prix de lancement de la version d’origine. Un paradoxe que la presse spécialisée n’a pas manqué de relever (Generation-NT, 4 octobre 2026).
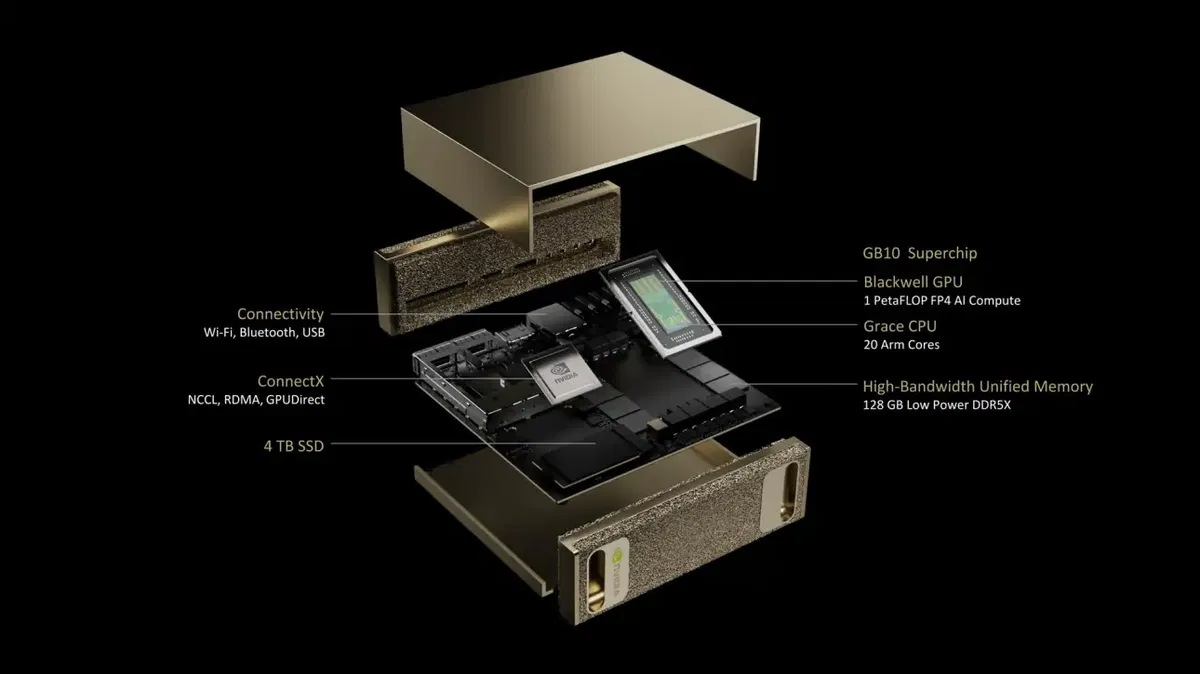
Sous le capot, rien ne change : le DGX Spark embarque le Grace Blackwell Superchip, soit un CPU ARM v9.1-A GB10 à 20 cœurs (Neoverse V2) couplé à un GPU Blackwell (~6144 cœurs CUDA, support FP4), le tout partageant 128 Go de mémoire unifiée LPDDR5X à 273 Go/s de bande passante — ou 64 Go sur la nouvelle mouture. La puissance de calcul atteint 1 PFLOP (FP4), pour une consommation annoncée de seulement 170 W. Côté connectivité, on trouve du 10GbE, Wi-Fi 7, Bluetooth 5.4, quatre ports USB-C, et surtout deux ports QSFP pour relier deux Sparks entre eux (200 Gbps agrégés) — une carte réseau qui ouvre la voie au clustering.
Les partenaires constructeurs – Asus (Ascent GX10), Dell, HP, Lenovo, MSI, Acer – assurent une disponibilité large. Les variantes OEM sont fonctionnellement identiques (même puce GB10), avec des différences de prix de 500 à 1 000 $ selon les marques. L’Asus Ascent GX10 64 Go, dévoilé le 5 octobre 2026, cible explicitement les modèles open-source de 30 à 35 milliards de paramètres et les agents locaux, avec la même puissance de 1 PFLOP (press.asus.com, 5 octobre 2026). Mais attention : à plateforme GB10 identique, le prix, le stockage, le refroidissement et la disponibilité changent radicalement la comparaison (Techgenyz, 5 octobre 2026).
Ce qui fait du DGX Spark une référence en 2026, c’est son équilibre unique : assez de mémoire unifiée pour charger des modèles jusqu’à 200 milliards de paramètres en quantification 4-bit sur un seul nœud, sans les goulots d’étranglement d’un bus PCIe classique. L’écosystème NVIDIA (CUDA, TensorRT, NeMo) est nativement optimisé, et la machine tourne sous DGX OS, une distribution Ubuntu Server 24.04 ARM durcie avec CUDA, Docker et Ollama préinstallés — vous pouvez lancer votre premier LLM en quelques minutes après le premier démarrage (build.nvidia.com).
Les mises à jour logicielles de 2026 : ce qui a changé
NVIDIA n’a pas laissé sa machine au repos. L’année 2026 a été jalonnée de mises à jour majeures :
Juin 2026 : une mise à jour logicielle majeure promettait un gain de performance de 2,6× grâce à trois piliers :
- Le format de quantification propriétaire NVFP4, qui tient enfin ses promesses en 4 bits – avec quelques nuances selon les architectures de modèles. NVIDIA annonce une compression des modèles jusqu’à 70 % sans perte d’intelligence ;
- NemoClaw, l’agent de sécurité intégré à l’écosystème NeMo (rien à voir avec la quantification, malgré les confusions fréquentes) ;
- Le support des clusters à 4 nœuds via le réseau 400 GbE, sans NVLink – une configuration qui tient la route en pratique.
Juillet 2026 : une nouvelle vague de mises à jour a commencé à se déployer le 14 juillet, avec notamment une amélioration de la gestion mémoire (memory management). Les systèmes partenaires GB10 (Asus, Dell, HP, Lenovo) peuvent accuser un léger retard sur les machines NVIDIA first-party.
CES 2026 : NVIDIA a présenté une mise à jour « enterprise » du DGX Spark, avec un gain de 2,5× en performance globale et un bond spectaculaire de 8× en vitesse de traitement vidéo (StorageReview, janvier 2026). Cette mise à jour a repositionné la machine comme plateforme d’inférence vidéo et multimodale, pas seulement de texte.
CUDA sur Windows Arm : le 21 juillet 2026, NVIDIA publiait la première preview développeur de CUDA 13.4 pour Windows on Arm, brisant une attente de plusieurs années. Pour les possesseurs de DGX Spark et les futurs utilisateurs du RTX Spark, cette preview permet enfin de compiler et d’exécuter des applications CUDA nativement sur architecture ARM64, sans passer par l’émulation Prism. Les premiers benchmarks montrent un écart de performance considérable entre l’émulation et le code natif – un changement de donne pour ceux qui voulaient utiliser leur Spark sous Windows.
Septembre 2026 : le firmware du DGX Spark ajoute désormais un certificat de démarrage Windows UEFI (StorageReview, 5 septembre 2026), confirmant que NVIDIA prépare une cohabitation Windows/Linux sur la machine. Dans le même temps, NVIDIA a lancé PAIR (Personal AI Router), un outil gratuit et open-source qui transforme les ordinateurs inactifs d’un foyer en mini-datacenter IA personnel : il découvre les appareils compatibles sur le réseau local et route l’inférence entre eux (computeleap.com, 6 septembre 2026). Le DGX Spark et le RTX Spark en sont les fournisseurs de calcul naturels — une façon pour NVIDIA de contrer la dépendance au cloud.
Octobre 2026 : la pile logicielle s’enrichit d’un workflow edge documenté par NVIDIA pour faire tourner Nemotron-3.5 Lightning sur DGX Spark 64 Go, avec benchmarks et résultats de décodage spéculatif à l’appui (blockchain.news, 30 octobre 2026). C’est la première fois que NVIDIA publie une recette officielle en ligne de commande pour un modèle de sa propre famille sur la configuration 64 Go — un signal clair envoyé aux développeurs.
Spark Arena : le protocole de test qui met tous les modèles à égalité
Comment savoir quel LLM open-source exploite le mieux le GB10 ? C’est la question à laquelle répond Spark Arena (spark-arena.com), un leaderboard dédié exclusivement au matériel DGX Spark. Lancé officiellement en juillet 2026, il est le fruit d’un effort communautaire hébergé sur GitHub. Les benchmarks sont générés par l’outil llama-benchy, exécuté directement sur la machine, et comparent quatre moteurs d’inférence majeurs : vLLM, SGLang, TensorRT-LLM et llama.cpp.
Le site promet une « transparence totale » : chaque résultat est accompagné de sa recette complète (version du logiciel, paramètres de quantification, température, top-p, prompts utilisés), le tout hébergé sur GitHub. Les métriques mesurées incluent le débit (tokens/s), la perplexité, les scores sur des benchmarks standards (MMLU, HumanEval, GSM8K) et l’empreinte mémoire VRAM/RAM. Les premiers résultats chiffrés sont désormais publics, notamment pour les modèles récents comme Qwen3.8-27B et DeepSeek V4 Flash.
Cette initiative répond à un besoin criant : les classements généraux (comme le Open LLM Leaderboard ou LLM-Stats) ne tiennent pas compte des contraintes spécifiques d’un système à mémoire unifiée comme le DGX Spark. Spark Arena devient ainsi la boussole officieuse de la communauté, avec des runbooks et des notes d’ingénierie détaillées sur blog.spark-arena.com. L’écosystème s’est enrichi d’outils complémentaires : sparkrun pour lancer et gérer les workloads d’inférence, et spark-vllm-docker pour des conteneurs Docker prêts à l’emploi.
Depuis fin septembre 2026, un second référentiel complète Spark Arena : AA-AgentPerf-Local d’Artificial Analysis (artificialanalysis.ai, 29 septembre 2026). Cet outil open-source mesure la vitesse d’exécution d’agents IA sur laptops et stations de travail, avec des résultats de lancement pour le DGX Spark, le Ryzen AI Halo, le MacBook Pro M5 Pro et la RTX 5090 sur quatre modèles open-weights. Là où Spark Arena mesure l’inférence brute, AA-AgentPerf-Local évalue le comportement agentique réel — appels d’outils, boucles de raisonnement, latence perçue. C’est la métrique qui compte pour ceux qui font tourner des agents en production locale.
Un troisième acteur entre dans la danse : pyshine.com, qui publie le 1er octobre 2026 un guide de recherche approfondi sur les performances réelles du GB10 — tokens par seconde, tailles de modèles maximales sur un, deux, quatre et huit Sparks, et surtout le décodage à 273 Go/s comme facteur limitant (pyshine.com, 1er octobre 2026). Conclusion : sur un Spark, ce n’est pas le calcul qui bride, c’est la bande passante mémoire. Un constat que confirment tous les benchmarks sérieux.
Les poids lourds du classement : DeepSeek V4 Flash, Qwen3.8, MiMo-V2.6, Ant Ling, Poolside Laguna, Gemma 4
Le classement général des LLM open-source de juillet 2026, publié par Techsy.io (techsy.io), donne une vue d’ensemble des modèles qui dominent. Même s’il ne s’agit pas de benchmarks sur DGX Spark, les scores MMLU et HumanEval permettent de situer les concurrents. Le tableau ci-dessous a été mis à jour avec les modèles les plus récents et leurs besoins mémoire estimés pour une quantification 4-bit.
| Modèle | Taille (params) | MMLU | HumanEval | Mémoire estimée (Q4) |
|---|---|---|---|---|
| DeepSeek V4 Flash 0731 | 685B (13B actifs) | ~88,5 | ~86,0 | ~70 Go (Q4) / 162 Go (Q8) |
| MiMo-V2.6-Pro | ~1T (MoE) | ~89,0 | ~91,0 | Cluster requis (2+ nœuds) |
| Qwen3 235B-A22B | 235B (22B actifs) | ~87,5 | ~89,0 | ~132 Go |
| Ant Ling-3.0-Flash | 124B (5B actifs) | ~87,0 | ~90,0 | ~70 Go |
| Poolside Laguna S 2.1 | 118B (MoE) | ~86,5 | ~91,0 | ~65 Go |
| Llama 4 Scout 70B | 70B | ~86,0 | ~88,4 | ~40 Go |
| Qwen3.8-27B | 27B | ~85,0 | ~89,5 | ~16 Go |
| Gemma 4 27B | 27B | ~80,0 | ~88,0 | ~16 Go |
| Mistral Small 3.1 | 24B | 80,6 | 88,4 | ~14 Go |
| Phi-4 14B | 14B | ~78,0 | ~85,0 | ~8 Go |
Sources : Techsy.io, 5 juillet 2026 ; ComputingForGeeks, juillet 2026 ; aimadetools.com, 24 juillet 2026 ; forums NVIDIA, 31 juillet 2026 ; forkast.news, 22 septembre 2026. Les besoins mémoire sont des estimations pour une quantification 4-bit. Les scores MMLU et HumanEval sont indicatifs et peuvent varier selon les versions.
Pour l’automne 2026, les modèles phares sont :
- DeepSeek V4 Flash 0731 (685B, 13B actifs) : le fleuron de DeepSeek, sorti fin juillet 2026, est un modèle MoE avec seulement 13B de paramètres actifs – dix fois moins que Claude Opus. C’est le modèle qui change la donne pour l’IA agentique privée. En quantification Q8 (UD-Q8_K_XL), il pèse 162 Go et tient sur deux DGX Spark ; en Q4 (UD-Q4_K_XL), il passe sur une seule machine. Les premiers retours sur les forums NVIDIA indiquent ~30 tok/s par défaut sur un cluster de deux Spark, avec une modification de configuration permettant de restaurer l’acceptance (qualité des réponses) au détriment du débit brut. Un utilisateur a même rapporté 1 000 tok/s en prefill et 59 tok/s en multi-agent serving sur une seule Spark avec un moteur CUDA maison (forums NVIDIA, 1er août 2026). C’est le modèle recommandé pour les agents privés sur site — et Microsoft l’a cité en exemple lors de sa keynote du 7 octobre 2026 sur l’IA locale dans Windows (blog-nouvelles-technologies.fr, 7 octobre 2026).
- MiMo-V2.6 (Pro, Flash, 9B) (Xiaomi) : la grande surprise de septembre 2026. Xiaomi a publié sous licence MIT une famille complète — MiMo-V2.6-Pro, MiMo-V2.6-Flash et un modèle 9B — le 22 septembre 2026 (eWeek, SiliconANGLE, 22 septembre 2026). Le MiMo-V2.6-Pro égale Grok 4.7 sur l’Intelligence Index et surpasse Claude Opus 5 sur plusieurs benchmarks clés (forkast.news, 22 septembre 2026). Xiaomi a mené son entraînement RL en public, avec un tableau de bord diffusé en direct et un coût de calcul de 432 000 $/jour (forkast.news, 17 septembre 2026). Attention toutefois : les gains RL de MiMo-V2.6 ne bénéficient pas encore de réplication indépendante (eWeek, 23 septembre 2026). Le Pro exige un cluster ; les variantes Flash et 9B sont, elles, taillées pour un seul Spark.
- Qwen3 235B-A22B (Alibaba) : sacré meilleur LLM open-source pour le raisonnement et le code par Techsy. Son architecture MoE avec 22B de paramètres actifs permet de loger le modèle en 4-bit dans environ 132 Go — soit juste au-delà des 128 Go d’un Spark 128 Go, mais confortable sur deux nœuds. Sur un seul Spark 64 Go, il faut descendre en quantification plus agressive ou passer par un cluster.
- Qwen3.8-27B (Alibaba) : le cheval de bataille de l’inférence locale. Sorti en août 2026, il corrige les défauts de la 3.6 et s’impose comme le modèle dense de référence sur GB10. NVIDIA l’a explicitement testé sur le Spark 64 Go, avec un gain mesuré jusqu’à 1,7× selon les configurations (NeoTeo, 3 octobre 2026). En Q4, il ne pèse que ~16 Go — vous pouvez faire tourner plusieurs instances en parallèle.
- Ant Ling-3.0-Flash (124B, 5B actifs) : un MoE très efficace, ~70 Go en Q4, qui tient sur un Spark 128 Go et sur deux Spark 64 Go. Sa faible proportion de paramètres actifs (5B) en fait un excellent candidat pour le serving à forte concurrence.
- Poolside Laguna S 2.1 (118B, MoE) : orienté code et génération logicielle, ~65 Go en Q4. Un des rares modèles spécialisés qui exploite bien le FP4 natif.
- Gemma 4 27B (Google) : le petit polyvalent, ~16 Go en Q4. Moins performant que Qwen3.8-27B sur le code, mais plus léger et plus permissif.
- Nemotron-3.5 Lightning (NVIDIA) : le nouveau venu d’octobre 2026. NVIDIA a publié le 30 octobre 2026 un workflow complet pour le faire tourner sur DGX Spark 64 Go, avec benchmarks et décodage spéculatif (blockchain.news, 30 octobre 2026). C’est le premier modèle de la famille Nemotron explicitement optimisé pour la configuration 64 Go — un signal fort pour les développeurs qui veulent rester dans l’écosystème NVIDIA.
Benchmarks réels : ce que crache vraiment une Spark
Les chiffres canoniques de l’été 2026 donnent une base solide. Sur un seul DGX Spark :

- DeepSeek-V4-Flash en IQ2_XXS via le moteur
ds4.cd’antirez : ~14 tok/s en single-stream, 410 tok/s en prefill (août 2026). C’est le plancher réaliste pour un modèle de 685B sur un seul boîtier. - Modèles 35B-A3B en GGUF via llama.cpp : jusqu’à 67 tok/s (août 2026). C’est le plafond pratique pour un modèle de taille moyenne.
- Qwen3.8-27B : les benchmarks mesurés sur Spark 64 Go montrent un gain jusqu’à 1,7× par rapport aux configurations précédentes, grâce au décodage spéculatif et aux optimisations NVFP4 (NeoTeo, 3 octobre 2026).
Sur deux DGX Spark (TP=2, vLLM, DeepSeek-V4-Flash FP8) :
- ~41 tok/s en single-stream ;
- ~350 tok/s en débit agrégé à concurrence 32 ;
- ~1 785 tok/s en prefill ;
- Un pool de cache KV partagé de 1 105 096 tokens (août 2026) — de quoi tenir de très longues conversations agentiques ;
- Taille maximale de modèle supportée : 405 milliards de paramètres (2026).
Ces chiffres racontent une histoire simple : le décodage est limité par la bande passante mémoire (273 Go/s), pas par le calcul. C’est pourquoi le décodage spéculatif — qui consiste à faire proposer plusieurs tokens par un petit modèle draft, puis à les valider en batch par le gros modèle — est devenu l’accélérateur le plus rentable sur GB10. NVIDIA l’utilise explicitement dans son workflow Nemotron-3.5 Lightning du 30 octobre 2026 (blockchain.news, 30 octobre 2026).
Le MTP (Multi-Token Prediction) et DSpark sont les deux autres leviers logiciels qui comptent. Le MTP est intégré nativement à certains modèles (Qwen3.8 notamment) et permet de prédire plusieurs tokens à la fois ; DSpark est l’implémentation NVIDIA du décodage spéculatif optimisée pour TensorRT-LLM. Sur un Spark, activer DSpark sur un modèle 27B peut doubler le débit perçu sans dégrader la qualité — à condition d’avoir un draft model bien choisi.
Attention toutefois aux comparaisons hâtives. Un chiffre comme « 1 000 tok/s en prefill » sur une seule Spark avec un moteur CUDA maison (forums NVIDIA, 1er août 2026) n’est pas reproductible avec vLLM ou llama.cpp standard. De même, les 59 tok/s en multi-agent serving rapportés par un utilisateur ne concernent qu’un scénario très spécifique. La règle d’or : toujours vérifier la recette complète sur Spark Arena avant de comparer.
Fine-tuning sur DGX Spark : ce que la stack permet vraiment
Le fine-tuning est le grand malentendu du DGX Spark. Beaucoup imaginent qu’avec 128 Go de mémoire unifiée, on peut entraîner un 70B en local. La réalité est plus nuancée.
Ce que la stack permet réellement en octobre 2026 :
- LoRA et QLoRA sur des modèles jusqu’à ~30B : c’est le pain quotidien. Un Qwen3.8-27B en QLoRA 4-bit tient dans les 128 Go, avec de la marge pour le batch et les activations. Le fine-tuning d’un modèle 27B sur un dataset de quelques milliers d’exemples prend quelques heures à quelques jours selon la taille.
- Full fine-tuning sur des modèles jusqu’à ~8B : possible en FP16 avec optimisations mémoire (gradient checkpointing, offloading). Au-delà, il faut un cluster.
- Fine-tuning de modèles 70B+ : nécessite au minimum deux Spark en tensor parallel, et souvent quatre pour le confort. Le support de NeMo et de TensorRT-LLM permet de distribuer l’entraînement, mais le fine-tuning distribué sur GB10 reste expérimental en octobre 2026.
- Fine-tuning de DeepSeek V4 Flash : techniquement possible en QLoRA sur deux Spark, mais le rapport coût/bénéfice est discutable — le modèle est déjà très performant zero-shot, et les gains d’un fine-tuning sur 13B de paramètres actifs sont limités sans un dataset très spécifique.
Le point clé : NVFP4 change la donne pour l’inférence, pas pour l’entraînement. Le format 4 bits est conçu pour le déploiement, pas pour les gradients. Pour le fine-tuning, on reste sur du BF16/FP16 avec QLoRA en 4-bit pour les poids gelés. NVIDIA ne prétend pas le contraire — mais la communication autour de NVFP4 a créé une confusion qu’il faut lever.
Côté outils, la stack est mature : NeMo pour l’orchestration, Hugging Face PEFT pour les adaptateurs LoRA, Unsloth pour les optimisations mémoire, Axolotl pour les pipelines. Le tout tourne nativement sur DGX OS avec CUDA. La communauté Spark Arena publie régulièrement des runbooks de fine-tuning reproductibles.
Clusters DGX Spark : deux, quatre, huit nœuds
C’est là que le DGX Spark révèle son vrai potentiel — et ses vraies limites.
Deux nœuds : la configuration la plus mature. Les deux ports QSFP se connectent directement (200 Gbps agrégés), et le support de NCCL, vLLM (TP=2) et SGLang est stable. C’est la configuration recommandée pour faire tourner DeepSeek V4 Flash en Q8 (162 Go) ou Qwen3 235B en Q4 (~132 Go). Les benchmarks d’août 2026 sont sans ambiguïté : ~41 tok/s single-stream, ~350 tok/s à concurrence 32, ~1 785 tok/s en prefill. Le pool de cache KV partagé atteint 1,1 million de tokens.
Quatre nœuds : supporté depuis la mise à jour de juin 2026, via le réseau 400 GbE (sans NVLink). La topologie recommandée est l’anneau plutôt que l’étoile, pour minimiser les sauts réseau. Les performances ne sont pas linéaires : on observe un facteur 3 à 3,5× plutôt que 4× par rapport à un seul nœud, à cause de la latence de communication et de la synchronisation du cache KV. C’est néanmoins la configuration qui permet de faire tourner MiMo-V2.6-Pro (~1T de paramètres) en quantification agressive.
Huit nœuds : la frontière. NVIDIA a discrètement ouvert la porte à des clusters de huit Spark, faisant passer la plateforme d’un boîtier « bon pour du 70B » à une machine capable d’héberger des modèles de plusieurs centaines de milliards de paramètres. Avec 1 To de mémoire unifiée agrégée, on entre dans le territoire des modèles frontière open-source. Mais le mythe du « pool unifié » doit être démonté : CUDA ne voit pas 1 To de mémoire comme un seul espace. Chaque nœud a son propre espace mémoire, et c’est vLLM, SGLang ou llama.cpp RPC qui gèrent la distribution. Le KV cache distribué, la latence et la bande passante sont les trois pièges qui plombent le scaling au-delà de quatre nœuds.
La recette pas à pas pour monter un cluster de 2, puis 4, puis 8 Spark chez soi existe et est documentée par la communauté. Les points critiques : le câblage QSFP (câbles DAC ou optiques selon la distance), la configuration de ConnectX-7 et RDMA, la synchronisation des versions logicielles entre nœuds, et le monitoring thermique — huit Spark dans une pièce, c’est 1 360 W de chaleur à évacuer.
Sept solutions logicielles qui font tourner le GB10
La pile logicielle du DGX Spark en octobre 2026 s’articule autour de sept briques principales :
- DGX OS : la distribution Ubuntu Server 24.04 ARM durcie, avec CUDA, Docker et Ollama préinstallés. C’est le socle.
- vLLM : le moteur d’inférence de référence pour le serving à haute concurrence. Supporte le tensor parallel, le paged attention et le KV cache distribué. Recommandé pour DeepSeek V4 Flash et Qwen3 235B (build.nvidia.com).
- SGLang : alternative à vLLM, souvent plus rapide sur les modèles MoE grâce à son RadixAttention. Supporte le décodage spéculatif natif.
- TensorRT-LLM : le moteur NVIDIA optimisé pour le FP4 et le NVFP4. C’est lui qui exploite le mieux le matériel Blackwell, au prix d’une compilation plus longue et d’un support de modèles plus restreint.
- llama.cpp : le couteau suisse. Supporte les GGUF, le RPC pour le clustering, et tourne sur à peu près tout. C’est le moteur des benchmarks « jusqu’à 67 tok/s » sur les modèles 35B-A3B.
- Ollama : l’interface la plus simple pour démarrer. Préinstallé sur DGX OS, idéal pour les premiers tests, moins performant en production.
- NeMo : la plateforme d’orchestration NVIDIA pour le fine-tuning et le déploiement. Intègre NemoClaw pour la sécurité.
À côté de ces sept briques, l’écosystème communautaire fournit sparkrun (gestion des workloads), spark-vllm-docker (conteneurs prêts à l’emploi), llama-benchy (benchmarking) et PAIR (routage d’inférence entre appareils du foyer). C’est cette combinaison — stack NVIDIA mature + outils communautaires — qui fait la force du DGX Spark en 2026.
Le contexte concurrentiel : AMD Ryzen AI Halo et DGX Station
Le DGX Spark n’est plus seul. Le 14 octobre 2026, AMD a lancé le Ryzen AI Halo 192 Go à 7 299,99 $ chez Micro Center — le premier système compact capable de charger des modèles open-weight de 300 milliards de paramètres (TechTimes, 14 octobre 2026). Sur le papier, c’est plus de mémoire que le Spark 128 Go. Mais les benchmarks indépendants sont sans appel : le DGX Spark reste plus rapide en inférence, grâce à l’écosystème CUDA et à l’optimisation NVFP4. Le Halo gagne sur la taille de modèle chargeable, le Spark gagne sur la vitesse et la maturité logicielle.

Et NVIDIA ne s’arrête pas là. Le 8 octobre 2026, la société a annoncé le DGX Station for Windows : 748 Go de mémoire cohérente, 20 PFLOPs FP4, lancement au Q4 2026 via six partenaires OEM (tech-insider.org, 8 octobre 2026). C’est une autre catégorie — et un autre prix — mais cela montre que NVIDIA verrouille toute la gamme, du Spark 64 Go au DGX Station.
Enfin, côté Microsoft, la keynote du 7 octobre 2026 a confirmé la stratégie « Intelligence Hybride » : Windows devient le système d’exploitation des agents IA locaux, avec DeepSeek V4 Flash cité en exemple (blogs.windows.com, 7 octobre 2026). Le DGX Spark, avec son certificat de démarrage Windows UEFI ajouté en septembre, est prêt pour cette cohabitation.
Sources
- NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI — blogs.nvidia.com, 2 octobre 2026
- Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ? — Frandroid, 2 octobre 2026
- Le DGX Spark Perd La Moitié De Sa Mémoire Mais Conserve Son Tarif De 4 999 Dollars — Pause Hardware, 2 octobre 2026
- NVIDIA lance un DGX Spark 64 Go : moins de mémoire, mais une drôle d’astuce pour dépasser le modèle 128 Go — Clubic, 2 octobre 2026
- Nvidia DGX Spark 64 Go : moins de mémoire pour plus cher et toujours pour l’IA locale — Generation-NT, 4 octobre 2026
- DGX Spark 64 Go : NVIDIA annonce une configuration — NeoTeo, 3 octobre 2026
- ASUS Ascent GX10 64GB: Compact Agentic AI Supercomputer — press.asus.com, 5 octobre 2026
- ASUS Ascent GX 10 vs NVIDIA DGX Spark: Same GB 10 Platform, Very Different Prices — Techgenyz, 5 octobre 2026
- NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM — blockchain.news, 30 octobre 2026
- The Best DGX Spark for Local AI in 2026: LLM Speed, Model Sizes, and Clusters, With Sources — pyshine.com, 1er octobre 2026
- NVIDIA DGX Spark achieves 2.5x performance and 8x video speed in CES 2026 enterprise update — StorageReview, janvier 2026 et 5 septembre 2026
- AA-AgentPerf-Local — Artificial Analysis, 29 septembre 2026
- Spark Arena — leaderboard communautaire, lancé en juillet 2026
- Serve LLMs with vLLM on One Device | DGX Spark — build.nvidia.com
- Meilleurs LLM open source 2026 — Techsy.io, 5 juillet 2026
- MiMo-V2.6 family release — eWeek, 22-23 septembre 2026 ; SiliconANGLE, 22 septembre 2026 ; forkast.news, 17 et 22 septembre 2026
- AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed — TechTimes, 14 octobre 2026
- NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs — tech-insider.org, 8 octobre 2026
- Building Windows for hybrid intelligence — blogs.windows.com, 7 octobre 2026
- Keynote Microsoft : l’IA locale révolutionne Windows — blog-nouvelles-technologies.fr, 7 octobre 2026
- NVIDIA DGX Spark — fiche technique et prix — glukhov.org, janvier 2026
- PAIR (Personal AI Router) — computeleap.com, 6 septembre 2026
Article recherché et rédigé automatiquement · Magazine Electrosens