
 NVIDIA DGX Spark · 6 September 2026
DGX Spark vs Ryzen AI Halo : le duel des mini-supercalculateurs IA en 2026, architectures, performances et fine-tuning passés au crible
Deux mini‑PC taillés pour l’IA locale s’affrontent en 2026 : le NVIDIA DGX Spark, propulsé par l’architecture Grace Blackwell, et l’AMD Ryzen AI Halo, basé sur le SoC Strix Halo. Lequel permet vraiment de faire tourner, inférer et affiner des modèles de 7B à 70B+ sans passer par le cloud ? Plongée dans leurs architectures, leurs performances réelles et leurs écosystèmes logiciels pour vous aider à choisir.
2026, l’année où l’IA de bureau a changé de dimension
Il n’y a pas si longtemps, faire tourner un LLM de 70 milliards de paramètres chez soi relevait de la science‑fiction. Les modèles open source comme Qwen3, Phi‑4 ou Gemma ont explosé en capacité, et avec eux le besoin de machines capables de les héberger localement – pour la confidentialité, la latence ou simplement pour éviter les coûts du cloud. En 2026, deux mini‑PC se disputent le trône de l’IA de bureau : le NVIDIA DGX Spark (GB10 Grace Blackwell) et l’AMD Ryzen AI Halo (Strix Halo). Tous deux promettent de démocratiser l’inférence et le fine‑tuning de LLM de grande taille, mais leurs approches diffèrent profondément. Le DGX Spark s’appuie sur l’écosystème CUDA éprouvé et une mémoire unifiée ultra‑rapide ; le Ryzen AI Halo mise sur une architecture x86 polyvalente, un NPU dédié et un prix plus agressif. Lequel est fait pour vous ? Pour répondre, il faut regarder sous le capot, analyser les benchmarks disponibles et peser les promesses logicielles.
Cœur du réacteur : architecture et mémoire unifiée passées au crible
Avant de comparer les performances, il faut comprendre ce qui se cache dans ces deux boîtiers compacts.
DGX Spark : le bébé de NVIDIA
Le DGX Spark est le premier mini‑PC de NVIDIA basé sur la plateforme Grace Blackwell. Il associe un CPU Grace (ARM Neoverse V2) à un GPU Blackwell, le tout relié par une mémoire unifiée LPDDR5X. Les spécifications précises (nombre de cœurs GPU, fréquence, TDP) n’ont pas été divulguées dans les sources disponibles, mais on sait qu’il peut embarquer 128 Go de mémoire unifiée avec une bande passante de 273 Go/s. Cette mémoire est partagée entre CPU et GPU, ce qui permet de charger des modèles de très grande taille sans avoir à copier les données entre deux pools séparés. NVIDIA revendique environ 1 PFLOP en FP4 pour le GPU Blackwell.
Deux versions existent : le DGX Spark Founders Edition (vendu directement par NVIDIA) et l’ASUS Ascent GX10 (OEM). Le Founders Edition est passé de 3 999 $ à 4 679 $ en 2026 en raison de la hausse des prix de la mémoire LPDDR5X et des SSD, tandis que l’ASUS GX10 reste à 2 999 $ mais avec seulement 1 To de stockage au lieu de 4 To. Les deux embarquent le même SoC GB10 et 128 Go de mémoire. En France, l’ASUS Ascent GX10 s’est nettement repositionné : son prix est tombé à environ 2 760 € en 2026, contre 4 000 € à son lancement (information rapportée par la communauté, non confirmée par une source officielle).
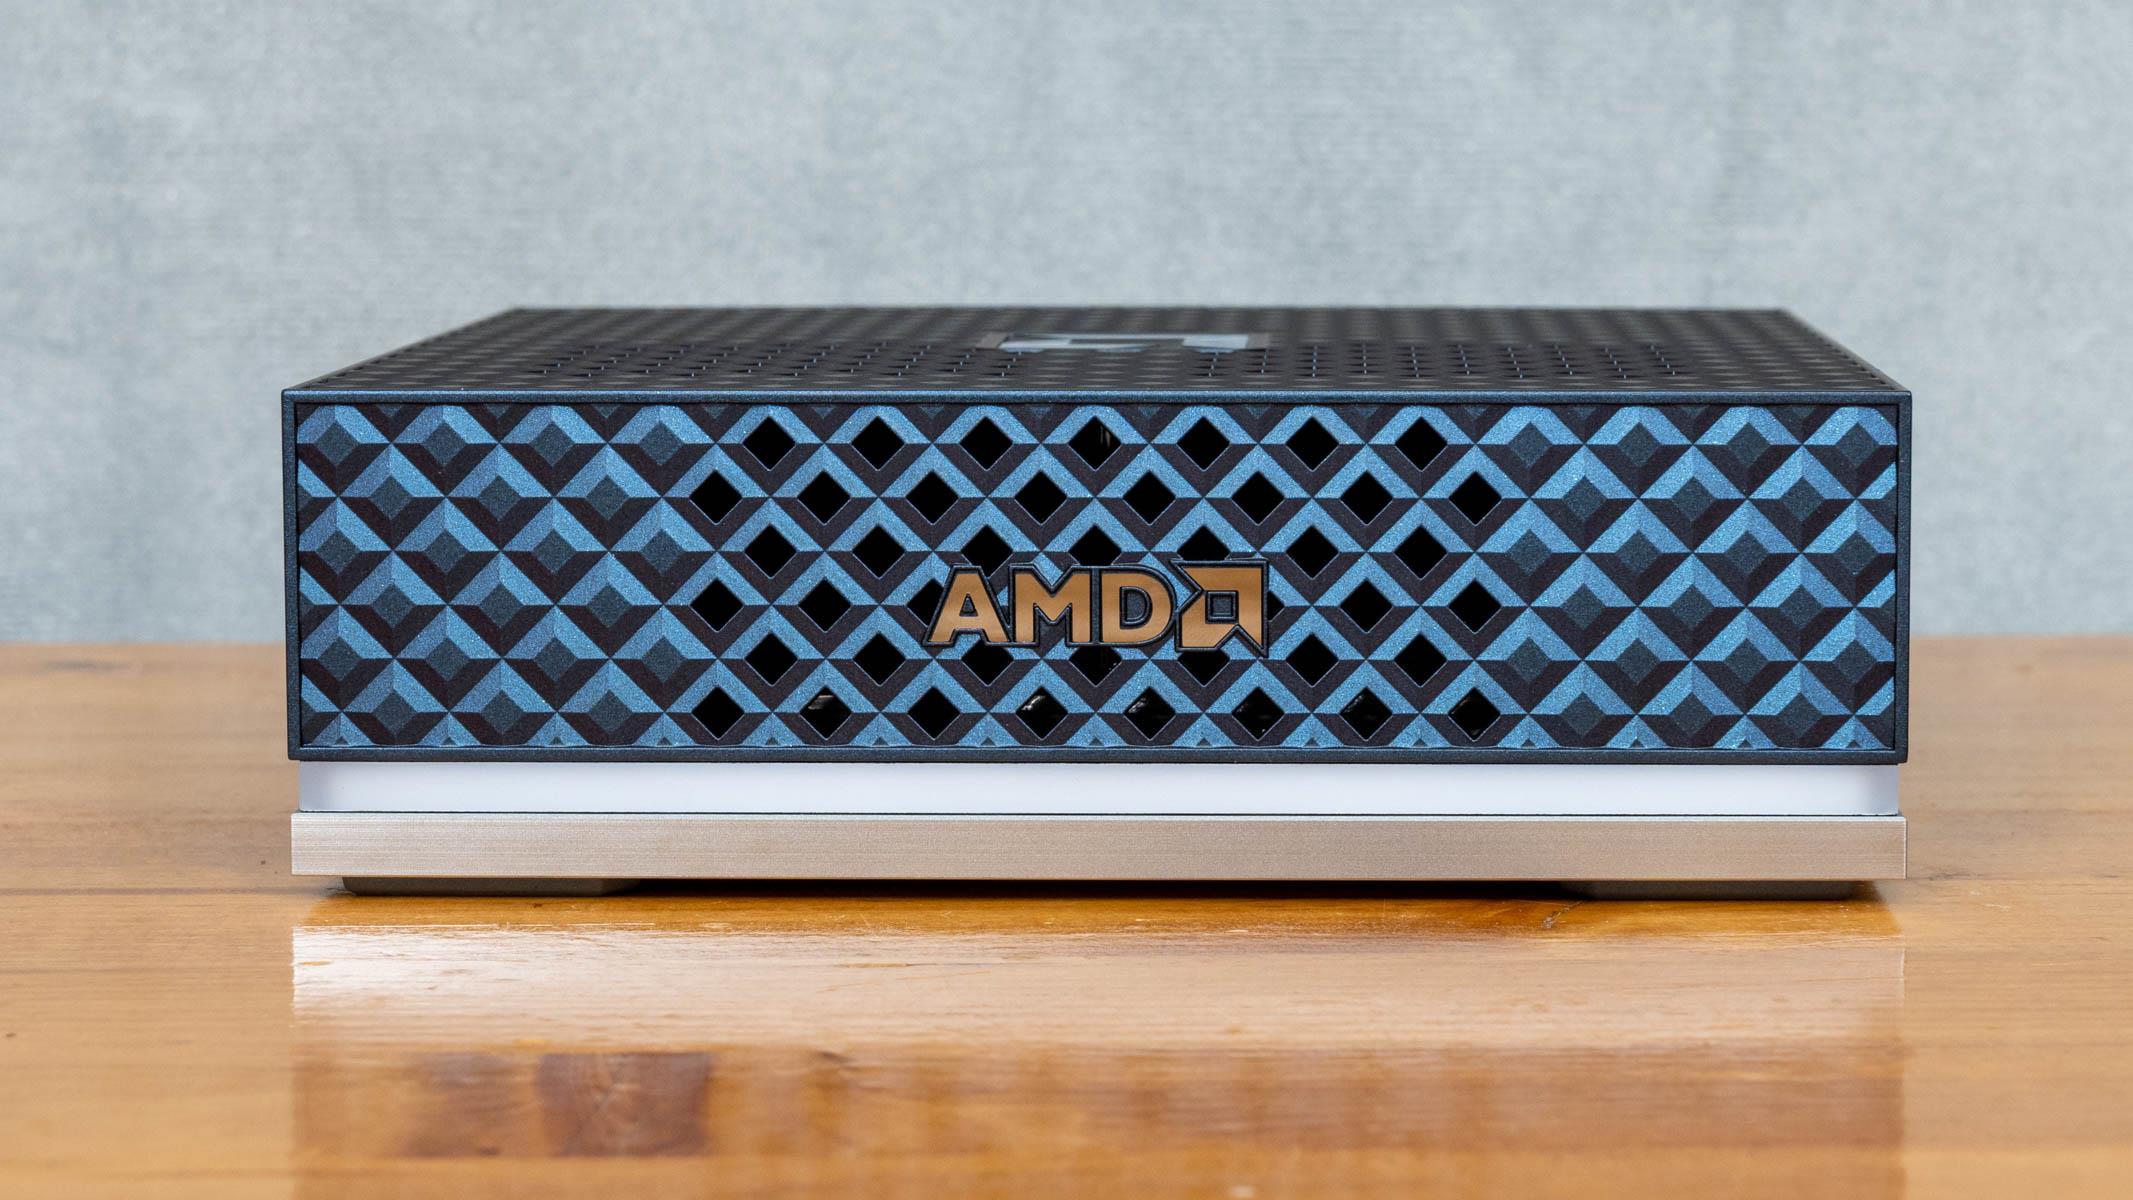
Ryzen AI Halo : le Strix Halo d’AMD
De l’autre côté, l’AMD Ryzen AI Halo est propulsé par le SoC Ryzen AI Max+ 395 (nom de code Strix Halo). Il intègre :
- 16 cœurs Zen 5 / 32 threads (CPU), avec une fréquence boost jusqu’à 5,1 GHz
- 40 unités de calcul RDNA 3.5 (GPU Radeon 8060S) cadencées jusqu’à 2,9 GHz
- NPU XDNA 2 de 50 TOPS
- Jusqu’à 128 Go de mémoire unifiée LPDDR5X sur un bus 256‑bit
La vitesse mémoire annoncée varie selon les sources : 8 000 MT/s (bande passante ~256 Go/s) ou 8 533 MT/s (~273 Go/s). Les tests les plus récents (HotHardware, TweakTown) retiennent 8 000 MT/s, soit 256 Go/s – légèrement inférieure à celle du DGX Spark. Le TDP est également sujet à débat : 55 W en mode nominal, 120 W en mode performance (HotHardware). Cela suggère que le Ryzen AI Halo peut fonctionner dans deux régimes, avec un impact direct sur les performances soutenues.
Le Ryzen AI Halo est disponible en deux variantes identiques sur le plan matériel, l’une avec Windows 11 Pro, l’autre avec Linux, toutes deux au même prix de 3 999 $. Une variante utilisant le Ryzen AI Max+ PRO 495, supportant jusqu’à 192 Go de mémoire et des modèles de 300 milliards de paramètres, est attendue au troisième trimestre 2026.
Tableau comparatif des spécifications clés
| Caractéristique | AMD Ryzen AI Halo (Strix Halo) | NVIDIA DGX Spark Founders | ASUS Ascent GX10 (DGX Spark OEM) |
|---|---|---|---|
| CPU | 16 cœurs Zen 5 / 32 threads (jusqu’à 5,1 GHz) | Grace (ARM Neoverse V2) | Grace (ARM Neoverse V2) |
| GPU | 40 CUs RDNA 3.5 (Radeon 8060S, 2,9 GHz) | Blackwell (~1 PFLOP FP4) | Blackwell (~1 PFLOP FP4) |
| NPU | XDNA 2 (50 TOPS) | Non (GPU seul) | Non (GPU seul) |
| Mémoire unifiée max | 128 Go LPDDR5X | 128 Go LPDDR5X | 128 Go LPDDR5X |
| Bande passante mémoire | 256 Go/s (LPDDR5X-8000) | 273 Go/s (LPDDR5X) | 273 Go/s (LPDDR5X) |
| TDP | 55 W (nominal) / 120 W (boost) | Non précisé | Non précisé |
| Prix (septembre 2026) | 3 999 $ (2 To SSD) | 4 679 $ (4 To SSD) | 2 999 $ (1 To SSD) |
| OS | Windows 11 Pro / Linux | Linux uniquement | Linux uniquement |
| Connectivité | 10GbE LAN, Wi-Fi 7, Bluetooth 5.4, 4× USB-C, HDMI 2.1b | Non précisé | Non précisé |
Sources : HotHardware, TweakTown, TechSpot, runaihome.com, compute-market.com
L’impact sur l’inférence est direct : la bande passante mémoire est souvent le goulot d’étranglement pour les LLM, car chaque token généré nécessite de charger l’intégralité des poids du modèle. Un écart de ~6 % (273 vs 256 Go/s) peut se traduire par une différence de quelques tokens par seconde. Mais ce n’est pas le seul facteur : l’optimisation logicielle joue un rôle tout aussi crucial.
Inférence en conditions réelles : 34 tok/s contre 39 tok/s, et après ?
Les premiers benchmarks disponibles comparent les deux machines sur un modèle de 120 milliards de paramètres (gpt‑oss 120B). Attention : ces chiffres sont rapportés par les vendeurs et la communauté, non vérifiés de manière indépendante. Ils donnent néanmoins un ordre de grandeur.
| Métrique | Ryzen AI Halo | DGX Spark (Founders / GX10) |
|---|---|---|
| Génération de tokens (tok/s) | ~34 | ~39 |
| Prompt processing (tok/s) | ~340 | ~1 720 |
Source : runaihome.com, compute-market.com
L’écart en prompt processing est spectaculaire : le DGX Spark est 5 fois plus rapide pour traiter le prompt initial. Cela s’explique par une combinaison de bande passante mémoire plus élevée et d’une optimisation logicielle poussée (CUDA, TensorRT‑LLM). En revanche, pour la génération token par token, la différence n’est que de ~15 % (39 vs 34 tok/s). Pour des modèles plus courants comme Qwen3‑72B ou Phi‑4 (7‑14B), on peut s’attendre à des écarts similaires, mais aucun benchmark indépendant n’est encore disponible dans cette gamme. Les tests sur des modèles plus petits (7B) montrent généralement que les deux machines peuvent atteindre des vitesses confortables (50‑100 tok/s), mais la latence de prompt processing reste un avantage net pour le DGX Spark.
Pour qui ? Si vous faites du chat interactif avec des prompts longs (analyse de documents, agents conversationnels), le DGX Spark offre une expérience plus fluide. Si vous privilégiez la génération de texte en continu (écriture, code), l’écart se resserre et le Ryzen AI Halo devient très compétitif, surtout à son prix inférieur.
Les nouveaux modèles qui changent la donne
Mi‑2026, le paysage des modèles open‑source s’est considérablement enrichi, et le DGX Spark est au centre de cette effervescence. Parmi les sorties notables :
- Ant Ling‑3.0‑Flash 124B‑A5B (23 juillet 2026) : un modèle MoE de 124 milliards de paramètres avec seulement 5 milliards d’actifs par token, utilisant une attention hybride‑linéaire (couches KDA et MLA dans un ratio 5:1). Avec un contexte maximal de 256K tokens (extensible à 1M), il est conçu pour tenir sur un seul DGX Spark. Les estimations non officielles de débit sur Spark tournent autour de 15‑20 tokens/s, ce qui en fait un candidat sérieux pour les workloads agentiques.
- Poolside Laguna S 2.1 (23 juillet 2026) : un modèle de 118 milliards de paramètres (MoE) spécialisé codage, présenté comme « la plus puissante ouverture occidentale » – le premier gros poids open‑weight américain depuis 11 mois. Il tient dans un seul desktop et rivalise avec des modèles 10 fois plus grands.
- DeepSeek V4 Flash 0731 (31 juillet 2026) : un modèle MoE avec 13 milliards de paramètres actifs, conçu pour l’agentique. Sur un cluster de deux DGX Spark, il atteint des performances de niveau « frontier » pour des agents privés, avec un cache KV de 1M tokens. En quantification Q8 (UD‑Q8_K_XL), il pèse 162 Go – soit seulement 7 Go de plus que la version Q4 – et tourne en pleine précision sur deux Spark. Des tests communautaires récents (forums NVIDIA, août 2026) rapportent 1 000 tok/s en prefill et 59 tok/s en serving multi-agents sur un seul Spark, et jusqu’à 30 tok/s en configuration par défaut sur deux nœuds.
- Qwen 3.6 27B : les benchmarks tiers (kie.ai) montrent des scores MMLU intéressants en NVFP4 vs FP8, avec un débit mesuré sur DGX Spark.
- Nemotron‑Labs‑Diffusion (20 mai 2026) : le modèle « tri‑mode » de NVIDIA qui unifie génération auto‑régressive, diffusion et auto‑régression, avec un gain annoncé de 5,9× en tokens par passe. Testé sur DGX Spark, il ouvre des perspectives nouvelles pour l’inférence locale.
Ces modèles illustrent la vitalité de l’écosystème open‑source en 2026, et le DGX Spark – avec ses 128 Go et son écosystème CUDA – est souvent la plateforme de référence pour les faire tourner en local.
Fine-tuning local : LoRA, QLoRA et le mur de la mémoire
Le fine‑tuning de LLM sur une machine de bureau est un rêve pour beaucoup de développeurs et chercheurs. Les deux mini‑PC peuvent‑ils le permettre ?

Capacité mémoire
Avec 128 Go de mémoire unifiée, les deux machines peuvent charger un modèle de 70B en 4‑bit (environ 40 Go) et laisser de la place pour les gradients et optimiseurs lors d’un fine‑tuning avec LoRA/QLoRA. En théorie, on peut fine‑tuner un modèle 7B‑14B en full precision (16‑bit) avec une taille de batch raisonnable. Pour un 70B, le QLoRA (4‑bit) est indispensable.
Bande passante et temps d’entraînement
La bande passante mémoire inférieure du Ryzen AI Halo (256 vs 273 Go/s) aura un impact sur la vitesse d’entraînement, mais l’écart est faible. En revanche, l’écosystème logiciel fait la différence : le DGX Spark bénéficie de CUDA et de bibliothèques optimisées comme TensorRT‑LLM, vLLM et NeMo AutoModel. NVIDIA propose même un guide officiel pour installer NeMo sur le DGX Spark, avec des conteneurs Docker préconfigurés (nvcr.io/nvidia/nemo-automodel:26.02). Le Ryzen AI Halo s’appuie sur ROCm 7.2.2 et des frameworks comme Axolotl, Unsloth ou Hugging Face PEFT.
Outils supportés
- DGX Spark : PyTorch natif avec CUDA, TensorRT‑LLM, vLLM, Hugging Face Transformers, Axolotl (via CUDA), NeMo AutoModel. Des exemples concrets de fine‑tuning de Phi‑4 et Gemma ont été rapportés (LinkedIn post). La communauté a également montré qu’un full fine‑tuning d’un Llama 8B est possible en moins de 24 heures sur le DGX Spark, avec des résultats de raisonnement comparables à un 70B sur certaines tâches. Le guide DeepWiki (août 2026) détaille les workflows de fine-tuning sur GB10 (sm121) avec ses 128 Go de mémoire unifiée.
- Ryzen AI Halo : ROCm 7.2.2, LM Studio, ComfyUI, Ollama. AMD promet un support Day 0 pour les principaux modèles. Cependant, la compatibilité de ROCm avec certains modèles et bibliothèques (ex. Flash Attention) reste parfois partielle, et la documentation moins mature que celle de CUDA.
Les mises à jour de juillet 2026 du DGX Spark
NVIDIA a déployé en juillet 2026 une mise à jour logicielle majeure pour le DGX Spark, avec notamment une meilleure gestion mémoire (amélioration du memory management) et des optimisations pour les partenaires GB10. Ces mises à jour renforcent la position du Spark pour le fine‑tuning et l’inférence de modèles toujours plus gros. La communauté a également vu émerger des outils comme Unsloth et LLaMA Factory, qui simplifient considérablement les pipelines LoRA/QLoRA sur cette machine. Une comparaison récente (marktechpost, juillet 2026) confirme qu’Unsloth reste le plus rapide en mono‑GPU, tandis que LLaMA‑Factory excelle en multi‑GPU – un atout pour les clusters.
Aucun benchmark de fine‑tuning (temps, mémoire utilisée) n’est disponible dans les sources pour une comparaison directe. Il faut donc rester prudent. Pour un usage intensif de fine‑tuning, le DGX Spark offre un chemin plus éprouvé, mais le Ryzen AI Halo pourrait bien rattraper son retard avec les mises à jour de ROCm.
CUDA vs ROCm : le vrai champ de bataille logiciel
Au-delà des chiffres bruts, c’est l’écosystème logiciel qui fait la différence. Le DGX Spark s’appuie sur CUDA, la norme de facto de l’IA, avec un support mature pour PyTorch, TensorRT-LLM, vLLM et NeMo. Le Ryzen AI Halo utilise ROCm 7.2.2, qui a fait d’énormes progrès mais reste parfois en retrait sur certains modèles et bibliothèques.
La stack logicielle du DGX Spark en 2026
Le DGX Spark GB10, avec son SoC de 170 W, fait tourner une stack complète pour les LLM open source. Parmi les solutions logicielles passées au crible par la communauté :
- LiteLLM : passerelle unifiée pour router les requêtes vers différents modèles et fournisseurs.
- vLLM : serveur d’inférence haute performance avec PagedAttention, optimisé pour CUDA.
- Ollama : la solution la plus simple pour déployer des modèles en quelques commandes.
- llama.cpp : implémentation C++ légère, idéale pour les environnements contraints.
- Llama Swap : outil de swap de modèles en mémoire pour maximiser l’utilisation des 128 Go.
- Atlas : nouveau venu qui émerge en 2026, promettant une gestion unifiée des modèles.
Benchmarks logiciels sur DGX Spark
Les tests communautaires montrent que vLLM et TensorRT-LLM offrent les meilleures performances d’inférence, tandis qu’Ollama et llama.cpp privilégient la simplicité. Pour le fine-tuning, NeMo AutoModel et Unsloth sont les choix privilégiés, avec LLaMA Factory pour les clusters multi-nœuds.
Le cas particulier de Claude Code
Un point crucial pour les développeurs : le DGX Spark tourne sous Linux (DGX OS Ubuntu) et ne supporte pas officiellement Claude Code, l’outil d’Anthropic. Le Ryzen AI Halo, avec son support Windows 11 Pro, permet d’exécuter Claude Code nativement. Pour 80 % des développeurs qui utilisent cet outil, c’est un avantage décisif – même si le DGX Spark offre de meilleures performances brutes.
Clusters multi-nœuds : de 200 à 700 milliards de paramètres
L’un des grands atouts du DGX Spark est sa capacité à former des clusters. NVIDIA a conçu le GB10 avec un lien réseau dédié (annoncé initialement à 100 GbE, mais les tests réels montrent un débit théorique de 1,25 Go/s sur lien 10GbE). En pratique, les clusters de deux à huit Spark permettent de faire tourner des modèles de 200 à 700 milliards de paramètres.

DeepSeek V4 Flash 0731 sur cluster de deux Spark
Le cas le plus documenté est celui de DeepSeek V4 Flash 0731 sur deux DGX Spark. Avec 13 milliards de paramètres actifs et un cache KV de 1M tokens, ce modèle atteint des performances de niveau « frontier » pour des agents privés. Les tests de la communauté (forums NVIDIA, août 2026) rapportent :
- 1 000 tok/s en prefill sur un seul Spark
- 59 tok/s en serving multi-agents sur un seul Spark
- 30 tok/s en configuration par défaut sur deux nœuds, avec des ajustements de configuration permettant de retrouver des taux d’acceptation élevés
Gestion de flotte : Progress Chef entre dans l’arène
Le 30 juillet 2026, Progress Software annonçait la compatibilité de sa plateforme Chef Enterprise Management avec le NVIDIA DGX Spark, à un prix de 189 dollars par an et par système. Pour les entreprises qui commencent à déployer des flottes de Spark, cette solution apporte :
- Provisionnement automatisé : déploiement de configurations standardisées sur des dizaines de machines
- Gestion agentless : basée sur un protocole JSON, sans agent à installer sur chaque nœud
- Intégration avec Ansible, Kubernetes et Slurm : pour les environnements hybrides
Chef se positionne face à Ansible, Base Command, Kubernetes et Slurm, avec l’avantage d’une gestion centralisée pensée pour l’échelle.
Verdict : lequel choisir en septembre 2026 ?
Le choix entre le DGX Spark et le Ryzen AI Halo dépend de vos priorités :
Choisissez le DGX Spark si :
- Vous privilégiez les performances brutes d’inférence (surtout le prompt processing)
- Vous êtes à l’aise avec Linux et l’écosystème CUDA
- Vous voulez faire du fine-tuning avec les outils NVIDIA (NeMo, TensorRT-LLM)
- Vous envisagez de monter un cluster multi-nœuds
- Vous voulez faire tourner les modèles les plus récents (Ant Ling, DeepSeek V4 Flash, Poolside Laguna)
Choisissez le Ryzen AI Halo si :
- Vous avez besoin de Windows 11 (Claude Code, outils Windows)
- Vous voulez un NPU dédié pour l’inférence locale
- Vous cherchez un prix plus agressif (3 999 $ vs 4 679 $)
- Vous préférez l’architecture x86 et la polyvalence
- Vous voulez une machine qui fait aussi office de PC de travail classique
En 2026, les deux machines sont capables de faire tourner des LLM de 70B+ en local, avec des performances confortables. Le DGX Spark reste la référence pour les workloads intensifs et le fine-tuning, tandis que le Ryzen AI Halo séduit par sa polyvalence et son prix. Le marché est en pleine effervescence, avec l’arrivée prochaine de la variante Ryzen AI Max+ PRO 495 (192 Go) et des mini-PC Acer et Gigabyte basés sur le GB10 attendus début 2027.
Sources
- HotHardware – Ryzen AI Halo Review
- TweakTown – AMD Ryzen AI Halo launches at $3,999
- Geeky Gadgets – Ryzen AI Halo vs DGX Spark
- Hypebeast – Station de travail AMD Ryzen AI Halo
- Forums NVIDIA – DeepSeek V4 Flash 0731 sur DGX Spark
- DeepWiki – Fine-tuning sur DGX Spark
- Flowtivity – DeepSeek V4 Flash sur dual DGX Spark
- OutilsIA – DGX Spark vs Strix Halo pour Claude Code
- Optijara – La stack complète des agents d’IA en 2026
Article recherché et rédigé automatiquement · Magazine Electrosens