
 NVIDIA DGX Spark · 1 November 2026
LLM open source sur NVIDIA GB10 DGX Spark : ce qui tourne vraiment à l’automne 2026, la bascule des 64 Go, le fine-tuning et les clusters
Le NVIDIA DGX Spark, avec son SoC GB10 Grace Blackwell et ses 128 Go de mémoire unifiée, promettait de démocratiser l’inférence et le fine-tuning de grands modèles de langage en local. Un an et demi après son lancement, la machine a mûri — mais elle a surtout changé de visage : depuis le 23 octobre 2026, la configuration d’entrée est passée à 64 Go pour 4 999 $, tandis que le modèle 128 Go s’envole au-delà des 6 000 $. Les modèles open source de classe 100 à 200 milliards de paramètres tournent toujours sur un bureau silencieux, les clusters de 2 à 8 nœuds se démocratisent, et l’écosystème logiciel s’est densifié autour de vLLM, TensorRT Edge-LLM et des outils de fine-tuning. Mais face au Ryzen AI Halo 192 Go d’AMD, le DGX Spark doit désormais justifier chaque dollar — et chaque gigaoctet.
2026, l’année où l’IA de bureau a changé de dimension
Il n’y a pas si longtemps, faire tourner un LLM de 70 milliards de paramètres chez soi relevait de la science-fiction. Les modèles open source ont explosé en capacité — MiMo-V2.6 de Xiaomi, Qwen3.8, DeepSeek V4 Flash, GLM 5.2, Kimi K2.7 — et avec eux le besoin de machines capables de les héberger localement : pour la confidentialité, la latence, ou simplement pour éviter les coûts du cloud. En 2026, deux mini-PC se disputent le trône de l’IA de bureau : le NVIDIA DGX Spark (GB10 Grace Blackwell) et l’AMD Ryzen AI Halo (Strix Halo). Tous deux promettent de démocratiser l’inférence et le fine-tuning de LLM de grande taille, mais leurs approches diffèrent profondément — et, depuis octobre, leurs grilles tarifaires ont été bouleversées par la flambée du prix de la LPDDR5X.
Le DGX Spark s’appuie sur l’écosystème CUDA éprouvé et une mémoire unifiée ultra-rapide ; le Ryzen AI Halo mise sur une architecture x86 polyvalente, un NPU dédié, une capacité mémoire supérieure sur sa variante PRO et un positionnement prix qui a beaucoup évolué. Lequel est fait pour vous ? Pour répondre, il faut regarder sous le capot, analyser les benchmarks disponibles et peser les promesses logicielles.
La bascule d’octobre 2026 : 64 Go, 128 Go et une nouvelle grille tarifaire
C’est le fait dominant de cet automne, et il conditionne tout le reste : le 2 octobre 2026, NVIDIA a annoncé une seconde configuration de son DGX Spark, dotée de 64 Go de mémoire unifiée, commercialisée à partir du 23 octobre 2026 chez plusieurs constructeurs, à 4 999 $. Le même jour, la version 128 Go a vu son prix grimper au-delà des 6 000 $ sur le marché, sous l’effet de la hausse des coûts de la mémoire (LPDDR5X) et du stockage.
Le paradoxe est assumé : la nouvelle mouture 64 Go coûte 1 000 $ de plus que le prix de lancement de la version 128 Go en 2025 (3 999 $). NVIDIA tente de « rectifier le tir » en réduisant de moitié la mémoire pour contenir la facture, mais la hausse des composants l’emporte. La question que tout le monde se pose — faut-il acheter deux petits plutôt qu’un gros ? — structure désormais les comparatifs : deux Spark 64 Go (9 998 $) offrent 128 Go au total mais un cluster à deux nœuds ; un seul Spark 128 Go (>6 000 $) reste plus simple mais plus cher au gigaoctet.
NVIDIA accompagne cette bascule d’une communication précise sur les tailles de modèles visées sur un ou deux systèmes, et sur un test interne : Qwen 3.8 27B jusqu’à 1,7 fois plus rapide sur la nouvelle configuration selon le constructeur. La version 64 Go « tourne des agents IA locaux avec la stack NVIDIA complète — et des clusters pour monter en performance à mesure que les charges grandissent », résume le blog officiel de NVIDIA.
À retenir pour l’acheteur : la barrière d’entrée baisse en apparence (4 999 $), mais la capacité mémoire — le vrai facteur limitant pour les LLM — baisse aussi. Les modèles de classe 100-200B qui tenaient sur un seul Spark 128 Go nécessitent désormais soit une quantification plus agressive, soit deux nœuds.
Cœur du réacteur : architecture et mémoire unifiée passées au crible
Avant de comparer les performances, il faut comprendre ce qui se cache dans ces boîtiers compacts.
DGX Spark : le bébé de NVIDIA
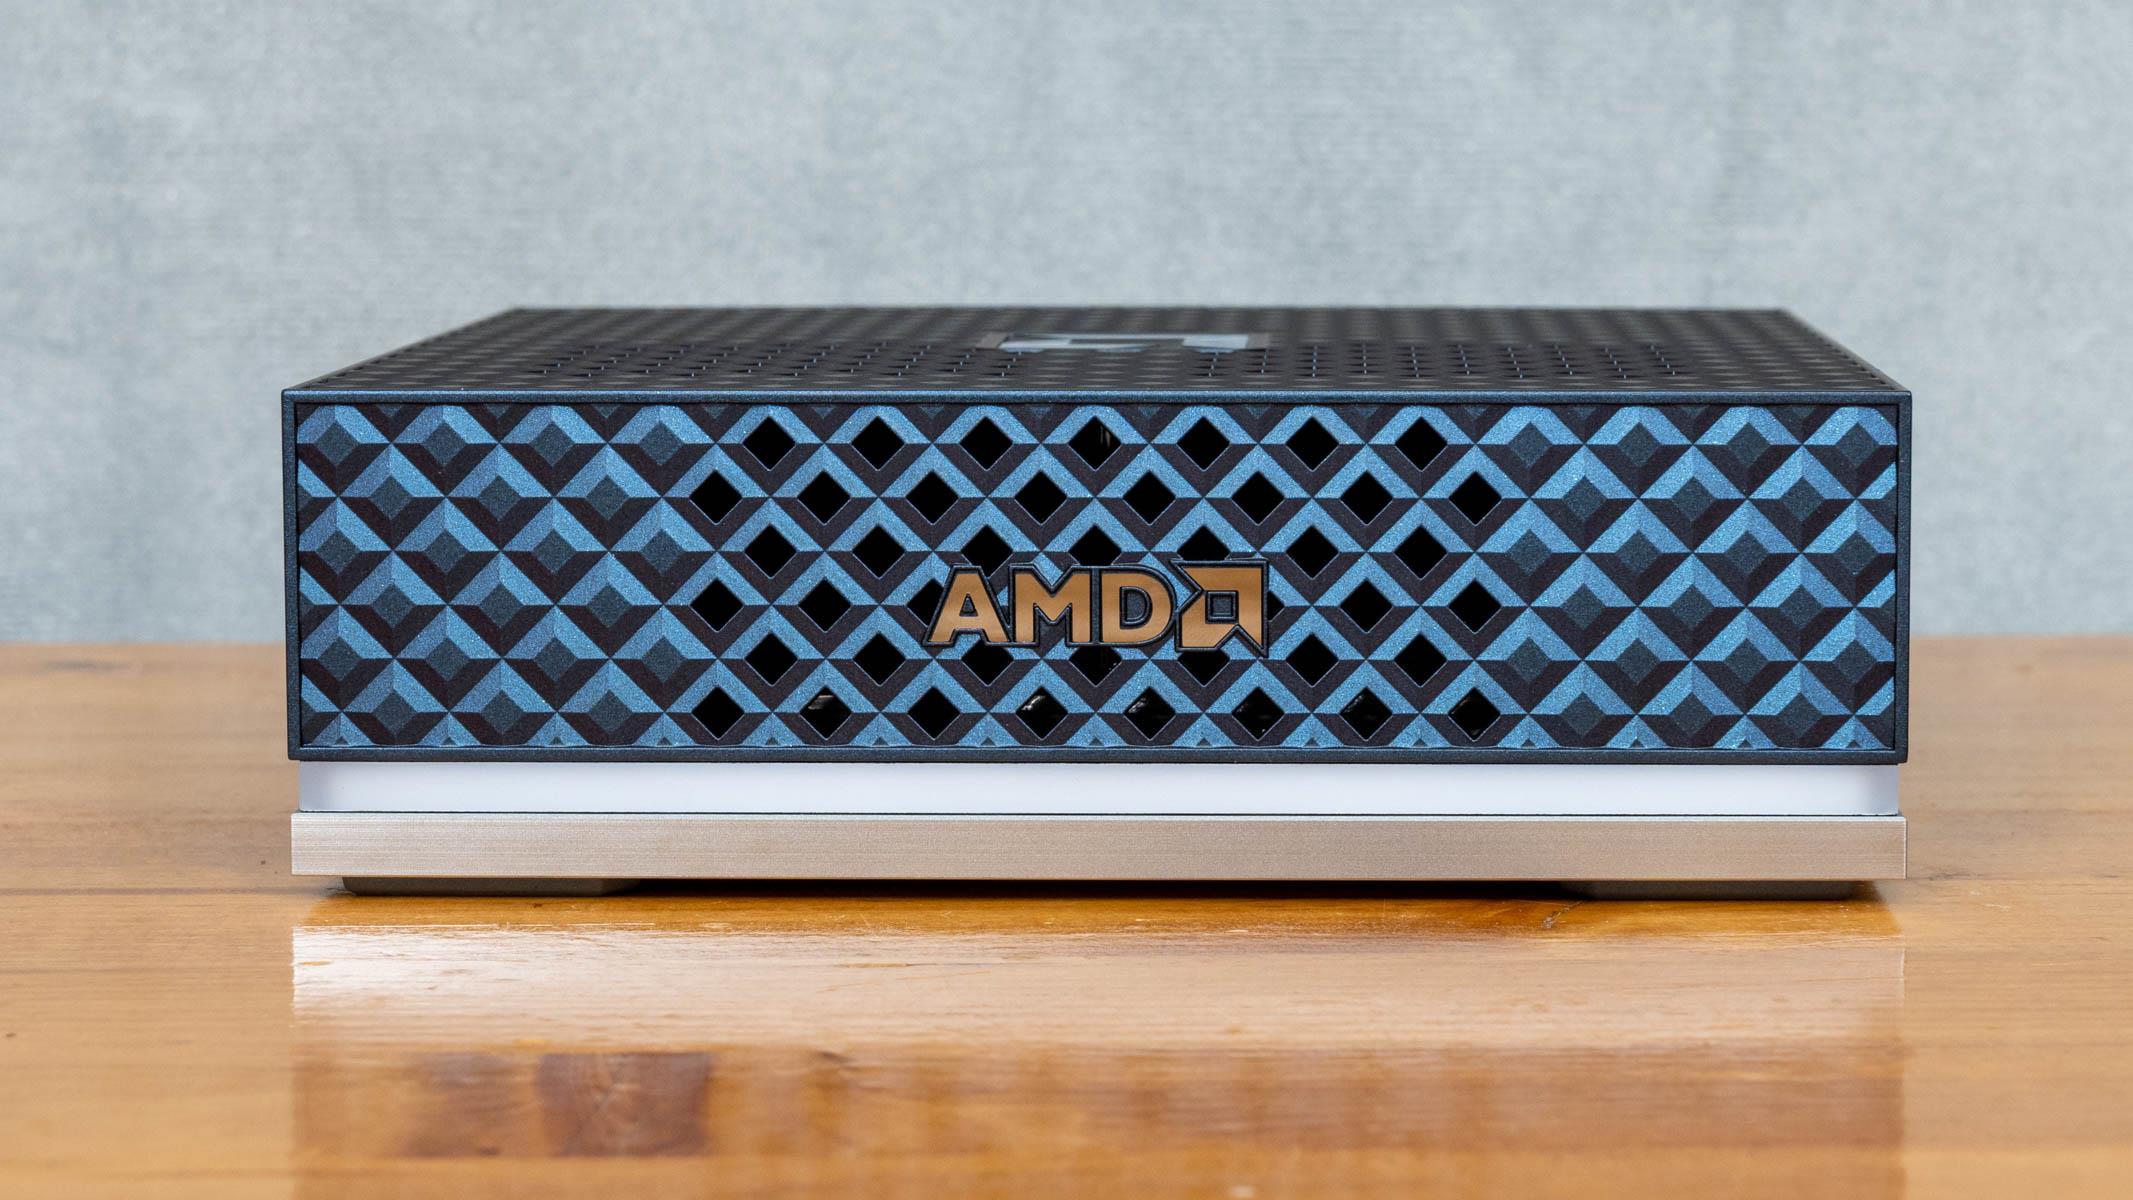
Le DGX Spark est le premier mini-PC de NVIDIA basé sur la plateforme Grace Blackwell. Il associe un CPU Grace (20 cœurs ARMv9.2 / Neoverse V2) à un GPU Blackwell, le tout relié par une mémoire unifiée LPDDR5X. Il embarque 128 Go de mémoire unifiée (121 GiB réellement exploitables selon les tests communautaires) — ou 64 Go sur la nouvelle configuration d’entrée — avec une bande passante de 273 Go/s. Cette mémoire est partagée entre CPU et GPU, ce qui permet de charger des modèles de très grande taille sans copier les données entre deux pools séparés. NVIDIA revendique environ 1 PFLOP en FP4 pour le GPU Blackwell, et la machine fonctionne sous DGX OS (Ubuntu 24.04 NVIDIA, kernel 6.17) avec CUDA 13.
Plusieurs versions existent : le DGX Spark Founders Edition (vendu directement par NVIDIA), l’ASUS Ascent GX10 (désormais décliné en 64 Go, voir plus bas), le MSI EdgeXpert MS-C931 et l’Acer DGX (marque blanche, livrée depuis le 8 septembre 2026, positionnée 500 à 1 000 $ sous le prix NVIDIA officiel, toujours sur base GB10 avec 128 Go). Le Founders Edition 128 Go est passé de 3 999 $ à plus de 6 000 $ en 2026, tandis que l’ASUS GX10 128 Go s’est maintenu autour de 2 999 $ avec seulement 1 To de stockage au lieu de 4 To. En France, l’ASUS Ascent GX10 s’est repositionné : son prix est tombé à environ 2 760 € en 2026, contre 4 000 € à son lancement (information rapportée par la communauté, non confirmée par une source officielle).
Le 5 octobre 2026, ASUS a officialisé une variante Ascent GX10 64 Go présentée comme un « supercalculateur agentique compact » : GB10, 1 PFLOP, ciblant les modèles open source de 30 à 35 milliards de paramètres et les agents IA locaux. C’est un changement de discours notable : le GX10 64 Go n’est plus vendu comme une machine à faire tourner du 120B, mais comme une plateforme agentique de taille moyenne.
Ryzen AI Halo : le Strix Halo d’AMD
De l’autre côté, l’AMD Ryzen AI Halo est propulsé par le SoC Ryzen AI Max+ 395 (nom de code Strix Halo). Il intègre :
- 16 cœurs Zen 5 / 32 threads (CPU), avec une fréquence boost jusqu’à 5,1 GHz
- 40 unités de calcul RDNA 3.5 (GPU Radeon 8060S) cadencées jusqu’à 2,9 GHz
- NPU XDNA 2 de 50 TOPS
- Jusqu’à 128 Go de mémoire unifiée LPDDR5X sur un bus 256-bit (192 Go sur la variante PRO 495)
La vitesse mémoire annoncée varie selon les sources : 8 000 MT/s (bande passante ~256 Go/s) ou 8 533 MT/s (~273 Go/s). Les tests les plus récents (HotHardware, TweakTown) retiennent 8 000 MT/s, soit 256 Go/s — légèrement inférieure à celle du DGX Spark. Le TDP est également sujet à débat : 55 W en mode nominal, 120 W en mode performance.
Surtout, la variante 192 Go est arrivée : le 14 octobre 2026, le Ryzen AI Halo 192 Go a été mis en vente chez Micro Center à 7 299,99 $, devenant le premier desktop compact capable de charger des modèles open-weight de 300 milliards de paramètres. Les benchmarks indépendants cités par TechTimes confirment toutefois que le DGX Spark garde l’avantage en vitesse — la bande passante et l’optimisation CUDA compensant la capacité mémoire supérieure d’AMD.
Tableau comparatif des spécifications clés
| Caractéristique | AMD Ryzen AI Halo 128 Go (Strix Halo) | AMD Ryzen AI Halo 192 Go (PRO 495) | NVIDIA DGX Spark 128 Go | NVIDIA DGX Spark 64 Go |
|---|---|---|---|---|
| CPU | 16 cœurs Zen 5 / 32 threads (jusqu’à 5,1 GHz) | 16 cœurs Zen 5 / 32 threads | Grace (20 cœurs ARMv9.2) | Grace (20 cœurs ARMv9.2) |
| GPU | 40 CUs RDNA 3.5 (Radeon 8060S, 2,9 GHz) | 40 CUs RDNA 3.5 | Blackwell (~1 PFLOP FP4) | Blackwell (~1 PFLOP FP4) |
| NPU | XDNA 2 (50 TOPS) | XDNA 2 (50 TOPS) | Non (GPU seul) | Non (GPU seul) |
| Mémoire unifiée max | 128 Go LPDDR5X | 192 Go LPDDR5X | 128 Go LPDDR5X | 64 Go LPDDR5X |
| Bande passante mémoire | 256 Go/s (LPDDR5X-8000) | ~256 Go/s | 273 Go/s (LPDDR5X) | 273 Go/s (LPDDR5X) |
| TDP | 55 W (nominal) / 120 W (boost) | 55 W / 120 W | ~170 W (système) | ~170 W (système) |
| Prix (octobre 2026) | 3 999 $ (2 To SSD) | 7 299,99 $ | >6 000 $ (4 To SSD) | 4 999 $ (à partir du 23 octobre) |
| OS | Windows 11 Pro / Linux | Windows 11 Pro / Linux | DGX OS (Ubuntu 24.04) | DGX OS (Ubuntu 24.04) |
| Connectivité | 10GbE LAN, Wi-Fi 7, Bluetooth 5.4, 4× USB-C, HDMI 2.1b | idem | Non précisé | Non précisé |
Sources : HotHardware, TweakTown, TechSpot, TechTimes (14 octobre 2026), blogs.nvidia.com (2 octobre 2026), Frandroid, Clubic, runaihome.com, compute-market.com, devtoolstack.mynewit.com
L’impact sur l’inférence est direct : la bande passante mémoire est souvent le goulot d’étranglement pour les LLM, car chaque token généré nécessite de charger l’intégralité des poids du modèle. Un écart de ~6 % (273 vs 256 Go/s) peut se traduire par quelques tokens par seconde. Mais ce n’est pas le seul facteur : l’optimisation logicielle joue un rôle tout aussi crucial.
Inférence en conditions réelles : ce que disent vraiment les benchmarks
Les premiers benchmarks disponibles comparent les deux machines sur un modèle de 120 milliards de paramètres (gpt-oss 120B). Attention : ces chiffres sont rapportés par les vendeurs et la communauté, non vérifiés de manière indépendante. Ils donnent néanmoins un ordre de grandeur.

| Métrique | Ryzen AI Halo | DGX Spark (Founders / GX10) |
|---|---|---|
| Génération de tokens (tok/s) | ~34 | ~39 |
| Prompt processing (tok/s) | ~340 | ~1 720 |
Source : runaihome.com, compute-market.com
L’écart en prompt processing est spectaculaire : le DGX Spark est 5 fois plus rapide pour traiter le prompt initial. Cela s’explique par une combinaison de bande passante mémoire plus élevée et d’une optimisation logicielle poussée (CUDA, TensorRT-LLM). En revanche, pour la génération token par token, la différence n’est que de ~15 % (39 vs 34 tok/s).
Le mur des modèles denses : 4,7 tok/s
Un benchmark indépendant mené sur un MSI EdgeXpert MS-C931 (GB10, 121 GiB unified, CUDA 13, Ollama 0.21.3-rc0 + llama.cpp) apporte un éclairage décisif sur 17 modèles locaux. Le verdict est sans appel : les MoE écrasent les denses comparables.
| # | Modèle | Type | Params total / actif | eval tok/s | prompt tok/s | Δ RAM |
|---|---|---|---|---|---|---|
| 🥇 1 | qwen3:30b-a3b | MoE | 30B / 3B | 82,5 | 442 | 45 GB |
| 🥈 2 | qwen2.5:7b | dense | 7B | 47,8 | 2 379 | 7 GB |
| 🥉 3 | mistral:7b | dense | 7B | 47,0 | 2 194 | 9 GB |
| … | llama3.3 / nemotron / deepseek-r1 | dense | 70B | ~4,7 | — | — |
Source : devtoolstack.mynewit.com, tests indépendants Selfhostr, 2026
Le constat est brutal : un 70B dense (llama3.3, nemotron, deepseek-r1) tourne à 4,7 tok/s — utilisable uniquement en mode asynchrone, pas en chat interactif. À l’inverse, un MoE comme qwen3:30b-a3b atteint 82,5 tok/s, soit le meilleur ratio vitesse/qualité du marché local en 2026. Au-delà de 123B de paramètres, on touche le plafond mémoire de la machine 128 Go. C’est précisément pour cette raison que la vague de modèles MoE de 2026 (Ant Ling-3.0-Flash, DeepSeek V4 Flash, Poolside Laguna) est si importante pour le DGX Spark : elle transforme une machine limitée sur les denses en plateforme viable pour des modèles de classe frontier — et c’est aussi ce qui rend la version 64 Go défendable, à condition de rester sur des MoE de 30-35B.
Les nouveaux modèles qui changent la donne
Mi-2026, le paysage des modèles open source s’est considérablement enrichi, et le DGX Spark est au centre de cette effervescence. Parmi les sorties notables :
- Ant Ling-3.0-Flash 124B-A5B (23 juillet 2026) : un modèle MoE de 124 milliards de paramètres avec seulement 5 milliards d’actifs par token, utilisant une attention hybride-linéaire (couches KDA et MLA dans un ratio 5:1). Avec un contexte maximal de 256K tokens (extensible à 1M), il est conçu pour tenir sur un seul DGX Spark 128 Go. Les estimations non officielles de débit tournent autour de 15-20 tokens/s, ce qui en fait un candidat sérieux pour les workloads agentiques.
- Poolside Laguna S 2.1 (23 juillet 2026) : un modèle de 118 milliards de paramètres (MoE) spécialisé codage, présenté comme « la plus puissante ouverture occidentale » — le premier gros poids open-weight américain depuis 11 mois. Il tient dans un seul desktop et rivalise avec des modèles 10 fois plus grands.
- DeepSeek V4 Flash 0731 (31 juillet 2026) : un modèle MoE avec 13 milliards de paramètres actifs, conçu pour l’agentique. Sur un cluster de deux DGX Spark, il atteint des performances de niveau « frontier » pour des agents privés, avec un cache KV de 1M tokens. En quantification Q8 (UD-Q8_K_XL), il pèse 162 Go — soit seulement 7 Go de plus que la version Q4 — et tourne en pleine précision sur deux Spark. Des tests communautaires récents (forums NVIDIA, août 2026) rapportent 1 000 tok/s en prefill et 59 tok/s en serving multi-agents sur un seul Spark, et jusqu’à 30 tok/s en configuration par défaut sur deux nœuds. Microsoft a d’ailleurs mis DeepSeek V4 Flash en avant lors de sa keynote Windows du 7 octobre 2026, signe de son statut de référence pour l’IA locale.
- Xiaomi MiMo-V2.6 (22-24 septembre 2026) : Xiaomi a ouvert sous licence MIT une famille de modèles (Pro, Flash, 9B) dont le MiMo-V2.6-Pro égale Grok 4.7 sur l’Intelligence Index et dépasse Claude Opus 5 sur certains benchmarks clés. Sorti le même jour que la puce V900 d’Alibaba, il est présenté comme la couche logicielle d’une stratégie d’écosystème. Attention toutefois : ses gains en RL n’ont pas encore été répliqués indépendamment, et l’entraînement repose sur une infrastructure coûteuse.
- Qwen 3.6 27B : les benchmarks tiers (kie.ai) montrent des scores MMLU intéressants en NVFP4 vs FP8, avec un débit mesuré sur DGX Spark. La version NVFP4 (26 juin 2026) atteint 0,8446 de MMLU, un pic de décodage à 163 tok/s, et 28-33 tok/s en session unique (jusqu’à 136 tok/s avec 10 agents en parallèle).
- Qwen3.8-27B (août 2026) : avec un score de 52 sur l’Artificial Analysis Intelligence Index, il se classe premier de sa catégorie parmi les modèles open-weight. Mesuré à 48 tok/s sur DGX Spark selon blog.openzeka.com, et 34-38 tok/s selon les tests du 20 août 2026. C’est le modèle que NVIDIA met en avant pour sa configuration 64 Go (jusqu’à 1,7× plus rapide).
- Nemotron-Labs-Diffusion (20 mai 2026) : le modèle « tri-mode » de NVIDIA qui unifie génération auto-régressive, diffusion et auto-régression, avec un gain annoncé de 5,9× en tokens par passe. Testé sur DGX Spark, il ouvre des perspectives nouvelles pour l’inférence locale.
Ces modèles illustrent la vitalité de l’écosystème open source en 2026, et le DGX Spark — avec sa mémoire unifiée et son écosystème CUDA — est souvent la plateforme de référence pour les faire tourner en local.
AA-AgentPerf-Local : le premier benchmark agentique multi-machines
Le 29 septembre 2026, Artificial Analysis a lancé AA-AgentPerf-Local, un benchmark dédié aux performances agentiques en local. Au lancement, quatre machines sont testées : DGX Spark, Ryzen AI Halo, MacBook Pro (M5 Pro) et RTX 5090, sur quatre modèles open-weight. C’est la première grille d’évaluation indépendante qui compare directement le Spark et le Halo sur des charges agentiques réelles (appels d’outils, boucles de raisonnement), et non sur de simples tokens par seconde. Les résultats détaillés n’ont pas encore été publiés intégralement, mais l’initiative comble un manque criant : jusqu’ici, chaque constructeur avançait ses propres chiffres.
Sept solutions logicielles passées au crible
Le DGX Spark n’est pas qu’un matériel : c’est une plateforme logicielle. En octobre 2026, sept stacks se partagent le terrain, chacune avec ses forces et ses pièges.
1. vLLM — le standard de fait pour le serving multi-utilisateurs. Sur deux Spark en tensor parallel (TP=2) avec DeepSeek-V4-Flash FP8, vLLM atteint ~41 tok/s en single-stream, ~350 tok/s en agrégé à concurrence 32 et ~1 785 tok/s en prefill. C’est la stack de référence pour les clusters et les déploiements multi-agents.
2. TensorRT Edge-LLM — le workflow edge de NVIDIA, détaillé le 30 octobre 2026. Il s’agit d’un compilateur avant d’être un runtime : on convertit le modèle (calibration NVFP4, gestion des dépendances) avant de déployer. Sur Nemotron 3.5 Lightning, NVIDIA annonce 73 tok/s sans DSpark et 127 tok/s avec speculative decoding (DSpark) sur un Spark 64 Go. Derrière le vernis « vendor benchmark », c’est la voie la plus rapide pour l’edge, mais la plus exigeante en ingénierie (versions, calibration, dépendances qui piquent).
3. Ollama — la simplicité avant tout. C’est la stack utilisée dans le benchmark des 17 modèles (Ollama 0.21.3-rc0 + llama.cpp). Parfait pour prototyper, moins pour servir en production à plusieurs agents.
4. llama.cpp — le couteau suisse. Sur un seul Spark, la suite GGUF atteint jusqu’à 67 tok/s sur un 35B-A3B (août 2026). C’est aussi la base de nombreux forks communautaires (dont ds4.c pour DeepSeek-V4-Flash IQ2_XXS, à ~14 tok/s single-stream et 410 tok/s en prefill).
5. LiteLLM — la couche de routage et de proxy. Indispensable dès qu’on mélange plusieurs backends (vLLM pour le lourd, Ollama pour le léger) et qu’on veut un point d’entrée unique compatible OpenAI.
6. Llama Swap — l’aiguillage de modèles à la volée, utile quand la mémoire unifiée ne permet d’en charger qu’un à la fois.
7. Atlas — l’orchestrateur émergent, orienté agents et gestion de contexte long.
À quoi s’ajoute Progress Chef Enterprise Management, rendu compatible avec le DGX Spark le 30 juillet 2026 à 189 $ par an et par système : c’est la brique de gestion d’entreprise (provisionnement, conformité, configuration agentless via JSON) qui manquait aux clusters GB10. Pour un parc de plusieurs Spark en entreprise, elle change la donne opérationnelle.
Fine-tuning sur DGX Spark : ce que la stack permet vraiment
Le fine-tuning local est l’un des arguments les plus solides du Spark — et l’un des plus mal compris. Avec 128 Go de mémoire unifiée, on ne fait pas de l’entraînement de modèle frontier, mais on fait très bien trois choses :
- LoRA et QLoRA sur des modèles de 7 à 70 milliards de paramètres. C’est le pain quotidien : adapter un Qwen3.8-27B ou un Mistral Small 4 à un domaine métier tient dans la mémoire, avec des temps d’entraînement raisonnables.
- Full fine-tune sur des modèles plus petits (jusqu’à ~8-13B selon la précision et la taille de batch), à condition d’accepter des temps longs.
- Pipelines de distillation et d’évaluation : le Spark sert de nœud de test avant de pousser en production.
Les outils qui fonctionnent réellement en 2026 : NVIDIA NeMo (intégré à la stack DGX OS), Unsloth (optimisations mémoire et vitesse), LLaMA Factory (interface unifiée multi-méthodes). La contrainte principale reste la bande passante mémoire : 273 Go/s, c’est excellent pour l’inférence, mais limité pour l’entraînement, où les transferts de gradients pèsent lourd. D’où l’intérêt des clusters : répartir un fine-tune sur deux ou quatre nœuds devient pertinent dès qu’on dépasse le 30B.
Avec la version 64 Go, le fine-tuning reste possible mais se concentre sur les modèles ≤ 30B en QLoRA. C’est un recul net pour les équipes qui visaient le 70B.
Clusters DGX Spark : ce que deux, quatre ou huit nœuds changent vraiment
C’est peut-être l’évolution la plus spectaculaire de 2026 : le clustering de Spark est passé du hack de laboratoire au produit supporté.
Deux nœuds. C’est la configuration de référence. Avec un cache KV partagé, deux Spark offrent un pool de 1 105 096 tokens (août 2026) et supportent des modèles jusqu’à 405 milliards de paramètres. En TP=2 avec vLLM et DeepSeek-V4-Flash FP8 : ~41 tok/s single-stream, ~350 tok/s agrégé à concurrence 32, ~1 785 tok/s en prefill. C’est le sweet spot coût/performance pour un agent privé de classe frontier.
Quatre nœuds. On entre dans le territoire du serving multi-équipes : plusieurs modèles chargés simultanément, routage via LiteLLM, redondance. La limite devient le réseau (les interconnexions entre Spark ne sont pas de l’InfiniBand) et la complexité opérationnelle — d’où l’arrivée de Chef.
Huit nœuds. Réservé aux workloads de fine-tuning distribué et aux démonstrations. Le rendement marginal décroît, et la gestion thermique/électrique de huit boîtiers de 170 W devient un vrai sujet.
La bascule des 64 Go rebat toutefois les cartes : deux Spark 64 Go (9 998 $) offrent 128 Go au total pour le prix d’un seul 128 Go actuel (>6 000 $) plus un peu — mais avec la complexité d’un cluster. C’est exactement la question posée par Frandroid le 2 octobre : « faut-il acheter deux petits plutôt qu’un gros ? » La réponse dépend de votre tolérance à l’administration d’un cluster : pour un développeur solo, un seul nœud reste plus simple ; pour une équipe, deux nœuds 64 Go sont souvent le meilleur compromis.
Quel stack choisir en octobre 2026 ?
Le choix dépend de trois questions : quelle taille de modèle, combien d’utilisateurs simultanés, et quel budget mémoire.
- Développeur solo, modèles ≤ 35B, prototypage : DGX Spark 64 Go (4 999 $) + Ollama ou llama.cpp. Simple, suffisant, et le Qwen3.8-27B y tourne à 34-48 tok/s.
- Agent privé de classe frontier (100-200B MoE) : DGX Spark 128 Go + vLLM, ou deux Spark 64 Go en TP=2. DeepSeek-V4-Flash FP8 y atteint ~41 tok/s single-stream et ~350 tok/s agrégé.
- Serving multi-agents en production : cluster 2-4 nœuds + vLLM + LiteLLM + Chef pour la gestion. C’est la configuration qui exploite vraiment le cache KV de 1M tokens.
- Déploiement edge optimisé : TensorRT Edge-LLM, à condition d’accepter le workflow de compilation et la calibration NVFP4.
- Fine-tuning métier : NeMo ou Unsloth en QLoRA sur 27-30B ; full fine-tune réservé aux petits modèles.
Face au Ryzen AI Halo 192 Go à 7 299,99 $, le DGX Spark garde un avantage décisif : la vitesse (prompt processing 5× supérieur, bande passante légèrement meilleure) et l’écosystème CUDA. AMD gagne sur la capacité mémoire (300B de paramètres chargeables) et sur la polyvalence x86. Mais à capacité égale, le Spark reste plus rapide — et c’est souvent ce qui compte pour un agent interactif.
La vraie question de cet automne n’est plus « Spark ou Halo », mais « un gros ou deux petits ». La réponse, en 2026, tient dans une phrase : la mémoire unifiée est devenue le bien le plus cher du calcul local, et NVIDIA vient de le prouver en doublant le prix au gigaoctet.
Sources
- NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI — blogs.nvidia.com, 2 octobre 2026
- Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ? — Frandroid, 2 octobre 2026
- NVIDIA lance un DGX Spark 64 Go : moins de mémoire, mais une drôle d’astuce pour dépasser le modèle 128 Go — Clubic, 2 octobre 2026
- Le DGX Spark perd la moitié de sa mémoire mais conserve son tarif de 4 999 dollars — Pause Hardware, 2 octobre 2026
- Nvidia DGX Spark 64 Go : moins de mémoire pour plus cher et toujours pour l’IA locale — Generation-NT, 4 octobre 2026
- DGX Spark 64 Go : NVIDIA annonce une configuration — NeoTeo, 3 octobre 2026
- ASUS Ascent GX10 64GB: Compact Agentic AI Supercomputer — ASUS, 5 octobre 2026
- ASUS Ascent GX10 vs NVIDIA DGX Spark: Same GB10 Platform, Very Different Prices — Techgenyz, 5 octobre 2026
- AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed — TechTimes, 14 octobre 2026
- NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM — blockchain.news, 30 octobre 2026
- The Best DGX Spark for Local AI in 2026: LLM Speed, Model Sizes, and Clusters, With Sources — pyshine.com, 1er octobre 2026
- Building Windows for hybrid intelligence — Microsoft, 7 octobre 2026
- Progress Chef sur DGX Spark : gestion d’entreprise, clusters GB10 et LLM open source — Progress Software, 30 juillet 2026
- Tests indépendants Selfhostr / devtoolstack.mynewit.com, 2026
- Artificial Analysis, AA-AgentPerf-Local, 29 septembre 2026
- HotHardware, TweakTown, TechSpot, runaihome.com, compute-market.com — benchmarks et spécifications 2026
Article recherché et rédigé automatiquement · Magazine Electrosens