
 NVIDIA DGX Spark · 12 October 2026
DGX Spark 64 Go : la fiche technique réelle, ce qu’on peut y faire, et à qui elle s’adresse vraiment
NVIDIA a tranché : pour rester sous les 5 000 dollars, le petit supercalculateur de bureau perd la moitié de sa mémoire et de son stockage. À 4 999 $ pour une disponibilité le 23 octobre 2026, cette déclinaison 64 Go n’est pas une nouvelle machine — c’est la même, amputée. Reste à savoir si l’amputation est indolore ou si elle vous coûtera, à l’usage, bien plus que les 1 950 $ économisés.
4 999 $ pour 64 Go : la vraie histoire derrière le prix du DGX Spark
Il faut remonter à octobre 2025 pour comprendre ce qui se joue aujourd’hui. Le DGX Spark, alors présenté comme le successeur du Project DIGITS dévoilé au CES 2025, débarque avec 128 Go de mémoire unifiée et un prix d’appel de 3 999 $. Un an plus tard, la même machine s’affiche à 6 950 $ — une envolée de 74 % en douze mois, documentée par Frandroid. Entre-temps, la Founders Edition française est passée de 4 099 € à 4 800 € dès février, et le Dell Pro Max 4 To culminait à 7 149 € avant une nouvelle hausse.
La cause ? La flambée des prix de la DRAM et de la HBM, qui frappe toute l’industrie depuis le début de l’année 2026. Dans ce contexte, NVIDIA n’avait que deux options : maintenir le cap tarifaire et voir son mini-supercalculateur devenir un objet de luxe, ou trouver une manière de redescendre sous la barre psychologique des 5 000 $. La réponse, annoncée début octobre et relayée par Clubic, tient en une phrase : le DGX Spark 64 Go sera disponible à partir du 23 octobre 2026, à partir de 4 999 $.
La « drôle d’astuce » que pointe Clubic mérite qu’on s’y arrête. Il ne s’agit pas d’une nouvelle carte mère, d’un nouveau SoC ou d’une révision du design thermique. Selon Frandroid, NVIDIA a simplement retiré la moitié des puces mémoire soudées sur le même PCB, et remplacé le SSD de 4 To par un modèle de 2 To. C’est une opération de segmentation par soustraction, rendue possible par le fait que le GB10 Grace Blackwell n’a jamais été conçu pour adresser 128 Go en natif — il en a la capacité, pas l’obligation.
Le tableau des prix, remis à plat, donne ceci :
| Configuration | Lancement | Prix actuel (oct. 2026) | Évolution |
|---|---|---|---|
| DGX Spark 128 Go | 3 999 $ (oct. 2025) | 6 950 $ (2 oct. 2026) | +74 % |
| DGX Spark 64 Go | — | 4 999 $ (23 oct. 2026) | Nouveau |
| Founders Edition FR | 4 099 € | 4 800 € (février 2026) | +17 % |
| Dell Pro Max 4 To | — | 7 149 € avant hausse | — |
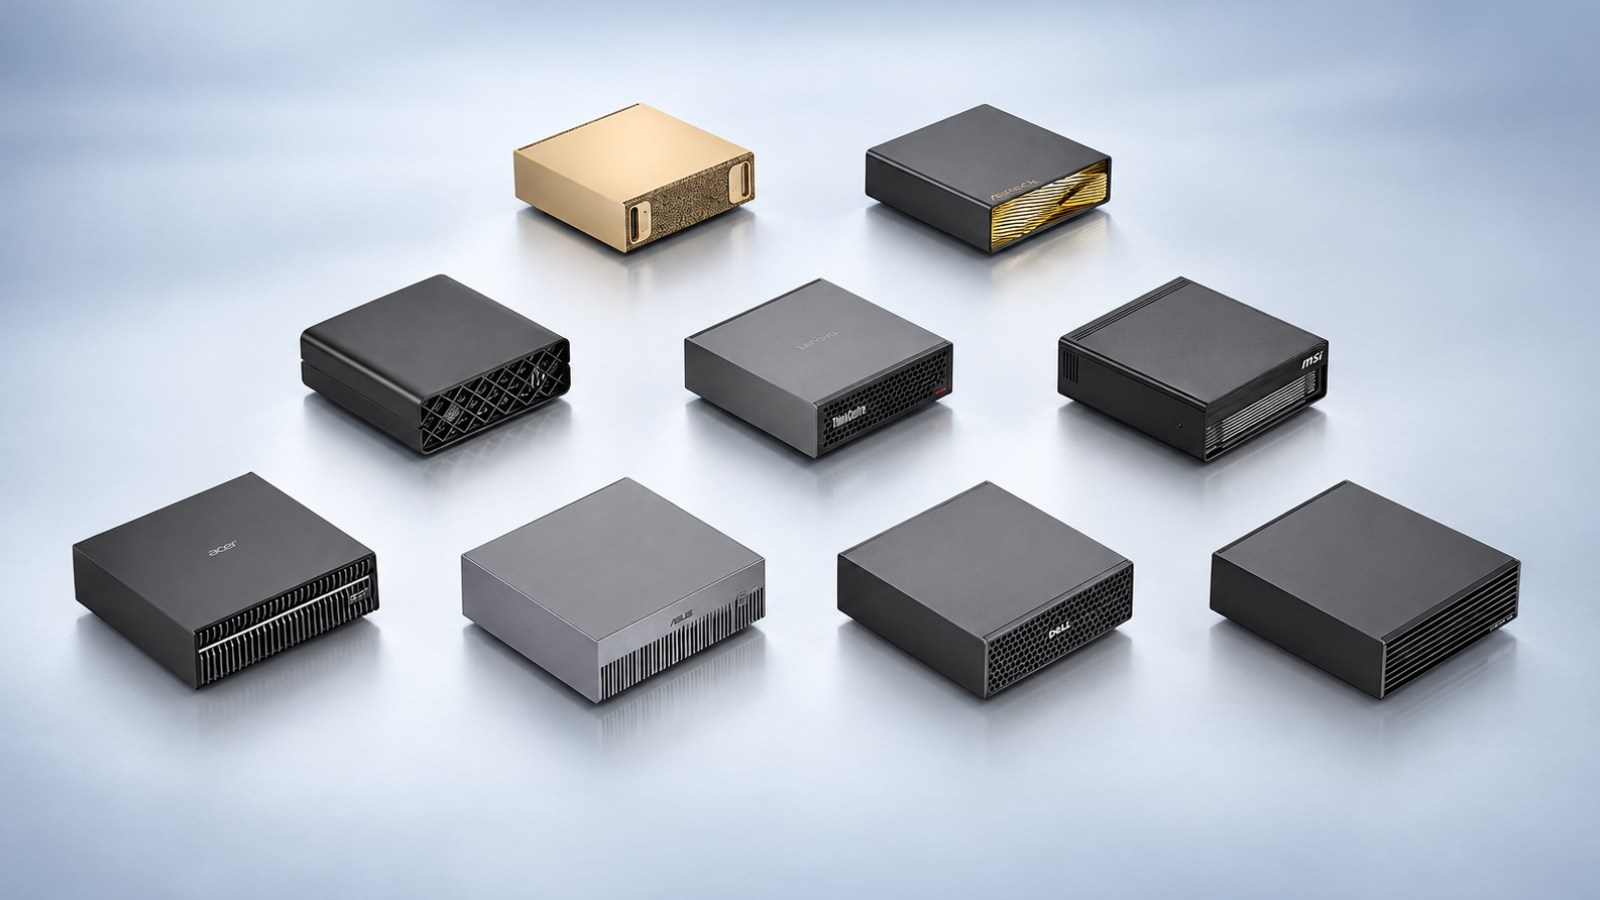
La distribution, elle, reste verrouillée : Acer, ASUS, Dell, Gigabyte, HP et MSI, sans Founders Edition 64 Go — NVIDIA réserve sa propre marque au modèle haut de gamme. Pour l’Europe, aucun tarif officiel n’a été communiqué ; Frandroid avance une estimation autour de 5 000 €, ce qui, au taux de change et à la TVA près, reste cohérent avec les 4 999 $ américains. Prudence donc : ce chiffre n’est pas confirmé par NVIDIA.
GB10 Grace Blackwell : anatomie d’un SoC qui tient dans 150 mm
Sous le capot, rien ne change. Le DGX Spark 64 Go embarque exactement le même GB10 Grace Blackwell Superchip que son grand frère. Concrètement : un CPU Arm à 20 cœurs, réparti en 10 Cortex-X925 (performance) et 10 Cortex-A725 (efficacité), accolé à un GPU Blackwell doté de 6 144 cœurs CUDA et de Tensor Cores de 5e génération. Le tout relié par un lien NVLink-C2C offrant 600 Go/s en full-duplex entre CPU et GPU.
C’est ce dernier chiffre qui mérite qu’on s’y attarde. Dans une architecture classique, le CPU et le GPU communiquent via PCIe, avec des allers-retours de données coûteux en latence et en bande passante. Ici, la mémoire est unifiée : le CPU et le GPU voient le même espace d’adressage, sans copie explicite. Pour l’inférence de grands modèles, cela change une chose fondamentale — le KV cache, cette mémoire d’état qui grossit linéairement avec la longueur du contexte, n’a plus besoin d’être dupliqué ou synchronisé entre deux pools distincts. C’est précisément ce qui permet, sur deux machines en cluster, d’atteindre un pool de cache KV partagé de 1 105 096 tokens, comme l’ont documenté des tests communautaires en août 2026.
Les caractéristiques physiques restent, elles aussi, identiques : bande passante mémoire annoncée à 273 Go/s, TDP de 170 W, refroidissement actif, format 150 × 150 × 50,5 mm. La connectique comprend 4 ports USB4, un port Ethernet 10 GbE, un HDMI 2.1a et un connecteur d’alimentation. Le système d’exploitation est DGX OS, une distribution basée sur Ubuntu, accompagnée de la pile logicielle NVIDIA AI Enterprise et de l’écosystème CUDA.
Ce qui change, en revanche, c’est la quantité de mémoire vive unifiée : 64 Go au lieu de 128 Go, et un SSD NVMe de 2 To au lieu de 4 To. Ces deux amputations, combinées, redéfinissent entièrement le profil d’usage de la machine — bien plus que le prix ne le suggère.
64 Go unifiés : ce qui rentre vraiment, précision par précision
C’est ici que le marketing rencontre la physique. NVIDIA annonce que le DGX Spark 64 Go fait tourner des modèles « jusqu’à 80 milliards de paramètres ». Le chiffre est exact — mais il cache une réalité plus nuancée, car l’empreinte mémoire d’un LLM ne se résume pas à ses poids.
Il faut additionner trois postes : les poids du modèle (fonction de la taille et de la précision), le KV cache (fonction de la longueur de contexte, du nombre de couches et de têtes d’attention), et les activations temporaires. Voici comment cela se traduit concrètement sur 64 Go :
| Taille modèle | INT4 (≈0,5 octet/param) | FP8 (≈1 octet/param) | FP16 (≈2 octets/param) | Verdict sur 64 Go |
|---|---|---|---|---|
| 7–8B | ~4 Go | ~8 Go | ~16 Go | Confortable, contexte très long possible |
| 14B | ~7 Go | ~14 Go | ~28 Go | Confortable en INT4/FP8 |
| 32B | ~16 Go | ~32 Go | ~64 Go | INT4/FP8 OK, FP16 à la limite |
| 70B dense | ~35 Go | ~70 Go | ~140 Go | INT4 uniquement, contexte court |
| 120B MoE | ~60 Go | ~120 Go | — | INT4 très serré, contexte minimal |
Le point de rupture est net : au-delà de 70 milliards de paramètres en dense, le FP8 ne passe plus. Un 70B en INT4 occupe environ 35 Go de poids, ce qui laisse une trentaine de gigaoctets pour le KV cache et les activations — suffisant pour un contexte de quelques milliers de tokens, insuffisant pour du long contexte. Un 120B MoE quantifié en INT4 tient tout juste, mais au prix d’un contexte si court qu’il en devient inutilisable pour du RAG sérieux.
Quant au débit, il est directement contraint par la bande passante mémoire de 273 Go/s. En première approximation, un modèle de 32B en INT4 (16 Go de poids) peut théoriquement atteindre une quinzaine de tokens par seconde en décodage pur, avant tout overhead. Les mesures réelles confirment cet ordre de grandeur : sur Qwen3.8-27B, le DGX Spark délivre 34 à 38 tokens/s en session unique (août 2026), et jusqu’à 163 tokens/s en pic de décodage sur Qwen3.6-27B, avec 136 tokens/s en charge multi-agents (10 agents simultanés). Sur un modèle bien plus gros, un DeepSeek-V4-Flash en IQ2_XXS ne dépasse pas ~14 tokens/s en single-stream, avec un prefill à 410 t/s.
Qwen, Llama, DeepSeek, Mistral : la short-list qui tourne sur la machine
Passons aux recettes concrètes. Sur 64 Go, la short-list des modèles réellement exploitables se dessine clairement.
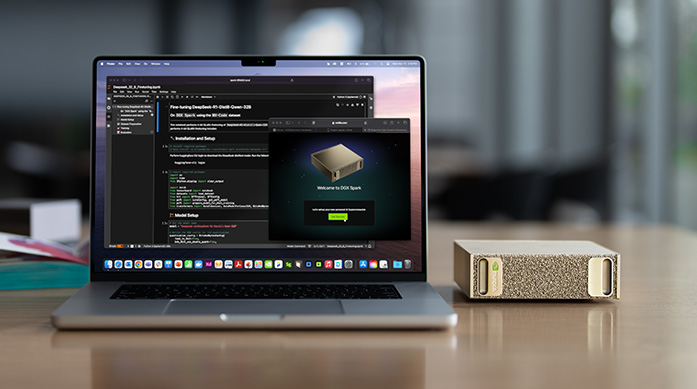
Qwen3 32B en FP8 est le candidat idéal : 32 Go de poids, il reste 32 Go pour le KV cache, ce qui autorise des contextes confortables. C’est le meilleur compromis qualité/place sur cette machine. Qwen3.8-27B, sorti en août 2026, tourne à 34-38 tokens/s et constitue aujourd’hui la référence pour un usage agentique.
Llama 4 Scout en INT4 (109B MoE, ~17B actifs) est plus délicat : quantifié agressivement, il tient dans les 64 Go, mais la dégradation qualitative sur les contextes longs est réelle. À réserver aux tâches courtes.
DeepSeek-R1 distillé 70B en INT4 est jouable — environ 35 Go de poids — mais avec un contexte limité. C’est le cas d’usage typique où l’on sent la morsure des 64 Go.
Mistral Large quantifié et Gemma 3 27B complètent le tableau : le premier en AWQ/GPTQ pour rester sous la barre, le second en FP8 sans difficulté.
Côté moteurs, chaque format a son écosystème : llama.cpp et Ollama excellent sur les GGUF quantifiés (jusqu’à 67 tok/s sur un 35B-A3B selon les tests d’août 2026), vLLM brille sur le FP8 natif et le serving multi-requêtes, TensorRT-LLM offre les meilleures performances brutes mais au prix d’une complexité de déploiement supérieure. Le piège classique : une quantification INT4 trop agressive dégrade silencieusement la qualité sur les contextes longs, là où le FP8 préserve bien mieux la fidélité — au prix d’une empreinte double.
Fine-tuning LoRA : ce qui reste viable, ce qui ne l’est plus
C’est le chapitre où l’écart entre 64 et 128 Go devient brutal. Le fine-tuning ne se contente pas de charger les poids : il faut stocker les gradients, l’état de l’optimiseur (souvent Adam, qui triple l’empreinte des paramètres entraînés), et les activations. Le LoRA atténue le problème en n’entraînant qu’une fraction des paramètres, mais les gradients et l’optimiseur restent proportionnels à cette fraction — et les activations, elles, dépendent de la taille du batch et de la longueur de séquence.
Sur 64 Go, la frontière pratique se situe autour de 32B en QLoRA (quantification 4 bits des poids de base + LoRA en précision supérieure). Au-delà, sur un 70B, les gradients et l’état de l’optimiseur font exploser la facture mémoire. Le full fine-tuning, lui, est hors de portée dès qu’on dépasse les petits modèles.
L’outillage reste mature : Unsloth pour l’efficacité mémoire, PEFT pour la flexibilité, Axolotl pour l’orchestration, NeMo pour les pipelines NVIDIA. Mais l’argument sérieux en faveur du 128 Go, c’est précisément là : il ouvre le full fine-tuning sur des modèles moyens et rend le LoRA confortable sur du 70B. Pour un laboratoire ou une équipe qui fine-tune régulièrement, les 1 950 $ d’écart se justifient vite.
Cluster 2× et 4× : le « 70 % de perf en plus » à l’épreuve du réel
NVIDIA a mis en avant un chiffre : deux DGX Spark reliés en cluster via le Sync Cluster Assistant (câble QSFP/ConnectX-7, configuration automatique) offriraient jusqu’à 70 % de performances supplémentaires sur Qwen 3.8 27B. Ce chiffre provient d’un test constructeur relayé par Clubic — et aucun test tiers ne l’a reproduit à ce jour.
Ce qu’il mesure vraiment mérite d’être décrypté. En inférence distribuée en tensor parallel (TP=2), deux machines se partagent les couches du modèle et communiquent à chaque passe. Le gain dépend fortement du modèle : sur un petit modèle où la bande passante n’est pas le goulot, l’overhead de communication peut annuler le bénéfice. Sur un gros modèle qui ne tiendrait pas sur une seule machine, le gain est structurel.
Les chiffres communautaires d’août 2026 sont plus parlants : sur DeepSeek-V4-Flash FP8 en TP=2 avec vLLM, on atteint ~350 tokens/s agrégés à concurrence 32, ~41 tokens/s en single-stream, et un prefill à ~1 785 t/s. Deux DGX Spark supportent jusqu’à 405 milliards de paramètres — bien au-delà des 200 milliards annoncés par NVIDIA. Le cluster a donc du sens pour l’inférence distribuée de gros modèles et pour les charges multi-requêtes. Il n’en a aucun pour un développeur solo qui fait tourner un 32B : la latence inter-nœuds et l’overhead de communication plomberaient l’expérience.
Agent local, RAG, batch : trois usages types passés au crible
Agent local always-on. C’est le scénario rêvé : une machine qui tourne 24/7, exécute des agents, répond sans cloud. Sur 64 Go, un Qwen3.8-27B laisse assez de place pour un ou deux agents concurrents — les mesures montrent 136 tokens/s avec 10 agents sur Qwen3.6-27B, mais c’était sur 128 Go. Avec 64 Go, on divise par deux la marge. Le TDP de 170 W et le refroidissement actif restent gérables pour un bureau. Verdict : ça passe, mais sans marge.
RAG sur base documentaire. Ici, le KV cache est roi. Un RAG sérieux implique des contextes longs, donc un KV cache volumineux. En 64 Go, avec un 32B en FP8 (32 Go de poids), il reste ~32 Go pour le cache — jouable. Mais il faut aussi caser le modèle d’embedding et, idéalement, un reranker. La cohabitation devient serrée. Verdict : ça passe juste, avec un modèle de taille modérée.
Inférence batch. Le SSD de 2 To (contre 4 To sur le 128 Go) limite le nombre de modèles stockés simultanément. Pour du serving à fort débit, 64 Go contraignent la taille des modèles servis. Verdict : ça ne passe pas pour de la production sérieuse multi-modèles.
64 Go ou 128 Go ? La grille de décision
| Profil | 64 Go suffit ? | Recommandation |
|---|---|---|
| Développeur solo testant des agents | ✅ Oui | 64 Go, modèles ≤32B |
| PME voulant un serveur d’inférence local | ⚠️ Limite | 128 Go si multi-modèles |
| Labo qui fine-tune | ❌ Non | 128 Go indispensable |
| Équipe RAG en production | ⚠️ Limite | 128 Go pour la marge |
Les alternatives à 5 000 € méritent examen. L’Acer DGX, même GB10, 128 Go, est proposé 500 à 1 000 $ sous le prix NVIDIA à l’automne 2026 — une anomalie de marché à surveiller. L’AMD Ryzen AI Halo (128 Go LPDDR5X, 256 Go/s, 34-39 tok/s sur 120B) est une alternative crédible. Le Mac Studio M-series reste une option pour l’inférence pure. La location cloud échappe à la question matérielle.

Ce que cette machine dit de 2026 : mémoire chère, IA locale sous tension
Le DGX Spark 64 Go est un révélateur. Dans un marché où la mémoire coûte plus cher que le silicium, NVIDIA adapte sa gamme plutôt que de la brader : on retire des puces, on garde le SoC, on redescend sous les 5 000 $. C’est une réponse honnête à une question que le secteur entier se pose désormais — non plus « peut-on faire tourner un LLM en local ? », mais « à quel prix, et pour quelle qualité ? ».
Pour 2027, la tendance est claire : généralisation des SoC à mémoire unifiée, concurrence accrue (Acer, AMD, Apple), et pression continue sur les prix tant que la crise DRAM persiste. Le DGX Spark 64 Go n’est pas la machine idéale — c’est la machine possible dans un monde où la mémoire est devenue le facteur limitant. Et à ce titre, elle mérite qu’on la regarde de près, à condition de savoir exactement ce qu’on veut en faire.
Sources
- NVIDIA lance un DGX Spark 64 Go — Clubic
- NVIDIA lance le DGX Spark en 64 Go — Frandroid
- NVIDIA DGX Spark 64GB Launched and Big 128GB GB10 Price Increases — ServeTheHome
- Nvidia debuts $4,999 DGX Spark amid memory crunch — The Register
- Nvidia’s 64GB DGX Spark starts at $4,999 on October 23 — tbreak
- NVIDIA annonce un DGX Spark 64 Go — Neoteo
- NVIDIA DGX Spark 64 Go — GamingDeputy
- Le DGX Spark se prend une cure d’amincissement — Hardware & Co
- AA-AgentPerf-Local — Artificial Analysis
- Matériel pour l’IA locale en 2026 — Context Studios
- Building Windows for hybrid intelligence — Microsoft
Article recherché et rédigé automatiquement · Magazine Electrosens