
 NVIDIA DGX Spark · 7 November 2026
DGX Spark 64 Go à 4 999 $ : la SKU qui divise, les 128 Go à 6 950 $, et ce que cela change vraiment pour vos LLM locaux
NVIDIA a officialisé le 2 octobre 2026 une DGX Spark à 64 Go de mémoire unifiée, en vente depuis le 23 octobre à partir de 4 999 $ — plus cher que le tarif de lancement de la version 128 Go (3 999 $), et alors que celle-ci vient de bondir à 6 950 $. Dans un marché mémoire en pleine flambée, cette SKU au rabais cache une équation économique bien plus subtile qu’il n’y paraît. Décryptage en profondeur pour ceux qui hésitent, et pour ceux qui possèdent déjà une Spark.
4 999 $ pour 64 Go : la Spark qui divise (et pourquoi les 128 Go sont désormais à 6 950 $)
Il y a des annonces qui ressemblent à des paradoxes. Celle-ci en est un beau : le 2 octobre 2026, NVIDIA a dévoilé une nouvelle déclinaison de sa DGX Spark dotée de 64 Go de mémoire unifiée, facturée à partir de 4 999 $, commercialisée depuis le 23 octobre 2026. Le problème, c’est que la version 128 Go, lancée à 3 999 $ en octobre 2025, a vu son prix grimper à 4 699 $ en février 2026 — puis à 6 950 $ le 2 octobre 2026, selon le relevé de Frandroid. Soit +74 % en un an, à configuration identique.
Autrement dit : la machine deux fois moins dotée en RAM coûte aujourd’hui 2 000 $ de moins que la version 128 Go au prix d’octobre 2026, mais 1 000 $ de plus que le tarif de lancement initial de cette même 128 Go. La communauté ne s’y est pas trompée. Sur les forums et Reddit, la question revient en boucle : pourquoi payer plus pour moins ? La réponse est moins absurde qu’il n’y paraît une fois le contexte mémoire rétabli.
La réponse tient en un mot : mémoire. La crise DRAM/HBM qui secoue l’industrie depuis plusieurs trimestres a fait exploser le coût des modules LPDDR5X. NVIDIA, comme tous les fabricants, doit composer avec des prix d’approvisionnement qui ont changé la donne. En réduisant la capacité de 128 à 64 Go, le constructeur parvient à maintenir un produit « abordable » dans une grille tarifaire qui s’est décalée vers le haut. Ce n’est pas une bonne affaire pour l’acheteur — c’est un ajustement de marché. Et NVIDIA le dit sans détour : c’est le même circuit imprimé, avec deux fois moins de puces mémoire.
Ce qu’il faut retenir de confirmé à ce stade :
- La DGX Spark embarque la superpuce GB10 Grace Blackwell (CPU 20 cœurs Arm Neoverse V2 + GPU Blackwell à 6 144 cœurs CUDA, l’équivalent d’une RTX 5070), jusqu’à 1 pétaFLOP en FP4.
- La version originale propose 128 Go LPDDR5X unifiée et 4 To de stockage NVMe.
- La nouvelle SKU 64 Go divise la RAM par deux et le stockage également (2 To), selon Frandroid — un point désormais documenté, plus seulement supposé.
- Le prix de lancement de la version 128 Go était de 3 999 $ / 4 099 € (Founders Edition), avant la hausse de février 2026 (4 699 $ / 4 800 €), puis celle du 2 octobre 2026 (6 950 $).
- La SKU 64 Go n’est pas vendue par NVIDIA en Founders Edition : uniquement chez Acer, ASUS, Dell, Gigabyte, HP et MSI. Le prix européen n’est pas communiqué ; à ce rythme, on devrait tourner autour de 5 000 €, et plus chez les constructeurs qui facturent la garantie sur site.
L’angle de cet article est simple : au-delà du choc tarifaire, que signifie concrètement cette division par deux pour quelqu’un qui veut faire tourner des LLM open source en local, fine-tuner des modèles, ou bâtir un cluster ? Et pour ceux qui possèdent déjà une Spark 128 Go, cette nouvelle SKU change-t-elle quelque chose ?
GB10 sous le capot : ce que 64 Go changent vraiment (et ce qu’ils ne changent pas)
Commençons par le socle matériel, qui reste identique entre les deux SKU. La DGX Spark repose sur la superpuce GB10 Grace Blackwell : un CPU 20 cœurs Arm (architecture Neoverse V2), un GPU Blackwell intégré avec environ 6 144 cœurs CUDA et support du FP4 (et du format NVFP4 désormais pris en charge nativement côté logiciel), le tout relié par NVLink-C2C. La bande passante mémoire est annoncée à ~273 Go/s, et la consommation tourne autour de 170 W — une prouesse pour un format mini-tour de 1,2 kg.
Ce qui change, c’est la taille du réservoir. Et dans une architecture à mémoire unifiée, ce réservoir conditionne tout : la taille maximale du modèle résident, la fenêtre de contexte disponible, et la marge pour le KV cache. Sur une Spark 128 Go, NVIDIA annonce la prise en charge de modèles jusqu’à 200 milliards de paramètres ; deux unités interconnectées via ConnectX-7 montent à 405 milliards de paramètres.
Avec 64 Go, NVIDIA annonce officiellement le support de modèles jusqu’à 100 milliards de paramètres entièrement en local — et deux unités 64 Go en cluster mutualisent 128 Go et étendent le support à 200 milliards de paramètres, selon la fiche produit relayée par Netics. C’est la frontière réelle de cette SKU.
Ce qui ne change pas :
- Le ConnectX-7 (jusqu’à 100 GbE) et la capacité de clustering restent présents. C’est un point crucial : NVIDIA maintient la possibilité de relier plusieurs Spark, y compris des 64 Go entre elles ou avec des 128 Go. Deux unités 64 Go reliées par câble QSFP forment une fabrique 200 GbE.
- Les 4 ports USB-C (dont un pour l’alimentation), le HDMI 2.1a jusqu’à 8K@120Hz, le Wi-Fi 7.
- Le DGX OS (Ubuntu personnalisé), le NVIDIA Agent Toolkit, les bibliothèques CUDA-X AI, les modèles ouverts Nemotron, et la prise en charge d’Ollama, vLLM et PyTorch. Blender est cité parmi les premiers fournisseurs d’applications créatives à soutenir la plateforme, avec un installateur à venir.
La différence matérielle vérifiable se limite donc, en l’état des informations disponibles, à RAM et stockage. Pas de GPU bridé, pas de connectique amputée, pas de perte de capacité cluster. C’est une bonne nouvelle pour ceux qui veulent construire progressivement.
Fenêtre de contexte, quantification et KV cache : la vraie frontière des 64 Go
Traduisons les 64 Go en contraintes pratiques. C’est ici que se joue la vraie différence pour un utilisateur de LLM locaux.
Quels modèles tiennent réellement ?
| Modèle | Quantification | Mémoire poids | Faisable sur 64 Go ? | Faisable sur 128 Go ? |
|---|---|---|---|---|
| Qwen3 32B | Q4/Q5 | ~18–22 Go | ✅ Confortable | ✅ Très confortable |
| Qwen3.8-27B | Q4 | ~16 Go | ✅ Confortable | ✅ Très confortable |
| Llama 3.3 70B | Q3 | ~30–35 Go | ⚠️ Juste, contexte limité | ✅ Confortable en Q4 |
| Llama 3.3 70B | Q4 | ~40–42 Go | ⚠️ Très serré, contexte minimal | ✅ Confortable |
| GPT-OSS 120B | MXFP4 | ~60 Go | ❌ Impossible (débordement) | ✅ Confortable |
| DeepSeek-R1 distillé 70B | Q3/Q4 | ~35–42 Go | ⚠️ Serré | ✅ Confortable |
| Ant Ling-3.0-Flash (124B-A5B) | Q4 | ~65–70 Go | ❌ Impossible | ⚠️ Limite |
Le tableau parle de lui-même. Sur 64 Go, la zone de confort s’arrête autour des modèles 30B en Q4/Q5. Au-delà, il faut soit descendre en quantification (Q3, voire Q2), soit accepter un contexte très réduit. La limite officielle des 100 milliards de paramètres annoncée par NVIDIA s’entend d’ailleurs en quantification agressive et sans grande marge de contexte — pas en FP16.
Le piège du KV cache
C’est le point que beaucoup sous-estiment. La mémoire ne sert pas qu’aux poids du modèle : elle héberge aussi le KV cache, qui grandit linéairement avec la longueur du contexte. Sur un modèle 70B en Q4, occuper 42 Go de poids sur 64 Go laisse à peine 20 Go pour le KV cache, le système et les buffers. Résultat : une fenêtre de contexte qui fond comme neige au soleil.
À l’inverse, sur 128 Go, un 70B en Q4 laisse ~85 Go disponibles — de quoi tenir un contexte de plusieurs dizaines de milliers de tokens sans transpirer, ou de servir deux modèles en parallèle.
Les stratégies d’offload CPU/GPU (via llama.cpp notamment) permettent de déborder sur la RAM système, mais au prix d’une chute de débit souvent sévère. Sur une Spark, où tout est unifié, l’offload est moins pénalisant que sur une config discrète — mais il reste un compromis.
Ce que disent les benchmarks (et comment extrapoler honnêtement vers la 64 Go)
Passons aux chiffres réels. Les données disponibles concernent majoritairement la Spark 128 Go, mais elles éclairent directement le comportement de la version 64 Go.

Sur GPT-OSS 20B en MXFP4 avec Ollama, la Spark affiche environ 60,9 tokens/s en décodage selon le tableur LMSYS consulté le 17 septembre 2026 — même si le corps de la revue LMSYS rapporte 49,7 tokens/s pour la même machine, une divergence interne qui invite à la prudence. Sur GPT-OSS 120B MXFP4 via llama.cpp (février 2026), on mesure 58,72 tokens/s à contexte nul, chutant à 42,76 tokens/s à 32 768 tokens de contexte — soit une perte de 27 %. Le prefill atteint 2 443,91 tokens/s sur un prompt de 2 048 tokens.
Comparons avec la concurrence :
| Machine | Débit (GPT-OSS 20B, décodage) |
|---|---|
| RTX 5090 | 205,5 tok/s |
| RTX PRO 6000 Blackwell | 215,2 tok/s |
| RTX 5080 | 140,9 tok/s |
| DGX Spark | 60,9 tok/s |
| Mac Studio M1 Max | 52,7 tok/s |
| Mac mini M4 Pro | 46,9 tok/s |
La RTX 5090 génère 3,4× plus vite que la Spark. Mais attention : elle ne peut pas charger un modèle de 120B. C’est le compromis fondamental de la Spark — lente mais capable de charger gros.
Pourquoi la 64 Go ne sera pas 2× plus lente
Point crucial : la bande passante mémoire reste identique entre les deux SKU (~273 Go/s). Or, en décodage, le débit est limité par la bande passante, pas par la capacité. Donc à modèle égal, une Spark 64 Go et une Spark 128 Go afficheront des performances quasi identiques.
La différence se jouera sur ce qu’on peut charger, pas sur la vitesse. Une 64 Go ne pourra tout simplement pas faire tourner un GPT-OSS 120B sans offload massif — là où la 128 Go le fait nativement.
Autres chiffres utiles pour situer la Spark dans l’écosystème :
- Qwen3.6-27B : 28–33 tok/s en session unique, jusqu’à 163 tok/s en pic de décodage, et 136 tok/s avec 10 agents simultanés.
- Qwen3.8-27B (août 2026) : 34–38 tok/s. C’est précisément le modèle du test officiel NVIDIA : sur deux systèmes 64 Go en cluster, le constructeur annonce jusqu’à 1,7× les performances d’un seul, avec un environnement logiciel inchangé quand un second nœud apparaît (NeoTeo).
- Ant Ling-3.0-Flash (124B-A5B) : estimé à 15–20 tok/s sur Spark.
- DeepSeek-V4-Flash IQ2_XXS (ds4.c) : ~14 tok/s en single-stream, 410 tok/s en prefill.
À noter : aucun benchmark indépendant exhaustif n’existe encore pour la SKU 64 Go à ce jour. Les seuls chiffres publics spécifiques à cette configuration sont ceux du fournisseur (test Qwen 3.8 27B en cluster, jusqu’à 1,7×). Toute extrapolation reste donc prudente.
Fine-tuning LoRA/QLoRA : la 64 Go est-elle un jouet ou un vrai outil ?
C’est la question qui fâche. Le fine-tuning local est devenu un argument de vente majeur pour la Spark — NVIDIA le met en avant dans sa communication. Mais que peut-on réellement faire sur 64 Go ?
Rappelons les besoins mémoire d’un fine-tuning :
- Poids quantifiés du modèle
- Optimiseur (AdamW en 32-bit double souvent la facture)
- Activations (dépend du batch et de la longueur de séquence)
- Gradients
En QLoRA (quantification 4-bit + LoRA), on divise drastiquement les besoins. Voici ce qui est réaliste :
| Taille modèle | Méthode | Faisable sur 64 Go | Faisable sur 128 Go |
|---|---|---|---|
| 7B–13B | QLoRA | ✅ Confortable | ✅ Très confortable |
| 30B | QLoRA | ⚠️ Limite haute | ✅ Confortable |
| 30B | LoRA (16-bit) | ❌ Non | ⚠️ Juste |
| 70B | QLoRA | ❌ Non (sauf offload extrême) | ⚠️ Limite |
| 70B | LoRA | ❌ Non | ❌ Non |
Le verdict est clair : la 64 Go est un outil d’itération rapide, pas une plateforme d’entraînement sérieux. Elle excelle pour tester des recettes QLoRA sur des modèles 7B–13B, valider des datasets, prototyper des adaptateurs. Dès qu’on vise du 30B+ en QLoRA avec des séquences longues, la 128 Go devient nécessaire.
Pour le fine-tuning lourd, NVIDIA positionne une autre machine : la DGX Station GB300 Grace Blackwell Ultra, annoncée à ~20 pétaFLOPS FP4, avec une cible explicite entraînement/fine-tuning. Une déclinaison DGX Station for Windows a été dévoilée début octobre 2026 avec 748 Go de mémoire cohérente et 20 pétaFLOPS FP4, pour un lancement au Q4 2026 via six partenaires OEM. C’est un autre budget, une autre catégorie.
La Spark, quelle que soit sa capacité, reste un outil de prototypage et d’inférence, pas un cluster d’entraînement.
Clustering : quand deux (ou quatre) Spark changent l’équation économique
Voici l’argument qui sauve la 64 Go. NVIDIA maintient la capacité de clustering sur cette SKU, via ConnectX-7 (100 GbE) et l’interconnexion PAIR — le Personal AI Router, un outil gratuit et open source lancé par NVIDIA qui transforme un réseau domestique en cluster d’inférence distribué.
Deux Spark interconnectées offrent 256 Go agrégés (en 128 Go) et, selon la communication NVIDIA, la prise en charge de modèles jusqu’à 405 milliards de paramètres. Deux Spark 64 Go, elles, mutualisent 128 Go et montent à 200 milliards de paramètres. Les chiffres réels observés sur des configurations 2× Spark 128 Go sont parlants :
- DeepSeek-V4-Flash FP8 en TP=2 avec vLLM : ~350 tok/s agrégés à c=32, ~41 tok/s en single-stream, ~1 785 tok/s en prefill.
- Cache KV partagé : un pool de 1 105 096 tokens sur deux Spark.
Faisons le calcul économique, avec les prix d’octobre 2026 :
| Configuration | Coût | RAM totale | Modèles max |
|---|---|---|---|
| 1× Spark 64 Go | 4 999 $ | 64 Go | ~100B (Q4 serré) |
| 1× Spark 128 Go | 6 950 $ (oct. 2026) | 128 Go | ~200B |
| 2× Spark 64 Go | 9 998 $ | 128 Go agrégés | ~200B (annoncé) |
| 2× Spark 128 Go | 13 900 $ | 256 Go agrégés | ~405B (théorique) |
Le paradoxe saute aux yeux : deux Spark 64 Go coûtent plus du double d’une Spark 128 Go (9 998 $ contre 6 950 $), pour une capacité agrégée identique en RAM — mais avec la promesse de modèles plus gros grâce au parallélisme, et un gain mesuré par NVIDIA jusqu’à 1,7× sur Qwen 3.8 27B. Sauf que cette promesse a un coût caché : la bande passante inter-nœuds, bien plus faible que le NVLink-C2C interne, qui pénalise le tensor parallelism sur les modèles serrés.
C’est exactement le mur qu’a rencontré Dre Dyson dans notre enquête sur Qwen3.5-397B-A17B sur deux DGX Spark : le pari à 12 000 $ fonctionne, mais les performances dépendent étroitement de la topologie réseau et de la qualité du câblage QSFP. Pour un cluster 2× 64 Go, la question n’est donc pas « est-ce que ça marche ? » mais « est-ce que le gain de 1,7× justifie 3 000 $ de plus qu’une 128 Go unique ? ». Pour la plupart des usages, non.
Octobre 2026 : la mise à jour logicielle qui change la donne (et vaut pour les deux SKU)
Voici le point que le débat tarifaire occulte : les deux SKU partagent le même DGX OS et la même pile logicielle, et cette pile vient de recevoir une mise à jour majeure. Le 21 octobre 2026, NVIDIA a déployé sa DGX Spark Software Updates – October 2026 Release sur les forums développeurs (forums.developer.nvidia.com), avec la promesse que les systèmes partenaires GB10 Grace Blackwell (Acer, ASUS, Dell, Gigabyte, HP, MSI) reçoivent les mêmes correctifs.
Cette mise à jour d’octobre 2026 soude l’écosystème :
- Support natif de vLLM consolidé (officialisé en juin 2026), avec speculative decoding et NVFP4.
- TensorRT-LLM et le workflow TensorRT Edge-LLM pour l’inférence edge, documenté par NVIDIA le 30 octobre 2026 : un workflow en ligne de commande pour faire tourner Nemotron-3.5 Lightning sur DGX Spark 64 Go, avec benchmarks et résultats de speculative decoding à l’appui (blockchain.news). C’est la première documentation officielle ciblant explicitement la SKU 64 Go.
- PAIR (Personal AI Router) pour le clustering domestique.
- Prise en charge d’Unsloth, Axolotl et Atlas pour le fine-tuning, et de CUDA 13.4.
Autrement dit : la 64 Go n’est pas une machine au rabais logiciellement. Elle hérite de tout l’écosystème, y compris des optimisations NVFP4 et du speculative decoding qui compensent en partie sa lenteur brute. C’est un argument fort pour qui veut entrer dans l’écosystème DGX à moindre coût — à condition d’accepter le plafond mémoire.
Les alternatives qui rebattent les cartes (et pourquoi la Spark reste dans la course)
La Spark 64 Go n’arrive pas sur un marché vide. Deux concurrents méritent d’être posés sur la table.
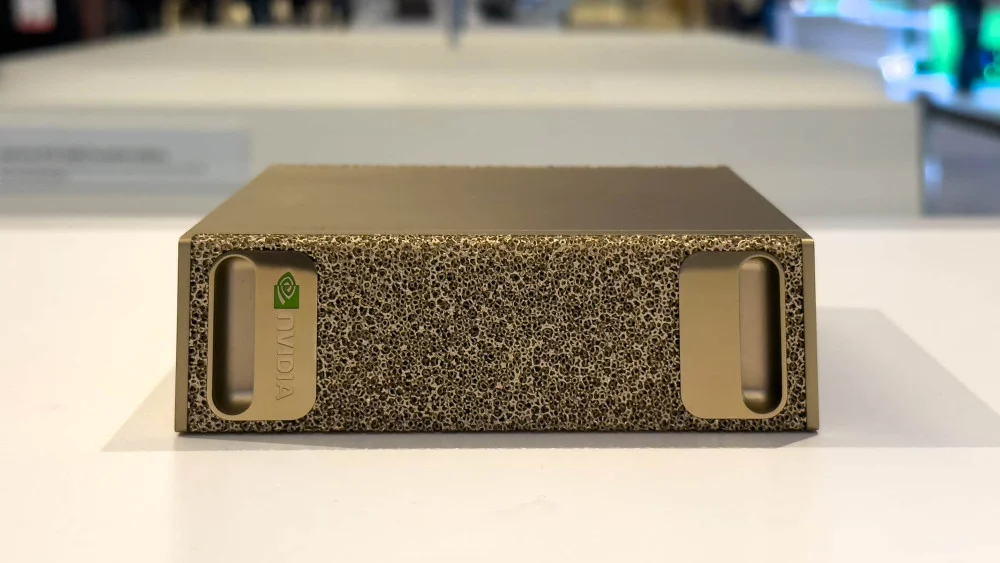
L’ASUS Ascent GX10 64 Go. Même plateforme GB10, même 1 pétaFLOP, même capacité à faire tourner des modèles 30–35B et des agents en local — mais un prix, un stockage, un refroidissement et une disponibilité différents, selon Techgenyz. Pour qui veut la puce GB10 sans le tarif NVIDIA, c’est la voie à examiner en priorité.
L’AMD Ryzen AI Halo 192 Go. Lancé chez Micro Center à 7 299,99 $, c’est le premier desktop compact capable de charger des modèles open weight de 300 milliards de paramètres. Les benchmarks indépendants montrent toutefois que la DGX Spark reste devant en vitesse (TechTimes). Le Halo gagne sur la capacité, la Spark sur le débit et la maturité logicielle.
Les mini-PC GB10 des partenaires. Acer propose une machine 128 Go livrée depuis le 8 septembre 2026, positionnée 500 à 1 000 $ sous le prix NVIDIA officiel. Avec les 128 Go à 6 950 $ chez NVIDIA, cet écart devient stratégique : un Acer GB10 128 Go peut revenir moins cher qu’une Spark 64 Go… pour le double de mémoire. C’est probablement le meilleur arbitrage du moment, et il rend la SKU 64 Go encore plus difficile à justifier.
Enfin, côté écosystème de mesure, AA-AgentPerf-Local d’Artificial Analysis (lancé le 29 septembre 2026) teste désormais DGX Spark, Ryzen AI Halo, MacBook Pro M5 Pro et RTX 5090 sur des modèles open weight — de quoi comparer sur des bases indépendantes plutôt que sur les seuls chiffres constructeur.
Verdict : pour qui la 64 Go a-t-elle un sens ?
Soyons clairs. La DGX Spark 64 Go n’est pas un bon achat pour qui veut la puissance mémoire brute : à 4 999 $, elle coûte plus cher que le lancement de la 128 Go, et les alternatives GB10 128 Go des partenaires sont souvent moins chères. Elle a néanmoins trois cas d’usage défendables :
- L’entrée progressive dans l’écosystème DGX. Même DGX OS, même pile logicielle, même ConnectX-7, même capacité cluster. On achète une 64 Go aujourd’hui, on en ajoute une seconde demain pour 128 Go agrégés et 200B de support. C’est la seule voie où le surcoût se justifie.
- Le prototypage d’agents et le fine-tuning léger. Modèles 7B–30B en QLoRA, agents longue durée avec Nemotron-3.5 Lightning, itération rapide : la 64 Go fait le travail, et la mise à jour d’octobre 2026 lui donne les mêmes outils qu’aux grandes.
- La souveraineté à petit budget. Pour une équipe qui veut du local privé sans cloud, 4 999 $ reste le ticket d’entrée le plus bas de la gamme DGX — à condition d’accepter le plafond des 100B.
Pour tous les autres — ceux qui veulent faire tourner GPT-OSS 120B, DeepSeek-V4-Flash ou un 70B en Q4 avec du contexte — la 128 Go reste le bon choix, que ce soit via NVIDIA à 6 950 $ ou via un partenaire GB10 moins cher. Et pour l’entraînement sérieux, c’est vers la DGX Station GB300 (ou sa déclinaison Windows à 748 Go) qu’il faut se tourner.
La vraie question n’est donc pas « 64 ou 128 Go ? » mais « une ou deux machines ? ». Et à ce jeu, le calcul de NVIDIA — parer à la crise mémoire en rognant la RAM tout en préservant le clustering — est cohérent, même s’il laisse l’acheteur face à une addition salée.
Sources
- Frandroid — Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ? (prix, dates, partenaires, hausses 128 Go)
- Netics — DGX Spark 64 Go : le calcul IA local à 4 999 dollars (limites 100B/200B, cluster QSFP 200 GbE, pile logicielle)
- NeoTeo — DGX Spark 64 Go : NVIDIA annonce une configuration (test Qwen 3.8 27B, jusqu’à 1,7×)
- NVIDIA Developer Forums — DGX Spark Software Updates, October 2026 Release (21 octobre 2026)
- Blockchain.news — NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM (30 octobre 2026, Nemotron-3.5 Lightning sur 64 Go)
- Techgenyz — ASUS Ascent GX10 vs NVIDIA DGX Spark (comparatif GB10, prix, stockage)
- TechTimes — AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed (7 299,99 $, 300B, débit)
- Tech-Insider — NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs (Q4 2026, six OEM)
- NVIDIA — DGX Platform (fiche officielle)
- Benchmarks LMSYS, llama.cpp, vLLM TP=2 et AA-AgentPerf-Local (Artificial Analysis, 29 septembre 2026) — chiffres consolidés du magazine.
Article recherché et rédigé automatiquement · Magazine Electrosens