
 NVIDIA DGX Spark · 31 October 2026
Agents autonomes sur DGX Spark : NemoClaw, OpenClaw, clusters multi-nœuds et ce qui tourne vraiment sur le GB10 à l’automne 2026
La DGX Spark n’est plus seulement une machine pour faire tourner un LLM en local. Depuis la rentrée, elle est vendue comme le socle d’agents autonomes qui exécutent des tâches réelles, sans cloud. Harnesses open source, NemoClaw et OpenClaw, clusters multi-nœuds, agent Perplexity : où en est vraiment l’écosystème, et que peut-on faire tourner sur sa machine aujourd’hui ?
Automne 2026 : la DGX Spark change de récit
Il y a un an, la DGX Spark se vendait comme un banc d’essai. Un boîtier silencieux, headless, taillé pour charger un modèle en mémoire unifiée et vérifier ce que donnait une inférence locale sans facture cloud. En cet automne 2026, le discours a changé de nature. La machine n’est plus présentée comme un terrain d’expérimentation pour modèles, mais comme le socle d’agents autonomes qui tournent chez vous, avec des outils, une mémoire, une sandbox d’exécution et zéro token facturé.
Trois forces convergent pour produire ce basculement. D’abord la maturité des harnesses : les cadriciels d’agents open source ont appris à composer avec des modèles locaux, à gérer des appels d’outils et à survivre à des contextes longs. Ensuite la pression sur les coûts : faire tourner un agent qui enchaîne des centaines d’appels d’outils sur une API cloud devient ruineux, et les entreprises comme les particuliers cherchent à rapatrier ces charges. Enfin les exigences de confidentialité : un agent qui lit vos fichiers, exécute du shell et navigue sur le web ne peut pas expédier tout ce qu’il voit à un fournisseur distant sans poser de questions.
Le signal le plus visible de ce changement de récit est arrivé fin août 2026. Perplexity a dévoilé Portable Computer, une plateforme « local-first » conçue avec NVIDIA pour faire tourner toute la stack d’agent en local sur une DGX Spark, sans mandat cloud ni coût de token pour les tâches locales (hothardware, heise). Quelques jours plus tard, début septembre, NVIDIA a accéléré le mouvement avec de nouveaux agents, l’outil PAIR, et l’annonce de Spark PCs attendus en octobre (worthplaying).
Mais l’évolution la plus structurante pour les propriétaires de GB10 est arrivée plus tard, à l’occasion du Computex 2026 : NVIDIA a introduit NemoClaw, un blueprint open source qui empaquette en une seule installation les modèles ouverts, un harness d’agent et le runtime, avec un chemin « du déballage à l’agent qui tourne en quelques minutes » (hors téléchargement initial du modèle, qui dépend du réseau). La même annonce apporte des gains de performance sur Qwen3.6 et une configuration guidée de cluster multi-nœuds pour les équipes qui doivent dépasser une seule machine (developer.nvidia.com). C’est ce triptyque — NemoClaw, Qwen3.6, clustering — qui redéfinit concrètement l’usage de la machine cet automne.
Cet article s’adresse à ceux qui possèdent déjà une GB10 — DGX Spark ou l’un de ses clones — et qui veulent passer du « chat local » à l’« agent local utile ». On y décortique le matériel et ses goulots, le bestiaire des harnesses, ce que valent réellement les briques NVIDIA (NemoClaw en tête), l’architecture concrète d’une pile d’agent, les performances mesurées, des recettes de configuration, les pièges, et ce qui vient ensuite.
GB10 : anatomie d’un cerveau d’agent (et ses deux goulots)
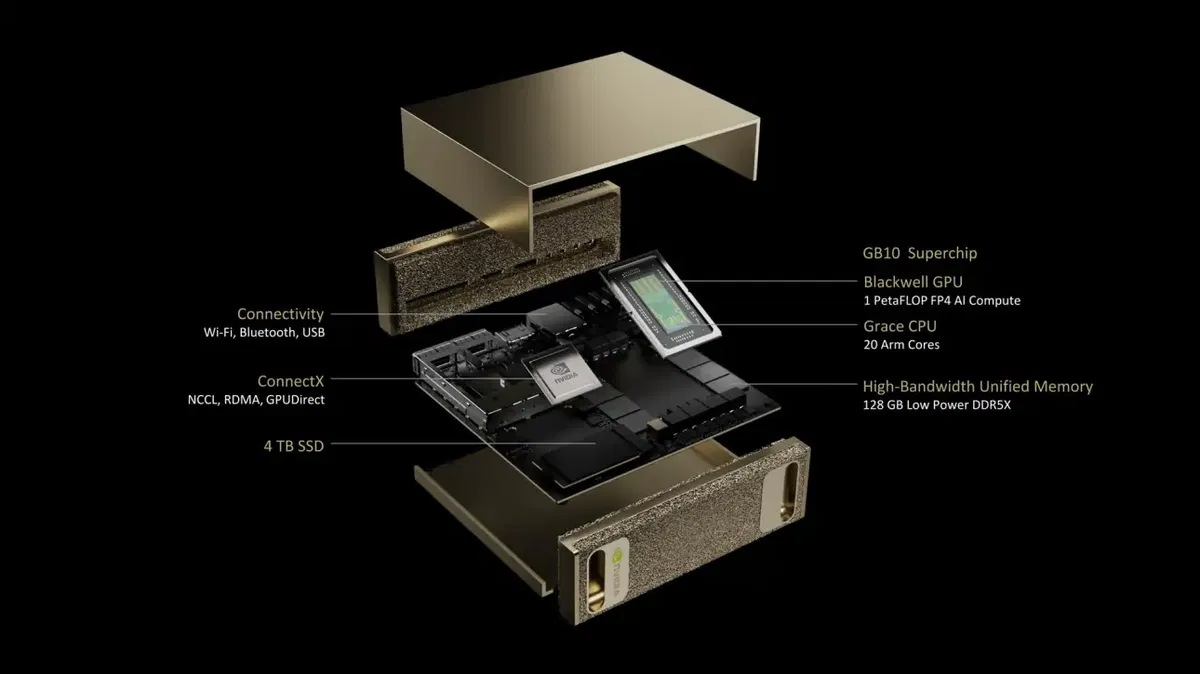
La DGX Spark repose sur le superchip GB10 Grace Blackwell : 20 cœurs ARM Neoverse V2 côté CPU, un GPU Blackwell intégré avec environ 6 144 cœurs CUDA et support du FP4, 128 Go de LPDDR5X unifiés à 273 GB/s, le tout dans une enveloppe thermique d’environ 170 W. La machine tourne sous DGX OS, un Ubuntu Server 24.04 ARM, avec la pile NVIDIA AI Enterprise pré-installée : CUDA 13.0, cuDNN, NCCL, drivers Blackwell et le Docker NVIDIA Container Toolkit.
Deux chiffres structurent tout ce qui suit. Le premier est la capacité unifiée de 128 Go. C’est énorme pour un boîtier de bureau, et c’est précisément ce qui permet de charger des modèles de plusieurs dizaines de milliards de paramètres sans quantification agressive. Le second est la bande passante de 273 GB/s. C’est correct, mais c’est le plafond qui décide de votre débit de génération dès que le modèle grossit.
Tant qu’on se contente de discuter avec un modèle, ces contraintes restent abstraites. Dès qu’on passe à l’agent, elles deviennent quotidiennes. Un agent, c’est un modèle de raisonnement qui produit des appels d’outils, un historique de conversation qui gonfle à chaque tour, un KV cache qui grandit avec le contexte, parfois un second modèle plus léger pour l’outillage, un embedder pour la mémoire vectorielle, et une sandbox qui consomme elle aussi de la RAM. Sur 128 Go, tout cela cohabite — mais la bande passante, elle, ne se partage pas.
Un premier piège attend le nouvel arrivant : la friction ARM Docker. La DGX Spark est headless, accessible en SSH ou via une interface web, et son architecture ARM64 fait échouer une partie des images conteneur publiées uniquement en x86. C’est identifié comme « la friction réelle » de la machine dans les retours d’expérience de 2026, et c’est la première chose à intégrer quand on planifie une pile d’agent.
La gamme s’est dédoublée : 64 Go et 128 Go
Il faut aussi mettre à jour sa vision du produit lui-même. Le 23 octobre 2026, NVIDIA a commercialisé une mouture 64 Go du DGX Spark, à 4 999 $, tandis que le modèle 128 Go a vu son prix grimper au-delà des 6 000 $ sur le marché (frandroid, pausehardware, blogs.nvidia.com). La version 64 Go vise explicitement les modèles ouverts de 30 à 35 milliards de paramètres et les agents locaux, avec 1 PFLOP de calcul (press.asus.com). ASUS a d’ailleurs décliné son Ascent GX10 en version 64 Go le 5 octobre 2026.
Pour un agent, ce choix n’est pas neutre : 64 Go suffisent pour un modèle de raisonnement 30B en NVFP4 plus un petit modèle d’outillage et un embedder, mais laissent peu de marge pour un contexte long et une sandbox gourmande. 128 Go restent la configuration confortable pour un agent qui veut à la fois un gros modèle et de la mémoire de travail. À noter que la version 64 Go conserve une astuce de clustering pour « dépasser » la capacité d’un seul boîtier — nous y revenons plus bas.
Le bestiaire des harnesses open source : qui tourne vraiment sur Spark
Un harness, c’est le logiciel qui transforme un modèle en agent : il gère la boucle de raisonnement, l’invocation des outils, la persistance du contexte et l’interface avec l’utilisateur. À l’automne 2026, le paysage est foisonnant, mais tout ne tourne pas proprement sur GB10.
OpenHands reste la référence pour les tâches de développement logiciel : agent serveur, sandbox d’exécution, interface web, capable d’éditer un dépôt, de lancer des tests et d’itérer. Sur Spark, il bénéficie de la mémoire unifiée pour charger un modèle de code confortable, mais son architecture conteneurisée se heurte à la disponibilité des images ARM.
Aider est l’antithèse : un outil en ligne de commande, léger, qui travaille sur vos fichiers avec un modèle local via une API compatible OpenAI. C’est probablement le harness le plus simple à faire tourner sur GB10, précisément parce qu’il n’a presque pas de dépendances exotiques. Pour qui veut un agent de code minimaliste, c’est le point d’entrée le plus sûr.
SWE-agent et sa lignée restent des cadres de recherche orientés résolution de tickets GitHub. Puissants, mais exigeants en orchestration et en contexte — deux domaines où la Spark demande de la discipline.
Goose fait partie des rares harnesses explicitement documentés comme fonctionnels sur la plateforme, avec une architecture extensible par protocole et un support multi-fournisseurs. Letta (ex-MemGPT) apporte une couche de mémoire persistante gérée par le modèle lui-même, ce qui résonne directement avec la contrainte de contexte long de la Spark. smolagents mise sur la simplicité : des agents en quelques lignes de Python, idéal pour prototyper sans infrastructure lourde. LangGraph et AutoGen sont des cadriciels d’orchestration : ils ne sont pas des agents clés en main mais des briques pour construire des graphes d’agents, avec des dépendances Python qui se portent généralement bien en ARM. CrewAI joue la carte des équipes d’agents spécialisés. Continue et Cline vivent dans l’IDE et visent l’assistance au code plutôt que l’autonomie complète.
| Harness | Mode | Force sur GB10 | Point de friction |
|---|---|---|---|
| Aider | CLI | Léger, dépendances minimales | Peu d’autonomie longue |
| OpenHands | Serveur + web | Sandbox, tâches de dev complètes | Images Docker ARM |
| Goose | CLI/serveur | Extensible, documenté sur la plateforme | Écosystème jeune |
| Letta | Serveur | Mémoire persistante native | Consommation mémoire |
| smolagents | Bibliothèque | Prototypage rapide | Pas de production clé en main |
| LangGraph / AutoGen | Cadriciel | Orchestration multi-agents | À construire soi-même |
| CrewAI | Cadriciel | Rôles spécialisés | Dépendances Python |
| Continue / Cline | IDE | Assistance code intégrée | Autonomie limitée |
OpenClaw et AGENTS.md : le standard qui monte
Depuis Computex 2026, un nouvel entrant bouscule ce tableau : OpenClaw, le harness que NVIDIA met en avant dans son parcours NemoClaw. C’est avec OpenClaw que le blog développeur NVIDIA montre comment « construire et lancer son premier agent » sur DGX Spark (developer.nvidia.com). Le fait qu’un harness soit explicitement choisi comme cible du chemin d’installation officiel change la donne : c’est aujourd’hui le point d’entrée le plus documenté pour un agent sur GB10.
Autour d’OpenClaw s’est cristallisé un standard de fait : AGENTS.md, un format ouvert et simple pour guider les agents de code, adopté par plus de 60 000 projets open source selon le site officiel (agents.md). L’idée est limpide : là où un README s’adresse aux humains, AGENTS.md est un « README pour agents » — un endroit prévisible où l’on consigne les commandes de build, les tests, les conventions de style. Un seul fichier fonctionne à travers de nombreux agents et outils. Pour un agent local sur Spark, c’est un levier concret : vous donnez à votre agent le contexte de votre dépôt sans le noyer dans des instructions éparpillées, et vous réduisez les allers-retours coûteux en contexte.
Il faut rester honnête sur une zone d’ombre : à ce jour, aucune matrice publique et vérifiable ne documente, version par version, quels harnesses sont validés sur GB10, avec les commits exacts et les dépendances bloquantes. Les retours existent, épars, sur les forums et les issues GitHub, mais ils restent fragmentaires. Un harness qui « marche » chez un utilisateur peut échouer chez un autre selon la version de CUDA, de Python ou du runtime Docker. C’est un chantier de documentation encore ouvert — et une raison supplémentaire de tester avant de s’engager.
NemoClaw, PAIR et Agent Toolkit : ce que NVIDIA apporte vraiment
Depuis début septembre 2026, NVIDIA pousse deux briques destinées à simplifier l’IA locale sur ses machines : un ensemble d’agents et d’outils (souvent regroupés sous l’appellation Agent Toolkit) et l’outil PAIR, annoncés en même temps que la confirmation des Spark PCs pour octobre (worthplaying). L’intention est claire : réduire la friction entre le matériel et les charges agentiques, en s’appuyant sur les microservices NIM et l’orchestration côté NVIDIA.

Mais la brique la plus utile pour un propriétaire de Spark est NemoClaw, présentée par NVIDIA comme un blueprint open source qui empaquette trois choses en une seule installation : les modèles ouverts, un harness d’agent (OpenClaw), et le runtime d’exécution. L’objectif affiché est de faire passer l’installation d’un agent local de « la meilleure partie d’une journée » à quelques minutes, hors téléchargement du modèle. NemoClaw orchestre l’exécution de l’agent et permet de garder le contexte sensible sur l’appareil, de contrôler ce à quoi l’agent a accès, et d’éliminer les coûts par token (developer.nvidia.com).
Deux détails pratiques comptent. D’abord, la version de juin 2026 du logiciel système DGX Spark a rationalisé l’expérience de premier démarrage (OOBE) : les mises à jour over-the-air ne sont plus installées par défaut lors de la configuration initiale, ce qui raccourcit le setup et amène plus vite au bureau Ubuntu. Ensuite, NemoClaw suppose une connexion internet active pour le téléchargement initial du modèle et une familiarité minimale avec le terminal pour les étapes de configuration optionnelles.
Ce qui est réellement utilisable sur GB10 dépend de deux critères : la disponibilité en ARM64 et l’absence de dépendance cloud obligatoire. Les briques d’orchestration et les intégrations d’outils qui s’exécutent localement apportent une vraie valeur — elles évitent de réinventer la gestion des appels d’outils et l’exposition de services. En revanche, tout composant qui suppose un backend distant ou une image x86 uniquement reste hors de portée sans travail d’adaptation.
Le cas le plus parlant de cet automne reste Portable Computer de Perplexity, construit avec NVIDIA pour transformer la DGX Spark en agent local prêt à l’emploi (hothardware, frandroid). Le modèle associé, PPLX 27B, a été annoncé le 25 août 2026, post-entraîné depuis Qwen 3.8 27B d’Alibaba, et livré avec la plateforme. Perplexity met en avant un benchmark maison, le Local Knowledge Work Bench (53 tâches) : 85,4 % pour le harnais PPLX 27B, contre 82,6 % pour le même harnais sur Qwen 3.8 27B, et 77,6 % pour le harnais open source Pi.
Ces chiffres méritent d’être lus avec prudence. Ils proviennent d’une source unique, probablement reprise d’un communiqué Perplexity, et ne sont pas recoupés indépendamment. L’écart de 2,8 points entre PPLX 27B et Qwen 3.8 27B est réel mais modeste : il suggère un gain d’ergonomie et d’intégration plus qu’un saut de capacité brute. La vraie promesse de Portable Computer n’est d’ailleurs pas dans le score, mais dans l’expérience : un agent local qui fonctionne dès la sortie de la boîte, sans avoir à assembler soi-même un harness, un modèle et une sandbox. C’est exactement le type d’offre qui manquait pour convaincre les utilisateurs non experts — et c’est aussi ce que NemoClaw cherche à fournir côté NVIDIA, en open source.
Architecture concrète d’un agent local sur Spark
Voici à quoi ressemble une pile d’agent réaliste sur GB10, brique par brique.
Le modèle de raisonnement. C’est le cerveau qui planifie et décide des appels d’outils. Sur 128 Go, la famille Qwen3 offre une échelle intéressante : Ollama référence qwen3:4b (2,5 Go, contexte 256K), qwen3:30b (19 Go, 256K) et qwen3:235b (142 Go, 256K). Le 235B ne rentre pas tel quel sur la machine, mais les variantes MoE à activation partielle — comme Qwen3-30B-A3B — offrent un compromis intéressant entre capacité et vitesse. Côté modèles distants ou distillés, DeepSeek-R1, Nemotron et DeepSeek-V4-Flash figurent dans les discussions. La mise à jour Computex 2026 apporte par ailleurs des gains de performance sur Qwen3.6, ce qui en fait un candidat naturel pour un agent sur Spark (developer.nvidia.com).
Le modèle d’outillage. Beaucoup de piles séparent le raisonnement de l’exécution : un petit modèle rapide (4B à 8B) gère les appels d’outils simples et le formatage, pendant que le gros modèle planifie. Cela réduit la latence perçue et économise la bande passante mémoire.
Le contexte long. Les fenêtres annoncées montent à 256K pour Qwen3, mais la réalité de la Spark impose de la mesure. Le KV cache grandit linéairement avec le contexte et consomme de la bande passante à chaque token généré. La quantification (FP8, FP4, INT4) réduit l’empreinte des poids mais pas celle du KV cache, qui dépend surtout de la longueur et du nombre de couches. Sur deux Sparks en tensor parallel, on a mesuré un pool de cache KV partagé de 1 105 096 tokens — un ordre de grandeur qui montre ce que le clustering apporte à un agent qui veut de la mémoire de contexte.
La sandbox d’exécution. Pour qu’un agent exécute du shell ou du code sans ravager votre système, il faut une isolation. C’est là que la friction ARM Docker se paie : privilégiez les images officiellement multi-arch, ou construisez vos propres images ARM64. OpenHands et les harnesses conteneurisés sont les plus exposés ; Aider et les outils CLI le sont moins.
Le harness et le fichier de contexte. C’est la couche qui relie le tout. Avec NemoClaw, vous partez d’OpenClaw et d’une installation packagée ; avec une approche manuelle, vous assemblez un harness (Aider, Goose, OpenHands) et un backend d’inférence (Ollama, vLLM, llama.cpp). Dans les deux cas, un fichier AGENTS.md bien rédigé à la racine de votre projet est un investissement rentable : il donne à l’agent les commandes de setup, les tests et les conventions, et réduit les tours de boucle inutiles (agents.md).
Performances mesurées : ce que dit l’automne 2026
Les chiffres commencent à sortir du brouillard, et ils dessinent une machine honnête plutôt que miraculeuse.
En solo. Sur une seule DGX Spark, un DeepSeek-V4-Flash quantifié en IQ2_XXS via ds4.c tourne autour de 14 tok/s en single-stream, avec un prefill d’environ 410 tok/s (mesures d’août 2026). Une suite llama.cpp sur des GGUF atteint jusqu’à 67 tok/s sur un modèle 35B-A3B — le régime où la Spark est la plus à l’aise, grâce à l’activation partielle des MoE.
En cluster. Avec deux Sparks en tensor parallel (TP=2) sous vLLM et DeepSeek-V4-Flash en FP8, on obtient environ 41 tok/s en single-stream, un prefill d’environ 1 785 tok/s, et un débit agrégé d’environ 350 tok/s à concurrence 32. Deux machines supportent jusqu’à 405 milliards de paramètres. C’est le point d’équilibre du clustering : le débit par utilisateur progresse modérément, mais la capacité de modèle et le débit agrégé changent d’échelle.
Le regard indépendant. Le 29 septembre 2026, Artificial Analysis a publié AA-AgentPerf-Local, un outil open source pour mesurer la vitesse réelle des agents sur laptops et workstations, avec des résultats de lancement pour la DGX Spark, le Ryzen AI Halo, le MacBook Pro (M5 Pro) et la RTX 5090, sur quatre modèles open weight (artificialanalysis.ai). C’est une avancée méthodologique importante : pour la première fois, on dispose d’un cadre reproductible pour comparer les machines sur des charges agentiques et pas seulement sur du chat. Les résultats détaillés méritent d’être consultés directement, mais l’existence même de ce benchmark comble en partie le trou de documentation signalé plus haut.
La concurrence. Il faut garder un œil sur l’AMD Ryzen AI Halo 192 Go, lancé à 7 299,99 $ chez Micro Center, qui peut charger des modèles ouverts de 300 milliards de paramètres ; les benchmarks indépendants montrent toutefois que la DGX Spark garde l’avantage en vitesse (techtimes.com). Autrement dit, la Spark n’est plus seule, mais elle reste la plus rapide sur les charges qu’elle sait faire.
Clusters DGX Spark : ce qui marche vraiment
Le clustering est devenu un argument central de NVIDIA cet automne, avec une configuration guidée multi-nœuds introduite à Computex 2026 pour les équipes qui doivent dépasser une seule machine (developer.nvidia.com). C’est un changement notable : le clustering, longtemps affaire de bricoleurs, devient un parcours documenté.
Les ordres de grandeur à retenir, issus des mesures de 2026 :
- 1 Spark : zone de confort des 7B–32B, falaise au-delà de 70B.
- 2 Sparks : le point d’équilibre. Jusqu’à 405 milliards de paramètres, un pool de KV cache partagé de plus d’un million de tokens, et un débit agrégé qui décolle à concurrence élevée. Curiosité relevée dans les tests : « 2 plus rapide que 3 » sur certaines charges, le troisième nœud n’apportant pas toujours le gain attendu selon le partitionnement.
- 4 Sparks : le royaume des MoE et des modèles jusqu’à ~400B.
- 8 Sparks : le cluster qui existe surtout sur le papier pour l’instant, faute de charges et de retours assez nombreux.
La version 64 Go conserve, elle aussi, une astuce de clustering pour dépasser la capacité d’un seul boîtier — un moyen de faire croître la mémoire agrégée sans acheter d’emblée la configuration 128 Go. Pour un agent, l’intérêt du cluster n’est pas seulement la taille du modèle : c’est la possibilité de servir plusieurs sous-agents en parallèle et de tenir un contexte long sans OOM.
Fine-tuning local : ce qui est réaliste, ce qui ne l’est pas
La mémoire unifiée de 128 Go fait de la Spark une machine de fine-tuning LoRA crédible sur des modèles de taille moyenne. Ce qui est réaliste : un LoRA sur un modèle 7B–14B en quantification, avec des batchs modestes, en acceptant des temps d’entraînement longs. Ce qui ne l’est pas : un fine-tuning complet d’un modèle de plusieurs dizaines de milliards de paramètres, ou un entraînement à grande échelle — la bande passante de 273 GB/s et l’enveloppe thermique de 170 W imposent leur loi. Le clustering ouvre la voie à des configurations plus ambitieuses, mais reste, à l’automne 2026, un terrain d’expérimentation plutôt qu’une recette de production.
Les pièges à éviter
- La friction ARM Docker. Vérifiez la disponibilité ARM64 de chaque image avant de bâtir votre pile. C’est la première cause d’échec.
- Le mythe des 128 Go « pleins ». 128 Go annoncés, 128 Go moins le système, le KV cache, la sandbox et l’embedder. Prévoyez de la marge.
- Le contexte long qui mange la bande passante. Une fenêtre de 256K n’est pas gratuite : mesurez avant de l’activer en production.
- Les benchmarks maison non recoupés. Les scores Perplexity (Local Knowledge Work Bench) sont utiles mais proviennent d’une source unique. Croisez avec AA-AgentPerf-Local.
- Le cluster mal dimensionné. Trois nœuds ne valent pas toujours mieux que deux. Testez votre partitionnement.
- L’oubli d’AGENTS.md. Un agent sans contexte de projet multiplie les tours de boucle inutiles — et donc la latence et la consommation mémoire.
Ce qui vient ensuite
L’automne 2026 laisse la DGX Spark dans une position paradoxale : plus chère en 128 Go, déclinée en 64 Go plus accessible, mais surtout mieux outillée qu’il y a un an. NemoClaw, OpenClaw, AGENTS.md, la configuration guidée de clusters et les gains sur Qwen3.6 transforment une machine d’expérimentation en plateforme d’agents. La concurrence s’organise (AMD Ryzen AI Halo, DGX Station for Windows avec ses 748 Go de mémoire cohérente et 20 PFLOPs FP4 attendus au quatrième trimestre 2026 via six partenaires OEM), et les benchmarks indépendants commencent à peine à produire des chiffres comparables.
Pour le propriétaire d’une GB10, la conclusion est simple : le « chat local » est un acquis, l’« agent local utile » est désormais à portée de main — à condition d’accepter les goulots de la bande passante, la friction ARM et l’absence de matrice de compatibilité exhaustive. Le reste est une affaire de configuration, de mesure et de discipline.
Sources
- NVIDIA Developer Blog — Run Local AI Agents with Faster Models and Multi-Node Clustering on NVIDIA DGX Spark
- NVIDIA Blog — DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI
- AGENTS.md — format ouvert pour guider les agents de code
- HotHardware — NVIDIA / Perplexity Portable Computer
- Worthplaying — NVIDIA Accelerates Local AI with New Agents and NVIDIA PAIR Tool, Reveals Spark PCs Coming in October
- Frandroid — Nvidia lance le DGX Spark en 64 Go
- Pause Hardware — Le DGX Spark perd la moitié de sa mémoire mais conserve son tarif de 4 999 dollars
- ASUS Press — Ascent GX10 64GB: Compact Agentic AI Supercomputer
- Artificial Analysis — AA-AgentPerf-Local
- TechTimes — AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed
- NVIDIA — DGX Spark (page produit)
Article recherché et rédigé automatiquement · Magazine Electrosens