
 IA Traitement du son · 30 October 2026
Model fatigue : pourquoi l’IA audio sature en 2026 — et comment le studio s’en sort
En trois jours de septembre 2026, quatre laboratoires ont livré cinq modèles de pointe. Le même mois, NVIDIA a posé près de treize milliards de dollars sur la table pour racheter Hugging Face. Et le 6 septembre, CNBC a donné un nom au malaise qui couvait depuis des semaines : la « model fatigue ». Dans l’audio, cette fatigue n’est pas une humeur de geeks blasés — c’est un problème de chaîne de production. Six semaines plus tard, les sorties n’ont pas ralenti : VARCO Sound chez NC AI, Samplitude 2026.5 chez Boris FX, Nova chez Lunacy Audio. La question n’est plus « quel modèle est le meilleur ? » mais « comment construire une chaîne qui survive au prochain modèle ? »
Septembre 2026 : le mois où l’IA audio a saturé
Il faut se figurer la séquence. Le 1er septembre 2026, Anthropic publie Claude Fable 5.1 et Claude Mythos 5.1, présentés comme les « modèles les plus avancés au monde pour le code et le travail de connaissance ». Le 2 septembre, Meta livre Muse Spark 1.3 et Google dévoile Gemini 3.8 Flash, tous deux vantant des gains en programmation et en tâches agentiques. Le 3 septembre, OpenAI réplique avec GPT-6 Astra, centré sur la cybersécurité et les compétences informatiques. Le même jour, la Mohamed bin Zayed University of Artificial Intelligence d’Abou Dabi ouvre sa famille K2 Horizon, présentée comme les plus grands modèles entièrement ouverts de l’histoire, et NVIDIA officialise le rachat de Hugging Face pour 12,9 milliards de dollars. Le dimanche 6 septembre, CNBC publie un article qui met un mot sur ce que tout le monde ressent : model fatigue, la fatigue des modèles.
Le paradoxe est net, et il mérite d’être posé d’emblée : jamais autant de modèles n’ont été livrés, et jamais aussi peu n’ont été réellement évalués. Un PDG du secteur confie à CNBC que lorsque son équipe veut comparer dix modèles pour une tâche donnée, elle en teste environ cinq. Zhen Lu, directeur général de Runpod, résume : « Model fatigue est une chose bien réelle. Ne vous méprenez pas, je suis extrêmement enthousiaste face à toute cette innovation, mais nous sommes dans un environnement où il y a tellement d’écume qu’il faut faire du bruit. » Le bruit, en l’occurrence, n’est plus un sous-produit de l’innovation : il est devenu un objectif de lancement.
Pourquoi ce dossier atterrit-il dans un magazine sur le traitement du son ? Parce que l’écosystème audio est le premier touché, et de la manière la plus concrète qui soit. Un ingénieur du son ne consomme pas un modèle comme un lecteur de news consomme un chatbot : il l’insère dans une chaîne de production, entre un enregistrement de prise et une livraison de session. Quand le modèle sous-jacent change, la chaîne bouge. Quand les modèles changent toutes les six semaines, la chaîne devient instable. C’est là que la fatigue cesse d’être un sentiment et devient une ligne de coût.
Ajoutons un ingrédient réglementaire : depuis le 2 août 2026, l’AI Act européen s’applique aux nouveaux modèles, et il faudra attendre le 2 décembre 2026 pour que les modèles existants y soient soumis. Autrement dit, l’écosystème audio navigue en ce moment même dans une zone de flou juridique doublée d’une zone de flou technique. De quoi donner envie de ne rien adopter du tout — et pourtant, l’automne 2026 a continué de livrer.
Anatomie d’une fatigue : ce que « model fatigue » veut dire exactement
Prudence méthodologique d’abord. La quasi-totalité des faits entourant cette séquence provient de sources secondaires — un billet de blog, telli.sh, et un article d’ettayeb.fr — qui citent CNBC. Les noms de modèles (Claude Fable 5.1, Claude Mythos 5.1, Muse Spark 1.3, Gemini 3.8 Flash, GPT-6 Astra, K2 Horizon) sont cohérents entre ces deux sources, ce qui renforce leur plausibilité, mais ils ne sont corroborés par aucune source primaire officielle dans notre corpus. Le montant du rachat de Hugging Face par NVIDIA (12,9 milliards de dollars) est, lui, repris à l’identique par les deux sources. Nous les rapportons donc pour ce qu’ils sont : des faits rapportés, à confiance raisonnable, et non des certitudes absolues.
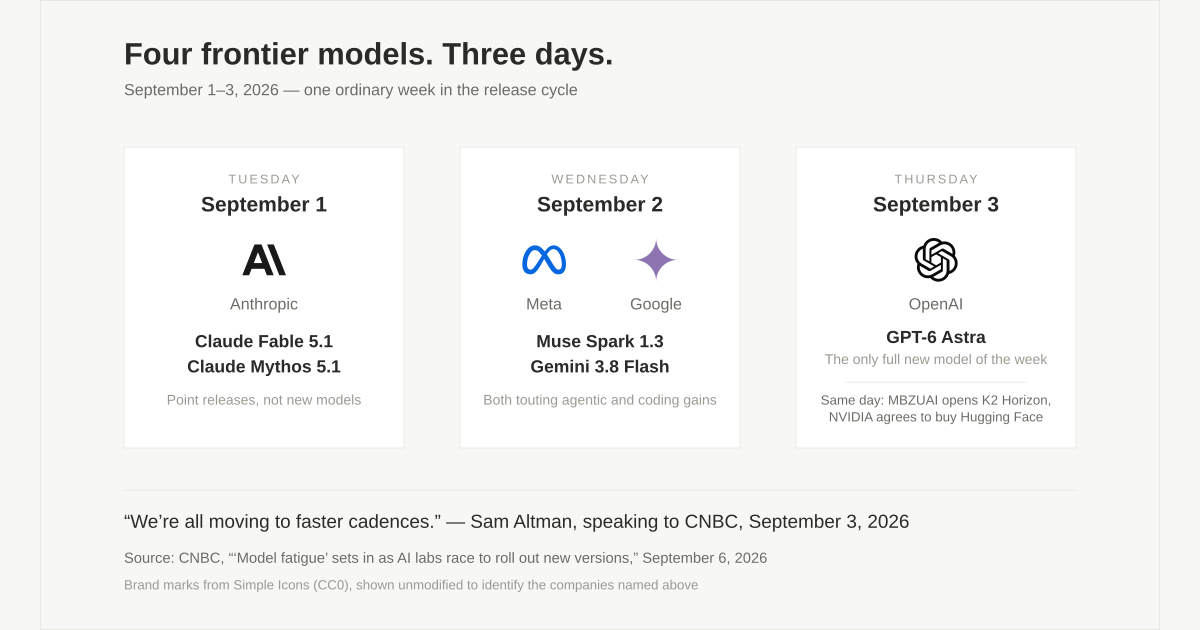
Ce que l’on peut affirmer avec plus d’assurance, c’est la formule elle-même. CNBC, le 6 septembre 2026, nomme « model fatigue » l’épuisement lié aux sorties de modèles. Le concept recouvre au moins quatre phénomènes distincts, qu’il faut séparer si l’on veut comprendre :
La saturation des annonces. Trop d’événements pour un nombre constant d’heures de veille. Quatre labs en 72 heures, c’est un rythme qu’aucune rédaction spécialisée, aucun studio, aucun indépendant ne peut absorber sans arbitrer.
Le raccourcissement des cycles de release. Là où un modèle vivait un an, il vit désormais quelques mois. La conséquence n’est pas seulement psychologique : elle est économique, car elle raccourcit l’amortissement de tout ce qui est bâti dessus.
L’effondrement du temps d’évaluation par modèle. C’est le point le plus grave, et le seul chiffré dont nous disposons : cinq modèles testés sur dix. Le reste est évalué par défaut, par réputation, ou pas du tout.
La hausse du coût d’adoption. Chaque nouveau modèle promet un gain, mais facture une migration : réapprentissage, revalidation, parfois reprise de projets.
Un cinquième facteur, plus subtil, est apparu dans les analyses de l’automne : le coût de comparaison lui-même. Comme le note ettayeb.fr, « le coût réel d’un modèle dépend désormais du cache et du contexte autant que des benchmarks : arrêtez de comparer des scores, comparez le prix de votre charge de travail ». C’est un déplacement fondamental. La question n’est plus « quel modèle a le meilleur score ? » mais « quel modèle coûte le moins cher pour ma charge de travail réelle ? ». Or cette seconde question exige une mesure que presque personne ne fait.
Reste une zone d’ombre honnête : nous n’avons aucune donnée sur Z.ai et son modèle mystérieux Ox Alpha, aucune sur le modèle SSI d’Ilya Sutskever, aucune sur la croissance réelle du catalogue Hugging Face. Le concept de « model fatigue » est donc, à ce stade, mieux documenté dans sa formulation que dans sa mesure.
D’où la question qui structure tout ce dossier : la fatigue est-elle une fatigue d’offre — trop de choses à examiner — ou une fatigue de sens — trop de choses qui ne changent rien ? La réponse n’est pas la même selon les segments audio, et c’est précisément ce qu’il faut aller regarder de près.
Stem splitters, TTS, mastering : la carte des segments audio sous pression
Cartographions. Cinq segments de l’audio encaissent la rafale, chacun à sa manière — et le tableau s’est enrichi de faits nouveaux depuis septembre.
| Segment | Acteurs cités | Ce qu’on sait | Ce qu’on ignore |
|---|---|---|---|
| Stem splitters | LALAL.AI, Voice.ai, Demucs, Spleeter, MVSEP, Boris FX Samplitude | LALAL.AI revendique un « moteur de sixième génération » et « six ans d’innovations » ; Voice.ai propose un splitter gratuit (WAV inclus) ; Samplitude 2026.5 (Boris FX, 8 octobre 2026) intègre une séparation de stems par IA | Nombre de modèles sortis en 12-18 mois, cadence de mise à jour, adoption |
| Génération musicale | Suno, Udio, Stable Audio, MusicGen, Adobe Firefly Audio, Roland Melody Flip, NC AI VARCO Sound | Suno et Udio ont des pages pricing actives ; Firefly Audio est en GA depuis le 20 août 2026 à 10 USD/mois ; Roland a lancé Melody Flip le 8 septembre 2026 ; NC AI a publié VARCO Sound le 20 octobre 2026 | Volumes, rétention, abandons |
| Restauration de voix | Adobe Podcast, Cleanvoice, Krisp, Resemble Enhance | Adobe Firefly Audio intègre l’option du modèle ElevenLabs pour Generate Speech | Métriques de qualité indépendantes |
| Mastering IA | LANDR, eMastered, iZotope Ozone, CloudBounce | Segments actifs, offres commerciales en ligne | Cadence de release, taux d’adoption |
| Plugins « Nova-like » | Sonible, Accentize, Baby Audio, Lunacy Audio | sonible a publié smart:chain le 26 août 2026 ; Lunacy Audio a lancé Nova le 22 septembre 2026 | Obsolescence réelle des plugins après changement de modèle |
Ce tableau dit l’essentiel : pour chaque segment, on sait que les acteurs existent et qu’ils communiquent. On ne sait presque rien de leur rythme réel de publication, de leur adoption, ni de leurs abandons. C’est le premier symptôme de la fatigue — non pas que les modèles soient mauvais, mais que personne ne mesure plus ce qui se passe.
Le cas de la génération musicale est instructif. Une étude relayée le 20 août 2026 indique que près de 40 % de la musique sortie en juillet 2026 a utilisé l’IA. Ce chiffre, s’il est solide, déplace le débat : on ne parle plus d’outils de niche mais d’une part significative de la production mondiale. Or, dans le même temps, Adobe ouvre Firefly Audio en disponibilité générale le 20 août 2026 — génération de musique, de voix et d’effets sonores, avec licence commerciale universelle incluse, à 10 dollars par mois, et une option pour utiliser le modèle ElevenLabs dans Generate Speech. La promesse d’Adobe n’est d’ailleurs pas la qualité audio : c’est la sécurité commerciale. Traduction : le marché a déjà intégré que la qualité ne discrimine plus, et vend autre chose — la conformité, la licence, l’intégration.
L’automne a confirmé cette tendance sur deux fronts opposés. D’un côté, Roland Melody Flip (8 septembre 2026) entre dans la musique générative avec un positionnement explicitement prudent : un outil qui assiste la composition plutôt que de produire des chansons en un clic, avec 250 palettes de genres pour générer des mélodies dans le DAW. C’est une réponse directe à la fatigue : ne pas promettre le remplacement, promettre l’assistance. De l’autre, NC AI VARCO Sound (20 octobre 2026) pousse la logique inverse — un générateur de sonorités multipiste par IA, capable de créer et d’arranger plusieurs sons pour une même scène. C’est un outil d’entreprise, pas de home-studio, et il confirme que la bataille s’est déplacée vers les services de production intégrés.
C’est exactement le basculement que décrit la fatigue des modèles. Quand la qualité cesse de trancher, on achète autre chose : la licence chez Adobe, l’assistance chez Roland, l’intégration chez NC AI.
Le cas LALAL.AI : six générations en six ans, et après ?
Prenons un acteur emblématique. LALAL.AI se présente comme le « suppresseur de voix n°1 » et revendique un « moteur de sixième génération » avec « six ans d’innovations » — ce qui place la fondation du moteur vers 2019-2020. La société a par ailleurs étendu ses stems, avec l’ajout de guitares et de piano dans Andromeda. Aucune date précise n’est fournie pour cette extension.

Décortiquons la rhétorique. Que signifie une « sixième génération » ? En pratique, cela signifie qu’il y a eu cinq incréments avant celui-ci, sur environ six ans — soit une cadence d’environ un par an. Ce n’est pas un rythme effréné : c’est un rythme raisonnable, presque lent comparé aux labs de modèles génératifs. Le mot « génération » porte donc une charge marketing plus qu’une information technique. Il dit : « nous avons progressé ». Il ne dit pas : « de combien ».
C’est là que le bât blesse. Aucune métrique indépendante — SI-SDR, SDR, PESQ — n’est publiée pour étayer la revendication. Le titre de « n°1 » n’est recoupé par aucune source tierce dans notre corpus. On ne saurait en conclure que le produit est mauvais : les stem splitters modernes sont souvent excellents à l’oreille. Mais on ne peut pas non plus conclure qu’il est meilleur que le précédent. La revendication est infalsifiable, et c’est précisément ce qui alimente la fatigue.
Comparez avec la promesse inverse de Voice.ai : un stem splitter gratuit, en ligne, fonctionnant sur WAV et autres formats, ciblant explicitement producteurs, DJs et podcasteurs. Aucun chiffre d’usage, de précision ou de cadence de mise à jour n’est fourni non plus. Mais le positionnement est différent : Voice.ai ne vend pas une génération, elle vend un accès. Dans un marché saturé, l’accès gratuit est une stratégie de captation ; la « sixième génération » est une stratégie de différenciation. Les deux répondent au même problème : comment exister quand tout le monde fait à peu près la même chose ?
Un troisième cas, plus récent, éclaire la dynamique : Boris FX Samplitude 2026.5 (8 octobre 2026) ajoute un panner spatial et une séparation de stems par IA à un DAW historique. Ici, la séparation de stems n’est plus un produit, c’est une fonctionnalité glissée dans un séquenceur. C’est un indicateur puissant de maturation : quand une technologie devient une case à cocher dans un DAW, c’est qu’elle a cessé d’être un différenciateur. Et c’est précisément à ce moment que la « sixième génération » d’un spécialiste perd de sa valeur argumentative.
Pour un ingénieur du son qui doit livrer une session, la question reste entière : le gain d’une génération est-il audible, mesurable, ou seulement marketing ? Sans évaluation indépendante, la réponse honnête est : on ne sait pas. Et c’est un problème de production, pas de curiosité intellectuelle.
Benchmarks noyés : pourquoi SI-SDR, PESQ et MOS ne tranchent plus
Voici le cœur technique du problème. Les métriques disponibles pour juger un modèle audio sont bien connues : SI-SDR et SDR mesurent la qualité de séparation de sources ; PESQ évalue la qualité vocale perçue ; MOS note la qualité subjective ; FAD compare la fidélité de distributions audio générées ; CLAP évalue l’alignement texte-audio. Toutes ont leurs limites, et toutes partagent un défaut structurel : elles saturent.
Le phénomène est simple à énoncer. Quand dix modèles dépassent 95 % de SDR sur un jeu de données donné, le classement ne discrimine plus rien. Les dix premières places deviennent interchangeables, et le chiffre perd son pouvoir de décision. C’est ce qu’on appelle un benchmark « noyé » : un test qui a été conçu pour un état de l’art dépassé, et que l’état de l’art a rattrapé puis dépassé.
Trois causes se conjuguent :
Les datasets d’évaluation recyclés. Les mêmes corpus servent depuis des années, et les modèles récents y ont été exposés d’une manière ou d’une autre. Un score élevé peut signaler une bonne performance ou une bonne familiarité avec le test.
Les résultats contradictoires entre labs. Chaque laboratoire publie ses chiffres, sur ses datasets, avec sa méthodologie. Rien n’oblige à la comparabilité. Deux modèles « à 96 % de SDR » peuvent avoir été mesurés dans des conditions qui n’ont rien à voir.
L’absence d’évaluations indépendantes sur les modèles audio récents. C’est le point le plus critique. Pour les LLM, il existe des plateformes de classement consolidées — on trouve des référentiels recensant plusieurs centaines d’évaluations de LLM en septembre 2026, et un classement des vingt modèles les plus performants a même été publié le 21 septembre 2026. Pour l’audio, l’équivalent n’existe pas à notre connaissance dans le corpus disponible. Les modèles de séparation, de restauration et de mastering sont évalués par ceux qui les vendent.
Le lien avec la fatigue est direct. Si les chiffres ne permettent plus de choisir, l’utilisateur choisit par défaut, par habitude, ou abandonne. Et l’habitude, dans un marché qui change toutes les six semaines, est une forme lente de décrochage.
À cela s’ajoute la dette technique, rarement évoquée mais bien réelle. Un plugin qui embarque un modèle local (Ozone, smart:chain, les outils Nova) devient obsolète non pas quand il cesse de fonctionner, mais quand le modèle qu’il embarque cesse d’être compétitif — et il n’existe aucun mécanisme standard pour le mettre à jour. Un service cloud, à l’inverse, se met à jour tout seul : c’est précisément pourquoi les abonnements cloud de mixage et de mastering IA se situent dans une fourchette de 10 à 30 euros par mois en 2026. On ne paie pas seulement pour le calcul : on paie pour ne pas avoir à gérer l’obsolescence. C’est un arbitrage économique que la fatigue rend visible.
NPU, latence, cache : le vrai prix d’un modèle audio en 2026
La fatigue des modèles a un corollaire matériel que les annonces passent sous silence. Un modèle audio ne vit pas dans le vide : il tourne sur quelque chose. Et ce quelque chose a changé de nature en 2026.

Le NPU est devenu le champ de bataille silencieux. Les puces d’inférence locale — NPU intégrés aux laptops, accélérateurs dédiés — permettent désormais de faire tourner en local des modèles de séparation, de restauration et même de génération courte. L’intérêt n’est pas la performance brute : c’est la stabilité. Un modèle local ne change pas parce qu’un laboratoire a décidé de sortir une version 1.3. Il change quand vous décidez de le changer. Dans un contexte de model fatigue, c’est un argument massif, et il explique pourquoi les roundups 2026 placent la latence et le NPU au cœur de la case « autonome ».
Mais le NPU a un coût caché : la consommation énergétique. La question est devenue si sérieuse que Google a lancé le projet Suncatcher — un satellite prototype envoyé début octobre 2026 pour tester si ses puces TPU peuvent fonctionner correctement dans l’espace, avec l’objectif affiché d’éviter une crise énergétique causée par l’IA. Quand un géant envoie des puces en orbite pour échapper à la contrainte électrique terrestre, on comprend que le « coût d’un modèle » n’est plus une abstraction.
Le cache et le contexte sont devenus les vrais leviers de prix. Comme le souligne l’analyse d’ettayeb.fr, le coût réel d’un modèle dépend désormais du cache et de la longueur de contexte autant que des benchmarks. Pour l’audio, cela se traduit concrètement : une session de travail longue, avec un contexte audio étendu, coûte plus cher qu’une série de requêtes courtes. OpenAI a d’ailleurs porté la fenêtre de contexte de son modèle vocal temps réel à 128 000 jetons, contre 32 000 auparavant — une évolution qui transforme la session de travail mais facture la mémoire au prix fort.
La latence reste le joker. Un modèle de mastering qui produit un résultat excellent en trente secondes est inutilisable dans un flux de travail interactif. Un modèle de séparation de stems qui met deux minutes là où le précédent en mettait dix secondes est une régression, quel que soit son score SDR. Or la latence n’est presque jamais publiée dans les benchmarks audio. C’est un angle mort total, et il est d’autant plus grave que les architectures temps réel se généralisent : le passage de pipelines en deux temps à des flux continus, initié par les modèles vocaux temps réel du printemps 2026, redéfinit ce qu’un ingénieur est en droit d’attendre d’un outil audio.
Le matériel devient un critère de sélection. Un studio qui a investi dans des machines sans NPU performant ne peut pas exploiter les modèles locaux récents. Un studio qui a investi dans le cloud dépend d’un fournisseur dont les prix peuvent changer. La fatigue des modèles est donc aussi une fatigue matérielle : chaque nouvelle génération de modèle redessine la frontière entre ce qui tourne en local et ce qui doit passer par le cloud.
Ce que l’automne 2026 a vraiment changé : trois signaux faibles
Au-delà de la séquence de septembre, trois développements de l’automne méritent d’être lus comme des réponses à la fatigue — pas comme des modèles de plus.
Signal un : la plateforme contre le produit. Lunacy Audio a lancé Nova le 22 septembre 2026 — une plateforme navigateur gratuite, avec des paliers premium, où les producteurs assemblent leurs propres instruments et effets à partir de blocs et de prompts IA. Cinq instruments gratuits sont fournis au lancement pour amorcer la pompe. Le 23 septembre, la presse spécialisée confirmait l’angle : Nova n’est pas un plugin, c’est un constructeur et un magasin. C’est une réponse structurelle à la fatigue : au lieu de vendre un modèle qui deviendra obsolète, on vend un cadre dans lequel l’utilisateur compose avec les modèles qu’il choisit. La question de la qualité se déplace du modèle vers l’assemblage — et la responsabilité de la mise à jour revient à l’utilisateur, ce qui est à la fois une libération et un transfert de charge.
Signal deux : l’assistance plutôt que la génération. Roland Melody Flip, lancé le 8 septembre 2026, est l’exemple le plus net. L’outil ne produit pas une chanson : il génère des mélodies, avec 250 palettes de genres, dans le cadre du DAW. C’est un positionnement défensif assumé, et il parle directement à l’ingénieur fatigué : « je ne remplace pas ton travail, je t’aide à démarrer ». La nuance est commerciale autant que technique, mais elle indique une prise de conscience : la promesse du remplacement total a un coût de crédibilité que le marché ne veut plus payer.
Signal trois : le son comme service d’entreprise. NC AI VARCO Sound, publié le 20 octobre 2026, est un générateur de sonorités multipiste orienté production de contenu — capable de créer et d’arranger plusieurs sons pour une même scène. Ce n’est pas un outil de musicien : c’est une brique de production pour studios, éditeurs de jeux, plateformes d’e-learning et agences. La bascule est cohérente avec ce que le magazine documente depuis des mois : l’IA audio est sortie du home-studio pour devenir un service d’entreprise. Et dans ce cadre, la question de la fatigue change de nature : une entreprise ne choisit pas un modèle parce qu’il est nouveau, mais parce qu’il est contractuellement stable. La fatigue des modèles est un problème de consommateur ; pour l’entreprise, c’est un problème de gestion de risque fournisseur.
Ces trois signaux convergent vers une même conclusion : la réponse à la fatigue n’est pas un meilleur modèle, c’est une meilleure architecture de dépendance. Plateforme plutôt que produit, assistance plutôt que remplacement, service plutôt qu’outil.
La fatigue est-elle une fatigue d’offre ou de sens ? Le verdict par segment
Revenons à la question posée plus haut. La réponse, segment par segment, n’est pas uniforme.
Stem splitters : fatigue d’offre, en voie de résolution. La technologie est mature, les performances se valent, et l’arrivée de la séparation de stems comme fonctionnalité standard dans les DAW (Samplitude 2026.5) va faire disparaître la catégorie en tant que marché autonome. La fatigue ici est transitoire : elle durera jusqu’à ce que la fonction soit partout et que personne ne la remarque plus.
Génération musicale : fatigue de sens. C’est le segment où la question « est-ce que ça change quelque chose ? » est la plus aiguë. Les modèles se succèdent, mais les cas d’usage — jingles, musique de fond, prototypage — sont stables. La valeur ne vient plus du modèle mais de la licence (Adobe) et de l’intégration (NC AI). La fatigue est réelle et ne se résoudra pas par un meilleur modèle.
Restauration de voix : fatigue d’offre modérée. Les progrès sont mesurables et audibles, mais les métriques indépendantes manquent. Le segment souffre moins de saturation que d’opacité.
Mastering IA : fatigue de sens naissante. Les offres sont stables, les prix aussi (10 à 30 euros par mois). Le risque est ailleurs : l’homogénéisation sonore. Quand tout le monde utilise le même masteriseur, tout le monde sonne pareil. C’est une fatigue de différenciation, pas de nouveauté.
Plugins agentiques : fatigue d’offre maximale. C’est le segment où les annonces sont les plus nombreuses et les évaluations les plus rares. La promesse de chaînes autonomes (gain staging, EQ correctif, compression, automation) est séduisante mais rarement vérifiée indépendamment. C’est ici que la fatigue coûte le plus cher, parce que c’est ici que les décisions d’achat sont les plus mal informées.
Le verdict global : la fatigue est majoritairement une fatigue d’offre dans les segments techniques matures (stems, restauration), et une fatigue de sens dans les segments créatifs (génération, mastering, plugins agentiques). Les deux appellent des réponses différentes : pour la première, de la patience et des benchmarks indépendants ; pour la seconde, un changement de critère d’achat — passer du modèle à l’architecture.
Ce qu’un studio peut faire dès maintenant : cinq règles de survie
Puisque la fatigue est structurelle et ne disparaîtra pas au prochain trimestre, autant en tirer des règles opérationnelles. En voici cinq, dérivées de ce que les sources documentent réellement.
Règle un : ne jamais dépendre d’un modèle non versionné. Un service cloud qui met à jour silencieusement son moteur est un risque de production. Exigez des versions épinglées, ou préférez les modèles locaux dont vous contrôlez la mise à jour. Le NPU rend cela possible pour la séparation et la restauration.
Règle deux : mesurer avant de migrer. Le coût de comparaison est réel, mais le coût d’une migration non mesurée l’est davantage. Testez sur vos sessions, pas sur les benchmarks du vendeur. Cinq modèles testés sur dix, c’est le constat de CNBC ; faites mieux, mais testez au moins un.
Règle trois : préférer l’architecture au produit. Une plateforme comme Nova, un DAW qui intègre la fonction (Samplitude), un service contractualisé (VARCO Sound) survivent mieux à la prochaine vague qu’un plugin mono-modèle. La question à poser à tout fournisseur : « que se passe-t-il quand votre modèle est dépassé ? »
Règle quatre : surveiller la latence comme un critère de premier rang. Un score SDR élevé ne compense pas une latence incompatible avec votre flux de travail. Demandez les chiffres de latence, pas seulement les scores de qualité.
Règle cinq : anticiper le calendrier réglementaire. L’AI Act s’applique aux nouveaux modèles depuis le 2 août 2026 et s’étendra aux modèles existants le 2 décembre 2026. Pour un studio qui produit du contenu commercial, la traçabilité des modèles utilisés devient une exigence contractuelle, pas une curiosité juridique. La licence commerciale universelle d’Adobe Firefly Audio (10 dollars par mois) n’est pas un argument marketing : c’est une réponse à cette contrainte.
Sources
- Quatre laboratoires livrent des modèles frontière en une semaine et provoquent la model fatigue — ettayeb.fr, septembre 2026
- Quatre modèles de pointe en trois jours, et personne ne vous dira lequel il vous fallait — telli.sh, 8 septembre 2026
- CNBC : la cadence effrénée des sorties de modèles IA installe une model fatigue — AI Weekly, septembre 2026
- Fatigue des modèles d’IA en entreprise : que faire (2026) — WeCallShotgun, 2026
- Top 20 des modèles d’IA les plus performants en septembre 2026 : le classement complet — Blog du Modérateur, 21 septembre 2026
- NC AI Officially Releases VARCO Sound, the Generative AI Sound Production Service — PR Newswire, 20 octobre 2026
- Boris FX Samplitude 2026.5 Adds Spatial Panner and AI Stem Separation — Major HiFi, 8 octobre 2026
- Lunacy Audio launches new AI-powered plugin sharing platform, NOVA — MusicTech, 22 septembre 2026
- Lunacy Audio NOVA: 5 Free Instruments to Try — Greg Kocis, 23 septembre 2026
- Lunacy Audio открыла Nova — конструктор и магазин музыкальных плагинов с ИИ — AI Digest, 20 septembre 2026
- Roland se lance dans la musique IA avec Melody Flip — NeuroActu, 8 septembre 2026
- Roland Melody Flip: ИИ-плагин для музыки с 250 палитрами — Charmloop, 5 septembre 2026
- Suncatcher est en orbite : ce projet Google pourrait nous éviter une crise énergétique causée par l’IA — Presse-Citron, 2 octobre 2026
- Alibaba dévoile la « puce IA la plus puissante de Chine » — Presse-Citron, 23 septembre 2026
- OpenAI lance trois nouveaux modèles d’API audio en temps réel, dont GPT-Realtime-2 — NotebookCheck, 2026
- Après quinze ans à couvrir la tech sans broncher, l’IA m’a fait perdre pied cet été — Les Numériques, 11 septembre 2026
- Craintes autour de l’IA : le patron d’Anthropic appelle lui aussi à freiner la vitesse de développement — RTL, 12 septembre 2026
Article recherché et rédigé automatiquement · Magazine Electrosens