
 NVIDIA DGX Spark · 11 October 2026
DGX Spark et DGX Station for Windows : l’IA locale open source bascule sur GB10, GB300 et Windows
Le 1er juin 2026, en marge du GTC Taipei, NVIDIA a dévoilé un boîtier qui ressemble à un amplificateur home cinéma, mais qui promet de faire tourner des modèles à 1 000 milliards de paramètres sur un bureau. La DGX Station for Windows, développée avec Microsoft, bouscule la hiérarchie établie depuis le DGX Spark. Mais à l’automne 2026, la vraie nouvelle n’est peut-être pas là : le Spark, lui, s’est dédoublé, s’est clusterisé, et a appris à faire du fine-tuning BF16 en pleine précision. Décryptage d’un écosystème qui se ramifie plus vite qu’on ne le croit.
Un supercalculateur dans un boîtier de home cinéma
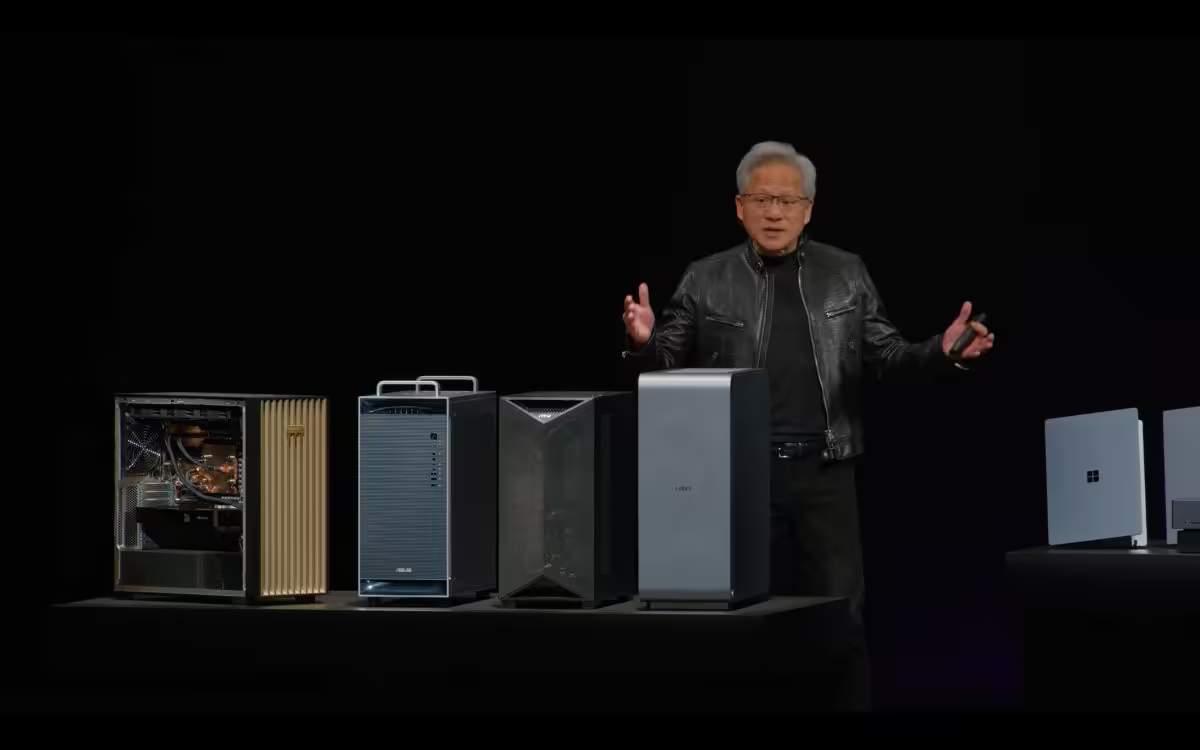
L’annonce a été faite au GTC Taipei, le 1er juin 2026, dans un contexte où l’IA locale est devenue un champ de bataille majeur. Après le succès du DGX Spark (anciennement Project DIGITS), ce petit boîtier à 3 000 $ qui a démocratisé l’inférence locale de modèles open source, NVIDIA frappe un grand coup avec un format « deskside » — un boîtier vertical qui, selon les mots des observateurs, ressemble à un amplificateur de home cinéma. Mais sous ce design discret, la bête est redoutable : le GB300 Grace Blackwell Ultra Desktop Superchip, capable de traiter des modèles jusqu’à 1 trillion de paramètres en local.
Ce n’est pas un simple rafraîchissement. C’est un changement de catégorie. Là où le DGX Spark s’adressait aux développeurs et aux passionnés avec ses 128 Go de mémoire unifiée, la DGX Station for Windows vise explicitement les entreprises et les postes de travail professionnels. Le choix de Windows comme système d’exploitation principal — en collaboration avec Microsoft — est un signal fort : NVIDIA ne veut plus seulement conquérir les laboratoires Linux, mais s’imposer sur le bureau de l’ingénieur, du data scientist et du créateur d’agents IA.
Le timing est également stratégique. Nous sommes en octobre 2026, et l’écosystème open source a explosé : DeepSeek V4 Flash tourne sur des clusters de deux DGX Spark, Qwen3.8-27B atteint 34-38 tok/s sur un Spark seul, et des modèles comme Xiaomi MiMo-V2.6 (jusqu’à 1T de paramètres pour la variante Pro) revendiquent de tenir tête aux frontières fermées. La DGX Station arrive au moment où la demande de puissance locale dépasse ce qu’un Spark peut offrir en confort — mais aussi au moment où le Spark lui-même se réinvente.
GB300 vs GB10 : la fiche technique qui tue
Le cœur de la DGX Station for Windows est le GB300 Grace Blackwell Ultra Desktop Superchip : un GPU Blackwell Ultra couplé à un CPU Grace, reliés par NVLink-C2C. Selon la page produit NVIDIA et la couverture de tech-insider.org, NVIDIA annonce 20 pétaflops en FP4 et jusqu’à 748 Go de mémoire. Ces chiffres donnent le vertige comparés au DGX Spark, basé sur le GB10, qui plafonne à environ 1 pétaflop FP4 et 128 Go de mémoire unifiée.
| Caractéristique | DGX Station for Windows | DGX Spark (GB10) |
|---|---|---|
| Processeur | GB300 Grace Blackwell Ultra Desktop Superchip | GB10 Grace Blackwell Superchip |
| Interconnexion CPU-GPU | NVLink-C2C | NVLink-C2C |
| Mémoire | Jusqu’à 748 Go | 128 Go unifiée (variante 64 Go depuis octobre 2026) |
| Performance FP4 | 20 pétaflops | ~1 pétaflop |
| Capacité modèles | Jusqu’à 1 trillion de paramètres | Modèles 27B-405B en pratique (cluster) |
| OS | Windows (avec NVIDIA OpenShell) + Linux | Linux (Ubuntu) |
| Prix | ~10 000 $ (non confirmé indépendamment) | ~3 000 $ (128 Go) ; 4 999 $ pour la variante 64 Go |
| Lancement | Q4 2026 | Disponible |
La différence de mémoire est le facteur le plus déterminant. Avec 748 Go, on peut charger en mémoire des modèles comme Llama 3.1 405B en quantification Q4, ou même des modèles plus récents comme DeepSeek V4 Flash (284 milliards de paramètres) en pleine précision. Le Spark, lui, est limité à des modèles de 27 à 405 milliards — et le 405B n’est atteignable qu’en cluster de deux nœuds.
Il faut toutefois noter des lacunes dans les spécifications publiées : NVIDIA n’a pas communiqué sur la capacité de stockage NVMe, le TDP ou l’alimentation. Ces détails sont cruciaux pour un poste de travail qui, à en juger par les performances annoncées, devrait consommer nettement plus que les 150 W du Spark. La prudence s’impose : les chiffres de 20 pétaflops et 748 Go proviennent des communications NVIDIA (relayées par SiliconANGLE et tech-insider.org), et aucun benchmark indépendant n’a encore été publié.
Windows, le nouveau terrain de jeu de l’IA locale
Le choix de Windows comme OS principal est une rupture historique pour NVIDIA, dont les stations DGX ont toujours été Linux-first. La collaboration avec Microsoft a donné naissance à NVIDIA OpenShell, un runtime agentique open-source sécurisé intégré à Windows, fondé sur les nouveaux mécanismes de sécurité et de confinement de Windows. Concrètement, cela signifie que les développeurs pourront exécuter des conteneurs NGC, TensorRT-LLM et PyTorch directement sur Windows, sans passer obligatoirement par WSL2.
Le mécanisme technique exact n’a pas été détaillé dans les sources disponibles. On peut raisonnablement imaginer un driver CUDA natif pour Windows, couplé à une couche de compatibilité pour les conteneurs. L’enjeu est de taille : l’écosystème NGC (NVIDIA GPU Cloud) est massivement orienté Linux, et les scripts de fine-tuning existants pour le Spark utilisent des images Docker Ubuntu. Si la DGX Station supporte nativement les conteneurs NGC sous Windows, la migration sera transparente. Sinon, WSL2 restera la béquille.
Un indice concret est apparu début septembre 2026 : le firmware du DGX Spark a intégré un certificat de démarrage Windows UEFI (Windows UEFI CA), signe que NVIDIA prépare ses machines à un écosystème Windows natif (StorageReview, 5 septembre 2026). Ce détail, anodin en apparence, montre que la stratégie « Windows-first » n’est pas qu’un slogan marketing : elle descend jusqu’au firmware.
Cette stratégie s’inscrit dans un mouvement plus large. Le 7 octobre 2026, Microsoft a présenté sa vision d’une « Intelligence Hybride » pour Windows, avec des agents IA capables de tourner en local sur PC (blogs.windows.com). Le même jour, la keynote Microsoft a mis en avant DeepSeek V4 Flash et l’IA locale sur PC (blog-nouvelles-technologies.fr). Autrement dit, la DGX Station for Windows n’arrive pas dans le vide : elle arrive dans un Windows qui a été explicitement repensé pour héberger des agents IA locaux.
Pour les possesseurs de Spark, cette annonce a un avantage collatéral : NVIDIA a récemment (3 septembre 2026) annoncé un support simplifié de l’IA locale pour les GPU équipés de 24+ Go de VRAM, avec des optimisations pour vLLM et llama.cpp (wccftech.com). Cette stratégie « Windows-first » pourrait bénéficier à toute la gamme, y compris les RTX.
20 pétaflops annoncés, mais que valent les benchmarks réels ?
C’est le point le plus délicat. À ce jour, aucun benchmark indépendant de la DGX Station for Windows n’a été publié. Les seuls chiffres disponibles sont ceux annoncés par NVIDIA : 20 pétaflops FP4 et la capacité de faire tourner des modèles à 1 trillion de paramètres.

En revanche, les tests tiers sur le Spark, eux, sont nombreux et documentés. Le tableau ci-dessous rassemble les mesures les plus récentes de l’automne 2026 :
| Configuration | Modèle | Débit | Source / date |
|---|---|---|---|
| 1× DGX Spark (ds4.c, IQ2_XXS) | DeepSeek-V4-Flash | ~14 tok/s single-stream, 410 tok/s prefill | 2026-08 |
| 1× DGX Spark (llama.cpp GGUF) | 35B-A3B | jusqu’à 67 tok/s | 2026-08 |
| 1× DGX Spark | Qwen3.8-27B | 34-38 tok/s | 2026-08-20 |
| 1× DGX Spark | Qwen3.6-27B | 28-33 tok/s (session unique), 163 tok/s (pic), 136 tok/s (10 agents) | 2026 |
| 2× DGX Spark (TP=2, vLLM, FP8) | DeepSeek-V4-Flash | ~41 tok/s single-stream, ~350 tok/s agrégé @ c=32, ~1 785 tok/s prefill | 2026-08 |
| 2× DGX Spark (cache KV partagé) | — | pool de 1 105 096 tokens | 2026-08 |
| AMD Ryzen AI Halo (comparaison) | modèle 120B | 34-39 tok/s | 2026-09 |
Un repère indépendant précieux est arrivé le 29 septembre 2026 : AA-AgentPerf-Local, un outil open source d’Artificial Analysis qui mesure la vitesse d’exécution d’agents IA sur laptops et stations de travail, avec des résultats de lancement pour le DGX Spark, le Ryzen AI Halo, le MacBook Pro (M5 Pro) et la RTX 5090 sur quatre modèles open-weight (artificialanalysis.ai). C’est exactement le type de méthodologie qui manque encore pour la DGX Station.
En extrapolant à partir des spécifications, on peut estimer que la DGX Station, avec ses 20 pétaflops FP4 (soit ~20 fois le Spark), pourrait atteindre des vitesses d’inférence de l’ordre de 200-400 tok/s sur des modèles 70B, et faire du fine-tuning LoRA sur des modèles 405B en quelques heures. Mais ce ne sont que des extrapolations. Il faudra attendre les tests de la presse spécialisée, probablement après le lancement au Q4 2026.
Un point positif : l’écosystème logiciel a mûri. Les workflows de fine-tuning complets sur Spark sont désormais documentés, et des projets communautaires montrent que la communauté a appris à dompter la machine. Cette maturité logicielle devrait se transférer à la DGX Station, qui utilise la même architecture Grace Blackwell.
Le Spark se dédouble : la variante 64 Go à 4 999 $
C’est peut-être la nouvelle la plus sous-estimée de l’automne. Le 2 octobre 2026, Hardwareluxx Russia a rapporté que le DGX Spark reçoit une version plus abordable, avec 64 Go de mémoire (hardwareluxx.ru). Le 3 octobre, kod.ru a précisé les détails : cette variante entre en vente le 23 octobre 2026, à partir de 4 999 $ — soit 1 000 $ de plus que le prix de lancement de la version originale à 128 Go en 2025 (kod.ru).
Le paradoxe mérite d’être souligné : une version à mémoire réduite, mais plus chère que l’originale. Cela reflète probablement la hausse des coûts des composants mémoire en 2026, plus qu’une stratégie de segmentation. Quoi qu’il en soit, cela redessine l’offre : le Spark n’est plus un produit unique à 3 000 $, mais une gamme qui s’étale de la variante 64 Go (4 999 $) à la variante 128 Go, en passant par les mini-PC RTX Spark des OEM.
Car les OEM sont entrés dans la danse. Selon shattered.io (8 septembre 2026), 8 fabricants livrent désormais des mini-PC RTX Spark, Lenovo et Acer en tête. Acer a livré ses premières machines le 8 septembre 2026, avec 128 Go unifiés et un positionnement 500 à 1 000 $ sous le prix NVIDIA. ASUS a présenté à l’IFA 2026 son ProArt GR1X, un mini-PC de 15 cm de côté équipé de la puce RTX Spark, conçu pour faire tourner un agent IA en permanence sans cloud (realmoon.ai). ASUS a également décliné ses ProArt P14 et P16 en laptops 128 Go + RTX Spark (ecosistemastartup.com). Et même AMD s’y met : selon Gizmodo (4 septembre 2026), HP prépare un laptop avec le meilleur APU AMD capable de gérer IA et gaming.
Clusters, PAIR et conteneurs NGC : l’écosystème logiciel en question
L’écosystème logiciel est le véritable champ de bataille. NVIDIA a lancé PAIR (Personal AI Router, 3-6 septembre 2026), un logiciel gratuit et open source qui transforme les réseaux domestiques en clusters d’inférence multi-GPU (computeleap.com, LinkedIn/Anthony Tracey). Cette initiative, combinée à la DGX Station, suggère une stratégie claire : permettre aux utilisateurs de connecter plusieurs machines (Sparks, Stations, RTX) pour former des clusters hétérogènes. Comme le résume computeleap, « NVIDIA route l’inférence à travers votre réseau domestique. DGX Spark et RTX Spark fournissent le matériel. C’est NVIDIA qui couvre son empire cloud-GPU. »
Les implications pour la DGX Station sont importantes. Avec ses 748 Go de mémoire, une Station seule peut faire ce que deux Sparks font en cluster. Mais l’intégration dans un cluster existant (par exemple, deux Sparks + une Station) pourrait permettre de faire tourner des modèles encore plus gros, ou d’augmenter le nombre d’agents simultanés.
Sur le plan des clusters Spark purs, les repères de l’automne 2026 sont désormais bien établis : deux nœuds pour 405B, quatre pour 700B, huit pour 750B+. Le cache KV partagé sur deux nœuds atteint 1 105 096 tokens, ce qui autorise des contextes très longs en multi-agents. La question de la compatibilité inter-nœuds (quorum, mise à jour séquentielle) reste un point de vigilance documenté par la communauté.
La compatibilité avec les conteneurs NGC est un point crucial. Le catalogue NGC contient des milliers de conteneurs optimisés pour les GPU NVIDIA, et la plupart sont conçus pour Linux. Si la DGX Station supporte ces conteneurs nativement sous Windows (via une couche de virtualisation ou un runtime natif), l’écosystème sera immédiatement disponible. Sinon, WSL2 restera la solution de repli, avec les performances en moins.
Fine-tuning : l’exploit BF16 d’un 35B sur un seul Spark
C’est l’une des démonstrations les plus marquantes de l’automne 2026 : affiner un modèle de 35 milliards de paramètres en pleine précision BF16, sans quantification, sur un seul DGX Spark. Un exploit rendu possible par une astuce de chargement qui contourne le piège du mmap — le chargement par défaut qui fait planter la machine en saturant la mémoire unifiée.
L’enseignement est double. D’abord, le Spark est capable de fine-tuning haute précision, pas seulement d’inférence quantifiée. Ensuite, la maîtrise des mécanismes mémoire (mmap, offloading, gestion du cache) est devenue une compétence clé pour quiconque veut exploiter la machine au maximum. Ces workflows devraient se transférer directement à la DGX Station, qui partage l’architecture Grace Blackwell et la même pile CUDA.
Pour les modèles plus gros, le fine-tuning LoRA reste la voie praticable : sur un cluster de deux Sparks, on peut envisager d’affiner des modèles de 70B+ en LoRA, avec un coût mémoire maîtrisé. C’est précisément la frontière que la DGX Station, avec ses 748 Go, promet de repousser — jusqu’au fine-tuning de modèles 405B en local.
Les modèles open-weight stars de l’automne 2026
Le paysage des modèles a lui aussi bougé. Voici les principaux candidats qui tournent (ou tourneront) sur GB10 et GB300 :

- DeepSeek V4 Flash (284B) : le cheval de bataille des clusters Spark, ~41 tok/s single-stream et ~350 tok/s agrégé sur deux nœuds en FP8.
- Qwen3.8-27B (Alibaba, août 2026) : 34-38 tok/s sur un Spark seul, le meilleur compromis taille/vitesse pour un nœud unique.
- Xiaomi MiMo-V2.6 (Pro, Flash, 9B, open source sous licence MIT, 22-24 septembre 2026) : la famille qui a fait sensation. Selon forkast.news, la variante Pro « égale Grok 4.7 sur l’Intelligence Index et surpasse Claude Opus 5 sur des benchmarks clés ». Attention toutefois : eweek.com souligne que « ses gains en RL manquent encore de réplication indépendante et reposent sur une infrastructure d’entraînement coûteuse ». La prudence est de mise sur les chiffres auto-déclarés.
- Nex-N2.5 Mini (post-entraîné à partir de la lignée Qwen3.5) : face au vétéran Qwen3-8B, un duel intéressant pour les stacks légères (orcarouter.ai, 9 septembre 2026).
- Poolside Laguna S 2.1 (118B) : revendique de battre des concurrents dix fois plus gros.
La diversité de cette offre est une bonne nouvelle pour le Spark : plus les modèles sont efficaces par paramètre, plus la machine de 128 Go reste pertinente, même face à une Station à 748 Go.
Face au Mac Studio, au Ryzen AI Halo et à la RTX 5090, la Station a-t-elle un avenir ?
Le positionnement concurrentiel est complexe. Voici les principaux adversaires :
| Système | Prix | Mémoire | Consommation | Points forts |
|---|---|---|---|---|
| DGX Station for Windows | ~10 000 $ | 748 Go | Non précisé | 20 PFLOPS FP4, modèles 1T |
| DGX Spark (128 Go) | ~3 000 $ | 128 Go | ~150 W | Écosystème, clusters, prix |
| DGX Spark (64 Go) | 4 999 $ | 64 Go | ~150 W | Entrée de gamme NVIDIA |
| Mac Studio M4/M5 Ultra | 3 999 $ (128 Go) / 5 999 $ (256 Go) | 128-256 Go | 100-150 W | Efficacité, écosystème Apple |
| AMD Ryzen AI Halo | 3 999 $ | 128 Go LPDDR5X | 55-120 W | 34-39 tok/s sur 120B, 256 Go/s |
| PC RTX 5090 | ~2 000 $ (carte seule) | 32 Go VRAM | 575 W | Prix, flexibilité |
| Cloud A100/H100 | 1-3 $/h | Variable | – | Scalabilité, zéro maintenance |
La DGX Station est clairement positionnée au-dessus du Mac Studio en termes de mémoire (748 Go contre 256 Go max) et de performance brute. Mais le Mac Studio, avec ses 128 Go à 3 999 $, reste imbattable en performance par watt et en prix d’entrée. Le Ryzen AI Halo, à 3 999 $ avec 128 Go LPDDR5X et 256 Go/s de bande passante, offre 34-39 tok/s sur un modèle 120B — un rapport performance/prix redoutable pour l’inférence. Les PC équipés de RTX 5090, malgré leur VRAM limitée à 32 Go, restent excellents pour les modèles 7B-32B.
Le benchmark contextstudios.ai (24 septembre 2026) compare précisément DGX Spark, Mac Studio M5 Ultra, RTX 5090 et Strix Halo sur Qwen3.8 et GLM-5.3, avec tokens/s réels, prix et coût par token face au cloud. C’est la référence à consulter pour arbitrer.
Le calcul du coût par token est impossible à faire précisément pour la Station sans benchmarks. Mais on peut raisonnablement estimer qu’à 10 000 $, elle devra justifier son prix par des capacités que ni le Mac Studio ni la RTX 5090 ne peuvent offrir : le fine-tuning de modèles 100B+ en local, et l’inférence de modèles 1T en quantification.
DGX Spark : faut-il vendre le sien pour acheter la Station ?
La question est légitime. Le Spark, à 3 000 $, reste une machine exceptionnelle pour son prix. Il fait tourner Qwen3.8-27B à 34-38 tok/s, DeepSeek V4 Flash à ~41 tok/s single-stream (et ~350 tok/s agrégé sur deux nœuds), et peut être clusterisé — deux nœuds pour 405B, quatre pour 700B, huit pour 750B+. Pour les développeurs qui travaillent sur des modèles 7B-32B, le Spark est largement suffisant.
La DGX Station s’adresse à un autre public : ceux qui veulent fine-tuner des modèles 70B+ en local, ou faire tourner des modèles 405B-1T en inférence. Le coût de migration est faible : les scripts PyTorch, les conteneurs NGC et les workflows développés pour le Spark devraient fonctionner sans modification majeure, grâce à la compatibilité CUDA et à l’architecture Grace Blackwell commune.
En revanche, la valeur résiduelle du Spark reste solide, et l’offre se diversifie : les mini-PC RTX Spark d’Acer, Lenovo et consorts sont livrés depuis septembre 2026, avec 128 Go unifiés et un prix 500 à 1 000 $ sous le DGX Spark officiel. ASUS ProArt GR1X, ProArt P14/P16, HP avec AMD : le marché de l’IA locale de bureau n’a jamais été aussi concurrentiel. Pour les possesseurs actuels, la question n’est pas « vendre ou ne pas vendre », mais plutôt « ai-je besoin de 748 Go de mémoire ? » Si la réponse est non, le Spark — ou l’un de ses clones OEM — reste un excellent compagnon.
Pro vs amateur : qui est vraiment visé ?
À 10 000 $, la DGX Station for Windows n’est clairement pas un produit grand public. NVIDIA cible les professionnels : data scientists, ingénieurs ML, studios de création d’agents IA, entreprises qui veulent garder leurs données en interne pour des raisons de confidentialité. Pour eux, la Station offre une alternative crédible au cloud : pas de coût horaire, pas de latence réseau, pas de risque de fuite de données.
Les amateurs éclairés, eux, resteront sur le Spark ou les PC équipés de RTX. Le Spark à 3 000 $, ou les mini-PC RTX Spark des OEM à prix inférieur, offrent déjà des capacités impressionnantes pour l’inférence locale. Le fine-tuning de modèles 70B+ reste l’apanage des professionnels, et c’est exactement là que la DGX Station se positionne.
Le positionnement marketing de NVIDIA est intéressant : la collaboration avec Microsoft et le support de Windows visent à séduire les entreprises qui n’ont pas d’infrastructure Linux. C’est un pari audacieux, car l’écosystème IA est historiquement Linux-first. Mais avec OpenShell, le certificat de démarrage Windows UEFI dans le firmware du Spark, et la vague « Intelligence Hybride » de Windows 11 26H2, NVIDIA et Microsoft construisent patiemment un pont entre les deux mondes. Si ce pont tient, la DGX Station pourrait bien être la première machine à faire de l’IA de classe supercalculateur un outil de bureau ordinaire — et le Spark, son éclaireur.
Sources
- NVIDIA annonce DGX Station pour Windows — blogs.nvidia.fr (GTC Taipei, 1er juin 2026)
- Supercalculateur d’IA pour Windows | Station NVIDIA DGX — nvidia.com
- NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs — tech-insider.org
- DGX Station — build.nvidia.com
- Nvidia представила ИИ-компьютер DGX Spark с 64 ГБ памяти — kod.ru (3 octobre 2026)
- Теперь и с 64 Гбайт: DGX Spark получил более доступную версию — Hardwareluxx Russia (2 octobre 2026)
- AA-AgentPerf-Local: Benchmarking local AI agents on laptops and workstations — artificialanalysis.ai (29 septembre 2026)
- Matériel pour l’IA locale en 2026 : DGX Spark, Mac Studio M5 Ultra, RTX 5090 et Strix Halo comparés — contextstudios.ai (24 septembre 2026)
- Xiaomi MiMo-V2.6 Open Source: Pro, Flash, 9B Models — eweek.com (23 septembre 2026)
- Xiaomi’s MiMo-V2.6 Ships Open Weights at Frontier-Class Performance — forkast.news (22 septembre 2026)
- Xiaomi introduces Mimo-V2.6 series open-source AI model family — SiliconANGLE (22 septembre 2026)
- Xiaomi MiMo-V2.6 Breaks Cover: A 1T-Class Chinese Lab Trains in Public — forkast.news (17 septembre 2026)
- Nex-N2.5 Mini contre Qwen3-8B — orcarouter.ai (9 septembre 2026)
- RTX Spark PCs [2026]: 8 OEMs, Lenovo Leads — shattered.io (8 septembre 2026)
- Asus ProArt GR1X : le mini-PC RTX Spark pour agents IA en local — realmoon.ai (6 septembre 2026)
- NVIDIA Shipped a Local AI Router. Nobody Noticed. — computeleap.com (6 septembre 2026)
- DGX Spark Windows Clue: This Week’s Firmware Adds a Windows Boot Certificate — StorageReview (5 septembre 2026)
- Nvidia launches free tool that links idle computers into a personal AI data center — LinkedIn/Anthony Tracey (5 septembre 2026)
- AMD Has Its Own RTX Spark PCs (And It Still Won’t Show Them to You) — gizmodo.com (4 septembre 2026)
- ASUS ProArt P14 y P16: 128 GB y RTX Spark para IA local — ecosistemastartup.com (3 septembre 2026)
- NVIDIA Brings Simplified Local AI Support To NVIDIA GPUs Carrying 24+ GB VRAM — wccftech.com (3 septembre 2026)
- Building Windows for hybrid intelligence — blogs.windows.com (7 octobre 2026)
- Keynote Microsoft : l’IA locale révolutionne Windows — blog-nouvelles-technologies.fr (7 octobre 2026)
- Microsoft confirme Windows 11 26H2 — lecrabeinfo.net (30 septembre 2026)
- MiniMax H3 FL2VA on single DGX Spark GB10 — github.com (26 septembre 2026)
- ASUS ProArt GR1X : l’IA locale pour les entreprises — syskb.com (22 septembre 2026)
Article recherché et rédigé automatiquement · Magazine Electrosens