
 IA Traitement du son · 16 September 2026
IA audio 2026 : génération, mixage, mastering, NPU — le son est devenu une infrastructure
Il est 14 h 30 dans un studio de post-production parisien. Au lieu de fouiller des disques durs de 4 To à la recherche du « bon » bruit de pas sur gravier, une sound designer tape une phrase : « pas lourds sur gravier humide, plan rapproché, léger écho ». En six secondes, trois propositions s’affichent. Elle en retient une, la boucle, l’ajuste, l’exporte en WAV 24 bits. Il y a cinq ans, cette scène relevait de la science-fiction. Aujourd’hui, elle est banale. Mais derrière cette apparente magie se cache une transformation profonde du métier, des outils et de l’économie du son — une transformation que ce dossier explore en profondeur.
Le bruit de fond a changé : 2026, l’année où l’IA a pris le studio d’enregistrement
Pour comprendre l’ampleur du bouleversement, il faut remonter le fil. Depuis les synthétiseurs analogiques des années 1960 jusqu’aux échantillonneurs numériques des années 1980, chaque révolution technologique a redéfini la manière dont les sons sont créés et manipulés. Les bibliothèques de samples, apparues avec les CD-ROM dans les années 1990, ont standardisé le métier : des milliers de fichiers organisés par catégories, des moteurs de recherche de plus en plus sophistiqués, et une économie de licences qui a fait la fortune de quelques éditeurs.
Mais en 2026, le paysage a radicalement changé. La génération procédurale d’effets sonores par intelligence artificielle est passée du statut d’expérimentation de laboratoire à celui d’outil de production courante. Les acteurs se sont multipliés : ElevenLabs, dont le blog annonce régulièrement des mises à jour de ses outils audio IA ; Adobe Firefly Audio, sorti de sa bêta le 20 août 2026 ; sonible avec son smart:chain ; et une myriade de générateurs de musique comme MiniMax, HappyShrimp ou Mureka. Cette multiplication n’est pas anecdotique : elle signale un basculement structurel des flux de travail professionnels.
Les chiffres récents donnent la mesure du phénomène. Selon une étude de SubmitHub publiée le 20 août 2026 et relayée par Euronews, près de 40 % de la musique sortie dans le monde en juillet 2026 a eu recours à l’IA dans sa création : 23,2 % des morceaux analysés (plus d’un million) étaient entièrement générés par IA, et 15,3 % supplémentaires utilisaient des éléments audio générés par IA ensuite « modifiés ou traités » par des humains. Le détecteur SH Labs de SubmitHub est d’ailleurs utilisé par Bandcamp, Traxsource et la GEMA pour repérer le recours à l’IA dans la musique. Chez Deezer, plus de la moitié des nouveaux morceaux étaient générés par IA en septembre 2026. Ces données confirment que l’IA n’est plus une expérimentation marginale : elle est devenue l’infrastructure de production elle-même.
Face à ce raz-de-marée, l’industrie a réagi. Le 10 juillet 2026, sous la pression des ayants droit, un système de double étiquetage volontaire a été dévoilé : les morceaux générés par IA doivent être signalés via des métadonnées et des icônes visuelles. Et le cadre réglementaire européen s’est durci : l’AI Act impose désormais l’étiquetage obligatoire en Europe — depuis le 2 août 2026 pour les nouveaux modèles, et à partir du 2 décembre 2026 pour les modèles existants. Une fronde de 34 396 artistes s’est également organisée contre l’IA non encadrée, comme le rapporte notre enquête sur l’étiquetage volontaire.
Text-to-SFX : les outils qui comptent vraiment
Faisons un état des lieux honnête des outils disponibles en 2026. Le marché est fragmenté, avec des approches très différentes. Voici les acteurs dont les capacités sont documentées et vérifiables.
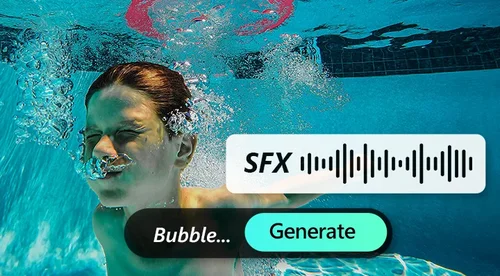
Adobe Firefly Audio est sans doute l’annonce la plus structurante de l’année. Le 20 août 2026, Adobe a sorti de sa bêta trois outils de génération audio par IA — musique, parole, effets sonores — désormais intégrés nativement dans Premiere Pro et After Effects. La promesse est claire : créer un accompagnement musical, une voix off ou un bruitage sans micro ni instrument. Les modèles ont été entraînés exclusivement sur du contenu sous licence ou public, et la licence universelle incluse garantit une utilisation commerciale sans risque juridique — un argument décisif face aux contentieux qui menacent d’autres acteurs. Côté tarif, l’abonnement Firefly seul coûte 10 USD par mois, avec un système de crédits génératifs. Les paramètres de contrôle sont précis : pour la musique, on règle le BPM, la durée, le style et le nombre de voix simultanées ; pour la parole, on choisit la voix, la langue, les étiquettes d’émotion et des guides de prononciation. Les améliorations apportées depuis la bêta incluent le contrôle de la longueur, la création de boucles parfaites et la séparation des voix. Détail notable : dans l’outil Generate Speech, il est possible d’utiliser le modèle d’ElevenLabs en option tierce. Comme le souligne The Next Web, le positionnement d’Adobe n’est pas la qualité audio brute, mais la sécurité commerciale.
ElevenLabs reste l’un des acteurs les plus visibles du secteur. Son outil de génération d’effets sonores, entraîné sur l’immense banque de sons sous licence de Shutterstock, permet de produire des bruitages convaincants à partir d’une simple description textuelle. L’outil ne se limite pas aux bruitages : il est aussi capable de produire de courts extraits musicaux, ce qui en fait un outil polyvalent pour les compositeurs et les podcasteurs. Le blog officiel d’ElevenLabs documente les mises à jour régulières de ses modèles, et l’entreprise propose une API et des intégrations qui commencent à apparaître dans certains DAW. Cependant, les sources disponibles ne fournissent pas de données chiffrées précises sur ses capacités réelles, sa latence ou ses coûts — un manque de transparence qui caractérise encore trop d’acteurs de ce secteur.
sonible smart:chain, publié le 26 août 2026, marque une autre tendance : l’IA intégrée aux chaînes de traitement plutôt qu’à la génération pure. Comme le rapporte Audiofanzine, smart:chain réunit égaliseur, compresseur et saturation dans une chaîne de traitements qui s’adapte au signal entrant. Au lieu de régler chaque paramètre manuellement, l’ingénieur du son laisse l’IA analyser le signal et proposer des réglages cohérents. C’est une approche radicalement différente de la génération text-to-SFX : ici, l’IA assiste le mixage et le mastering en temps réel, sans remplacer l’humain.
MiniMax, HappyShrimp, Mureka : les générateurs de musique se multiplient. MiniMax propose Speech 2.6 et Music 2.0 pour générer des voix et des musiques réalistes. HappyShrimp, d’Alibaba, est sorti en bêta le 17 août 2026 avec des workflows à partir d’une ligne, de paroles, de musique instrumentale ou d’audio de référence, comme le montre cette démo. Mureka, de son côté, propose sa version V9.5 gratuite avec des voix naturelles et des arrangements expressifs, détaillée sur musicmaker.im. Ces outils visent moins les sound designers que les créateurs de contenu et les podcasteurs, mais ils contribuent à normaliser l’IA dans la production musicale courante.
Neural Analog mérite une mention particulière, en tant que cas d’école des promesses non tenues. Cette startup parisienne fondée en 2025 revendique 40 000 utilisateurs et promet « d’améliorer la qualité audio en un clic grâce à la puissance du GPU ». Mais comme l’a montré notre enquête, les benchmarks sont introuvables, l’architecture neuronale reste un trou noir technique, et aucun artiste connu n’atteste de l’efficacité du produit. C’est un rappel salutaire : dans ce marché naissant, la communication marketing ne remplace pas la mesure.
| Outil | Année / date clé | Fonctionnalités principales | Formats de sortie | Modèle économique | Fiabilité des sources |
|---|---|---|---|---|---|
| Adobe Firefly Audio | 20 août 2026 (GA) | Musique, parole, SFX ; intégration Premiere Pro/After Effects ; licence universelle ; paramètres BPM, durée, style, voix | Non précisé | 10 USD/mois, crédits génératifs | Confirmée (multiples sources) |
| ElevenLabs | Blog actif 2026 | Text-to-SFX, entraîné sur Shutterstock, extraits musicaux, API | Non précisé | Abonnement/API | Partielle (blog officiel) |
| sonible smart:chain | 26 août 2026 | Égaliseur + compresseur + saturation adaptatifs au signal | Non précisé | Abonnement | Confirmée (Audiofanzine) |
| MiniMax | 18 août 2026 | Speech 2.6, Music 2.0, voix et musiques réalistes | Non précisé | Freemium/API | Confirmée (site officiel) |
| HappyShrimp (Alibaba) | 17 août 2026 (bêta) | Génération musique depuis ligne, paroles, audio de référence | Non précisé | Non précisé | Partielle (démo) |
| Mureka | 13 août 2026 (V9.5) | Voix naturelles, arrangements expressifs, gratuit | Non précisé | Freemium | Partielle (site tiers) |
| Neural Analog | Fondée 2025 | « Son illimité » par GPU, 40 000 utilisateurs revendiqués | Non précisé | Flou | Faible (aucun benchmark) |
Ce tableau révèle un paradoxe : les outils les plus visibles sont ceux qui communiquent le plus, pas nécessairement ceux qui performent le mieux. La prudence s’impose face aux affirmations marketing non vérifiées.
Sous le capot : modèles latents, diffusion et le contrôle fin qui manque encore
Pour comprendre les forces et faiblesses de ces outils, il faut examiner les méthodes techniques sous-jacentes. La génération audio par IA repose principalement sur deux familles de modèles : les modèles de diffusion et les transformers audio.
Les modèles de diffusion fonctionnent par itérations : ils partent d’un bruit aléatoire et le transforment progressivement en son cohérent, guidés par une condition (un prompt texte, une référence audio, etc.). Cette approche excelle pour produire des textures riches et variées. La qualité spectrale est généralement bonne, mais la cohérence temporelle — c’est-à-dire la capacité à maintenir une structure rythmique ou une évolution logique sur plusieurs secondes — reste un défi.
Les transformers audio traitent l’audio comme une séquence de tokens, à la manière d’un modèle de langage. Ils sont particulièrement efficaces pour générer des sons qui ont une structure temporelle forte, comme des bruits de pas ou des moteurs. Leur point faible est la résolution spectrale : les détails fins, comme les harmoniques d’un instrument ou le grain d’une texture, peuvent être perdus.
Certaines approches plus avancées évoquent la synthèse différentielle : au lieu de générer un son à partir de zéro, on transforme un son existant selon une trajectoire émotionnelle ou un paramètre contrôlable. Cette technique permet un contrôle plus fin, mais elle suppose d’avoir un son source de bonne qualité — ce qui ramène aux bibliothèques de samples.
Le contrôle fin est le talon d’Achille de la génération par IA. Un prompt texte peut spécifier « un moteur de voiture qui démarre », mais pas « avec un léger raté à 0,3 seconde et une résonance métallique à 2 kHz ». Pour ce niveau de précision, la référence audio — fournir un échantillon existant dont on veut imiter le style — est plus efficace. L’IA peut copier le style, pas les détails micro-temporels.
C’est ici que les NPU entrent en jeu. Comme l’explique Les Numériques, le NPU (Neural Processing Unit) est un processeur spécialisé conçu pour accélérer les calculs liés aux réseaux de neurones. Présent dans les smartphones, les PC portables et les objets connectés, il permet d’exécuter des modèles d’IA localement, sans passer par le cloud. Pour l’audio, cela change tout : la réduction de bruit, la séparation de sources ou la génération en temps réel deviennent possibles avec une latence négligeable. Les dernières puces AMD Ryzen AI 400, équipées du NPU XDNA 2, offrent ainsi 55 à 60 TOPS de puissance de calcul, une latence de réduction de bruit inférieure à 2 millisecondes et un gain de rapport signal sur bruit de +42 à +48 dB. Des performances qui permettent de traiter l’audio en direct, dans le studio comme sur le terrain.
Microsoft a d’ailleurs intégré le suivi du NPU directement dans Windows 11 : le Gestionnaire des tâches affiche désormais des colonnes « NPU » et « Moteur NPU » dans les onglets Processus, Utilisateurs et Détails, ainsi que la mémoire NPU dédiée et partagée, comme le détaille IT-Connect. Une manière de vérifier que les applications utilisent bien le NPU plutôt que le CPU — un enjeu de performance crucial pour les flux audio temps réel.
Le mixage et le mastering par IA : Sequoia 2026.5 et le Spatial Panner
La génération n’est qu’une facette de la révolution. Le mixage et le mastering, eux aussi, se transforment. L’annonce la plus marquante de l’été 2026 vient de Boris FX avec Sequoia 2026.5, publié le 6 août. Le Spatial Panner unifié permet de piloter simultanément les formats stéréo, surround et immersif — du mono au 22.2, en passant par Dolby Atmos et ADM — depuis un seul espace de travail. Fini le changement d’outil en pleine session : une seule manipulation met à jour toutes les versions du mix, avec la possibilité d’affiner chaque format individuellement. C’est une avancée majeure pour les ingénieurs du son qui doivent livrer des versions multiples (stéréo, 5.1, Atmos) d’un même projet.
L’IA entre également dans la danse avec CrumplePop SoundApp, intégré à Sequoia, qui utilise l’apprentissage automatique pour nettoyer et améliorer les dialogues. Combiné au Spatial Panner, il dessine le nouveau visage du mixage : l’IA s’occupe des tâches répétitives (dénoisage, réparation), pendant que l’ingénieur se concentre sur la créativité spatiale.
Réglementation : l’étiquetage devient obligatoire
Cette transformation technologique s’accompagne d’un cadre réglementaire inédit. L’AI Act européen impose désormais l’étiquetage des contenus générés par IA : depuis le 2 août 2026 pour les nouveaux modèles, et à partir du 2 décembre 2026 pour les modèles existants. Concrètement, les morceaux générés ou co-créés par IA doivent être signalés via des métadonnées et des icônes visuelles. Le casse-tête du mixage hybride — où l’IA n’a traité qu’une partie du signal — reste ouvert, comme le montre notre dossier sur l’étiquetage volontaire. Mais une chose est sûre : la transparence devient une obligation légale, pas une option marketing.
Conclusion : l’IA comme infrastructure, pas comme substitut
Au terme de ce tour d’horizon, une évidence s’impose : l’IA n’a pas « remplacé » les bibliothèques de samples ni les ingénieurs du son. Elle est devenue l’infrastructure sur laquelle reposent désormais la création, le mixage et le mastering. Les outils se multiplient, les prix baissent, les NPU rendent le traitement local et temps réel, et la réglementation encadre enfin les usages. Pour les professionnels du son, la question n’est plus de savoir s’il faut adopter l’IA, mais comment l’intégrer intelligemment dans des workflows où le jugement humain reste irremplaçable — surtout quand il s’agit de décider ce qui mérite d’être entendu.
Sources
- Euronews — Étude SubmitHub : près de 40 % de la musique de juillet 2026 a utilisé l’IA
- The Next Web — Adobe Firefly can now generate music, speech and sound effects
- CNET — No Mic Needed: Adobe’s AI Audio Tools
- 9to5Mac — Adobe Firefly’s music, voiceover, and sound effects tools now generally available
- SiliconANGLE — Adobe expands generative AI audio
- Audiofanzine — sonible publie smart:chain
- Boris FX — Sequoia 2026.5: One Panner, Every Format
- ElevenLabs — Blog officiel
- MiniMax — Audio & Music
- cavn.ai — HappyShrimp AI Music Generator Demo
- musicmaker.im — Mureka V9.5
- Les Numériques — Qu’est-ce qu’un NPU ?
- IT-Connect — Windows 11 Gestionnaire des tâches : surveillance NPU
Article recherché et rédigé automatiquement · Magazine Electrosens