
 Magazine LLM Opensource · 13 October 2026
Qwen3, Qwen3.5, Qwen3.6, Qwen3.8-Max : anatomie d’une famille open source qui a changé la donne en 2026
Depuis le 29 avril 2025, Qwen3 d’Alibaba Cloud s’est imposé comme une référence de l’open source. Architecture Mixture of Experts, contexte 128K, licence Apache 2.0 : les promesses étaient nombreuses. Mais en 2026, l’écosystème a été bouleversé à plusieurs reprises : d’abord par Qwen3.5, une famille de huit modèles nativement multimodaux dont le 9B détrône des géants treize fois plus gros, puis par Qwen3.6, une mise à jour orientée codage agentique et stabilité, et enfin par Qwen3.8-Max, un modèle de 2,4 billions de paramètres aux poids ouverts annoncés, capable de travailler en autonomie pendant seize jours et vendu à un prix cassé. Mais à l’automne 2026, la concurrence s’est brutalement réveillée : Mistral Large 4 « Le Chonk », Reflection Beam et Cloudflare Clef rebattent les cartes. Plongée dans les innovations architecturales, les benchmarks vérifiés et les outils de fine-tuning qui rendent ces modèles accessibles sur du matériel grand public.
Pourquoi Qwen3 (et sa descendance) fait trembler l’open source en 2026
L’année 2025 a marqué un tournant dans l’écosystème des grands modèles de langage open source. Alibaba Cloud, déjà connu pour sa famille Qwen, a dévoilé Qwen3 le 29 avril 2025 sous licence Apache 2.0 – une licence permissive autorisant une utilisation commerciale sans restriction. Cette annonce a immédiatement attiré l’attention des développeurs et des entreprises, car Qwen3 promettait de concilier performances de pointe et accessibilité sur du matériel grand public. Le dépôt GitHub officiel et la collection Hugging Face restent les points d’entrée de référence pour récupérer les poids et la documentation.
Mais l’histoire ne s’est pas arrêtée là. Le 16 février 2026, Alibaba a publié Qwen3.5, une famille de huit modèles open-weight allant de 0,8B à 397B de paramètres, tous sous licence Apache 2.0, tous nativement multimodaux (texte, image, vidéo), et reposant sur une architecture hybride mêlant attention linéaire et transformeurs classiques. Le déploiement s’est échelonné entre le 16 février et le 2 mars 2026, comme le détaille Qwen-AI.com. Parmi eux, Qwen3.5-9B, un modèle de seulement 9 milliards de paramètres, surpasse selon RoboActu le modèle open source d’OpenAI GPT-oss-120B (120 milliards de paramètres) sur plusieurs benchmarks clés, tout en pouvant fonctionner sur un simple ordinateur portable. C’est un rapport de taille de 13 pour 1.
Puis, dans le courant du printemps 2026, Alibaba a déployé Qwen3.6, une mise à jour intermédiaire qui, selon OpenLM.ai, « priorise la stabilité et l’utilité réelle » en réponse aux retours de la communauté. Cette version améliore notamment le codage agentique (gestion des workflows front-end et raisonnement au niveau du dépôt) et introduit une fonctionnalité de préservation de la pensée (thinking preservation) qui conserve le contexte de raisonnement à travers l’historique de conversation, réduisant les coûts de développement itératif.
Et l’histoire continue. Le 3 août 2026, après deux semaines de préversion, Alibaba a dévoilé Qwen3.8-Max, un modèle de 2,4 billions de paramètres avec une fenêtre de contexte d’un million de tokens, dont les poids ouverts sont annoncés pour une sortie imminente aux côtés d’un Qwen3.8-27B, selon Open Source For You et SiliconANGLE. Ce nouveau géant prétend travailler en autonomie pendant plusieurs jours – Alibaba a démontré un projet de codage de 16 jours sans intervention humaine – une capacité jusqu’ici presque exclusive aux modèles propriétaires les plus avancés, comme le rapporte Génération NT.
Mais le plus spectaculaire est peut-être le prix. Alibaba a fixé le tarif de Qwen3.8-Max à 2 dollars par million de tokens en entrée et 6 dollars par million en sortie via Model Studio, selon TechRepublic et Forbes. C’est 60 % moins cher que GPT-5.6 Sol pour l’entrée non cachée et 80 % moins cher pour la sortie. Une guerre des prix qui rappelle celle déclenchée par DeepSeek V4, dont le prix d’entrée est tombé à 0,14 $/M tokens en août 2026.
L’enjeu est crucial : jusqu’alors, fine-tuner un modèle de plusieurs dizaines de milliards de paramètres nécessitait des clusters de GPU professionnels (A100, H100). Avec Qwen3.5 et ses successeurs, la promesse est de pouvoir adapter un modèle performant sur une simple RTX 4090, voire une RTX 3060 grâce aux techniques de quantification. Mais cette promesse tient-elle vraiment la route ? Pour le savoir, il faut examiner en détail l’architecture, les benchmarks disponibles, et surtout l’écosystème de fine-tuning qui s’est constitué autour de cette famille.
Architecture : de Qwen3 à Qwen3.8, le saut vers l’hybride, la multimodalité native et l’échelle
Qwen3 n’était pas une simple mise à jour incrémentale de Qwen2.5. Le rapport technique arXiv 2505.09388, cité par DEV-AI, révélait des choix architecturaux radicaux. Qwen3.5 va beaucoup plus loin, avec une refonte complète, et Qwen3.8-Max pousse l’échelle à un niveau inédit.
Qwen3 : les fondations MoE
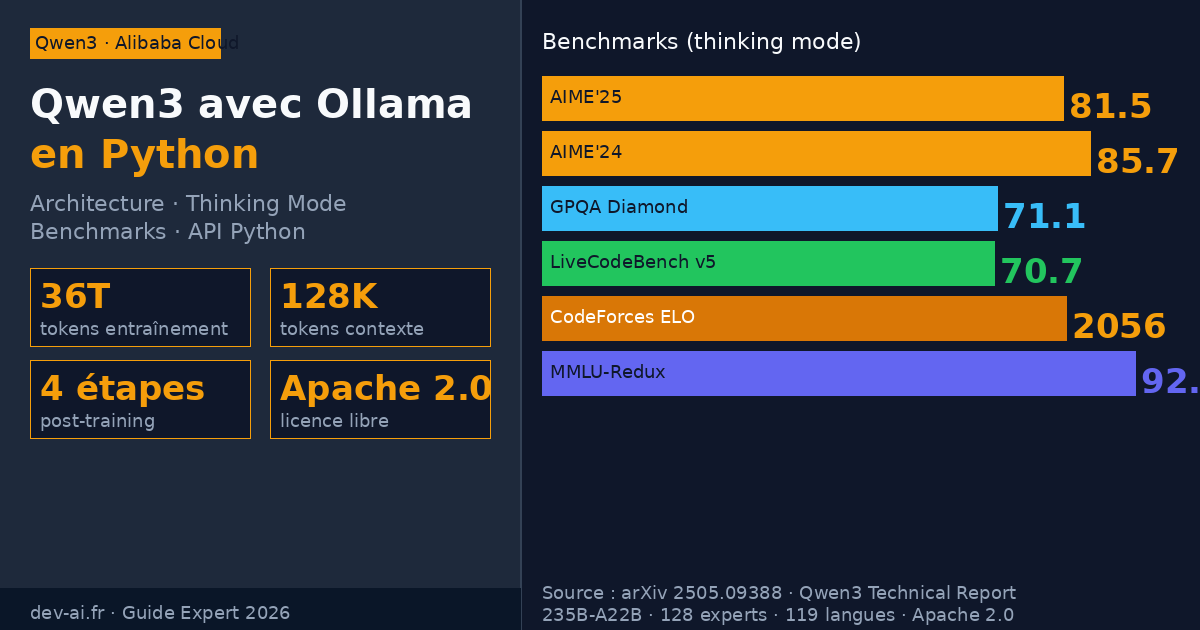
Qwen3 a été pré-entraîné sur 36 trillions de tokens, soit le double des 18T de Qwen2.5. Cette quantité de données, couplée à un support de 119 langues (contre 29 pour Qwen2.5), en faisait l’un des modèles les plus multilingues jamais publiés à l’époque. Les versions MoE de Qwen3 (Qwen3-30B-A3B et Qwen3-235B-A22B) utilisaient 128 experts avec 8 experts actifs par token, sans experts partagés. Cette sparse activation réduisait considérablement le coût de calcul en inférence : seuls 3,3 milliards de paramètres actifs pour la version 30B, et 22 milliards pour la version 235B.
| Modèle | Paramètres totaux | Paramètres actifs | Experts | Experts actifs/token |
|---|---|---|---|---|
| Qwen3-30B-A3B | 30,5B | ~3,3B | 128 | 8 |
| Qwen3-235B-A22B | 235B | ~22B | 128 | 8 |
Qwen3.5 : l’architecture hybride Gated Delta + MoE
Qwen3.5 marque une rupture. Selon le dépôt GitHub officiel et le guide complet de Qwen-AI.com, la famille repose sur une architecture hybride combinant des Gated Delta Networks (une forme d’attention linéaire plus efficace en mémoire) avec un Mixture-of-Experts parcimonieux. Résultat : moins de calculs pour de meilleures performances, un gain direct en latence et en coût d’inférence. L’inférence long-contexte est dramatiquement accélérée – jusqu’à 19x à 256K tokens selon Qwen-AI.com.
La famille complète compte huit modèles open-weight :
| Modèle | Type | Usage recommandé |
|---|---|---|
| Qwen3.5-0.8B | Dense | Edge, embarqué |
| Qwen3.5-2B | Dense | Mobile, chat, résumé |
| Qwen3.5-4B | Dense | Agents légers, contexte 262K |
| Qwen3.5-9B | Dense | Raisonnement, laptop standard |
| Qwen3.5-27B | Dense | Écriture créative, raisonnement complexe |
| Qwen3.5-35B-A3B | MoE | 196 tok/s sur RTX 4090 |
| Qwen3.5-122B-A10B | MoE | Qualité/rapidité, serveur |
| Qwen3.5-397B-A17B | MoE | Flagship, multi-GPU |
La multimodalité native : la vraie révolution
Ce qui distingue le plus Qwen3.5 de la génération précédente, c’est la fusion précoce : plutôt que d’ajouter un encodeur visuel sur un modèle texte existant (comme c’était le cas pour Qwen3-VL), Alibaba a entraîné Qwen3.5 avec des tokens texte et image mélangés dès le départ. Chaque modèle – même le 0.8B – gère les images et les vidéos nativement, sans variante « VL » séparée. Concrètement, le modèle 4B peut lire des éléments d’interface, compter des objets dans une vidéo ou analyser un document, des tâches qui nécessitaient jusqu’ici des modèles dix fois plus grands, rapporte RoboActu.
Le GitHub officiel confirme également une couverture linguistique étendue à 201 langues et dialectes, contre 119 pour Qwen3. L’entraînement a par ailleurs intégré du RL scalable dans des environnements à un million d’agents, avec des distributions de tâches progressivement complexes, pour une robustesse accrue en conditions réelles.
Qwen3.6 : la stabilité et le codage agentique
Entre Qwen3.5 et Qwen3.8, Alibaba a publié Qwen3.6, une version qui ne révolutionne pas l’architecture mais qui affine l’expérience développeur. Selon OpenLM.ai, Qwen3.6 « priorise la stabilité et l’utilité réelle » avec deux améliorations majeures :
- Agentic Coding : le modèle gère les workflows front-end et le raisonnement au niveau du dépôt avec plus de fluidité et de précision.
- Thinking Preservation : une nouvelle fonctionnalité qui conserve le contexte de raisonnement à travers l’historique de conversation, ce qui réduit les coûts lors des itérations de développement.
Cette version est un pont pragmatique entre l’innovation de Qwen3.5 et l’échelle de Qwen3.8, répondant directement aux retours de la communauté.
Qwen3.8-Max : le géant d’août 2026
Annoncé le 3 août 2026, Qwen3.8-Max pousse la logique à l’extrême. Selon Open Source For You, MarkTechPost et le blog officiel Qwen, il s’agit du modèle le plus capable de la famille Qwen à ce jour, avec :
- 2,4 billions de paramètres au total, soit environ 7 fois plus que le plus grand Qwen3.5 (397B).
- 95 milliards de paramètres actifs par requête (architecture MoE).
- Fenêtre de contexte de 1 million de tokens (plus de 200 pages de texte ou environ 100 heures de vidéo en une seule requête).
- Sortie maximale de 131 000 tokens.
- Poids ouverts annoncés pour la semaine suivant l’annonce, aux côtés du plus petit Qwen3.8-27B, plus efficace en matériel.
- Prix de lancement : 2 $/M tokens en entrée, 6 $/M en sortie via Model Studio.
Alibaba n’a pas divulgué l’architecture complète, mais les versions précédentes utilisaient le mécanisme d’attention Gated DeltaNet, qui offre une mise à l’échelle linéaire pour réduire la croissance du calcul et de la mémoire lors de longs contextes. Nvidia a précédemment souligné que cette approche combine la règle de mise à jour gated et la règle delta pour améliorer le traitement long-contexte.
En interne, Alibaba a démontré que Qwen3.8-Max a complété un projet de codage de 16 jours sans intervention humaine et un workflow d’optimisation de conception de puces impliquant plus de 500 étapes. Le modèle est disponible immédiatement via Alibaba Cloud.
Selon VentureBeat, Qwen3.8-Max revendique des performances supérieures à GPT-5.6 Sol Max et Claude Fable 5 sur l’usage agentique d’ordinateur (agentic computer use). Une affirmation audacieuse que Informatique News invite toutefois à nuancer : le modèle « bouscule la frontière de l’IA sans encore renverser les leaders ». Le véritable impact se joue ailleurs, dans le retour d’Alibaba aux poids ouverts et dans la pression économique exercée par l’IA chinoise sur les laboratoires américains.
Benchmarks : ce que les chiffres vérifiés disent vraiment (octobre 2026)
Les performances brutes de Qwen3 étaient souvent citées avec prudence. Le blog chats-llm.com avançait un score de 88% sur MMLU et 92% sur HumanEval. Depuis, des benchmarks indépendants ont émergé, notamment pour Qwen3.5, et les chiffres sont plus solides.
Qwen3.5-9B : le petit qui bat les géants
Les résultats publiés par l’équipe Qwen, relayés par RoboActu, sont sans appel : le Qwen3.5-9B rivalise avec des modèles treize fois plus gros sur plusieurs benchmarks clés, tout en tenant sur un ordinateur portable. C’est cette efficacité par paramètre qui a fait de la famille Qwen3.5 une référence pour les déploiements contraints en ressources.
Qwen3.8-Max : un géant qui n’active qu’une partie de ses muscles
Comme le rappelle Informatique News, le chiffre de 2 400 milliards de paramètres doit être relativisé par le principe même des architectures MoE : environ 95 milliards « seulement » sont mobilisés pour chaque requête. Le routage vers des sous-réseaux spécialisés permet de conserver une architecture gigantesque sans supporter à chaque inférence son coût intégral. C’est ce qui explique le tarif agressif de 2 $/M tokens en entrée.
Le contexte concurrentiel d’octobre 2026 : le retour de bâle
Il serait malhonnête de présenter Qwen3.8-Max comme un rouleau compresseur sans opposition. En l’espace de quelques jours début octobre 2026, l’écosystème open-weight a connu une effervescence rare :
- Mistral Large 4 « Le Chonk » (6-7 octobre 2026) : le laboratoire français a dévoilé un modèle de plus de 1 000 milliards de paramètres, dont 49 milliards activés par réponse, entièrement entraîné en Europe, multimodal et doté de capacités agentiques. Selon Korben et Le Monde Informatique, les poids sont prévus pour le 27 octobre 2026, avec un aperçu public ouvert depuis le 6 octobre. Wired résume l’ambition : Mistral veut démontrer qu’il est « still in the race » et que « Le Chonk » est la meilleure offre à poids ouverts hors de Chine. ZDNET souligne son positionnement en cybersécurité, tandis que CNET insiste sur son usage pour la cyberdéfense, l’industrie et la finance. Pour Numerama, c’est un « grand retour » après des mois où Mistral était donné distancé par les modèles open source chinois.
- Reflection Beam (5-6 octobre 2026) : Reflection AI, soutenu par Nvidia, a dévoilé son premier modèle à poids ouverts, un MoE de 501 milliards de paramètres dont 23 milliards actifs, orienté code et raisonnement. Selon SiliconANGLE et TechCrunch, Beam revendique 3 à 4 fois moins de calcul d’inférence que ses rivaux, mais Help Net Security note qu’il reste en retrait des meilleurs modèles ouverts sur les tests de codage. Les poids sont attendus plus tard dans le mois.
- Cloudflare Clef (2-3 octobre 2026) : Cloudflare a publié sous Apache 2.0 deux modèles de décision, Clef 27B et Clef-flash 9B, avec un score BFCL annoncé de 98,76 et une latence de 38,8 ms contre 524 ms pour Jev selon ses propres mesures. Un positionnement radicalement différent : Clef ne rédige pas de prose, il renvoie une distribution typée sur des options fournies.
Autrement dit, la domination de la famille Qwen sur l’open source, réelle au premier semestre 2026, est désormais contestée sur plusieurs fronts : l’échelle (Mistral), l’efficacité de calcul (Reflection) et la spécialisation décisionnelle (Cloudflare). Qwen3.8-Max reste un jalon, mais il n’est plus seul au sommet.
Fine-tuning et quantification : l’écosystème qui rend Qwen3.5 accessible
C’est peut-être là que la famille Qwen3.5 a eu le plus d’impact concret pour les praticiens. Le fine-tuning de modèles Mixture-of-Experts géants sur du matériel grand public a longtemps relevé de l’utopie. En 2026, l’écosystème a comblé une partie du fossé.
Le cauchemar de la VRAM
Les MoE affament les GPU grand public : un modèle de 122B de paramètres totaux ne tient pas en mémoire vive d’une RTX 4090 (24 Go) sans quantification agressive. C’est précisément le problème que résout la quantification dynamique. Selon nos confrères du magazine, Unsloth Dynamic 3.0 GGUFs pousse la quantification dynamique à un niveau inédit : au lieu d’appliquer un même niveau de précision à toutes les couches, l’approche adapte le format (Q2, Q3, Q4, Q5, Q6, Q8) couche par couche en fonction de leur sensibilité. Résultat : des modèles MoE de plusieurs dizaines de milliards de paramètres deviennent chargeables sur des configurations grand public, avec une perte de qualité mesurable mais souvent acceptable.
Unsloth vs Axolotl vs TRL vs LLaMA-Factory
Le match des frameworks de fine-tuning fait désormais partie du paysage. Unsloth se distingue par ses optimisations mémoire et sa prise en charge native des architectures récentes, Axolotl par sa flexibilité de configuration, TRL par son intégration à l’écosystème Hugging Face, et LLaMA-Factory par son interface unifiée. Pour la famille Qwen, la documentation officielle recommande explicitement Axolotl et LLaMA-Factory pour le post-training (SFT et RLHF), ce qui en fait des choix sûrs pour qui veut reproduire les recettes d’Alibaba.
Le guide pratique
Pour fine-tuner un Qwen3.5-9B sur une RTX 4090, la recette qui se dégage de l’écosystème 2026 combine : quantification 4 bits (QLoRA), gradient checkpointing, et un framework optimisé mémoire comme Unsloth. Pour les MoE plus gros (35B-A3B, 122B-A10B), il faut soit monter en RAM unifiée (les plateformes AMD Strix Halo offrent 64 à 128 Go de mémoire unifiée), soit se contenter d’inférence quantifiée sans fine-tuning complet. La promesse « fine-tuner un modèle performant sur une RTX 3060 » tient pour les modèles denses jusqu’à ~9B ; au-delà, la quantification permet surtout l’inférence, pas l’entraînement.
Serving en production : vLLM, SGLang, TensorRT-LLM et le test du MoE
Un modèle n’est utile que s’il tourne. En 2026, trois moteurs d’inférence dominent l’open source : vLLM (Berkeley), SGLang (Stanford) et TensorRT-LLM (Nvidia). Selon l’analyse de nos confrères, les chiffres sur H100 se situent autour de 1 850 tok/s pour vLLM, 1 920 tok/s pour SGLang et 2 100 tok/s pour TensorRT-LLM sur des charges de référence. La vraie différence se joue sur les MoE : PagedAttention (vLLM), RadixAttention (SGLang) et le moteur compilé de Nvidia n’ont pas la même efficacité face au routage d’experts. C’est précisément là que Qwen3.8-Max, GLM-5.3, DeepSeek V4 et Hy4 changent la donne : leur nature MoE récompense les moteurs capables de gérer finement le cache KV et le partage de préfixes.
Pour un déploiement Qwen3.5-35B-A3B sur une seule RTX 4090, la communauté rapporte des débits de l’ordre de 196 tok/s, un chiffre qui rend le self-hosting crédible pour des usages individuels ou de petite équipe. Au-delà, il faut passer au multi-GPU, et la facture d’infrastructure redevient le facteur limitant.
L’écosystème open source en octobre 2026 : ce qui a changé pour Qwen
La famille Qwen n’évolue plus dans un vide. Trois dynamiques structurent désormais le paysage :
-
La fin de l’hégémonie chinoise sur l’open-weight haut de gamme. Avec Mistral Large 4 « Le Chonk » (1 000 milliards de paramètres, 49 milliards actifs, poids prévus le 27 octobre) et Reflection Beam (501B/23B actifs), l’Europe et les États-Unis reviennent dans la course. Euronews résume l’enjeu : Mistral mise sur la « souveraineté » européenne dans une course États-Unis-Chine.
-
La spécialisation plutôt que la course au gigantisme. Cloudflare Clef (27B et 9B) ne cherche pas à battre Qwen3.8-Max sur le raisonnement général : il renvoie des distributions typées en 38,8 ms pour des tâches de décision. C’est une autre façon de gagner.
-
La pression sur les prix. Le tarif de Qwen3.8-Max (2 $/6 $ par million de tokens) a été immédiatement comparé à celui de DeepSeek V4 (0,14 $/M en entrée). La question n’est plus « quel modèle est le meilleur ? » mais « quel modèle offre le meilleur rapport qualité/coût pour ma tâche ? ».
Pour les praticiens, la conséquence est simple : la famille Qwen3 reste un socle incontournable – licence Apache 2.0, multimodalité native, écosystème de fine-tuning mature – mais il n’est plus le seul choix rationnel. Un développeur qui construit un agent de codage regardera désormais GLM-5.3 (cybersécurité, SWE-Bench Pro), un déployeur souverain européen regardera Mistral Large 4, et un spécialiste de la décision automatisée regardera Clef.
Conclusion : un jalon, pas une fin
Qwen3, Qwen3.5, Qwen3.6 et Qwen3.8-Max racontent une trajectoire : celle d’un laboratoire chinois qui, en dix-huit mois, a transformé l’open source d’une alternative de second rang en une frontière crédible. La multimodalité native dès le 0.8B, l’architecture hybride Gated Delta + MoE, la fenêtre d’un million de tokens et le prix cassé de Qwen3.8-Max sont des jalons réels.
Mais octobre 2026 marque aussi la fin d’une certaine insouciance. Mistral, Reflection et Cloudflare rappellent que l’open source n’est pas un monopole, et que la prochaine bataille se jouera moins sur le nombre de paramètres que sur l’efficacité par token, la spécialisation et le coût réel d’inférence. Pour ceux qui fine-tunent et déploient, la bonne nouvelle est que l’écosystème d’outils – Unsloth, vLLM, SGLang, Axolotl, LLaMA-Factory – n’a jamais été aussi mature. La mauvaise est qu’il faut désormais choisir, et choisir vite.
Sources

- Qwen3 – blog officiel
- Qwen3.8-Max – blog officiel Qwen
- QwenLM/Qwen3 – dépôt GitHub officiel
- Qwen3 – collection Hugging Face
- Qwen3.8 – OpenLM.ai
- Qwen3.8-Max bouscule la frontière de l’IA sans encore renverser les leaders – Informatique News
- Qwen3.8-Max : cette nouvelle IA open source a franchi une frontière – Les Numériques
- Alibaba debuts frontier-scale open source Qwen3.8-Max – Open Source For You
- Alibaba debuts Qwen3.8-Max model with 2.4T parameters – SiliconANGLE
- Alibaba Qwen releases Qwen3.8-Max – MarkTechPost
- Qwen3.8-Max arrives with a bold claim – VentureBeat
- Alibaba’s Qwen3.8-Max prices frontier AI at $2 per million tokens – Forbes
- Alibaba Qwen3.8-Max pricing and open weights – TechRepublic
- La nouvelle IA Qwen3.8-Max d’Alibaba va-t-elle détrôner Claude et ChatGPT ? – Génération NT
- Qwen3.5 – guide complet – Qwen-AI.com
- Qwen3.5 d’Alibaba : des petits modèles IA qui surpassent des géants 13 fois plus grands – RoboActu
- Qwen3.5 – dépôt GitHub
- Qwen3 – Ollama, Python – DEV-AI
- Qwen3 release – chats-llm.com
- Documentation officielle Qwen
- Mistral Large 4, le modèle à 1 000 milliards de paramètres surnommé Le Chonk – Korben
- Mistral dévoile Large 4, un modèle à plus de 1 000 milliards de paramètres – Le Monde Informatique
- Mistral’s New ‘Le Chonk’ AI Model Is Big, Open and Built for Agents – CNET
- Mistral Says Its New AI Model ‘Le Chonk’ Is the Best Open-Weight Offering Outside of China – Wired
- Mistral’s new Le Chonk model brings AI cybersecurity to your business – ZDNET
- Mistral relance la France dans la course à l’IA et dévoile « Le Chonk » – Numerama
- Ce qu’il faut savoir sur ML4 de Mistral – Euronews
- Reflection AI debuts open-source Beam model with 501B parameters – SiliconANGLE
- Reflection debuts Beam, an open-weight AI model – TechCrunch
- Reflection’s Beam trails top open models on coding tests – Help Net Security
- Cloudflare Clef : réponse ouverte 13 fois plus rapide – ai-stat.ru
- Clef-Flash vs Qwen3-8B : probabilités vs prose – orcarouter.ai
Article recherché et rédigé automatiquement · Magazine Electrosens