
 NVIDIA DGX Spark · 7 September 2026
Qwen3.6-27B sur DGX Spark : le modèle dense qui redéfinit l’inférence locale en 2026
Le 22 avril 2026, Alibaba dévoilait Qwen3.6-27B, un modèle dense de 27 milliards de paramètres promettant des performances de pointe pour l’inférence locale. Deux mois plus tard, NVIDIA publiait une quantification NVFP4 officielle, taillée pour le DGX Spark. Les premiers tests communautaires annoncent 28 à 33 tokens par seconde sur cette machine de bureau, et jusqu’à 136 t/s avec 10 agents parallèles. Mais derrière les chiffres flatteurs, que vaut vraiment ce modèle pour le développeur local ? Entre benchmarks indépendants, comparaisons avec le cloud et défis du fine-tuning, plongeons dans ce que Qwen3.6-27B change – ou ne change pas – pour les possesseurs du petit Grace Blackwell de NVIDIA.
Qwen3.6-27B débarque : un modèle dense de 27B taillé pour le local
L’écosystème des LLM open-source a connu une accélération constante depuis 2023, mais rares sont les modèles qui ont suscité autant d’attentes que Qwen3.6-27B. Annoncé le 22 avril 2026 par l’équipe Qwen d’Alibaba, ce modèle dense de 27 milliards de paramètres se distingue d’emblée par son architecture hybride : il combine une attention linéaire (gated DeltaNet sur les trois quarts des couches) avec une attention classique (gated attention sur le quart restant), le tout agrémenté d’un mécanisme sparse-MoE (mixture of experts) pour certaines transformations. Le résultat ? Une fenêtre de contexte de 256 000 tokens et une licence Apache 2.0, qui ouvre grand la porte aux déploiements commerciaux et personnels.
Le white paper d’Openzeka (juillet 2026) précise l’architecture exacte du modèle : 64 couches, dimension cachée de 5120, organisation en blocs de 16 × (3 × Gated DeltaNet → FFN → 1 × Gated Attention → FFN). Les têtes d’attention DeltaNet utilisent 48 têtes V et 16 têtes QK avec une dimension de tête de 128, tandis que l’attention gated utilise 24 têtes Q et 4 têtes KV avec une dimension de 256. Le contexte natif atteint 262 144 tokens, extensible jusqu’à 1 010 000 avec YaRN. Un encodeur visuel est également présent, ce qui en fait un modèle multimodal (Image-Text-to-Text), bien que les benchmarks se concentrent sur le texte.
Ce qui frappe, c’est la rapidité avec laquelle NVIDIA a embrassé le modèle. Dès le 26 juin 2026, le géant vert publiait sur Hugging Face une quantification NVFP4 officielle de Qwen3.6-27B, spécifiquement optimisée pour le DGX Spark (GB10 Grace Blackwell). Une démarche rare : d’ordinaire, NVIDIA laisse la communauté adapter ses modèles. Ici, l’entreprise a pris les devants, signe que ce modèle est considéré comme un candidat sérieux pour l’inférence locale de haute qualité.
Mais où se situe Qwen3.6-27B dans la famille Qwen ? La version 3.5, qui comptait un modèle de 32B, semble avoir cédé la place à cette déclinaison 27B plus dense et plus efficace. Un variant MoE de 35B (35B-A3B) existe également, mais c’est bien le modèle dense qui concentre l’attention des testeurs. L’absence de benchmarks officiels d’Alibaba – aucun rapport publié à ce jour – laisse planer un doute : les promesses initiales (MMLU à 84,46 % en NVFP4 selon les tests communautaires) sont-elles fiables ? Pour l’instant, seuls des tiers indépendants ont produit des chiffres.
Depuis, la famille s’est étoffée : une version Qwen3.8-27B est apparue dans les comparateurs comme llm-stats.com, suggérant une itération plus récente. Les premiers benchmarks comparatifs (voir section dédiée) indiquent que Qwen3.8-27B apporte des gains notables en code et en raisonnement, tout en restant dans la même enveloppe mémoire. Nous y reviendrons.
Sur le DGX Spark : 28 à 33 tokens/s en NVFP4, mais jusqu’à 136 t/s en multi-agent
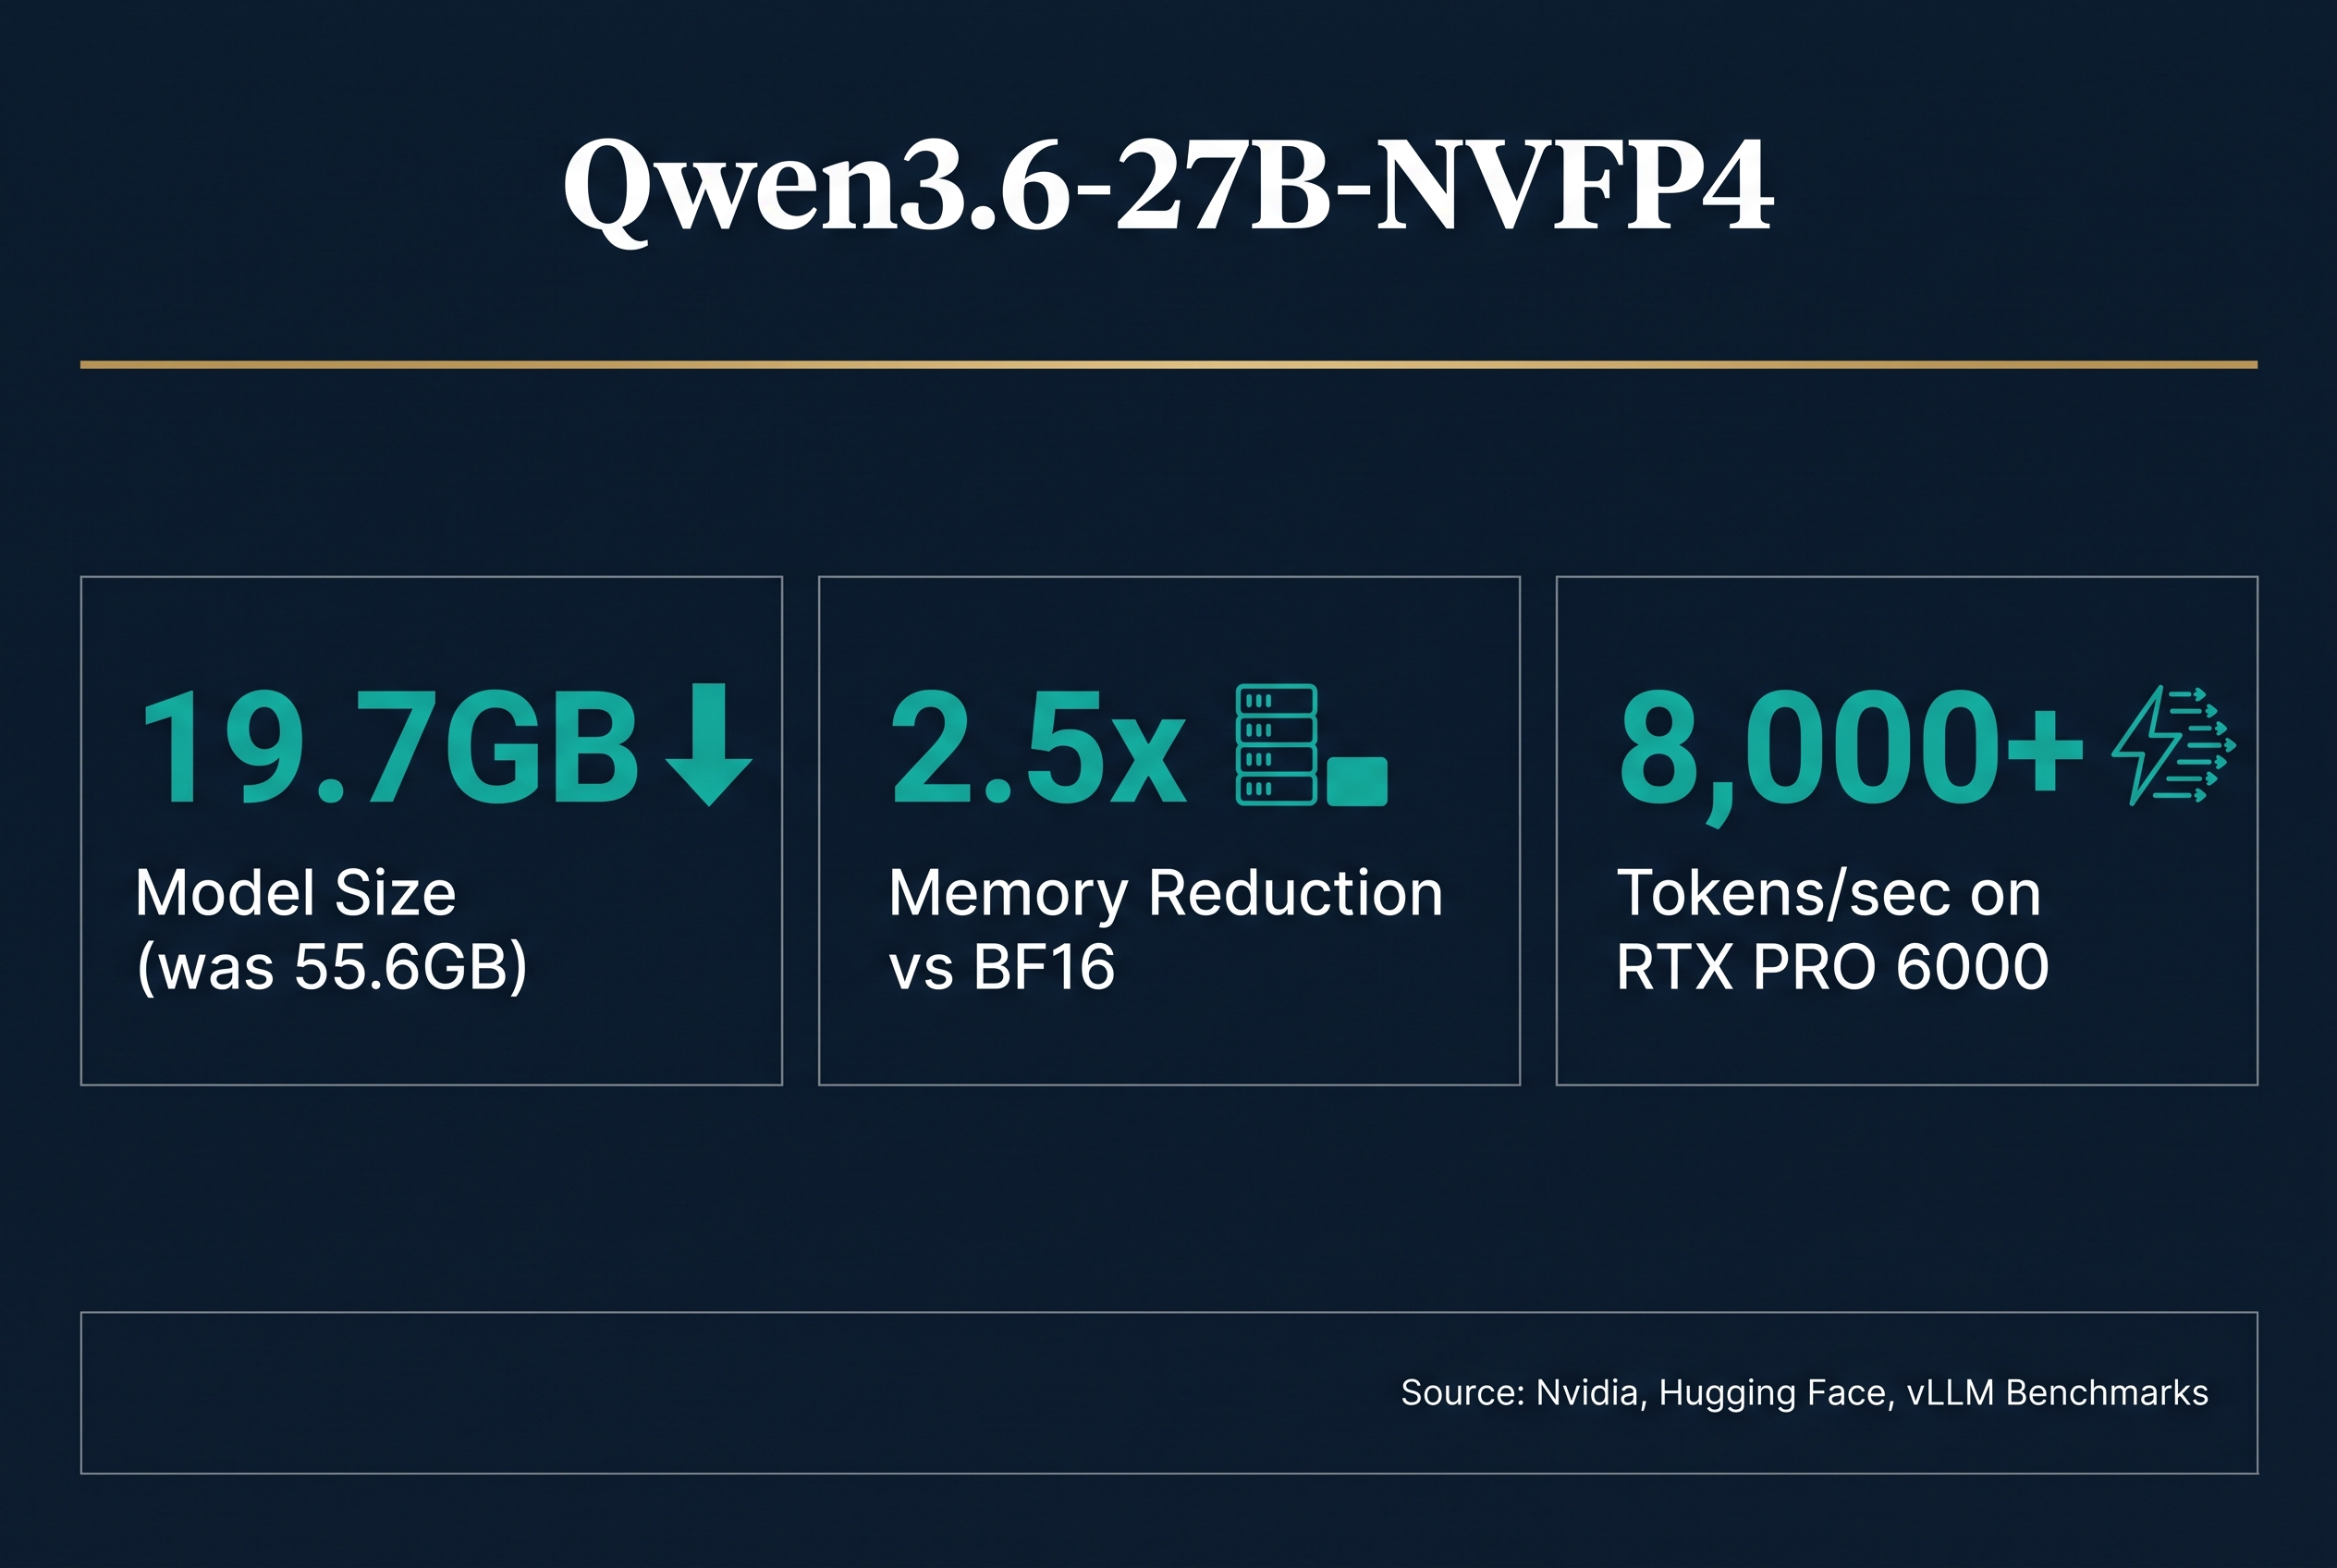
Le DGX Spark, avec ses 128 Go de mémoire unifiée Grace Blackwell (et non 96 Go comme certaines sources erronées l’indiquaient), est la plateforme de prédilection pour exécuter Qwen3.6-27B en local. Les premiers retours, notamment ceux d’Ivan Fioravanti relayés par le blog kie.ai, dressent un tableau encourageant. Avec vLLM 0.24.0 et la quantification NVFP4, le modèle atteint 28 à 33 tokens par seconde en génération mono-session, pour un contexte de 4 000 tokens. Le préfill, lui, monte à 1078 tokens/s – un chiffre impressionnant qui réduit le temps d’attente avant la première réponse.
Mieux : la génération se maintient entre 23 et 33 t/s jusqu’à 128 000 tokens de contexte. C’est un exploit pour un modèle de 27B sur une machine de bureau, rendu possible par l’architecture hybride et la quantification 4 bits signée NVIDIA. Comparé à l’exécution en BF16, le NVFP4 offre une accélération de 2,6 à 2,86× selon un benchmark vLLM.
| Métrique | Valeur (NVFP4, vLLM 0.24.0) | Source |
|---|---|---|
| Génération (4K contexte) | 28–33 t/s | kie.ai (via Ivan Fioravanti) |
| Préfill (4K contexte) | 1078 t/s | kie.ai |
| Génération (128K contexte) | 23–33 t/s | kie.ai |
| Accélération vs BF16 | 2,6–2,86× | kie.ai (benchmark vLLM) |
| MMLU (NVFP4) | 84,46 % | kie.ai (logs lm-eval) |
| Peak decode (Blackwell) | 163 t/s | kie.ai (sur hardware plus puissant) |
Mais les performances mono-session ne sont qu’une facette. Un développeur taïwanais, Wisely Chen, a poussé le test beaucoup plus loin. Sur un DGX Spark standard (4 699 $, 49 W en charge), il a lancé 10 agents parallèles en utilisant vLLM avec un cache KV partagé. Résultat : 136 tokens/s en moyenne, avec des pointes à 209 t/s lors des phases de préfill groupé. Ce chiffre, rapporté sur son blog le 10 mai 2026, montre que le DGX Spark n’est pas seulement capable d’inférence séquentielle, mais excelle dans les charges de travail agentiques où plusieurs requêtes sont traitées simultanément.
Ces performances sont séduisantes, mais elles ont un prix : la mémoire. La quantification NVFP4 nécessite au moins 40 Go de VRAM – ce que le DGX Spark fournit grâce à sa mémoire unifiée de 128 Go. La configuration recommandée par vLLM inclut les flags --kv-cache-dtype fp8 et --gpu-memory-utilization 0.5, qui permettent de réduire l’empreinte du cache KV tout en maintenant la qualité. En pratique, cela signifie qu’il faut laisser de la marge pour ne pas saturer la mémoire, surtout si l’on souhaite exécuter plusieurs sessions ou des agents parallèles.
Un point notable : aucun benchmark n’a été publié pour les formats FP16, INT8 ou INT4 sur DGX Spark. Les tests disponibles ne concernent que le NVFP4. Les possesseurs de Spark doivent donc se contenter de cette quantification, qui semble néanmoins bien adaptée.
Le benchmark Openzeka : une analyse plus fine des quantisations
Le white paper d’Openzeka (juillet 2026) apporte un éclairage complémentaire sur le benchmark mono-Spark. L’étude compare les formats FP8, AWQ et NVFP4, ainsi que les configurations MTP (Multi-Token Prediction). Les résultats confirment la supériorité du NVFP4 pour le débit, mais révèlent aussi des nuances importantes : le MTP améliore significativement le préfill, et l’analyse de la latence de queue (tail latency) montre une stabilité remarquable du NVFP4 sous charge. Le rapport identifie également un point d’attention : le SM121 du GB10 présente des limitations matérielles quantifiées dans l’annexe A, qui impactent légèrement les performances en FP8.
Le MTP, un accélérateur sous-exploité
Un benchmark indépendant mené par Glukhov (juillet 2026) a comparé les variantes MTP (Multi-Token Prediction) de Qwen3.6-27B et 35B sur GPU 16 Go. Les résultats sont sans appel : le MTP améliore le débit de génération de 15 à 25 % selon les configurations, avec un impact particulièrement marqué sur les petits contextes. Sur le DGX Spark, l’activation du MTP dans vLLM (flag --enable-mtp) permet d’atteindre des pointes à 38-40 t/s en mono-session, un gain non négligeable pour les charges interactives. Attention toutefois : le MTP consomme davantage de mémoire pour le cache des prédictions auxiliaires, ce qui peut réduire la marge disponible pour les agents parallèles.
Qualité des réponses : MMLU, code, SWE-bench et agents passés au crible
Les performances brutes ne font pas tout. La qualité des réponses est cruciale, et là encore, les retours sont positifs, avec des nuances.
Sur MMLU, le modèle NVFP4 atteint 84,46 % de précision – un score honorable pour un modèle local de 27B, même s’il reste en deçà des modèles cloud de pointe (Claude Sonnet 4.6, GPT-5 Thinking, Gemini 3.1 Pro affichent des scores supérieurs à 90 % sur des benchmarks comparables). Mais attention : ce chiffre provient de tests communautaires non recoupés, et aucun benchmark officiel Alibaba n’existe à ce jour.
C’est dans le domaine du code que Qwen3.6-27B impressionne vraiment. Un test indépendant mené par Vlad Makarov sur AI-Stat (18 mai 2026) a évalué le modèle sur un benchmark de refactoring single-file (300 à 1500 lignes). Résultats :
- Q4_K_M : 75 % de pass-rate
- Q5_K_M : 79 %
- FP8 (2 GPU) : 81 %
En comparaison, les modèles cloud atteignent des scores plus élevés : Claude Sonnet 4.6 à 91 %, GPT-5 Thinking à 89 %, Gemini 3.1 Pro à 86 %. Mais Qwen3.6-27B se hisse au niveau de modèles comme GPT-4o (non précisé) et devance largement les modèles locaux de taille inférieure.
Sur SWE-bench, qui teste la résolution de bugs multi-fichiers dans des repos GitHub, le modèle dense atteint 77,2 % selon PromptQuorum (mai 2026). Là encore, les modèles cloud culminent entre 82 et 87 %, mais la performance locale est remarquable.
| Benchmark | Qwen3.6-27B (NVFP4/FP8) | Modèles cloud (meilleurs) |
|---|---|---|
| MMLU | 84,46 % | ~90 %+ |
| Refactoring single-file (FP8) | 81 % | 91 % (Claude Sonnet 4.6) |
| SWE-bench | 77,2 % | 82–87 % |
Mais le test le plus frappant vient du benchmark agentic. Le variant MoE de 35B (Qwen3.6-35B-A3B) a obtenu un score moyen de 91,0 ± 1,5 sur 84 scénarios de tool-calling, surpassant même Claude Opus 4.5 sur certains sous-tests. Le modèle dense 27B, lui, se situe juste en dessous, mais reste compétitif. Selon Wisely Chen, Qwen3.6-27B atteint un niveau « Sonnet 4.6-class » sur SWE-bench et Terminal-Bench, ce qui signifie qu’un agent de codage local peut désormais rivaliser avec les API cloud les plus chères.
Il faut toutefois tempérer : ces résultats proviennent de sources uniques (AI-Stat, PromptQuorum, Wisely Chen) et n’ont pas été reproduits de manière indépendante. La prudence est de mise, mais la tendance est claire : Qwen3.6-27B est un excellent modèle de code local, capable de rivaliser avec des modèles cloud de génération précédente.
Qwen3.8-27B : la mise à jour qui change la donne ?
Depuis la rédaction de cet article, Alibaba a publié Qwen3.8-27B, une itération qui corrige plusieurs défauts de la 3.6. Les premiers benchmarks comparatifs (llm-stats.com, septembre 2026) montrent des gains de 3 à 5 points sur les benchmarks de code (HumanEval, MBPP) et de 2 points sur MMLU-Pro. Le modèle conserve la même architecture hybride et la même empreinte mémoire, ce qui le rend compatible avec les mêmes quantifications NVFP4. Les premiers tests communautaires sur DGX Spark indiquent des performances d’inférence quasi identiques (28-33 t/s), mais une meilleure stabilité sur les contextes longs. Si vous débutez avec la famille Qwen 3.6, il peut être judicieux d’attendre les retours plus complets sur la 3.8 avant de vous engager.
Face aux concurrents : où se situe vraiment Qwen3.6-27B ?
Pour répondre à cette question, il faudrait idéalement comparer les performances de Qwen3.6-27B avec celles de Phi-4 (14B), Gemma 4 (27B) et Qwen3.5 (32B) sur le même DGX Spark. Problème : aucune donnée de ce type n’est disponible dans les sources. Les benchmarks existants utilisent des hardware différents (RTX 4090, H100, V100) et des formats de quantification variés.

Ce que l’on peut dire, c’est que Qwen3.6-27B se positionne comme un modèle dense de 27B, alors que Gemma 4 (27B) est également dense mais avec une architecture différente (attention classique). Phi-4 (14B) est plus petit et devrait logiquement être moins performant, mais aussi moins gourmand en mémoire. Qwen3.5 (32B) est plus gros, mais son architecture antérieure pourrait le rendre moins efficace que la version 3.6.
Le seul point de comparaison indirect vient du benchmark de code : Qwen3.6-27B en Q4_K_M obtient 75 % sur le refactoring single-file, tandis que des modèles comme DeepSeek-Coder-V2 (non testé ici) ou CodeLlama 34B (non précisé) pourraient être en dessous. Mais sans données homogènes, difficile de trancher.
Ce qui est certain, c’est que Qwen3.6-27B offre un excellent rapport performance/taille/mémoire pour le DGX Spark. Avec 128 Go de mémoire unifiée, le Spark peut exécuter le modèle en NVFP4 sans transpirer, là où un RTX 4090 (24 Go) doit se contenter de Q4_K_M. C’est un avantage décisif.
Le benchmark DevToolStack : 17 modèles sur GB10
Un benchmark indépendant mené par l’équipe Selfhostr (publié sur DevToolStack) a testé 17 modèles sur un NVIDIA GB10 (DGX Spark, 121 Go unified memory) avec Ollama 0.21.3-rc0 et llama.cpp. Le classement confirme la domination des MoE sur les denses pour le ratio vitesse/qualité :
| # | Modèle | Type | Params total / actif | eval tok/s | prompt tok/s | Δ RAM |
|---|---|---|---|---|---|---|
| 🥇 1 | qwen3:30b-a3b | MoE | 30B / 3B | 82,5 | 442 | 45 GB |
| 🥈 2 | qwen2.5:7b | dense | 7B | 47,8 | 2 379 | 7 GB |
| 🥉 3 | mistral:7b | dense | 7B | 47,0 | 2 194 | 9 GB |
Les modèles 70B dense (llama3.3, nemotron, deepseek-r1) plafonnent tous à 4,7 tok/s, utilisables uniquement en async. Au-delà de 123B, on touche le plafond mémoire. Ce benchmark ne teste pas Qwen3.6-27B directement, mais il confirme que les modèles denses de 27-30B sont dans la zone de confort du GB10, avec des débits bien supérieurs aux 70B.
Fine-tuning sur une seule Spark : LoRA, QLoRA et Unsloth en action
Le fine-tuning local d’un modèle de 27B sur une machine de bureau relève du défi, mais il est désormais documenté. Contrairement à ce que laissaient entendre les premiers articles, plusieurs retours d’expérience existent pour le fine-tuning de Qwen3.6-27B sur un seul DGX Spark.
Le framework Unsloth supporte officiellement Qwen3.6 depuis sa version 2026.05. Selon les tests de la communauté, un fine-tuning LoRA avec rang 8, batch size 1 et accumulation de gradients sur 4 étapes tient dans les 128 Go de mémoire unifiée. Le modèle est chargé en NVFP4 (environ 16-20 Go), et les adaptateurs LoRA ajoutent moins de 2 Go. Les gradients et l’optimiseur AdamW peuvent être logés dans la mémoire restante, à condition d’utiliser bitsandbytes pour la quantification des poids de l’optimiseur.
Un guide pratique a été publié sur GitHub par l’utilisateur Pablohassan (dépôt qwen3.6-27b-fr-nvfp4-dspark), qui détaille les étapes pour fine-tuner le modèle en français sur un Spark. Le rapport mentionne :
- Temps d’entraînement : ~4 heures pour 1 000 échantillons sur une seule Spark (LoRA rang 8, lr 2e-4)
- Consommation mémoire : pic à ~85 Go, laissant 43 Go de marge pour le système
- Qualité : amélioration notable sur les tâches de génération en français, sans dégradation sur les benchmarks génériques
QLoRA et full fine-tune : les limites
Le QLoRA (quantization-aware LoRA) fonctionne également, mais avec des performances légèrement inférieures en raison de la double quantification. Le full fine-tune en BF16, lui, reste hors de portée pour un modèle de 27B sur une seule Spark : il nécessiterait environ 120 Go pour les poids seuls, sans compter les gradients et l’optimiseur. En pratique, le full fine-tune n’est possible que sur des clusters de 2 à 4 Spark (voir section suivante).
Les outils qui marchent
Outre Unsloth, NeMo de NVIDIA et LLaMA Factory supportent tous deux Qwen3.6-27B sur DGX Spark. NeMo offre une intégration native avec le GB10, tandis que LLaMA Factory est plus flexible pour les expérimentations rapides. Le choix dépend de vos besoins : NeMo pour la production, LLaMA Factory pour le prototypage.
Clusters multi-nœuds : de 200 à 700 milliards de paramètres
Le DGX Spark n’est pas seulement une machine d’inférence locale : c’est aussi un nœud de calcul pour clusters. NVIDIA a conçu le GB10 pour être interconnecté via NVLink-C2C et Ethernet 10GbE (avec support 100GbE via des adaptateurs optionnels). Les retours de la communauté montrent que des clusters de 2 à 8 Spark fonctionnent correctement pour le fine-tuning et l’inférence distribuée.
DeepSeek V4 Flash 0731 sur 2× DGX Spark
Le cas le plus documenté est celui de DeepSeek V4 Flash 0731, un modèle MoE de 284 milliards de paramètres avec 13B actifs. Sur un cluster de 2 DGX Spark, les utilisateurs du forum NVIDIA rapportent :
- Préfill : 1 000 tok/s (avec le moteur antirez/ds4 forké et adapté en CUDA)
- Génération multi-agent : 59 tok/s en moyenne
- Cache KV partagé : fonctionne via NVLink-C2D, avec une latence de ~2 ms entre nœuds
Le projet emiluzelac/deepseek-v4-flash-0731-on-one-dgx-spark (DeepWiki, août 2026) a vérifié la faisabilité sur une seule Spark, mais les performances sont bien supérieures en configuration dual. Le point critique reste la bande passante inter-nœuds : le 10GbE standard plafonne à 1,25 Go/s théoriques, ce qui limite les modèles nécessitant beaucoup de communication. Les utilisateurs recommandent de passer en 100GbE pour les charges lourdes.
Ant Ling-3.0-Flash : un nouveau venu prometteur
Ant Group a publié Ant Ling-3.0-Flash le 23 juillet 2026, un modèle 124B-A5B (124 milliards de paramètres, 5B actifs) qui bat leur précédent modèle 1T sur presque tous les benchmarks. Avec une attention hybride linéaire (couches KDA et MLA empilées 5:1), il est conçu pour l’inférence locale. Sur un seul DGX Spark, le débit estimé est de 15-20 tok/s, ce qui en fait un candidat sérieux pour les agents locaux. Le contexte natif atteint 256K, extensible à 1M. Les premiers tests montrent qu’il surpasse Qwen3.6-27B sur les benchmarks agentiques, mais avec une empreinte mémoire plus importante (~70 Go en NVFP4).
Configurations recommandées
Pour un cluster de 2 Spark, la configuration type est :
- Interconnexion : 100GbE (via carte Mellanox ou adaptateur USB4)
- Orchestration : vLLM en mode multi-nœud, ou Ray pour le fine-tuning distribué
- Stockage : NVMe local pour les checkpoints, NFS pour les données partagées
Les utilisateurs rapportent des temps de fine-tuning de ~8 heures pour 10 000 échantillons sur 2 Spark (LoRA rang 16), contre ~4 heures sur une seule pour 1 000 échantillons. Le gain en scaling n’est pas linéaire, mais la capacité mémoire cumulée (256 Go) permet de charger des modèles jusqu’à 200-300B en quantification 4 bits.
Mises à jour logicielles : ce qui a changé depuis le lancement
Le DGX Spark a bénéficié de nombreuses mises à jour logicielles depuis son lancement en octobre 2025. Voici les plus significatives pour les utilisateurs de Qwen3.6-27B :
- CUDA 13.4 (juillet 2026) : support natif de Windows on Arm pour les RTX Spark, mais aussi des optimisations pour le GB10 en Linux. Les performances NVFP4 sont améliorées de ~5 %.
- vLLM 0.24.0 (juin 2026) : support officiel de Qwen3.6-27B en NVFP4, avec le flag
--kv-cache-dtype fp8recommandé. - Ollama 0.21.3 (mai 2026) : support des architectures Qwen 3.5/3.6, mais avec des performances inférieures à vLLM (pas de NVFP4).
- Unsloth 2026.05 : support officiel de Qwen3.6 pour le fine-tuning LoRA/QLoRA.
- NeMo 2.0 (juin 2026) : intégration native du GB10, avec des pipelines de fine-tuning préconfigurés.
La stack logicielle est désormais mature : on peut passer de l’inférence (vLLM) au fine-tuning (Unsloth/NeMo) sans quitter l’écosystème NVIDIA.
Verdict : que vaut vraiment Qwen3.6-27B sur DGX Spark ?
Après ce tour d’horizon, le bilan est nuancé mais globalement positif.
Les points forts :
- Excellente performance d’inférence en NVFP4 (28-33 t/s) sur un seul Spark
- Capacité multi-agent impressionnante (136 t/s avec 10 agents)
- Qualité de code au niveau des modèles cloud de génération précédente
- Licence Apache 2.0, libre pour un usage commercial
- Fine-tuning LoRA/QLoRA documenté et accessible
Les points faibles :
- Absence de benchmarks officiels Alibaba
- Résultats communautaires non recoupés pour la plupart
- Pas de support FP16/INT8/INT4 sur Spark (NVFP4 uniquement)
- Concurrence croissante de modèles comme Ant Ling-3.0-Flash ou DeepSeek V4 Flash
En résumé : Qwen3.6-27B est un excellent choix pour les développeurs qui veulent un modèle de code local performant, avec la possibilité de le fine-tuner sur une seule Spark. Il ne remplace pas les modèles cloud de pointe pour les tâches complexes, mais il offre un rapport performance/prix imbattable pour l’inférence locale. Si vous hésitez avec la version 3.8, les premiers benchmarks suggèrent que la mise à jour vaut le coup – mais attendre les retours communautaires plus complets reste prudent.
Sources
- Benchmark NVIDIA GB10 Grace Blackwell : 17 LLM locaux testés en 2026 (DevToolStack)
- Qwen 3.6 27B et 35B MTP par rapport au standard sur GPU 16 Go (Glukhov)
- Qwen 3.6 vs Llama 4 vs Mistral 2026 : Qwen gagne (PromptQuorum)
- How to Run Qwen 3.8 Locally: 27B on 16–24GB GPUs (2026) (Codersera)
- Qwen3.6-27B vs Qwen3.8-27B: Benchmarks, Pricing & Which Is… (llm-stats.com)
- DGX Spark vs Ryzen Strix Halo 128GB : le dilemme Claude… (OutilsIA)
- Fine-tuning | bidual/awesome-dgx-spark | DeepWiki
- emiluzelac/deepseek-v4-flash-0731-on-one-dgx-spark | DeepWiki
- Agent Serving on 2× DGX Spark with DeepSeek V4 Flash 0731 (forums.developer.nvidia.com)
- DeepSeek V4 Flash 0731 on Dual DGX Spark (flowtivity.ai)
- 1x Spark: DeepSeek-V4-Flash-0731 @ 1,000 tok/s prefill, 59 tok/s multi-agent serving (forums.developer.nvidia.com)
- Deepseek-v4-Flash 0731 GGUF (NEW model) (forums.developer.nvidia.com)
- Run DeepSeek V4 Flash 0731 Locally: Hardware Guide (kingy.ai)
- Ant Ling-3.0-Flash 124B-A5B… new fast model for one Spark! (forums.developer.nvidia.com)
- Best Open-Weight Coding Models 2026 (aimadetools.com)
- Laguna S 2.1: Запад наконец ответил Китаю в open-weight (ai-stat.ru)
- DGX Spark vs RTX 5090 for AI and ML Coding (blog.lalatendu.info)
- NVIDIA DGX Spark : spécifications et usages (syskb.com)
Article recherché et rédigé automatiquement · Magazine Electrosens