
 NVIDIA DGX Spark · 1 November 2026
LLM open source sur NVIDIA GB10 DGX Spark : ce qui tourne vraiment à l’automne 2026, la bascule des 64 Go, le fine-tuning et les clusters
Le NVIDIA DGX Spark, avec son SoC GB10 Grace Blackwell et ses 128 Go de mémoire unifiée, promettait de démocratiser l’inférence et le fine-tuning de grands modèles de langage en local. Un an et demi après son lancement, la donne a changé deux fois : le 23 octobre 2026, NVIDIA a discrètement scindé sa machine en deux — une mouture 64 Go vendue 4 999 $ et un modèle 128 Go qui dépasse désormais les 6 000 $. Entre-temps, les modèles open-weight spécialement optimisés (DeepSeek V4 Flash 0731, Ant Ling-3.0-Flash, Poolside Laguna S 2.1, Xiaomi MiMo-V2.6, Qwen 3.8-27B) et les retours de la communauté permettent enfin de dresser un bilan honnête : quels modèles tiennent vraiment leurs promesses, à quelles vitesses, et comment en tirer le meilleur parti — en solo comme en cluster.
La révolution silencieuse du calcul local : pourquoi 2026 est l’année du LLM open-source sur DGX Spark
L’année 2026 marque un tournant dans la démocratisation des grands modèles de langage. Alors que les géants du cloud continuent de proposer des API coûteuses et parfois opaques, une vague de modèles open-source de haute qualité a envahi le paysage. Mistral Small 4 (119B), DeepSeek V4 Flash 0731, GLM 5.2, Kimi K2.7, Qwen 3.6, Ant Ling-3.0-Flash, Poolside Laguna S 2.1, et plus récemment Xiaomi MiMo-V2.6… les noms s’accumulent, et avec eux, la promesse d’une IA souveraine, exécutée sur son propre matériel.
Le NVIDIA DGX Spark incarne cette ambition. Annoncé comme une station de travail personnelle capable de faire tourner des modèles à 200 milliards de paramètres, il s’adresse aux développeurs, chercheurs et PME qui veulent contrôler leurs données, réduire leurs coûts et expérimenter sans limite. Mais entre les communiqués officiels et la réalité des benchmarks, il y a un fossé que nous allons explorer.
Les enjeux sont clairs : performance, confidentialité, coût. Un LLM open-source bien choisi, correctement quantifié et déployé sur un DGX Spark peut rivaliser avec les services cloud pour de nombreuses tâches, tout en garantissant que les données ne quittent jamais la machine. Encore faut-il savoir quel modèle choisir, comment le configurer et à quels résultats s’attendre.
Un point de contexte essentiel : le DGX Spark n’est plus seulement une machine d’inférence. Depuis la rentrée 2026, elle est aussi vendue comme le socle d’agents autonomes locaux, avec des harnesses open source et des plateformes clés en main comme le « Portable Computer » de Perplexity, qui transforme le boîtier en agent IA local sorti d’usine. Cette évolution change la façon dont on évalue la machine : ce n’est plus seulement « combien de tokens par seconde », mais « combien d’agents en parallèle, à quelle latence, pour quel coût de tokens nul ». C’est précisément ce que mesure le nouveau benchmark AA-AgentPerf-Local d’Artificial Analysis, lancé le 29 septembre 2026 avec quatre modèles open-weight et quatre plateformes au banc — DGX Spark, Ryzen AI Halo, MacBook Pro (M5 Pro) et RTX 5090.
La bascule d’octobre 2026 : 64 Go, 128 Go et une nouvelle grille tarifaire
C’est la nouvelle qu’il faut intégrer avant toute décision d’achat. Le 2 octobre 2026, NVIDIA a officialisé une seconde déclinaison de son mini-supercalculateur : un DGX Spark doté de 64 Go de mémoire unifiée, commercialisé à partir du 23 octobre 2026 chez plusieurs constructeurs, au prix de 4 999 dollars. Le même jour, la version 128 Go — celle que nous décrivions jusqu’ici — voit son tarif grimper au-delà des 6 000 dollars sur le marché, conséquence directe de l’envolée des cours de la mémoire LPDDR5X. Autrement dit : moins de mémoire, mais plus cher que le prix de lancement de la version 128 Go en 2025 (3 999 $).
La lecture naïve serait de crier à l’arnaque. La réalité est plus subtile, et NVIDIA l’assume dans son billet de blog officiel : le DGX Spark 64 Go vise les développeurs qui veulent démarrer sur de l’IA locale avec le stack NVIDIA complet, puis passer au cluster quand la charge grandit. La machine embarque toujours le GB10 Grace Blackwell, avec environ 1 PFLOP de calcul et le même écosystème logiciel. Ce que l’on perd, c’est la marge de manœuvre mémoire : là où le 128 Go chargeait confortablement un modèle de 200 milliards de paramètres en NVFP4, le 64 Go se concentre sur les modèles de 30 à 35 milliards de paramètres et les agents locaux.
Le test mis en avant par NVIDIA sur cette configuration est d’ailleurs révélateur : Qwen 3.8-27B, avec un gain de vitesse annoncé jusqu’à 1,7× par rapport à la génération précédente de logiciels. Un modèle de 27 milliards de paramètres, donc — pas un 200B. C’est le cœur du repositionnement : le 64 Go est une porte d’entrée agentique, pas une station de fine-tuning lourd.
Faut-il acheter deux petits plutôt qu’un gros ? C’est la question que pose Frandroid et que reprend Clubic : deux Spark 64 Go (9 998 $) offrent 128 Go cumulés et, surtout, la possibilité de faire du tensor parallelism sur deux nœuds — mais avec le coût réseau, la complexité d’orchestration et une consommation doublée. Un seul 128 Go reste plus simple, plus rapide en single-stream, et désormais plus cher. Le calcul n’est plus seulement technique, il est budgétaire.
Cette bascule tarifaire s’inscrit dans un contexte plus large : le 8 octobre 2026, NVIDIA a dévoilé une DGX Station for Windows à 748 Go de mémoire cohérente et 20 PFLOPs FP4, attendue au quatrième trimestre 2026 chez six partenaires OEM. La hiérarchie est claire : le Spark reste l’entrée de gamme locale, la Station devient le milieu de gamme, le cloud reste le haut. Et face à elle, AMD a sorti son Ryzen AI Halo 192 Go à 7 299,99 $ chez Micro Center, premier desktop compact capable de charger des modèles open-weight de 300 milliards de paramètres — mais les benchmarks indépendants du 14 octobre 2026 confirment que le DGX Spark garde l’avantage sur la vitesse d’inférence, grâce à CUDA.
DGX Spark : la fiche technique qui change la donne
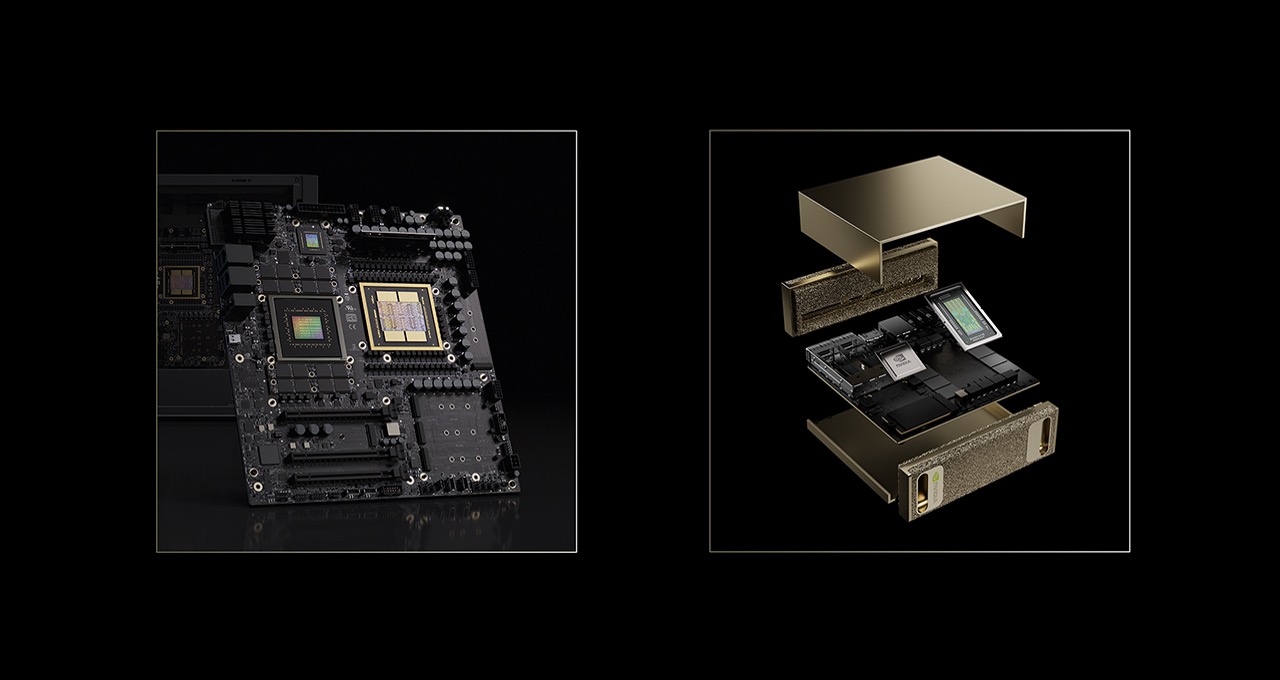
Le DGX Spark repose sur le superchip NVIDIA GB10 Grace Blackwell, combinant un CPU à 20 cœurs ARM Neoverse V2 et un GPU Blackwell d’environ 6 144 cœurs CUDA avec support FP4. Sa mémoire unifiée LPDDR5X — 128 Go ou désormais 64 Go — offre une bande passante de 273 Go/s, le véritable atout de la machine : elle permet de charger des modèles bien plus volumineux que ce que permettrait une carte graphique classique, limitée à 16 ou 24 Go de VRAM. Le tout dans un format compact de 150×150×50,5 mm pour 1,2 kg, avec une consommation d’environ 170 W (les mesures en charge relevées par Context Studios en septembre 2026 donnent environ 160 W).
| Caractéristique | DGX Spark 128 Go | DGX Spark 64 Go | RTX 4080 (référence) | Mac Studio (M4 Ultra) |
|---|---|---|---|---|
| Mémoire unifiée | 128 Go LPDDR5X (273 Go/s) | 64 Go LPDDR5X (273 Go/s) | 16 Go GDDR6X | 64 Go (ou 128 Go) unifiée |
| Capacité max. modèles | 200 Mds paramètres (NVFP4) | 30–35 Mds paramètres (usage courant) | ~13 Mds (quantifié) | ~30–70 Mds (selon RAM) |
| Prix (automne 2026) | > 6 000 $ | 4 999 $ (dès le 23 oct. 2026) | ~1 200 $ (carte seule) | ~6 000–7 000 $ |
| TDP | ~170 W | ~170 W | 320 W | ~60 W (selon config) |
| Format | Mini-PC (1,2 kg) | Mini-PC (1,2 kg) | Carte graphique | Tour ou mini |
Le prix de la version 128 Go a été révisé à 4 699 $ en avril 2026, contre 3 999 $ initialement, en raison de contraintes d’approvisionnement mémoire — puis a dépassé les 6 000 $ à l’automne, selon Pause Hardware et Generation-NT. En Europe, le tarif catalogue grimpait à environ 5 038 € HT selon le relevé de Context Studios (septembre 2026), avant la nouvelle hausse. Un investissement conséquent, mais qui inclut tout le nécessaire : CPU, GPU, mémoire, stockage et alimentation. Il faut toutefois noter que des clones licenciés existent : l’ASUS Ascent GX10 est généralement 500 à 1 000 $ moins cher, avec une qualité de finition perçue supérieure, et d’autres OEM (MSI EdgeXpert, Acer DGX) proposent des variantes fonctionnellement identiques (même puce GB10). Le 5 octobre 2026, ASUS a d’ailleurs officialisé son Ascent GX10 64 Go, positionné sur les modèles open-source de 30 à 35 milliards de paramètres et les agents locaux, avec 1 PFLOP de calcul — même plateforme, prix très différent, comme le relève Techgenyz.
Le verdict communautaire de mai 2026 reste néanmoins partagé : 70 à 80 % des acheteurs de mini-PC IA préfèrent le AMD Ryzen AI Halo (Strix Halo) pour son rapport performance/prix, mais le DGX Spark conserve l’avantage décisif de l’écosystème CUDA complet.
Le guide de configuration outilsia.fr précise que la machine tourne sous DGX OS (basé sur Ubuntu Server 24.04 ARM), avec CUDA 13.0, cuDNN, NCCL, Docker et le NVIDIA Container Toolkit préinstallés — on peut lancer son premier LLM en quelques minutes après le premier démarrage. Point important : le DGX Spark n’a pas de connecteur HDMI/DisplayPort utilisable ; c’est une machine headless conçue pour être pilotée via SSH ou interface web depuis une autre machine. Le même guide insiste sur un point souvent passé sous silence : la friction réelle n’est pas l’installation, mais la gestion des conteneurs ARM Docker — prévoyez du temps pour adapter vos images x86.
NVIDIA a également annoncé une collaboration avec llama.cpp, apportant une optimisation spécifique qui améliorerait les performances d’exécution des modèles de pointe de 35 % en moyenne. Le format NVFP4 (NVIDIA Floating Point 4-bit) permet de compresser les modèles jusqu’à 70 % sans perte d’intelligence, selon la communication officielle. Ces chiffres, bien que non vérifiés de manière indépendante, laissent entrevoir un potentiel énorme pour l’inférence locale.
Mises à jour logicielles de l’été et de l’automne 2026 : ce qui change vraiment
Le stack logiciel du Spark a mûri par vagues successives, et il faut distinguer ce qui est vérifié de ce qui relève du marketing.
Côté vérifié : NVIDIA a publié le 21 juillet 2026 une preview de CUDA 13.4 pour Windows on Arm, ouvrant la voie aux futures machines RTX Spark. Ce kit natif Arm64 permettra aux développeurs de préparer leurs applications pour la plateforme RTX Spark, dont les deux variantes du processeur N1X ont été confirmées par les pilotes. ASUS et MSI lanceront leurs PC portables RTX Spark dès l’automne 2026, avant Acer et Gigabyte dont les mini-PC sont attendus début 2027.
Le 3 septembre 2026, NVIDIA a annoncé simplifier le support de l’IA locale sur ses GPU embarquant au moins 24 Go de VRAM, avec des optimisations apportées à vLLM et llama.cpp sur les plateformes RTX et DGX (wccftech.com). Cette dynamique profite directement au DGX Spark.
Le 30 octobre 2026, NVIDIA a détaillé un workflow CLI complet pour faire tourner Nemotron 3.5 Lightning sur un DGX Spark 64 Go via TensorRT Edge-LLM, avec des chiffres de speculative decoding à l’appui : 73 tok/s sans DSpark, 127 tok/s avec. Derrière le vernis « vendor benchmark », c’est le signe que l’outillage edge se stabilise — et que la version 64 Go est bien la cible des nouveaux workflows.
Enfin, sur le front du fine-tuning, NVIDIA a publié des recettes NeMo AutoModel spécifiques au Spark, avec un conteneur 26.08 (nvcr.io/nvidia/nemo-automodel:26.08) et un correctif mémoire à appliquer après la construction de l’image, en épinglant le dépôt sur le merge commit de la PR 3766. Un détail qui compte : les recettes Spark et les correctifs mémoire sont arrivés après la publication de l’image, ce qui signifie que sans ce pin, on n’obtient pas les performances attendues. C’est le genre de friction qui explique pourquoi la communauté parle d’un « stack qui mûrit » plutôt que d’un « stack mature ».
Les modèles stars de 2026 : Mistral Small 4, DeepSeek V4 Flash 0731, GLM 5.2, Kimi K2.7, Ant Ling-3.0-Flash et leurs concurrents
Le paysage des LLM open-source en 2026 est dominé par des architectures variées : transformeurs denses, mixture-of-experts (MoE), modèles quantifiés nativement. Voici un tableau comparatif mis à jour avec les informations des sources web récentes.
| Modèle | Architecture | Paramètres totaux | Paramètres actifs | Quantification supportée | Particularité |
|---|---|---|---|---|---|
| Mistral Small 4 | MoE (128 experts, 4 actifs) | 119 Mds | 6,5 Mds | NVFP4 (natif) | Multilingue, raisonnement configurable, contexte 256k, licence Apache 2.0 |
| DeepSeek V4 Flash 0731 | MoE optimisé | 284 Mds | 13 Mds | NVFP4, MXFP4, GGUF (Q8, Q4) | Variante rapide pour DGX Spark, très bon en agentique, optimisé pour cluster 2 Spark |
| GLM 5.2 | Transformer dense | 744 Mds | – | BF16, FP8, NVFP4 | Qualité maximale, raisonnement, code |
| GLM-5.3-Flash | MoE | 320 Mds | 18 Mds | NVFP4, FP8 | Mesuré sur paire de nœuds DGX Spark (24 sept. 2026) |
| Kimi K2.7 | MoE | 1000 Mds | ~30 Mds | MXFP4 | Agentique, appels d’outils, MCP |
| Ant Ling-3.0-Flash | MoE (attention hybride KDA/MLA) | 124 Mds | 5 Mds | NVFP4, FP8 | Contexte 256K extensible à 1M, débit estimé 15-20 tok/s sur Spark |
| Poolside Laguna S 2.1 | MoM (256 experts) | 118 Mds | ~? | FP8, BF16 | Modèle de codage open-weight, rivalise avec des modèles 10× plus gros |
| Xiaomi MiMo-V2.6 (Pro/Flash/9B) | Famille open-weight | Classe 1T (Pro) | – | – | Poids ouverts sous licence MIT, performances frontière, gains RL non répliqués indépendamment |
| Qwen 3.6 | Transformer dense | 4 à 31 Mds | – | BF16, FP8, GGUF | Compact, une seule carte, idéal TPE |
| Qwen 3.8-27B | Transformer dense | 27 Mds | – | NVFP4, GGUF | 52 à l’Intelligence Index, 1er de sa classe open-weight ; testé par NVIDIA sur Spark 64 Go (jusqu’à 1,7×) |
| Gemma 4 | Transformer dense | 4 à 31 Mds | – | BF16, FP8, GGUF | Compact, une seule carte |
| Llama 3.1 8B | Transformer dense | 8 Mds | – | BF16, FP8, GGUF | Référence pour les petits modèles |
| Mistral 7B v0.3 | Transformer dense | 7 Mds | – | BF16, FP8, GGUF | Très rapide sur DGX Spark |
Mistral Small 4 est un modèle hybride publié par Mistral AI en mars 2026. Il unifie en un seul point de contrôle trois familles de modèles — Instruct, Reasoning (anciennement Magistral) et Devstral — offrant ainsi une polyvalence exceptionnelle pour un usage général. Son architecture MoE le rend particulièrement efficace : 119 milliards de paramètres au total, mais seulement 6,5 milliards actifs par token, avec 128 experts dont 4 actifs à chaque inférence. Il accepte texte et images en entrée, et sa fenêtre de contexte de 256k tokens le rend adapté aux tâches longues. La version quantifiée en NVFP4, créée en collaboration avec les équipes vLLM et Red Hat via llm-compressor, réduit significativement la mémoire requise : les poids occupent environ 66 Go, ce qui tient parfaitement dans les 128 Go du DGX Spark — et déborde, en revanche, du 64 Go.
DeepSeek V4 Flash 0731 est la dernière variante optimisée de DeepSeek V4, conçue pour l’inférence rapide sur DGX Spark. Avec 284 milliards de paramètres totaux et seulement 13 milliards actifs, il délivre des performances agentiques de niveau frontière, soit 10× moins de paramètres actifs que Claude Opus, selon flowtivity.ai. Son dépôt GitHub est Mjxkill/deepseek-v4-flash-2x-dgx-spark. Les forums NVIDIA rapportent qu’en configuration double DGX Spark, le modèle atteint 30 tok/s par défaut, et qu’un changement de configuration permet de restaurer un taux d’acceptation élevé. La version GGUF Q8 (UD-Q8_K_XL) pèse 162 Go, seulement 7 Go de plus que la Q4 (UD-Q4_K_XL), ce qui permet une exécution en précision quasi complète sur un cluster de deux Spark. Une reproduction indépendante sur un seul Spark est documentée dans le projet emiluzelac/deepseek-v4-flash-0731-on-one-dgx-spark.
GLM 5.2 domine l’indice d’intelligence des modèles ouverts selon le comparatif 2026 de QDNA. Avec 744 milliards de paramètres, il nécessite une quantification poussée pour tenir sur un seul DGX Spark, mais reste un choix de premier ordre pour les organisations exigeantes. Sa variante plus légère, GLM-5.3-Flash (320B au total, 18B actifs), a été mesurée par Context Studios le 24 septembre 2026 sur une paire de nœuds DGX Spark — un cas d’usage typique du cluster à deux nœuds.
Kimi K2.7 est un modèle orienté agentique, avec une forte capacité d’appels d’outils et de protocole MCP. Il est particulièrement adapté au développement d’agents autonomes.
Ant Ling-3.0-Flash (124B-A5B) est un modèle MoE récent d’Ant Group, sorti le 23 juillet 2026, avec une architecture d’attention hybride (KDA et MLA dans un ratio 5:1). Seulement 5 milliards de paramètres actifs par token, ce qui le rend très efficace. Son contexte natif de 256K tokens est extensible à 1M. Les premiers tests informels font état d’un débit de 15 à 20 tok/s sur un Spark unique — un ordre de grandeur cohérent avec la bande passante mémoire de la machine, mais qui reste à confirmer par des mesures indépendantes.
Qwen 3.8-27B mérite une mention à part : c’est le modèle que NVIDIA met en avant pour la version 64 Go, avec un gain de vitesse annoncé jusqu’à 1,7× sur le Spark. Son score de 52 à l’Intelligence Index en fait le premier de sa classe open-weight, et sa taille (27 Mds) le rend confortable sur une seule machine, y compris la 64 Go.
Performances réelles : le tableau de bord de l’automne 2026
C’est ici que les chiffres comptent, et qu’il faut être précis sur ce qui est mesuré, par qui, et sur quelle configuration.
Sur un seul DGX Spark, les mesures canoniques de l’été 2026 donnent le ton. Avec le projet antirez ds4 et DeepSeek-V4-Flash en quantification IQ2_XXS, on obtient environ 14 tok/s en single-stream, pour un prefill de 410 tok/s. Avec la suite llama.cpp en GGUF sur un modèle de 35B-A3B, on monte jusqu’à 67 tok/s. C’est le régime de croisière réaliste d’une machine unique : quelques dizaines de tokens par seconde sur des modèles de taille moyenne, pas les centaines de tokens par seconde des benchmarks marketing.
Sur deux DGX Spark, la donne change. En tensor parallelism (TP=2) avec vLLM et DeepSeek-V4-Flash en FP8, on atteint environ 41 tok/s en single-stream, un prefill d’environ 1 785 tok/s, et surtout un débit agrégé d’environ 350 tok/s à une concurrence de 32. Le pool de cache KV partagé grimpe à 1 105 096 tokens. Et la taille maximale de modèle supportée passe à 405 milliards de paramètres — de quoi charger GLM-5.3-Flash ou un Kimi K2.7 quantifié.
Le 29 septembre 2026, Artificial Analysis a lancé AA-AgentPerf-Local, son benchmark dédié aux agents locaux, avec quatre modèles open-weight et quatre plateformes au banc. C’est la première mesure réellement indépendante et comparable du comportement agentique sur Spark, et elle vaut mieux que n’importe quel chiffre de tokens par seconde isolé : un agent qui tourne à 20 tok/s mais qui termine sa tâche en trois appels d’outils bat un agent à 60 tok/s qui en fait douze.
Un chiffre à garder en tête pour les déploiements multi-agents : Alibaba rapporte que Qwen3.6-27B atteint 136 tokens/s avec 10 agents en parallèle sur un DGX Spark. C’est le genre de donnée qui compte quand on évalue la machine comme socle d’agents, et non comme simple chatbot.
Enfin, côté TensorRT Edge-LLM, NVIDIA annonce 127 tok/s sur Nemotron 3.5 Lightning en 64 Go avec speculative decoding (DSpark), contre 73 tok/s sans. Ces chiffres sont des benchmarks constructeur, à prendre avec les précautions d’usage — mais ils indiquent la direction : le speculative decoding et les formats NVFP4 sont les deux leviers qui font vraiment la différence sur GB10.
LoRA, QLoRA, full fine-tune : quel pipeline pour quel modèle ?
Le fine-tuning est l’autre promesse du Spark, et c’est là que la mémoire unifiée change tout. Sur une carte graphique classique, un fine-tuning LoRA sur un modèle de 30 milliards de paramètres est un casse-tête de quantification. Sur un Spark 128 Go, c’est une après-midi de travail.
Les pipelines qui fonctionnent réellement en 2026 :
LoRA et QLoRA restent les options par défaut pour les modèles de 7 à 35 milliards de paramètres. Sur un Spark 128 Go, un QLoRA sur Qwen 3.8-27B ou Mistral Small 4 (en 4-bit) tient confortablement, avec de la marge pour un batch raisonnable. Sur le 64 Go, il faut descendre en taille de modèle ou réduire le rang et la longueur de séquence — c’est faisable, mais serré.
Le full fine-tune reste réservé aux petits modèles (7-8B) ou aux configurations multi-nœuds. Un full fine-tune de 27B en BF16 demande bien plus que 128 Go une fois comptés les états d’optimiseur, les gradients et les activations ; c’est un cas d’usage pour deux à quatre Spark, pas pour un seul.
Les outils : NeMo AutoModel est le chemin officiel NVIDIA, avec des recettes spécifiques au Spark et un conteneur dédié. Unsloth reste le favori de la communauté pour sa vitesse et sa faible empreinte mémoire sur les petits et moyens modèles. LLaMA Factory offre la plus grande flexibilité de configuration. Le choix dépend surtout de votre tolérance à la friction : NeMo est le mieux intégré au stack, Unsloth le plus rapide à prendre en main, LLaMA Factory le plus configurable.
Un point d’attention : la gestion des conteneurs ARM. La plupart des images de fine-tuning publiées par la communauté sont x86. Sur Spark, il faut soit utiliser les images NVIDIA (nemo-automodel, par exemple), soit reconstruire. C’est la friction numéro un rapportée par les utilisateurs, bien avant les performances brutes.
Clusters DGX Spark : ce que deux, quatre ou huit nœuds changent vraiment
Le cluster est la vraie histoire de 2026. NVIDIA a positionné le Spark dès le départ comme une brique de cluster, et les chiffres confirment que c’est là que la machine trouve sa pleine mesure.

À deux nœuds, on double la mémoire (256 Go cumulés) et on accède au tensor parallelism. C’est la configuration de référence pour DeepSeek V4 Flash 0731, GLM-5.3-Flash et les modèles de la classe 300-400 milliards de paramètres quantifiés. Les mesures de l’été 2026 sont solides : 41 tok/s single-stream, 350 tok/s agrégés à concurrence 32, 1 785 tok/s de prefill.
À quatre nœuds, on entre dans le territoire du fine-tuning sérieux et des modèles de la classe 700 milliards. C’est aussi là que la complexité d’orchestration devient significative : gestion du réseau, synchronisation des caches KV, tolérance aux pannes.
À huit nœuds, on parle de charge multi-agents à l’échelle d’une équipe, avec des harnesses comme NemoClaw ou OpenClaw qui répartissent les tâches. C’est là que des outils de gestion d’entreprise deviennent nécessaires — et c’est précisément le créneau que Progress Chef a investi le 30 juillet 2026, avec une compatibilité DGX Spark à 189 dollars par an et par système.
Le vrai enseignement de l’automne 2026 : le cluster Spark n’est plus un projet de laboratoire. C’est une architecture de production pour les PME qui veulent de l’IA souveraine, avec des coûts prévisibles et une gestion d’entreprise qui arrive. La limite n’est plus matérielle, elle est opérationnelle : qui administre, qui met à jour, qui surveille.
Sources
- NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI — blogs.nvidia.com, 2 octobre 2026
- Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ? — Frandroid, 2 octobre 2026
- NVIDIA lance un DGX Spark 64 Go : moins de mémoire, mais une drôle d’astuce pour dépasser le modèle 128 Go — Clubic, 2 octobre 2026
- Le DGX Spark Perd La Moitié De Sa Mémoire Mais Conserve Son Tarif De 4 999 Dollars — Pause Hardware, 2 octobre 2026
- Nvidia DGX Spark 64 Go : moins de mémoire pour plus cher et toujours pour l’IA locale — Generation-NT, 4 octobre 2026
- DGX Spark 64 Go : NVIDIA annonce une configuration — NeoTeo, 3 octobre 2026
- ASUS Ascent GX10 64GB: Compact Agentic AI Supercomputer — ASUS, 5 octobre 2026
- ASUS Ascent GX 10 vs NVIDIA DGX Spark: Same GB 10 Platform, Very Different Prices — Techgenyz, 5 octobre 2026
- AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed — Tech Times, 14 octobre 2026
- NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs — Tech-Insider, 8 octobre 2026
- NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM — Blockchain.news, 30 octobre 2026
- The Best DGX Spark for Local AI in 2026: LLM Speed, Model Sizes, and Clusters, With Sources — Pyshine, 1er octobre 2026
- CUDA Finally Lands on Windows on Arm — Tech Times, 21 juillet 2026
- NVIDIA simplifie le support de l’IA locale sur ses GPU — Wccftech, 3 septembre 2026
- NeMo AutoModel — instructions de fine-tuning sur DGX Spark — NVIDIA Build
- NeMo AutoModel — PR 3766 — GitHub
- DeepSeek V4 Flash 2x DGX Spark — GitHub
- DeepSeek V4 Flash 0731 on one DGX Spark — DeepWiki
- Guide de configuration DGX Spark / ASUS GX10 — OutilsIA
- DeepSeek V4 Flash — Flowtivity
Article recherché et rédigé automatiquement · Magazine Electrosens