
WSL 3 : le passthrough GPU/NPU qui va faire entrer l’IA audio locale dans les studios Windows
L’arrivée de WSL 3 avec son passthrough quasi natif GPU et NPU (annoncé à Build 2026) est en train de transformer Windows en plateforme de choix pour l’IA audio locale. Cet article explore ce que cette infrastructure change concrètement pour les ingénieurs du son, les développeurs de plugins et les
SoundBoost : quand le mastering se pilote à la voix — révolution ou miroir aux alouettes ?
Décryptage de la sortie de SoundBoost, un service de mastering et de mixage piloté par instructions en langage naturel, annoncé fin juillet 2026. L’article analyse en profondeur la technologie sous-jacente (compréhension sémantique, adaptation au style, rendu), ses promesses face aux outils de maste
Adobe Firefly Audio : la création sonore sans micro entre dans le studio
Décrypter la sortie en version générale des outils audio IA d’Adobe (génération de musique et de parole sans micro). Analyser les capacités réelles des modèles, la qualité et le réalisme des voix générées, ainsi que l’intégration native dans Premiere Pro et After Effects. Comparer cette offre avec l
Anker THUS AI : la puce qui veut enterrer le cloud audio — décryptage d’un pari industriel à l’IFA 2026
Décryptage en profondeur de l’annonce majeure d’Anker à l’IFA 2026 : sa puce THUS AI dédiée à l’audio, déployée sur cinq modèles (Space 2 Pro, Liberty Buds 2, etc.). L’article analyse ce que cette puce apporte concrètement (traitement local, réduction de bruit adaptative, spatialisation, voix), la s
Voix ressuscitées, identités réinventées : le pari à 1 milliard de dollars d’ElevenLabs pour restaurer un million de voix
ElevenLabs annonce un programme à 1 milliard de dollars pour restaurer un million de voix, notamment celle d’Eric Dane. Ce dossier explore les technologies de clonage et de restauration vocale, les cas d’usage (médical, divertissement), les enjeux éthiques de consentement et d’identité vocale, et le
L’IA audio passe à l’oreille : le grand basculement vers l’embarqué
Panorama de l’état des lieux de l’IA audio embarquée en 2026, à l’heure où les puces dédiées (THUS d’Anker, NPU) et les assistants vocaux intégrés aux écouteurs et appareils grand public redéfinissent le traitement du son. L’article doit relier les annonces majeures de l’IFA 2026 (Anker Soundcore, S
Sonible smart:chain : quand l’IA orchestre enfin toute la chaîne de mixage
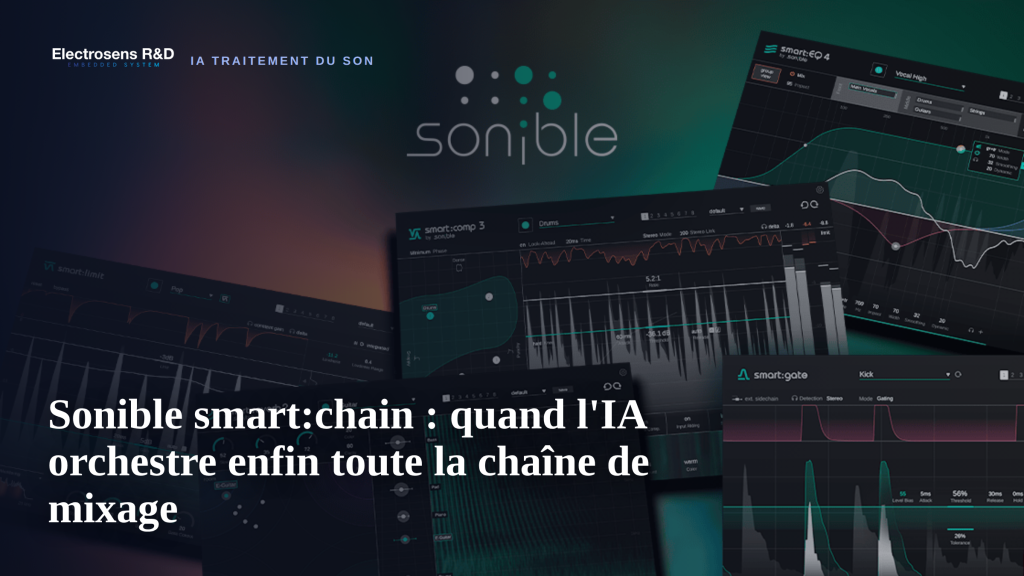
Décryptage en profondeur de Sonible smart:chain, le nouveau plugin de chaîne de traitement piloté par IA qui promet de simplifier le mixage tout en conservant un contrôle créatif total. L’article analyse son fonctionnement (analyse audio en temps réel, suggestions de réglages contextuels), le compar
HappyShrimp vs Mureka V9.5 : le duel qui rebat les cartes de la musique IA
Comparatif approfondi entre les deux dernières grandes sorties de modèles de génération musicale : Alibaba HappyShrimp (bêta, août 2026) et Mureka V9.5. Analyse détaillée des forces et faiblesses de chacun (qualité vocale, longueur des pistes, contrôle utilisateur, latence, écosystème, tarification)
L’audio IA quitte le cloud : la grande bascule vers l’edge en 2026
Alors que le cloud a longtemps dominé le traitement audio par IA, une bascule majeure s’opère en 2026 vers l’edge (périphérie). Les acquisitions de Syntiant (Orosound, AudioSourceRE), le partenariat Deepgram/Snapdragon, et les innovations matérielles (HAVIT, AISpeech, Embedded World) dessinent un no
L’IA audio open weight débarque : quand les modèles chinois rebattent les cartes des plugins propriétaires
Alors que les géants comme OpenAI, Stability AI et ByteDance dominent l’audio génératif avec des modèles propriétaires, la montée en puissance des modèles open weight chinois (Moonshot AI Kimi K3, etc.) annonce une rupture majeure. Ce dossier explore comment cette vague open source pourrait permettr