
 LLM auto hébergées · 29 October 2026
llama.cpp en 2026 : anatomie d’un moteur qui refuse de mourir (et pourquoi il reste la colonne vertébrale de l’IA locale)
On l’a longtemps rangé dans la catégorie des projets bricolés pour bidouilleurs de week-end. Trois ans plus tard, llama.cpp est le socle invisible sur lequel tournent Ollama, LM Studio, les serveurs maison et une bonne partie des agents de code. Voici ce qu’il y a vraiment sous le capot — et pourquoi ce moteur discret continue de gagner.
Le moteur qu’on n’attendait plus : pourquoi llama.cpp est partout en 2026
Il faut mesurer l’ironie. Quand un développeur bulgare a commencé à porter un modèle de langage en C/C++ sans dépendances, au printemps 2023, personne n’imaginait que ce serait le logiciel qui, trois ans plus tard, ferait tourner l’IA locale de millions de machines. Et pourtant. En 2026, llama.cpp n’est plus un projet expérimental : c’est l’infrastructure. Le dépôt vit sous l’organisation ggml-org sur GitHub, et une application dérivée, simplement nommée « Llama », est distribuée par « the llama.cpp team and Hugging Face » — un partenariat qui dit beaucoup sur la trajectoire du projet.
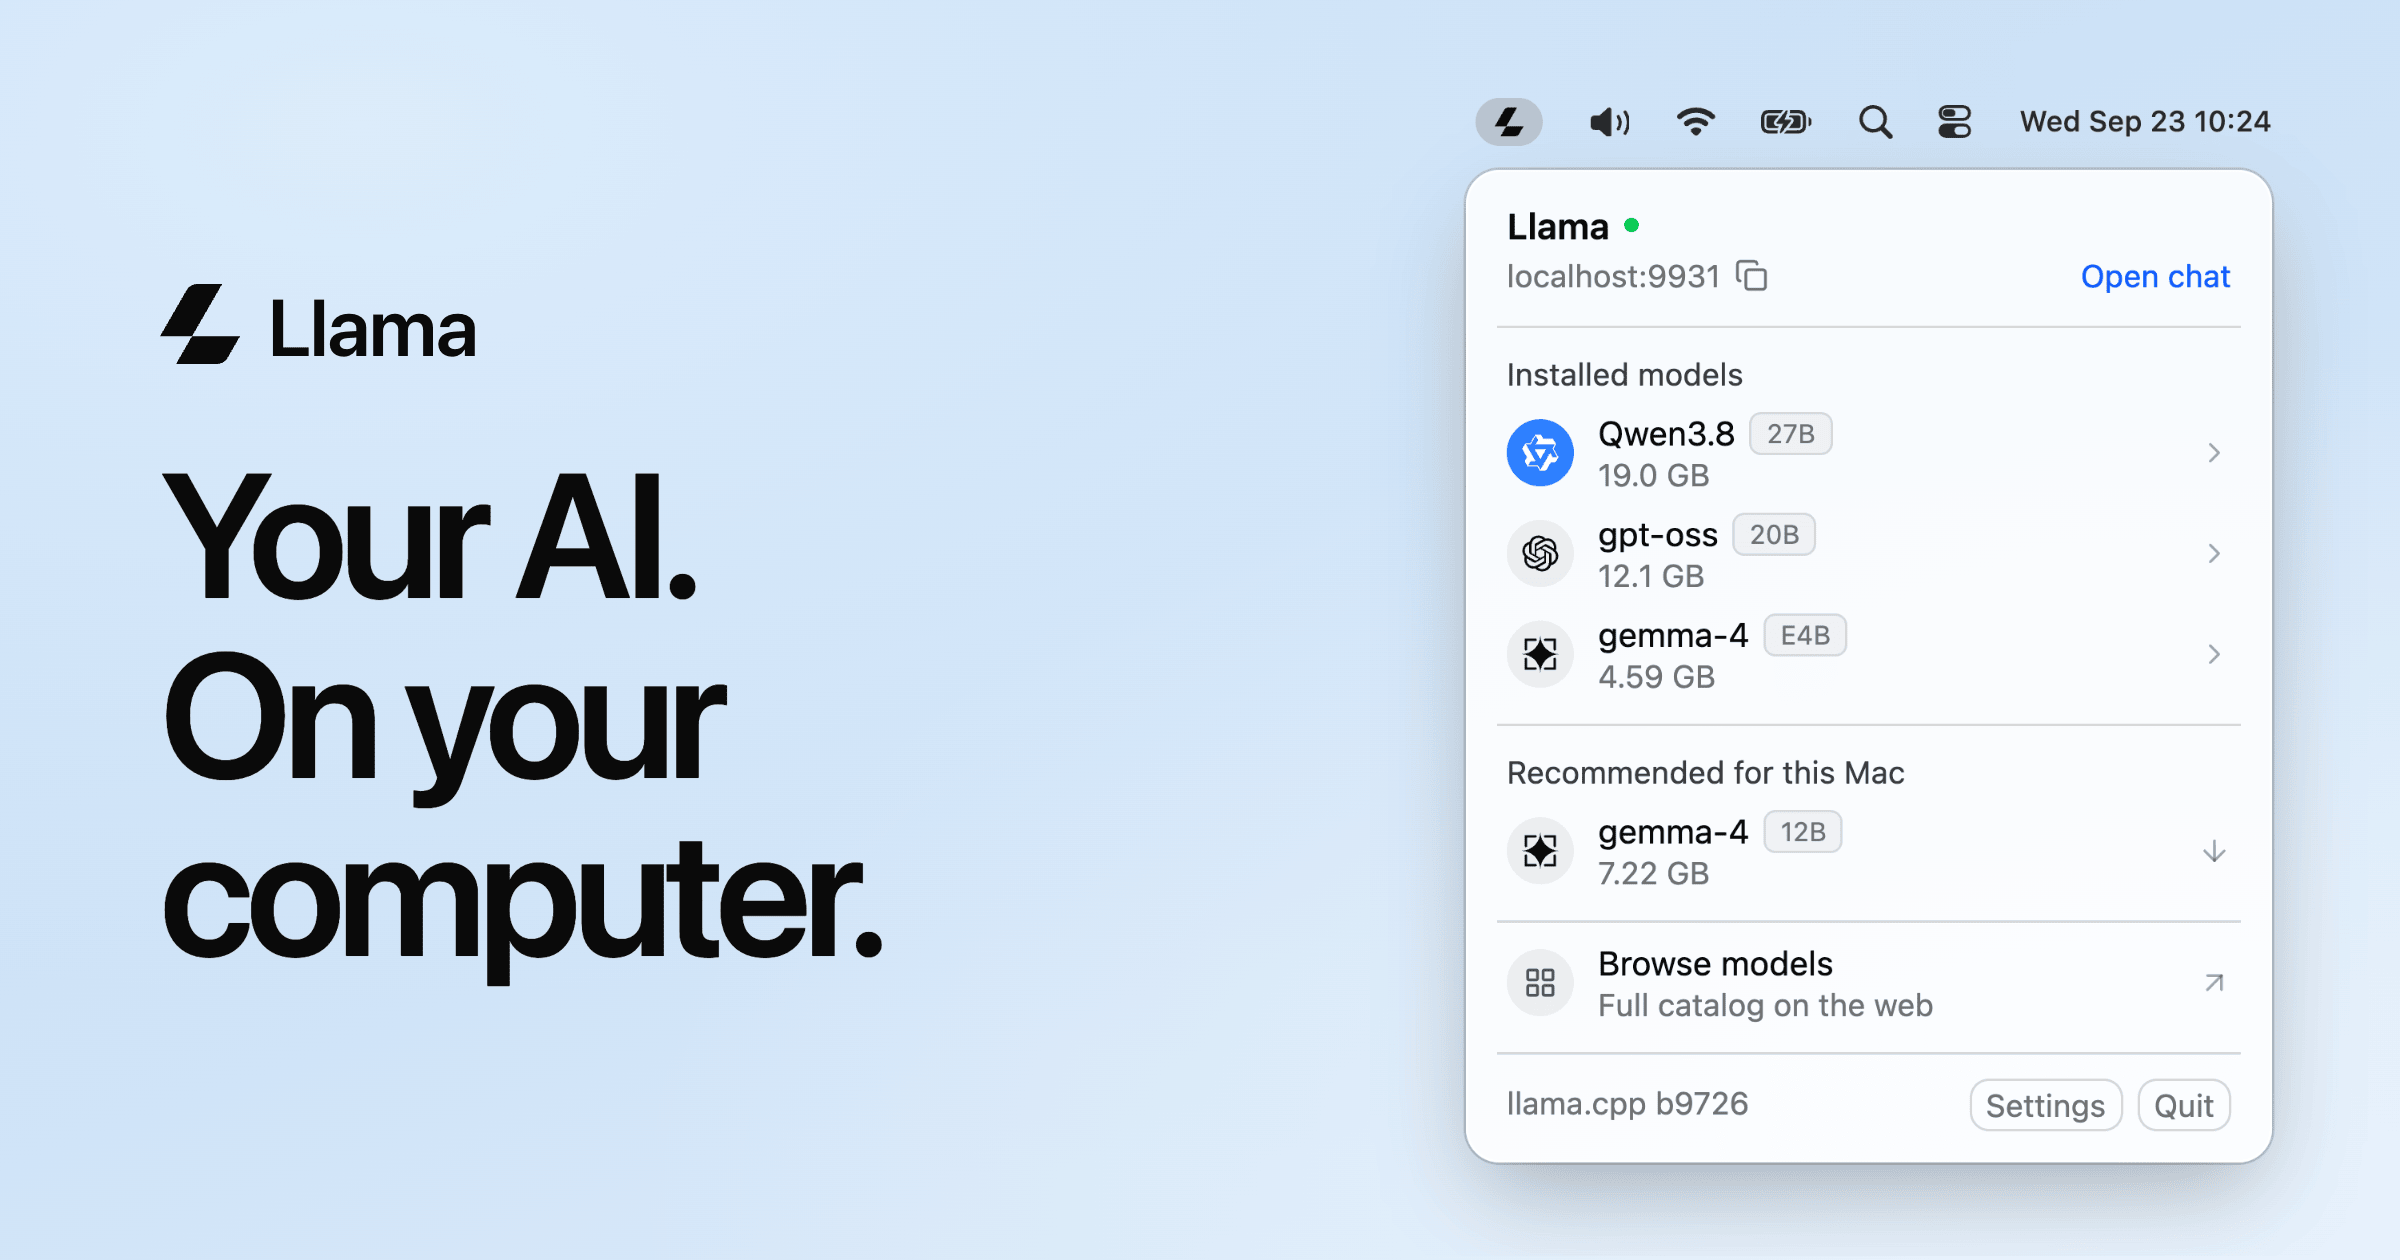
Cette app est un révélateur. Présentée comme un petit utilitaire de barre de menu sur Mac et de zone de notification sur Windows, elle pèse environ 1 Mo au téléchargement et 4 Mo une fois installée, selon le site officiel. Elle est gratuite, open source, fonctionne hors ligne, et expose une API locale compatible OpenAI sur localhost:9931/v1. Autrement dit : n’importe quel outil qui sait parler à l’API d’OpenAI peut, sans changer une ligne de code, s’adresser à un modèle qui tourne sur votre propre disque. Les modèles sont stockés une seule fois dans le cache Hugging Face, partagé avec llama.cpp et d’autres outils, et déchargés de la mémoire après cinq minutes d’inactivité.
Ce dernier détail n’est pas anodin. Il trahit une philosophie d’ingénierie : le moteur est conçu pour cohabiter avec le reste de la machine, pas pour la monopoliser. C’est précisément ce qui le rend invisible — et indispensable.
Mais il faut poser d’emblée une limite documentaire. Les sources publiques disponibles en 2026 décrivent surtout le produit fini (l’app, ses réglages, ses paliers mémoire) et très peu l’anatomie interne du moteur. Les pages officielles vantent les réglages exposés — quantization, taille de contexte, entrée image, speculative decoding, batch size — sans publier de benchmarks de débit. Les articles qui prétendent raconter « la réécriture 2026 » existent, mais leur contenu n’est pas vérifiable à partir des extraits disponibles. Nous allons donc disséquer ce que l’on peut affirmer, signaler ce qui relève de l’inférence raisonnable, et surtout éviter de fabriquer des chiffres. Car c’est bien là le piège de ce sujet : llama.cpp est un projet si populaire que les tok/s inventés y circulent plus vite que les mesures réelles.
ggml, GGUF, quantization : la mécanique intime du moteur
Pour comprendre llama.cpp, il faut d’abord comprendre qu’il n’est pas seul. Le moteur repose sur ggml, une bibliothèque de tenseurs et de graphes de calcul de bas niveau, écrite en C, sans dépendance externe. C’est ggml qui fait le vrai travail : représenter les poids, construire le graphe de calcul d’une passe avant, exécuter les opérations matricielles. llama.cpp, à proprement parler, est la couche qui organise ces graphes en une inférence de transformer cohérente — attention, feed-forward, normalisation, échantillonnage.
Le format de conteneur, c’est GGUF. C’est lui qui a rendu l’écosystème possible : un fichier GGUF embarque les poids, mais aussi les métadonnées (architecture, tokenizer, paramètres de quantization). Un seul fichier, lisible par llama.cpp, Ollama, LM Studio, et désormais — signal notable d’octobre 2026 — par Windows ML, qui a ajouté un support expérimental de llama.cpp pour les modèles GGUF, avec API locale compatible OpenAI. Quand Microsoft intègre votre format dans son runtime système, ce n’est plus un projet de niche.
Vient ensuite la question qui détermine tout ce que vous pouvez faire tourner : la quantization. Réduire la précision des poids (de 16 bits vers 4, 5 ou 8 bits) permet de diviser l’empreinte mémoire par deux à quatre, au prix d’une perte de qualité variable. Les schémas de référence — Q4_K_M, Q5_K_M, et la famille IQ (importance-aware) — sont des compromis finement calibrés : Q4_K_M est réputé pour offrir le meilleur rapport taille/qualité, Q5_K_M pour les machines un peu plus confortables, les variantes IQ poussant plus loin l’optimisation pour les contextes contraints. Les sources officielles de 2026 ne détaillent pas les évolutions récentes de ces formats ; on sait seulement que l’app Llama expose un réglage de quantization décrit comme « la précision maximale qui tient en mémoire » — ce qui résume assez bien l’arbitrage : on choisit d’abord ce qui rentre, on optimise ensuite.
C’est ce couple ggml/GGUF qui explique la longévité du projet. Là où d’autres runtimes dépendent d’un framework lourd (PyTorch, CUDA exclusif, bibliothèques propriétaires), llama.cpp compile partout, du Raspberry Pi au serveur multi-GPU, avec le même binaire et le même format de fichier. La portabilité n’est pas un argument marketing : c’est une décision architecturale prise dès le premier jour, et qui paie encore en 2026.
Backends et offloading : ce qui se passe quand on passe du CPU au GPU
Un moteur ne tourne pas « sur du matériel » dans l’abstrait : il tourne sur des backends, c’est-à-dire des implémentations spécialisées des opérations de ggml pour chaque famille de processeurs et de cartes. Côté CPU, cela signifie exploiter les jeux d’instructions AVX2, AVX-512 sur x86 et NEON sur ARM (Apple Silicon, Snapdragon, Graviton). Côté GPU, cela signifie CUDA pour NVIDIA, Metal pour Apple, Vulkan pour à peu près tout le reste, ROCm/HIP pour AMD, SYCL pour l’écosystème Intel. La force de llama.cpp est de faire cohabiter ces backends dans un même binaire, avec un multi-backend dynamique qui choisit à l’exécution où envoyer chaque opération.
Le réglage qui cristallise tout, c’est l’offloading, piloté par le fameux paramètre -ngl (number of GPU layers). Le principe : le modèle est découpé en couches, et l’on décide combien de couches résident sur le GPU plutôt qu’en RAM système. Plus vous en déchargez, plus l’inférence accélère — jusqu’au point où la VRAM déborde, et où le moteur se met à faire des allers-retours coûteux entre mémoire GPU et mémoire hôte. Le bon réglage n’est donc pas « le maximum », mais « le maximum qui tient ». C’est un art de l’ajustement, et c’est là que les utilisateurs se perdent.
Pourquoi le support de Vulkan et Metal a changé la donne ? Parce qu’il a ouvert l’accélération GPU à du matériel qui n’a jamais eu droit aux faveurs de CUDA : les Mac M-series via Metal, les GPU intégrés AMD via Vulkan, les puces graphiques de mini-PC. Les mesures indépendantes publiées en 2026 le confirment : sur un iGPU AMD Radeon 780M, les optimisations Vulkan de llama.cpp ont apporté un gain d’inférence d’environ +50 %, et un simple réglage MMVQ (matrice-vecteur quantifiée) a ajouté +12,9 % supplémentaires. Sur ce même iGPU, on atteint environ 10-12 tok/s avec Llama 3 8B en Q4 et Qwen 2.5 7B, et 8-11 tok/s avec Mistral 7B Q4_K_M. Ce ne sont pas des vitesses de course, mais c’est utilisable — et c’est exactement le genre de machine que llama.cpp est seul à servir correctement.
KV cache, batching continu et speculative decoding : les réglages qui font gagner (ou perdre) des tokens par seconde
Trois mécanismes internes déterminent ce que vous ressentirez comme « rapide » ou « poussif ». Le premier est le KV cache : pour éviter de recalculer l’attention sur tout l’historique à chaque nouveau token, le moteur stocke les clés et valeurs des tokens déjà traités. Ce cache coûte de la mémoire, et son coût croît linéairement avec la taille du contexte et le nombre de couches. D’où les techniques de quantization du cache (stocker les clés/valeurs en 8 ou 4 bits), et les stratégies de gestion type paged attention, qui fragmentent le cache pour mieux le réutiliser entre requêtes. Plus votre contexte est long, plus le cache pèse — un point que les utilisateurs découvrent souvent trop tard, quand leur modèle « qui rentrait » ne rentre plus.
Le deuxième est le batching continu. En serving multi-requêtes, le moteur n’attend pas qu’une génération se termine pour en démarrer une autre : il insère dynamiquement de nouvelles séquences dans le lot en cours. Résultat : le débit global grimpe, même si la latence par requête peut légèrement augmenter. C’est ce qui distingue un moteur de serving d’un simple script d’inférence.
Le troisième est le speculative decoding. Le principe : un petit modèle « brouillon » propose plusieurs tokens d’avance, et le grand modèle les valide en une seule passe. Si le taux d’acceptation est bon, on gagne des tokens par seconde sans aucune perte de qualité — c’est un accélérateur exact, pas une approximation. L’app Llama l’active automatiquement si le modèle le supporte. Mais le gain dépend entièrement du taux d’acceptation, lui-même dépendant de la proximité entre modèle brouillon et modèle cible : sur certains couples, on gagne beaucoup ; sur d’autres, on paie le coût du brouillon pour rien. C’est un réglage à tester, pas à activer les yeux fermés.
Enfin, la taille de contexte et le batch size interagissent avec tout cela. L’app Llama note que le batch size est plus grand sur les Mac disposant de 32 Go ou plus — logique : plus de mémoire unifiée permet de traiter plus de tokens en parallèle. C’est un rappel utile : sur ce moteur, la performance n’est pas une propriété du logiciel seul, mais du couple logiciel/matériel/réglages.
Ce que ça change concrètement : faire tourner des modèles sur matériel modeste
Traduisons en arbitrages utilisateur. Les paliers officiels de l’app Llama donnent un point de départ honnête : Gemma 4 dès 16 Go de RAM, GPT-OSS dès 24 Go, Qwen 3.8 dès 32 Go. Ces seuils ne disent pas « ça tourne vite », ils disent « ça rentre ». C’est la première question à se poser, et souvent la seule qui compte : un modèle qui déborde en swap est inutilisable, quelle que soit sa qualité.
Pourquoi Q4_K_M est-il si souvent le point d’équilibre ? Parce qu’il divise l’empreinte par rapport au 16 bits tout en préservant l’essentiel de la qualité, et qu’il laisse de la place au KV cache et au système. Un modèle 8B en Q4_K_M tient confortablement sur 8 Go de VRAM ; le même en Q8_0 devient limite. Le cache Hugging Face partagé, lui, évite le fléau du re-téléchargement : un modèle téléchargé une fois est réutilisé par llama.cpp, l’app Llama et les autres outils qui pointent vers le même cache.
Les configurations typiques se répartissent en trois familles. CPU seul : les Ryzen récents et l’Apple Silicon s’en sortent honorablement sur des modèles 7-8B quantifiés, avec l’avantage de la mémoire unifiée sur Mac. GPU grand public : une RTX 3060 (12 Go) ou une RTX 4090 (24 Go) change complètement l’expérience, à condition de bien régler -ngl. Configurations hybrides : c’est là que llama.cpp brille, en répartissant les couches entre GPU et CPU selon la mémoire disponible — un compromis imparfait mais qui rend possible ce qui ne rentrerait nulle part.
L’écart entre modèles « raisonnables » et modèles « frontière » reste vertigineux. Ollama distribue Llama 4 Scout (MoE de 109 milliards de paramètres, 17 milliards actifs) et Maverick (400 milliards, 17 milliards actifs), tous deux multimodaux natifs. Ces modèles ne tournent pas sur une machine de bureau standard ; ils illustrent la frontière. Entre un Gemma 4 qui tient sur 16 Go et un Maverick de 400 milliards, il y a un ordre de grandeur — et c’est précisément cet ordre de grandeur que llama.cpp permet de franchir progressivement, configuration après configuration.
La guerre des runtimes : llama.cpp face à Ollama, LM Studio et aux offres propriétaires
Il faut clarifier une confusion tenace : llama.cpp n’est pas un concurrent d’Ollama ou de LM Studio. C’est leur moteur. Ollama et LM Studio sont des distributions clés en main qui embarquent llama.cpp (ou une variante) et ajoutent une couche de confort : gestion des modèles, interface, commandes simplifiées. Quand vous lancez un modèle dans Ollama, c’est souvent llama.cpp qui travaille en dessous. La comparaison pertinente n’est donc pas « llama.cpp vs Ollama », mais « moteur nu vs distribution ».
Face aux runtimes serveur — vLLM, SGLang, TensorRT-LLM — l’arbitrage est différent. Ces moteurs sont optimisés pour le débit maximal en datacenter, avec du batching agressif, du paged attention sophistiqué et une exploitation fine du matériel NVIDIA. Sur un serveur multi-GPU qui doit servir des centaines de requêtes, ils gagnent. Mais ils supposent une infrastructure, des dépendances lourdes, et souvent du matériel spécifique. llama.cpp gagne sur la portabilité et l’empreinte : un binaire, un fichier GGUF, et ça tourne sur un laptop, un mini-PC ou un serveur modeste. Ce n’est pas le même métier.
Face à MLX (Apple), la question est plus subtile : MLX est taillé pour l’Apple Silicon et peut offrir de meilleures performances sur Mac. Mais llama.cpp reste le seul à couvrir à la fois Mac, Windows, Linux, NVIDIA, AMD, Intel et CPU pur, avec le même format de fichier. C’est cette universalité qui explique sa position de socle. Un comparatif de 48 outils d’inférence locaux publié en septembre 2026 confirme d’ailleurs la centralité des runtimes compatibles GGUF et API OpenAI dans l’écosystème.
Les limites persistent. Les sources publiques de 2026 ne fournissent pas de benchmarks récents comparant llama.cpp à vLLM ou MLX sur des charges réelles — un manque de transparence qui profite aux chiffres marketing. Le projet dépend de mainteneurs bénévoles, et la fragmentation des backends (CUDA, Metal, Vulkan, ROCm, SYCL) est une richesse autant qu’un fardeau de maintenance.
Gouvernance, releases et signaux à surveiller : pourquoi le moteur refuse de mourir
La longévité de llama.cpp tient à trois choses. D’abord, une gouvernance communautaire : le projet vit sous l’organisation ggml-org, avec une équipe identifiée (« the llama.cpp team ») et un partenariat affiché avec Hugging Face pour l’app Llama. Ensuite, un rythme de release soutenu : la version v0.5.0 est documentée en septembre 2026 comme apportant « le dernier backend, des changements de modèles et de serveur », avec des guides d’installation et de vérification GPU. Enfin, une adoption en cascade : Windows ML intègre llama.cpp pour les GGUF en octobre 2026, Ollama propose des intégrations d’agents de code (claude, opencode, hermes, openclaw) avec llama4, et les outils d’agents s’appuient sur son API.
Ce qu’il faut surveiller : la transparence des benchmarks. Les releases annoncent des gains CPU/GPU, mais les sources disponibles ne les détaillent pas chiffre par chiffre. Le soutien des sponsors et la santé des mainteneurs sont des angles morts documentaires. Le risque de fork ou d’essoufflement existe, comme pour tout projet bénévole. Et l’éventuelle standardisation de GGUF — déjà amorcée par son adoption dans Windows ML — serait un signal fort : un format standardisé survit à ses mainteneurs.
Mesurer sans se mentir : repères de performance et pièges des benchmarks
Comment évaluer llama.cpp chez soi ? L’outil officiel, llama-bench, mesure le prompt processing et la génération de tokens dans des conditions contrôlées. C’est le point de départ. Mais les chiffres publics sont rares et peu comparables : matériel différent, quantization différente, taille de contexte différente, batch différent. Un « 40 tok/s » sans préciser le modèle, la quantization, le contexte et le matériel ne veut rien dire.

Les mesures indépendantes (r/LocalLLaMA, blogs techniques) existent et sont précieuses — c’est d’elles que viennent les chiffres cités plus haut sur le Radeon 780M (10-12 tok/s en Llama 3 8B Q4, +50 % via Vulkan, +12,9 % via MMVQ). Mais elles aussi varient. La bonne pratique : mesurer soi-même, en distinguant prompt processing (traitement du prompt, souvent rapide) et génération (token par token, plus lente), en notant la latence TTFT (time to first token) et l’empreinte mémoire réelle. Et se méfier des chiffres marketing : l’app Llama annonce 1 Mo de téléchargement et 4 Mo installée — c’est vrai, mais cela ne dit rien de la performance, seulement de la légèreté du binaire. Enfin, ne confondez jamais les modèles Llama (de Meta) et le moteur llama.cpp : le premier est un modèle, le second est le logiciel qui le fait tourner.
Ce que llama.cpp change pour l’IA locale (et ce qu’il ne changera pas)
En 2026, llama.cpp reste la colonne vertébrale parce qu’il résout deux problèmes que personne d’autre ne résout aussi bien : la portabilité (un format, un binaire, tous les matériels) et l’efficacité mémoire (quantization, offloading, KV cache maîtrisé). Pas parce qu’il serait le plus rapide — sur un datacenter, vLLM le bat ; sur un Mac, MLX peut le devancer. Mais sur la diversité des machines réelles, il est seul.
Ce qu’il change : la démocratisation de l’IA hors ligne, l’intégration dans les agents de code, le cache partagé qui évite le gaspillage, l’API compatible OpenAI qui rend tout interopérable. Ce qu’il ne change pas : les limites matérielles (RAM, bande passante mémoire), la complexité des réglages (quantization, offloading, KV cache), la dépendance à un écosystème de mainteneurs. Les signaux à suivre : les releases 2026, les benchmarks indépendants, l’adoption par les entreprises, et l’éventuelle standardisation de GGUF. Le moteur refuse de mourir parce qu’il a compris, avant tout le monde, que l’IA locale ne se joue pas sur la vitesse brute, mais sur la capacité à tourner partout. Et ça, aucun benchmark ne le mesurera jamais.
Sources
- llama.app — site officiel de l’app Llama (llama.cpp team & Hugging Face)
- Ollama — bibliothèque llama4
- Meta AI — modèles Llama
- Wikipédia — Llama (language model)
- Techgenyz — Windows ML: 2026 Updates for GGUF Models and Local AI (9 octobre 2026)
- Microsoft Foundry on Windows Blog — AI Development on Windows: from PyTorch and llama.cpp to Windows ML (7 octobre 2026)
- gyanaangan.in — llama.cpp v0.5.0 in 2026: What Changed, How to Install, Run GGUF & Use the Local API (27 septembre 2026)
- quelllm.fr — Performance LLM sur GPU AMD Radeon 9070XT (25 septembre 2026)
- promptquorum.com — Moteurs d’inférence et runtimes locaux : comparatif 2026 (20 septembre 2026)
- contextstudios.ai — Décodage spéculatif : le seul gain de vitesse sans perte (19 septembre 2026)
- lecompute.fr — Décodage spéculatif : quand un petit modèle accélère votre LLM (13 septembre 2026)
- briefia.fr — Faire tourner une IA en local en 2026 : guide complet (18 septembre 2026)
- Hugging Face — The Best Open Source and Open-Weight LLM Models to Run Locally in 2026
- Spheron — Best Open-Source LLMs to Self-Host in 2026: VRAM Tier Guide
- memeburn.com — Best Hardware for Running Open-Source AI Models Locally in 2026
- freeainews.com — LLaMA.cpp 2026 Release: Faster CPU and GPU Inference
Article recherché et rédigé automatiquement · Magazine Electrosens