
 LLM Tools · 16 October 2026
Schémas d’outils : l’art discret qui décide si votre agent LLM fonctionne ou hallucine
En juin 2023, des avocats new-yorkais déposaient six arrêts de justice inventés devant un tribunal fédéral — et écopaient de 5 000 dollars d’amende. Trois ans plus tard, les agents LLM échouent encore massivement en production : 88 % selon les données 2026. Le coupable n’est presque jamais le modèle. C’est le contrat JSON qu’on lui tend.
Le jour où six arrêts de justice inventés ont coûté 5 000 dollars
L’affaire est devenue un classique. En juin 2023, le cabinet new-yorkais Levidow, Levidow & Oberman dépose devant un tribunal fédéral six arrêts de justice… qui n’existent pas. Ils ont été générés par ChatGPT. Le juge inflige une amende de 5 000 dollars aux avocats. À l’époque, tout le monde accuse le modèle : « les LLM hallucinent ». Sauf que le vrai problème n’était pas là. Le problème, c’était l’interface entre le modèle et le réel — un humain qui recopie sans vérifier la sortie d’un système qui n’a jamais eu accès à une base de jurisprudence.
Trois ans plus tard, la leçon n’a pas été tirée partout. Les chiffres de 2026 sont brutaux : 88 % des agents IA échouent en production. Un agent de support client non surveillé dépasse les 30 % de tâches ratées après seulement trois semaines d’exploitation. Et le facteur d’amplification des hallucinations dans les agents multi-étapes est estimé entre 3 et 8x — un chiffre qu’il faut prendre avec prudence, car il circule sans méthodologie publique, mais qui dit quelque chose d’important : plus un agent enchaîne d’étapes, plus une erreur initiale se propage.
La thèse de ce dossier est simple, et elle contrarie la plupart des intuitions : la majorité des échecs d’agents en production ne sont ni des échecs de prompt, ni des échecs de choix de modèle. Ce sont des échecs de design de schéma d’outil. Le tool calling ne se joue pas dans le system prompt. Il se joue dans le JSON que vous exposez à l’agent : les noms d’outils, leur granularité, leurs descriptions, leurs types, leurs enums, la façon dont ils renvoient leurs erreurs, et la manière dont ils sont versionnés.
C’est un art discret. Personne n’en parle dans les keynotes. Et c’est précisément pour ça qu’il décide de tout.
Un outil, trois métadonnées : name, description, parameters
Un outil exposé à un LLM tient en trois métadonnées, et c’est à peu près tout : un name, une description, et un parameters — le schéma JSON des arguments. Cette structure est confirmée par de multiples sources pédagogiques indépendantes (codegym, pyai.io, apidog, kitlab), et elle est stable depuis l’introduction du function calling.
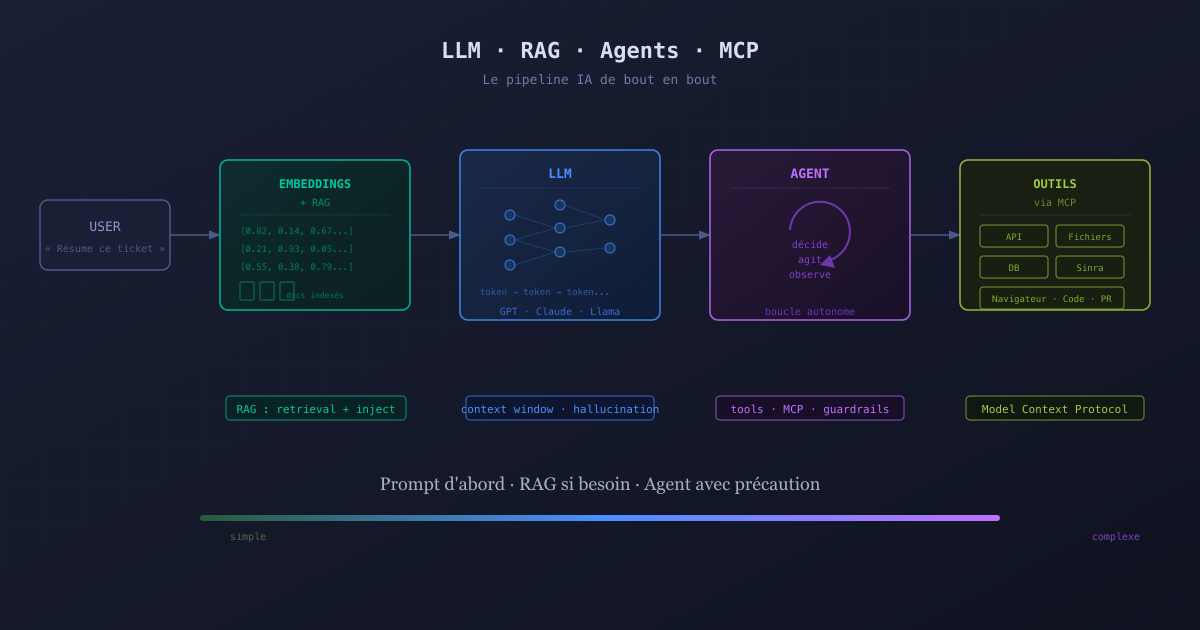
Le point fondamental, répété par toutes les sources : le modèle n’exécute jamais rien. Il génère une requête structurée — généralement du JSON — que le runtime (votre code applicatif, un serveur MCP, un Agents SDK) exécute. Le modèle est un générateur de texte contraint. L’outil est un contrat entre ce générateur et votre code.
Le schéma JSON minimal comporte trois briques : type: object, properties, et required. L’exemple canonique qui circule partout est get_weather : une propriété city de type string, une propriété unit de type enum avec deux valeurs (celsius, fahrenheit), et city listé dans required. Les types primitifs supportés sont string, integer, number, boolean, array (avec items), object (avec properties), et null — ce dernier s’exprimant souvent via un type composite comme ["string", "null"].
À côté de ce schéma propre, il y a le contre-exemple qu’on voit dans à peu près tous les prototypes : un outil nommé doStuff, une description qui dit « fait des trucs », et un paramètre data de type object sans propriétés déclarées. Ce schéma est valide au sens JSON Schema. Il est aussi inutile : le modèle ne sait pas quoi mettre dans data, donc il invente. Et ce qu’il invente, votre runtime va l’exécuter.
La maxime qui revient dans la littérature est limpide : « tools are a contract ». Un outil, c’est un contrat. Pas une étiquette, pas un commentaire, pas une docstring qu’on espère que le modèle lira. Un contrat exécutable.
Ce qui se passe vraiment entre le schéma et l’appel
Il faut comprendre la mécanique interne pour comprendre où ça casse. Quand un modèle « appelle un outil », il ne fait pas un appel de fonction au sens informatique. Il génère une séquence de tokens qui, mise bout à bout, forme un objet JSON conforme — ou censé l’être — au schéma que vous avez fourni.
Deux régimes coexistent. Le premier est le JSON mode : on demande au modèle de produire du JSON valide, sans garantie sur le contenu. Le second est le function calling avec décodage contraint par grammaire (grammar-constrained decoding) : le décodeur est contraint token par token pour ne produire que des séquences conformes au schéma. C’est ce qui explique qu’un modèle puisse produire un JSON syntaxiquement parfait… et sémantiquement absurde.
Le paramètre tool_choice est le levier de contrôle : auto laisse le modèle décider, none désactive les outils, required force un appel, et une valeur explicite force un outil nommé. C’est un paramètre central, et pourtant absent de la plupart des tutoriels francophones — ce qui en dit long sur le niveau de rigueur moyen.
Où sont les points de défaillance ? Il y en a trois, et ils sont distincts :
- Le schéma lui-même : trop profond, trop ambigu, mal typé. Le modèle génère un appel conforme à un mauvais contrat.
- La génération : le schéma est bon, mais le modèle hallucine un argument — une ville inexistante, une date impossible, un identifiant inventé. Un schéma correct ne garantit pas un appel correct.
- La validation aval : personne ne vérifie l’appel avant de l’exécuter. C’est le point le plus meurtrier, et le plus facile à corriger.
Un schéma correct est une condition nécessaire. Ce n’est jamais une condition suffisante.
Un outil fourre-tout ou dix outils fins : la granularité comme premier levier
C’est le débat le plus concret du design d’outils, et il n’a pas de réponse universelle — seulement des règles empiriques.
D’un côté, l’outil fourre-tout : search_and_book_everything(query, options). Un seul outil, un seul schéma, une seule description. Simple à écrire, catastrophique à faire fonctionner. Le modèle doit deviner, à partir d’une description unique, s’il doit chercher, vérifier une disponibilité, ou réserver. Il se trompe souvent. Et quand il se trompe, le retour d’erreur est un pavé illisible qui ne lui permet pas de se corriger.
De l’autre côté, les outils fins : search_flights, check_availability, book_flight. Trois outils, trois schémas, trois descriptions. Le modèle choisit mieux, parce que chaque outil a une intention claire. Les erreurs sont localisées : si check_availability échoue, on sait exactement quoi corriger. Et chaque outil est testable indépendamment — ce qui, en pratique, est le seul moyen de faire des tests de non-régression sur un agent.
Les règles pratiques qui émergent de la littérature 2026 :
- Un outil = une intention. Si vous hésitez entre deux descriptions pour un même outil, c’est qu’il faut le scinder.
- Un seuil de vigilance autour de 10 à 15 outils par agent. Au-delà, la précision de sélection chute et le schéma global consomme du contexte pour rien. Les architectures qui exposent 15 serveurs MCP finissent par n’en solliciter qu’une demi-douzaine par tâche — signe qu’il faut filtrer dynamiquement plutôt que tout exposer.
- Le signal qu’un outil doit être scindé : quand sa description contient « ou », quand ses paramètres sont majoritairement optionnels, quand ses retours d’erreur sont hétérogènes.
La granularité n’est pas une question d’esthétique. C’est le premier levier de fiabilité, et le moins coûteux à actionner.
La description est un contrat, pas une étiquette
Si vous ne retenez qu’une chose de ce dossier, retenez celle-ci : la description d’un outil n’est pas une étiquette, c’est une spécification opérationnelle. Elle joue le rôle d’instruction pour le modèle, exactement comme la description d’un champ joue le rôle de prompt pour le remplissage de ce champ.
Une bonne description répond à six questions :
- Quand utiliser l’outil ? (« Utilise cet outil quand l’utilisateur demande une météo actuelle ou prévue. »)
- Quand ne pas l’utiliser ? (« N’utilise pas cet outil pour des données historiques : utilise
get_historical_weather. ») - Quel est le format des entrées ? («
citydoit être un nom de ville en anglais, sans code postal. ») - Quel est le format des sorties ? (« Renvoie une température en degrés et une condition textuelle. »)
- Quels sont les cas limites ? (« Si la ville est ambiguë, renvoie une erreur
AMBIGUOUS_CITYavec la liste des candidats. ») - Que faire en cas d’échec ? (« En cas d’erreur transitoire, réessaie une fois avant d’abandonner. »)
Comparez maintenant deux versions réelles qu’on trouve dans la nature. Version bâclée : description: "Récupère la météo." Version contractuelle : description: "Récupère la météo actuelle pour une ville donnée. Utilise cet outil uniquement pour des données présentes ou à moins de 7 jours. Pour l'historique, utilise get_historical_weather. La ville doit être un nom en anglais. Si plusieurs villes correspondent, l'outil renvoie AMBIGUOUS_CITY."
La différence de comportement est massive. Et elle est plus grande qu’un changement de modèle — parce qu’un modèle plus puissant avec une description floue produira une réponse plus convaincante, pas plus correcte.
Pièges de typage : enums, optionalité, additionalProperties et strict mode
Le typage est l’endroit où les équipes perdent le plus de temps en débogage, parce que les erreurs y sont silencieuses.
Piège 1 — le string libre au lieu d’un enum. Un champ unit: string au lieu de unit: enum ["celsius", "fahrenheit"] invite le modèle à inventer "C", "degC", "metric". Un enum ferme la porte. C’est la correction la plus rentable du catalogue.
Piège 2 — l’optionalité mal marquée. Un champ non listé dans required est optionnel. Un champ optionnel que le modèle oublie produit un appel incomplet que votre runtime doit gérer. La règle : si un champ est nécessaire au fonctionnement de l’outil, il doit être dans required. Pas dans la description. Dans required.
Piège 3 — additionalProperties laissé ouvert. Par défaut, JSON Schema autorise des propriétés non déclarées. Le modèle peut donc ajouter des champs fantaisistes qui passeront la validation. Le passer à false est une pratique de base.
Piège 4 — les types null mal gérés. Un champ nullable doit être déclaré explicitement (type: ["string", "null"]), sinon le modèle produit null là où vous attendez une chaîne, et votre code plante.
Piège 5 — l’imbrication excessive. Un schéma à quatre niveaux d’objets imbriqués est difficile à générer correctement et impossible à déboguer. Aplatissez.
Sur le strict mode, les comportements diffèrent selon les fournisseurs. OpenAI a popularisé un mode strict qui garantit la conformité au schéma, mais qui impose des contraintes (toutes les propriétés doivent être dans required, additionalProperties: false obligatoire). Anthropic expose un champ racine tools[] avec un input_schema et un tool_choice de sélection forcée. Google et Mistral ont leurs propres conventions. La conséquence pratique est claire : un schéma portable entre fournisseurs est un schéma conservateur — enums partout, required exhaustif, pas d’imbrication, pas de types exotiques.
Checklist de typage avant mise en production :
| Vérification | Statut attendu |
|---|---|
| Chaque champ contraint est un enum | Oui |
Tous les champs nécessaires sont dans required |
Oui |
additionalProperties: false |
Oui |
| Types null déclarés explicitement | Oui |
| Profondeur d’imbrication ≤ 2 | Oui |
| Descriptions de champs renseignées | Oui |
| Testé avec le strict mode du fournisseur cible | Oui |
Quand l’outil échoue : erreurs structurées, retours lisibles, reprise d’agent
Un mauvais retour d’erreur transforme une erreur en hallucination. C’est mécanique : si l’outil renvoie Error 500 ou une stack trace, le modèle n’a aucune prise pour se corriger — alors il improvise, et l’improvisation s’appelle une hallucination.
La gestion des erreurs doit donc être partie intégrante du schéma. Trois principes :
1. Des codes d’erreur normalisés. Pas de messages libres. Un enum d’erreurs : NOT_FOUND, INVALID_ARGUMENT, RATE_LIMITED, UNAUTHORIZED, TRANSIENT. Le modèle peut alors raisonner sur la catégorie.
2. Des messages actionnables. « Ville introuvable. Essayez avec le nom complet ou vérifiez l’orthographe. » est actionnable. « Erreur » ne l’est pas.
3. La distinction transitoire / définitive. Une erreur TRANSIENT justifie un retry. Une erreur INVALID_ARGUMENT justifie une reformulation. Une erreur UNAUTHORIZED justifie un arrêt et une remontée à l’utilisateur. Si votre schéma ne distingue pas ces cas, l’agent ne peut pas choisir la bonne stratégie — et il en choisira une mauvaise.
Les patterns de reprise qui fonctionnent : retry borné (une ou deux tentatives, jamais de boucle infinie), fallback vers un outil alternatif, et clarification — demander à l’utilisateur plutôt que d’inventer. Ce dernier pattern est sous-utilisé, alors qu’il est le plus sûr.
Un point d’attention sur les coûts : chaque aller-retour de tool calling coûte de la latence (de l’ordre de 800 ms par aller-retour selon les données 2026) et des tokens. Un agent non optimisé peut coûter environ 200 dollars par mois là où un agent correctement architecturé tient entre 29 et 50 dollars. La gestion d’erreur n’est pas qu’une question de fiabilité : c’est aussi une question de facture.
Versionner sans casser : compatibilité ascendante et dépréciation d’outils
Voici un problème que peu d’équipes anticipent : vos agents en production ont mémorisé votre schéma. Pas au sens littéral — mais leurs comportements, leurs prompts, leurs tests et leurs traces sont calibrés sur une version donnée. Changer un schéma, c’est changer un contrat avec des consommateurs vivants.
Les règles de versioning qui tiennent :
- Ajouter un champ optionnel : sûr. Les agents existants continuent de fonctionner.
- Ajouter un champ requis : cassant. À éviter, ou à accompagner d’une valeur par défaut.
- Renommer un champ : cassant. Préférez un alias temporaire.
- Supprimer un champ ou un outil : jamais brutalement. Dépréciation progressive, avec une période de double exposition.
- Changer un type : cassant. Traitez-le comme un nouvel outil.
La gouvernance compte autant que la technique. Qui valide un changement de schéma ? Idéalement, la même personne qui valide une migration de base de données — parce que c’est exactement le même type de risque. Le déploiement doit être accompagné de tests de non-régression sur les traces réelles : rejouer les appels historiques contre le nouveau schéma et vérifier que le taux de succès ne chute pas.
Sur le plan réglementaire, l’EU AI Act transfère la responsabilité au déployeur, pas au fournisseur du modèle. Autrement dit : si votre agent casse quelque chose, c’est vous. Le versioning de schéma n’est pas un détail d’ingénierie, c’est une ligne de défense juridique.
Patterns émergents 2026 : schémas générés, validation en amont, tests de schéma
L’année 2026 a vu trois mouvements de fond qui changent la donne.
Premier mouvement : la génération automatique de schémas. On dérive désormais les schémas d’outils depuis des sources existantes — spécifications OpenAPI, typings TypeScript, signatures Python. LangChain le fait depuis longtemps avec son décorateur @tool, qui dérive le nom de la fonction, la description de la docstring et le schéma des indications de type. Microsoft documente trois familles de schémas d’outils : les plugins API (OpenAPI, statiques), MCP (découverte dynamique) et Agent-to-Agent. La génération réduit les erreurs de recopie, mais elle ne remplace pas la relecture : un schéma généré depuis une API mal conçue reste un mauvais schéma.
Deuxième mouvement : la validation en amont par contraintes de grammaire. Le décodage contraint progresse — des travaux comme SchemaFill explorent le décodage spéculatif slot-parallèle et rapportent jusqu’à 4,05x d’amélioration de débit sur des benchmarks comme Glaive et BFCL. Ces gains portent sur la vitesse, pas sur la précision du design de schéma — mais ils rendent les schémas riches moins coûteux à exposer.
Troisième mouvement : les tests de schéma comme tests unitaires. Le Berkeley Function Calling Leaderboard (BFCL), référence académique du domaine, en est à sa V4 — une évaluation agentique holistique qui distingue les modèles à support natif du function calling (FC) de ceux qui contournent via génération de texte (Prompt). Il mesure l’Overall Accuracy, le coût en dollars, la latence, et une « format sensitivity » — mais uniquement pour les modèles non-FC. C’est un signal fort : la sensibilité au format est reconnue comme un axe d’évaluation, même si les chiffres publics manquent encore cruellement. Il n’existe à ce jour aucune étude indépendante quantifiant l’impact des noms explicites vs ambigus, des descriptions détaillées vs minimales, ou des enums vs strings libres. C’est une lacune du domaine, et il faut le dire clairement plutôt que d’inventer des chiffres.
Le protocole MCP s’est imposé comme couche de standardisation. La spec du 28 juillet 2026 a introduit le mode stateless, OAuth 2.1 et déprécié SSE. Safari 27 embarque un serveur MCP natif avec 17 outils d’automatisation — et, ironie, aucun contrôle MDM pour les désactiver. Cinema 4D 2026.4 intègre un serveur MCP pour Claude et ChatGPT. Les prédictions d’adoption par les éditeurs SaaS tablent sur 60 % en 2027. Autrement dit : les schémas d’outils deviennent une infrastructure, avec les mêmes exigences que n’importe quelle API publique.
Grille de relecture finale en 10 points
Avant de brancher un agent sur un système réel, passez chaque outil au crible :
- Nom explicite — un verbe et un objet, sans ambiguïté.
- Description contractuelle — quand utiliser, quand ne pas utiliser, formats, cas limites.
- Un outil = une intention — pas de fourre-tout.
- Enums partout où l’espace de valeurs est fini.
requiredexhaustif — tout champ nécessaire y figure.additionalProperties: false— pas de champs fantômes.- Profondeur d’imbrication ≤ 2 — schéma plat, lisible.
- Erreurs structurées — codes normalisés, messages actionnables, distinction transitoire/définitif.
- Versioning documenté — qui valide, comment on déprécie, quels tests de non-régression.
- Traces exploitables — chaque appel journalisé avec assez de contexte pour devenir un test de régression.
Ce que ça change pour les équipes est simple à énoncer et difficile à exécuter : le schéma d’outil devient un artefact de première classe. Versionné comme du code, testé comme du code, revu comme du code. Ce n’est pas la partie glamour du travail sur les agents. C’est la partie qui décide si votre agent fonctionne — ou s’il invente six arrêts de justice.
Sources
- Tool-Calling Schema Design for LLM Agents (2026 Production Pattern)
- LLM Function Calling and Tool Use Guide 2026: OpenAI, Anthropic, Google
- LLM Tool Calling — How AI Agents Use Functions (2026)
- Function Calling & Tool Use Patterns in Production LLM Applications
- How Do You Build Reliable LLM Tool Calling in Production?
- Berkeley Function Calling Leaderboard (BFCL)
- Traçage des appels d’outils d’agent IA : que journaliser à chaque requête
- 2026 MCP vs Function Calling : quelle couche d’outils choisir ?
- MCP 2026-07-28 : la nouvelle spec décryptée
- Safari 27 : le navigateur d’Apple se met à l’IA avec un serveur MCP
- Maxon a intégré un serveur MCP dans Cinema 4D 2026.4
- Hallucinations LLM : fiabilisation des agents (2026)
- IA : concepts RAG, agents, LLM
- Agent harness : le code autour du modèle
- Building Agent Tools — LangChain/LangGraph
- Cours ChatGPT Apps — codegym
- Schema-guided reasoning — vLLM
Article recherché et rédigé automatiquement · Magazine Electrosens