
 NVIDIA DGX Spark · 5 November 2026
DGX Spark 64 Go : ce que 4 999 $ achètent vraiment quand la mémoire devient rare
Le 23 octobre 2026, la DGX Spark 64 Go est arrivée en boutique à 4 999 dollars — plus cher, à sa sortie, que la version 128 Go ne l’était en 2025. Dans le même temps, le modèle 128 Go franchissait les 6 000 dollars sur le marché. La crise mémoire n’est pas un décor : c’est le moteur de toute l’opération. Et derrière l’arbitrage capacité/prix se cache une falaise technique que peu d’acheteurs mesurent avant de signer.
64 Go à 4 999 $ : la fiche technique qui cache un arbitrage
Il y a quelque chose d’étrange à écrire ces lignes. Depuis des mois, toutes les sources documentant le DGX Spark — de hardwareand.co à Ultralytics, en passant par les fiches constructeur — décrivaient une machine à 128 Go de mémoire unifiée LPDDR5X. Le chiffre était devenu un mantra : 128 Go, 273 Go/s de bande passante, 1 pétaFLOP en FP4. C’était la promesse du GB10 Grace Blackwell : faire tenir dans un boîtier de la taille d’un livre ce qui nécessitait naguère un rack.
Puis, début octobre 2026, NVIDIA a officialisé une variante à 64 Go pour 4 999 $ — rapportée notamment par The Register, ServeTheHome et TechPowerUp. Le titre de The Register est d’ailleurs sans ambiguïté : « Nvidia debuts $4,999 DGX Spark with half the RAM and storage, amid memory crunch ». La crise mémoire n’est pas un détail de contexte — c’est le moteur de toute l’opération.
Un détail que la couverture initiale a souvent mal lu : à son lancement, le 64 Go est plus cher que ne l’était le 128 Go en 2025. Kod.ru le relève sans détour — la nouvelle machine arrive à 4 999 $, soit 1 000 $ de plus que le prix de départ de l’originale 128 Go l’an dernier. Frandroid pose la bonne question dans son titre même : faut-il acheter deux petits plutôt qu’un gros ? Et Pause Hardware résume la situation d’un trait : le DGX Spark perd la moitié de sa mémoire mais conserve son tarif de 4 999 dollars, tandis que la version 128 Go dépasse désormais les 6 000 $ sur le marché.
Car voilà le vrai sujet. Dans une architecture à mémoire unifiée, « 64 Go » ne veut pas dire « moitié moins de tout ». Cela veut dire : moitié moins de place pour les poids du modèle, moitié moins de place pour le KV-cache, moitié moins de marge pour les activations d’entraînement, et — selon les SKU — un quart du stockage NVMe. Chaque gigaoctet retiré se paie ailleurs, dans une monnaie qui n’est pas le dollar mais le contexte, la taille de modèle et la possibilité même de fine-tuner.
La thèse de cet article tient en une phrase : à 4 999 $, le problème du DGX Spark 64 Go n’est pas son prix, c’est la falaise technique qu’il installe silencieusement — et la seule façon de la contourner proprement, c’est d’en acheter deux.
GB10 : anatomie d’un SoC qui ne pardonne pas l’erreur de dimensionnement
Pour comprendre ce que 64 Go changent, il faut d’abord comprendre ce qu’est le GB10. Il s’agit d’un SoC co-conçu par MediaTek pour la partie CPU et NVIDIA pour la partie GPU, logé dans un package à chiplets. Côté CPU : un bloc Arm de 20 cœurs (10 Cortex-X925 + 10 Cortex-A725 selon Ultralytics). Côté GPU : un iGPU Blackwell dont hardwareand.co estime qu’il est logiquement comparable à une RTX 5070 de bureau — comparaison de tiers, non confirmée officiellement par NVIDIA, mais qui donne l’ordre de grandeur.
Le point crucial, c’est la mémoire. Le GB10 embarque de la LPDDR5X unifiée sur un bus 256 bits (16 canaux × 16 bits), cadencée à 4266 MHz, pour 273 Go/s de bande passante annoncée. CPU et GPU puisent dans le même pool. C’est élégant — pas de copie CPU→GPU, pas de PCIe à saturer — mais c’est aussi impitoyable : tout ce que vous allouez au KV-cache est retiré aux poids du modèle, et inversement.
Et c’est là que se joue la vraie contrainte. Pour l’inférence de grands modèles, le goulot d’étranglement n’est presque jamais la capacité mémoire — c’est la bande passante. Un modèle de 70 milliards de paramètres quantifié en Q4 pèse environ 40 Go. Il « tient » dans 64 Go. Mais à chaque token généré, il faut lire l’intégralité de ces 40 Go depuis la mémoire. À 273 Go/s, cela plafonne théoriquement autour de 6 à 7 tokens par seconde en décodage pur — et en pratique moins, une fois le KV-cache, l’overhead runtime et les couches non quantifiées pris en compte. La capacité vous dit si le modèle rentre. La bande passante vous dit à quelle vitesse il parle.
Le budget KV-cache, lui, se calcule avec une formule qu’il faut avoir en tête avant tout achat :
KV-cache (octets) = 2 × n_layers × n_kv_heads × head_dim × bytes_par_valeur × longueur_de_contexte
Le facteur 2 couvre les clés et les valeurs. Prenons un modèle 32B typique : une soixantaine de couches, un groupement GQA qui ramène les têtes KV à 8, une dimension de tête de 128, et — en FP16 — 2 octets par valeur. À 32 000 tokens de contexte, cela représente déjà plusieurs gigaoctets. À 128 000 tokens, on parle de l’ordre de 15 à 20 Go rien que pour le cache. Ajoutez les poids (≈ 20 Go en Q4 pour un 32B), l’overhead du runtime (2 à 4 Go), et vous voilà à 40-45 Go consommés — sur 64. La marge fond vite.
C’est cette arithmétique, plus que le prix, qui définit ce que le 64 Go peut et ne peut pas faire.
Ce que NVIDIA promet, ce que la quantification permet
La communication officielle de NVIDIA, reprise par blog.netics.fr, annonce le support de modèles jusqu’à 100 milliards de paramètres entièrement en local sur une seule unité, et jusqu’à 200 milliards sur deux unités en cluster. NeoTeo précise les tailles de modèles visées sur un ou deux systèmes, et cite le test fournisseur sur Qwen 3.8 27B — jusqu’à 1,7× les performances d’un seul système en configuration double.
Ces chiffres sont exacts au sens strict : un modèle de 100B en quantification très agressive (2-3 bits) peut effectivement tenir dans 64 Go. Mais « tenir » et « être utilisable » sont deux choses différentes. Le tableau ci-dessous confronte la promesse marketing à la réalité de la quantification, une fois le KV-cache et l’overhead comptés.
| Modèle | Quantification | Poids | Contexte max réaliste | Verdict sur 64 Go |
|---|---|---|---|---|
| Llama 3.1 8B | Q8 | ~8 Go | 128K confortable | ✅ Excellent |
| Qwen 2.5 32B | Q4_K_M | ~20 Go | 32K-64K | ✅ Bon compromis |
| Qwen 3.8 27B | Q4 | ~15-17 Go | 32K-64K | ✅ Sweet spot visé par NVIDIA |
| Mixtral 8x7B | Q4 | ~26 Go | 16K-32K | ⚠️ Serré |
| Llama 3.1 70B | Q4 | ~40 Go | 4K-8K | ⚠️ Contexte ridicule |
| DeepSeek-R1 distillé (70B) | Q4 | ~40 Go | 4K-8K | ⚠️ Idem |
| Modèle « 100B » annoncé | Q2/IQ2 | ~30-35 Go | 2K-8K | ⚠️ Tient, mais dégradé |
Le schéma est clair. Les modèles 70B tiennent en Q4, mais avec un contexte si court qu’ils en deviennent inutilisables pour tout ce qui ressemble à un agent ou à un RAG. Vous chargez 40 Go de poids, il vous reste 20 Go pour le cache — soit quelques milliers de tokens. Autant dire rien.
Les 27-32B sont le sweet spot. Un Qwen 2.5 32B en Q4_K_M laisse 40 Go de marge, ce qui autorise un contexte de 32K à 64K selon le groupement KV. C’est suffisant pour un agent local, pour du résumé de documents, pour du code assisté. C’est précisément la classe de modèles que NVIDIA met en avant dans ses propres tests (Qwen 3.8 27B), et c’est la configuration que je recommanderais à quiconque achète un 64 Go.
Les 8B, enfin, respirent. Un Llama 3.1 8B en Q8 ne consomme que 8 Go : le KV-cache peut s’étaler sur 128K sans étouffer. C’est le seul segment où le 64 Go ne se sent jamais à l’étroit.
Ce qu’il faut retenir : le 64 Go n’est pas un « 128 Go bridé ». C’est une machine qui change de catégorie d’usage. Elle fait tourner les 8B et les 27-32B admirablement. Elle fait tourner les 70B en mode dégradé. Elle ne fait pas tourner les 405B — ce que le 128 Go permet pourtant, comme le rappelle Geeky-Gadgets dans son test de deux DGX Spark en cluster, et ce que confirment les mesures canoniques : deux DGX Spark supportent jusqu’à 405 milliards de paramètres.
La falaise du fine-tuning : LoRA, QLoRA et le mur des 64 Go
C’est ici que l’arbitrage devient douloureux. L’inférence est un problème de lecture ; le fine-tuning est un problème d’écriture, et il coûte bien plus cher en mémoire.
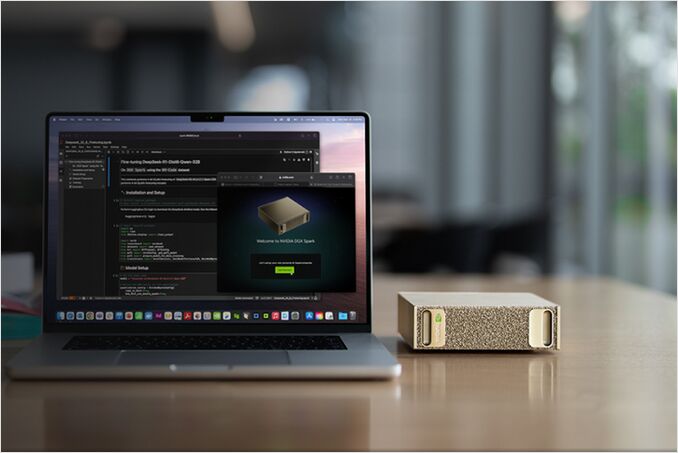
Fine-tuner un modèle, c’est empiler : les poids (gelés en QLoRA), les gradients (uniquement pour les adaptateurs LoRA, donc peu), les états d’optimiseur (Adam en garde deux copies par paramètre entraîné), les activations (qui explosent avec la taille de batch et la longueur de séquence), et le KV-cache si vous faites de l’entraînement sur séquences longues.
Sur un 70B en Q4, le LoRA est déjà à la limite. Les poids pèsent 40 Go. Les activations, même avec gradient checkpointing agressif, réclament 10 à 15 Go. Le KV-cache pour des séquences de 2 000 tokens ajoute quelques gigaoctets. On frôle le plafond en permanence, et la moindre augmentation de batch provoque un OOM.
Sur un 32B, QLoRA sauve la mise. Les poids en 4 bits tombent à 20 Go, les adaptateurs LoRA sont minuscules, et il reste assez de marge pour des séquences de 4 000 à 8 000 tokens. C’est la configuration réaliste pour qui veut personnaliser un modèle sur sa machine.
Le full fine-tuning, en revanche, est hors de portée. Un 8B en full fine-tuning exige déjà bien plus que 64 Go une fois gradients et états d’optimiseur comptés. Sur les gros modèles, n’y pensez même pas.
Le 128 Go change la donne sur ce terrain précis : la marge supplémentaire autorise des batches plus larges, des séquences plus longues, et surtout des checkpoints plus fréquents sans saturer le stockage. Ce dernier point mérite sa propre section.
NVMe en moins : ce que la perte de stockage change pour les pipelines RAG
Le DGX Spark 64 Go ne réduit pas seulement la RAM. Selon les SKU, il divise aussi le stockage NVMe — 1 To contre 4 To sur la Founders Edition, comme le documente Ultralytics. Et cette réduction est peut-être plus insidieuse que celle de la mémoire, parce qu’elle frappe des usages qu’on n’anticipe pas au moment de l’achat.
Premier cas : le RAG local. Un pipeline de génération augmentée par récupération, c’est un index vectoriel plus une base de documents. Un corpus de 50 000 documents techniques, une fois chunké et vectorisé en FP16, occupe facilement 20 à 40 Go. Ajoutez le modèle (20 Go), le KV-cache (10 Go), et vous voilà avec un disque de 1 To qui se remplit vite — sans compter les logs, les caches de tokenizer, les versions multiples de modèles.
Deuxième cas : les checkpoints de fine-tuning. Un checkpoint d’adaptateur LoRA est léger. Mais un checkpoint complet d’un 32B en Q4 pèse 20 Go. Si vous sauvegardez toutes les 500 étapes sur un entraînement de 5 000 étapes, vous générez dix checkpoints — 200 Go. Sur 4 To, c’est anodin. Sur 1 To, c’est un casse-tête de rotation.
Troisième cas : les datasets d’entraînement. Un corpus de fine-tuning de quelques gigaoctets de texte brut, plus ses versions tokenizées, plus les splits, plus les backups — la facture monte vite.
Externaliser via USB4/Thunderbolt ou via le réseau est possible, mais ajoute de la latence et de la complexité. Pour un pipeline RAG qui doit servir des requêtes en continu, un index vectoriel sur disque externe est un compromis médiocre. La perte de stockage n’est pas un détail : c’est une contrainte structurelle sur ce que vous pouvez construire.
128 Go vs 64 Go : le match sur quatre scénarios concrets
Confrontons les deux SKU sur des cas d’usage précis. Les chiffres de débit disponibles proviennent de mesures publiées sur le 128 Go et extrapolés avec prudence — je signale au passage une incohérence documentée dans les sources : certains benchmarks annoncent 49,7 tok/s là où d’autres mesurent 60,9 tok/s sur des configurations similaires. La variance est probablement due aux versions de runtime et aux paramètres de quantification.
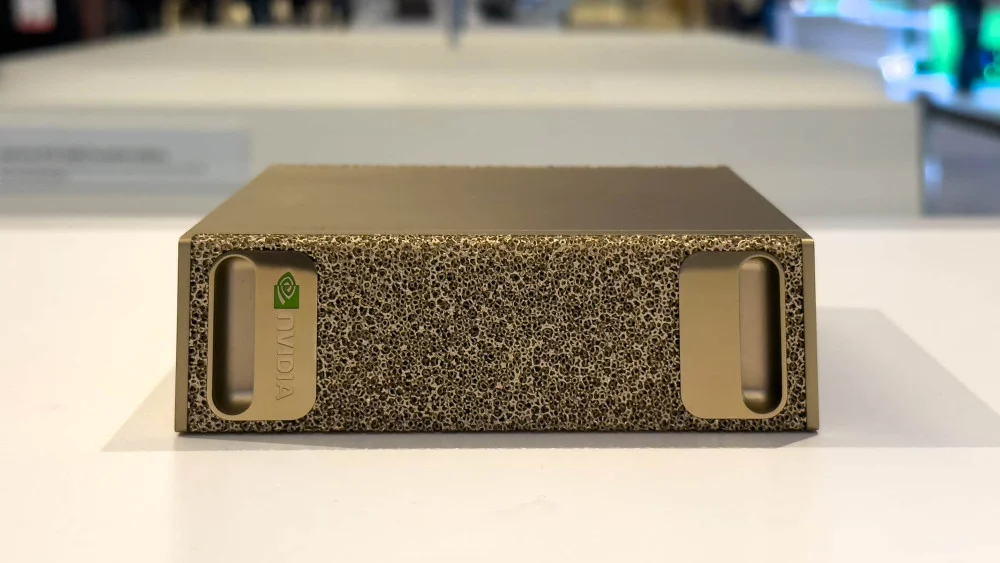
Scénario 1 — Agent local multi-outils avec contexte long. Un agent qui enchaîne les appels d’outils, garde l’historique de conversation et raisonne sur des documents. Sur 128 Go, un Qwen 3.6-27B tourne à 28-33 tokens/s en session unique, avec des pics de décodage à 163 tokens/s et 136 tokens/s avec 10 agents simultanés (données Alibaba). Sur 64 Go, le même modèle tient, mais le contexte disponible se réduit : là où le 128 Go gère 128K tokens, le 64 Go plafonne autour de 64K. Pour un agent à mémoire longue, c’est une différence perceptible.
Scénario 2 — Fine-tuning LoRA d’un 32B. Sur 128 Go : confortable, séquences de 8K, checkpoints fréquents. Sur 64 Go : faisable en QLoRA, mais avec des séquences plafonnées à 4K et une rotation de checkpoints serrée. L’écart devient rédhibitoire dès que vous visez des séquences longues ou des batches > 2.
Scénario 3 — Cluster 2× via ConnectX-7. Le DGX Spark embarque un Smart NIC ConnectX-7 à 200 Gb/s, permettant de connecter officiellement deux machines — et davantage via OpenMPI avec un switch externe. Deux DGX Spark 128 Go font tourner un modèle 405B, comme l’a testé Geeky-Gadgets, avec des performances qui restent en retrait du cloud. Avec deux 64 Go, vous atteignez 128 Go cumulés — soit exactement la capacité d’une seule machine 128 Go, mais avec deux fois la bande passante agrégée et deux fois le CPU. C’est là que le calcul de Frandroid prend tout son sens : deux petits peuvent, dans certains cas, battre un gros. Les mesures canoniques sur deux Spark 128 Go donnent l’ordre de grandeur de ce que le cluster apporte : ~41 tok/s en single-stream et ~350 tok/s en agrégé à concurrence 32 sur DeepSeek-V4-Flash FP8 avec vLLM en TP=2, et un pool de cache KV partagé de 1 105 096 tokens. Sur deux 64 Go, ces chiffres restent comparables en débit mais la capacité de contexte par modèle est divisée.
Scénario 4 — Le test fournisseur. NVIDIA mesure Qwen 3.8 27B sur deux systèmes 64 Go en cluster : jusqu’à 1,7× les performances d’un seul, avec un environnement logiciel inchangé quand un second nœud apparaît. C’est le meilleur argument pour le 64 Go : la montée en charge est transparente, et l’investissement est incrémental.
La release d’octobre 2026 : ce que la pile logicielle change vraiment
Un DGX Spark n’est rien sans sa pile logicielle, et c’est peut-être là que le 64 Go se rattrape. Le 21 octobre 2026, NVIDIA a déployé sa mise à jour trimestrielle — la October 2026 Release — documentée sur les forums développeurs NVIDIA. Les systèmes partenaires à base de GB10 Grace Blackwell reçoivent les mêmes mises à jour, ce qui uniformise l’expérience entre la Founders Edition et les machines Acer, ASUS, Dell, Gigabyte, HP et MSI.
La configuration 64 Go conserve DGX OS et la pile logicielle IA complète : NVIDIA Agent Toolkit, bibliothèques CUDA-X AI, modèles ouverts Nemotron, et prise en charge des moteurs que les équipes utilisent déjà — Ollama, vLLM et PyTorch notamment. Blender est cité parmi les premiers fournisseurs d’applications créatives à soutenir la plateforme, avec un installateur à venir. C’est un point souvent négligé : le 64 Go n’est pas une machine au rabais logiciel, c’est la même plateforme avec moins de RAM.
La release d’octobre apporte par ailleurs un workflow edge documenté par NVIDIA pour faire tourner Nemotron-3.5 Lightning sur DGX Spark 64 Go, avec données de benchmark et résultats de décodage spéculatif — rapporté par blockchain.news le 30 octobre 2026. C’est précisément le type d’optimisation qui compte sur une machine à bande passante contrainte : le décodage spéculatif réduit le nombre de passes mémoire par token généré, ce qui atténue le plafond des 273 Go/s.
Il faut cependant rester lucide sur la cadence réelle de NVIDIA. Comme le documente notre enquête sur la release d’octobre, la promesse d’un rythme trimestriel maîtrisé cache une réalité plus heurtée : entre communication et traces GitHub, la cadence effective est plus irrégulière qu’annoncé, et la compatibilité des conteneurs NGC, de vLLM et de llama.cpp relève parfois de la loterie. Sur un 64 Go, où chaque gigaoctet compte, une version de runtime mal alignée se paie immédiatement en OOM.
L’écosystème s’élargit : ASUS, Acer et la concurrence
Le 64 Go n’arrive pas seul. Le 5 octobre 2026, ASUS a dévoilé son Ascent GX10 64GB, également propulsé par le GB10 Grace Blackwell, positionné pour faire tourner des modèles open source de 30 à 35 milliards de paramètres et des agents IA en local, avec 1 pétaFLOP de calcul — selon le communiqué ASUS. Techgenyz souligne que l’Ascent GX10 et le DGX Spark partagent le même matériel GB10, mais que le prix, le stockage, le refroidissement et la disponibilité changent la comparaison.

C’est un point important pour l’acheteur : le GB10 est devenu une plateforme, pas un produit unique. Acer propose depuis le 8 septembre 2026 un mini-PC GB10 en 128 Go, positionné 500 à 1 000 dollars sous le prix NVIDIA officiel. Sur le segment 64 Go, la concurrence entre ASUS, Acer, Dell, Gigabyte, HP et MSI jouera probablement en faveur de l’acheteur — mais attention aux SKU : tous ne sont pas logés à la même enseigne côté stockage NVMe.
La vraie question concurrentielle, cependant, vient d’ailleurs. Le 14 octobre 2026, AMD a lancé son Ryzen AI Halo 192GB à 7 299,99 $ chez Micro Center — le premier système compact capable de charger des modèles open weight de 300 milliards de paramètres. Les benchmarks indépendants, rapportés par TechTimes, montrent cependant que le DGX Spark garde l’avantage en vitesse. C’est le compromis inverse du 64 Go : AMD vous vend la capacité, NVIDIA vous vend le débit. Et pour l’inférence interactive, le débit compte souvent plus que la capacité.
Verdict : pour qui, et à quel prix
Reprenons. Le DGX Spark 64 Go à 4 999 $ est une machine qui :
- excelle sur les modèles 8B à 32B, avec des contextes de 32K à 128K selon la taille ;
- tient les modèles 70B en Q4, mais avec un contexte trop court pour un usage agentique sérieux ;
- ne tient pas les modèles 405B, réservés au cluster 2× (et au 128 Go) ;
- fait du fine-tuning QLoRA confortablement sur du 32B, difficilement sur du 70B ;
- souffre d’un stockage NVMe réduit (1 To) qui pénalise les pipelines RAG et la rotation de checkpoints ;
- bénéficie de la même pile logicielle que le 128 Go, y compris la release d’octobre 2026 et le décodage spéculatif Nemotron.
La recommandation dépend d’un seul calcul : combien de fois par mois allez-vous saturer 64 Go ? Si la réponse est « rarement », le 64 Go est un excellent poste de développement local pour une petite équipe, et l’ajout d’un second nœud plus tard double la capacité sans changer l’environnement logiciel. Si la réponse est « tous les jours », le 128 Go — désormais au-dessus de 6 000 $ — reste le seul choix rationnel, ou il faut regarder du côté d’AMD pour la capacité brute.
Ce qu’il faut retenir, en une phrase : le 64 Go n’est pas une version au rabais du 128 Go, c’est une machine d’une autre catégorie — et l’acheteur qui ne fait pas ce deuil avant de commander achètera un OOM à 4 999 dollars.
Sources
- The Register — Nvidia debuts $4,999 DGX Spark with half the RAM and storage, amid memory crunch (2 octobre 2026)
- ServeTheHome — Nvidia DGX Spark 64GB launched and big 128GB GB10 price increases (2 octobre 2026)
- TechPowerUp — Nvidia launches DGX Spark 64 GB desktop AI systems (2 octobre 2026)
- Frandroid — Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ? (2 octobre 2026)
- Pause Hardware — Le DGX Spark perd la moitié de sa mémoire mais conserve son tarif de 4 999 dollars (2 octobre 2026)
- Kod.ru — Nvidia представила ИИ-компьютер DGX Spark с 64 ГБ памяти (3 octobre 2026)
- NeoTeo — DGX Spark 64 Go : NVIDIA annonce une configuration (3 octobre 2026)
- blog.netics.fr — DGX Spark en 64 Go : ce que 4 999 dollars de calcul local apportent à une petite équipe
- hardwareand.co — Le Gigabyte AI Top Atom passe en test / DGX Spark, un mini-PC exotique pour un maxi prix
- Ultralytics — documentation DGX Spark
- Geeky-Gadgets — Run 405B AI model locally (test de deux DGX Spark en cluster)
- NVIDIA Developer Forums — DGX Spark Software Updates, October 2026 Release (21 octobre 2026)
- blockchain.news — NVIDIA details edge AI workflow for DGX Spark and TensorRT Edge-LLM (30 octobre 2026)
- ASUS Press — ASUS Ascent GX10 64GB: Compact Agentic AI Supercomputer (5 octobre 2026)
- Techgenyz — ASUS Ascent GX10 vs NVIDIA DGX Spark: Same GB10 Platform, Very Different Prices (5 octobre 2026)
- TechTimes — AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed (14 octobre 2026)
- Clubic — NVIDIA lance un DGX Spark 64 Go : moins de mémoire, mais une drôle d’astuce pour dépasser le modèle 128 Go (2 octobre 2026)
Article recherché et rédigé automatiquement · Magazine Electrosens