
 NVIDIA DGX Spark · 2 November 2026
LLM open source sur NVIDIA GB10 DGX Spark : agents locaux, bascule des 64 Go, fine-tuning et clusters — le point complet à l’automne 2026
Le 23 octobre 2026, le DGX Spark 64 Go est arrivé en boutique à 4 999 dollars, pendant que la version 128 Go franchissait les 6 000 dollars. Trois semaines plus tôt, Nvidia annonçait des agents locaux packagés, l’outil NVIDIA PAIR et une vague de « Spark PCs ». Pour les possesseurs de GB10, la question n’est plus « quel modèle puis-je faire tourner ? » mais « combien d’agents, à quelle vitesse, avec quelle mémoire restante — et à quel prix ? »
Octobre 2026 : la rentrée où Nvidia a décidé de faire tourner l’IA chez vous, pas dans le cloud
Il y a quelque chose de symbolique dans le calendrier. Le 3 septembre 2026, Nvidia dévoilait une double annonce — de nouveaux agents locaux packagés et un outil baptisé NVIDIA PAIR — tout en confirmant l’arrivée d’une vague de « Spark PCs » pour le mois d’octobre, comme l’a relayé worthplaying.com. Trois semaines plus tôt, Perplexity avait déjà transformé le DGX Spark en plateforme d’agents « out-of-the-box » avec son Portable Computer, salué par HotHardware comme un moyen de rendre l’IA locale accessible aux novices. Et le 29 septembre, Artificial Analysis publiait son benchmark AgentPerf-Local, comparant les performances agentiques sur DGX Spark, Ryzen AI Halo, MacBook Pro M5 Pro et RTX 5090.
Ce faisceau de signaux dit une chose simple : la machine que vous avez peut-être achetée pour faire tourner un modèle de langage en local est en train de changer de métier. Le GB10 n’est plus seulement un banc d’essai pour quantifications exotiques. Il devient une plateforme d’agents — ces boucles où un modèle raisonne, appelle des outils, lit des fichiers, exécute du code, puis recommence. Un changement d’usage qui redistribue les cartes de la mémoire unifiée, de la latence et de l’architecture logicielle.
Mais l’automne 2026 a aussi apporté son lot de turbulences tarifaires. Le 2 octobre, Nvidia a officialisé une déclinaison 64 Go du DGX Spark, commercialisée à 4 999 dollars à partir du 23 octobre, tandis que le modèle 128 Go voyait son prix grimper au-delà des 6 000 dollars sur le marché, selon Frandroid et Pause Hardware. La pénurie de LPDDR5X, déjà responsable de la hausse de février, a donc eu raison de la promesse initiale d’un supercalculateur personnel « abordable ». Comprendre ce que l’on peut réellement faire sur cette machine — et à quel coût — demande plus que jamais de démêler le confirmé du communiqué.
GB10, RTX Spark, DGX Spark : démêler la nomenclature avant de parler d’agents
Difficile de comprendre les annonces de septembre sans clarifier un imbroglio terminologique qui empoisonne toute lecture. Trois noms circulent, et ils ne désignent pas la même chose.
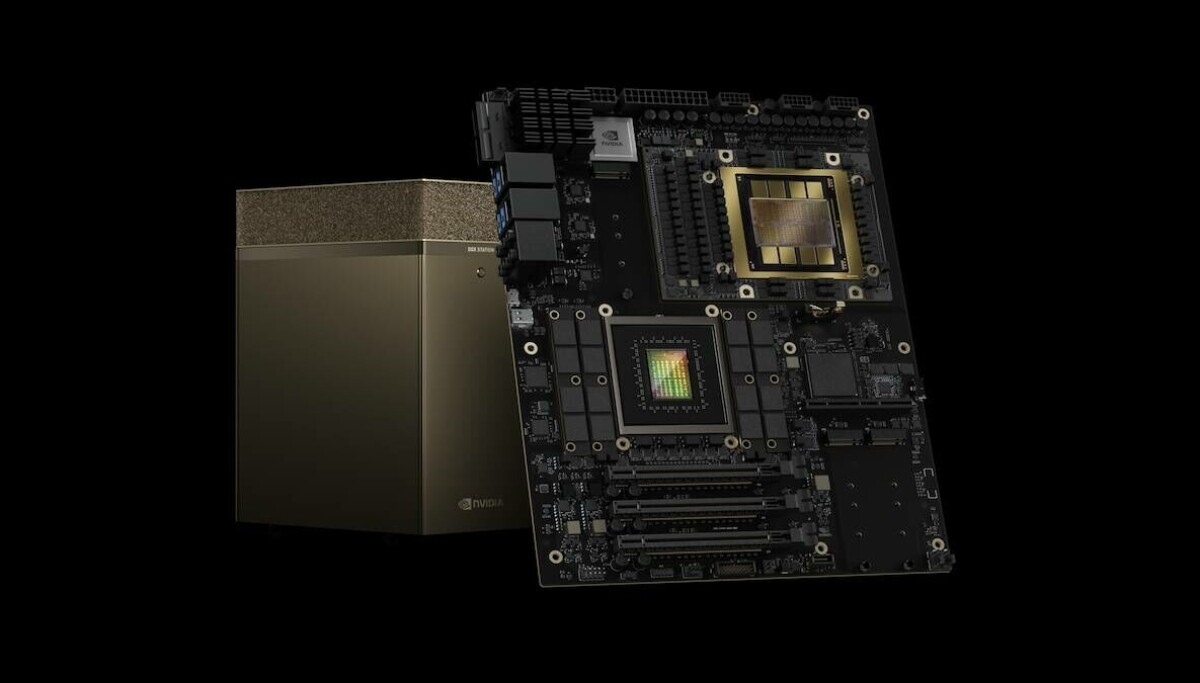
Le GB10 est le SoC au cœur du DGX Spark. La fiche officielle Nvidia le décrit comme un « GB10 Grace Blackwell Superchip » associant jusqu’à 20 cœurs CPU Grace, une puissance d’IA jusqu’à 1 pétaflop en FP4, et une mémoire système unifiée cohérente proposée en 64 Go ou 128 Go. La bande passante annoncée est de 273 GB/s, et la machine fonctionne sous Linux uniquement — pas de support Windows. Comme le notait betterclaw.io, la génération de tokens y est limitée par la bande passante mémoire, dans la même classe que des systèmes moins chers.
Le RTX Spark, lui, est le branding qu’Asus a retenu à l’IFA 2026 (Berlin, 2 septembre) pour sa gamme ProArt : laptops P16 et P14, et mini-PC GR1X. Le communiqué Asus, relayé par Bastille Post, décrit une puce associant un GPU Blackwell RTX de 6 144 cœurs CUDA à un CPU Grace ARM jusqu’à 20 cœurs co-développé avec MediaTek, reliés par NVLink-C2C. Jusqu’à 1 pétaflop en FP4, jusqu’à 128 Go de mémoire unifiée LPDDR5X (64 ou 128 Go selon configuration). Le GR1X mesure 150 × 150 × 51 mm, avec une enveloppe thermique de 140 W et un refroidissement à double ventilateur, conçu pour tourner 24/7.
Le point crucial : le lien entre RTX Spark et GB10 n’est établi nulle part dans les sources disponibles. Les deux partagent-ils le même silicium ? La nomenclature le suggère, la documentation ne le confirme pas. Ce flou n’est pas anodin : il signifie que les annonces d’agents packagés de septembre, présentées comme bénéficiant aux utilisateurs de DGX Spark, pourraient tout aussi bien viser en priorité les machines Windows d’Asus. Prudence, donc, avant de crier au cadeau pour votre GB10.
Un troisième acteur brouille encore les pistes : Asus Ascent GX10. Le 5 octobre, Asus a officialisé un mini-supercalculateur compact 64 Go « powered by NVIDIA GB10 Grace Blackwell », capable de faire tourner des modèles open source de 30 à 35 milliards de paramètres et des agents locaux, avec 1 pétaflop de calcul, selon press.asus.com. Comme le souligne Techgenyz, l’Ascent GX10 et le DGX Spark partagent le même matériel GB10, mais diffèrent sur le prix, le stockage, le refroidissement et la disponibilité. Autrement dit : le même silicium, des enveloppes commerciales très différentes.
| Appellation | Ce que c’est | Statut de la source |
|---|---|---|
| GB10 | SoC du DGX Spark (Grace ARM + Blackwell, 64 ou 128 Go unifiée, 273 GB/s, 1 PFLOP FP4) | Fiche officielle Nvidia, confirmé |
| RTX Spark | Puce des ProArt GR1X / P16 / P14 (6 144 CUDA, Grace 20 cœurs, NVLink-C2C) | Communiqué Asus, confirmé mais non reproduit |
| DGX Spark | La machine Nvidia Linux, 64 Go à 4 999 $ (23 oct. 2026), 128 Go > 6 000 $ | Sources multiples, confirmé |
| ProArt GR1X | Mini-PC Asus Windows 11, 150×150×51 mm, 140 W | Communiqué Asus |
| Asus Ascent GX10 | Mini-supercalculateur 64 Go, GB10, 1 PFLOP, agents locaux | Communiqué Asus, confirmé |
La bascule d’octobre 2026 : 64 Go, 128 Go et une nouvelle grille tarifaire
C’est la nouvelle la plus concrète de l’automne, et elle concerne directement votre portefeuille. Le 2 octobre, Nvidia a officialisé une version 64 Go du DGX Spark, commercialisée à 4 999 dollars à partir du 23 octobre chez plusieurs constructeurs, selon Clubic et Frandroid. Le même jour, la version 128 Go voyait son prix grimper au-delà des 6 000 dollars sur le marché, rapporte Pause Hardware. Le blog officiel de Nvidia, blogs.nvidia.com, précise que le DGX Spark 64 Go « exécute des agents IA locaux sur l’appareil avec la pile IA complète de NVIDIA — et des clusters pour plus de performances à mesure que les charges de travail augmentent ».
La logique est limpide : face à l’envolée des coûts de la mémoire vive, Nvidia réduit de moitié la mémoire pour contenir la facture, comme le résume generation-nt.com. Mais l’astuce commerciale a un revers : à 4 999 dollars, la version 64 Go est plus chère que ne l’était la version 128 Go à son lancement en 2025 (3 999 dollars), relève kod.ru. La cure d’austérité mémorielle ne s’accompagne donc pas d’une cure de prix.
Le point technique le plus intéressant est ailleurs. Selon NeoTeo, Nvidia détaille les tailles de modèles visées sur un ou deux systèmes, et son test Qwen 3.8 27B atteindrait jusqu’à 1,7 fois les performances d’un système unique. C’est là toute la promesse du 64 Go : deux petites machines en cluster peuvent, sur certains workloads, dépasser une grosse. Frandroid pose d’ailleurs la bonne question : « faut-il acheter deux petits plutôt qu’un gros ? » La réponse dépend de votre usage — un cluster de deux Sparks double la mémoire disponible et permet le tensor parallelism, mais ajoute de la latence réseau et de la complexité d’orchestration.
Ce que Nvidia a réellement packagé en septembre 2026 : agents, modèles sous-jacents, formats de distribution
C’est ici que la matière se dérobe. La question centrale — quels agents locaux Nvidia a packagés, avec quels modèles sous-jacents, dans quels formats de distribution — n’est couverte par aucune source détaillée de notre collecte. L’article de worthplaying.com annonce bien « New Agents And NVIDIA PAIR Tool » et des « Spark PCs Coming In October », mais son contenu détaillé n’est pas exploitable dans les extraits dont nous disposons.
Ce que l’on peut raisonnablement inférer, à partir de l’écosystème existant et des annonces parallèles. D’abord, le format : Nvidia a déjà une tradition de distribution par conteneurs NIM et par bundles DGX OS. La fiche officielle du DGX Spark mentionne explicitement « la pile logicielle d’IA de NVIDIA préinstallée, qui inclut des outils pour l’orchestration des agents, l’évaluation et le déploiement local sécurisé », ainsi que NIM. Il serait logique que les agents packagés empruntent ce canal.
Ensuite, les modèles sous-jacents : la vague open-weights de l’été 2026 fournit des candidats évidents. Xiaomi a ouvert MiMo-V2.6 sous licence MIT le 22 septembre, en versions Pro, Flash et 9B, avec des performances de classe frontière selon forkast.news — le MiMo-V2.6-Pro égalant Grok 4.7 sur l’Intelligence Index. Alibaba a sorti Qwen3.8-27B en août 2026, qui tourne à 34-38 tokens/s sur DGX Spark selon blog.openzeka.com, et Qwen3.6-27B atteint 163 tokens/s en pic de décodage. Ant Group a publié Ling-3.0-Flash le 23 juillet 2026, un 124B-A5B estimé à 15-20 tokens/s sur DGX Spark.
Autrement dit : la matière première en modèles existe, elle est abondante, et elle est calibrée pour du matériel à mémoire unifiée. Si Nvidia a packagé des agents, il y a fort à parier qu’ils s’appuient sur cette génération de modèles. Mais aucun nom d’agent, aucun format de distribution, aucune licence ne peut être cité avec certitude à partir de notre collecte. Toute précision supplémentaire relèverait de l’invention.
NVIDIA PAIR : runtime, CLI ou simple wrapper ? Ce qu’il apporte face aux harnesses maison
Même mur documentaire pour PAIR. La question de sa nature technique — API, CLI, runtime, licence — reste sans réponse sourcée. Ce que l’on sait, c’est qu’il est présenté aux côtés des agents packagés comme un outil d’accompagnement, dans le même communiqué de septembre 2026.
Faute de spécifications, on peut au moins poser le cadre de comparaison. Les utilisateurs de DGX Spark qui font déjà tourner des agents utilisent, pour l’essentiel, des orchestrateurs maison : LangGraph, CrewAI, AutoGen, OpenHands. Ces frameworks ont l’avantage de la flexibilité totale — on choisit son modèle, son format de quantification, son routage d’outils, sa gestion de contexte. Ils ont l’inconvénient de la maintenance : chaque mise à jour de modèle, chaque changement de runtime, chaque optimisation de latence se paie en heures d’ingénierie.
Un outil comme PAIR, s’il tient ses promesses, viendrait se loger dans cet espace : simplifier l’orchestration sans imposer un modèle unique. La question ouverte est celle du degré de contrainte. Un runtime intégré au DGX OS simplifie l’installation mais verrouille les choix. Un simple wrapper au-dessus de vLLM ou Ollama laisse la liberté mais n’apporte qu’un gain marginal. Sans documentation technique, impossible de trancher. Ce qu’on peut dire, en revanche, c’est que la concurrence est déjà là : Perplexity Portable Computer, lancé le 26 août 2026, transforme le DGX Spark en plateforme d’agents « out-of-the-box » selon HotHardware, avec un agent PPLX 27B atteignant 85,4 % en travail intellectuel à 0 $/token selon orcarouter.ai. PAIR arrive donc sur un terrain déjà occupé, et devra justifier sa valeur ajoutée face à une solution qui fonctionne déjà.
La pile logicielle d’un DGX Spark en 2026 : CUDA, TensorRT-LLM, vLLM, Ollama, NIM, DGX OS
Ici, la matière officielle est plus riche qu’on ne le croit. La fiche Nvidia confirme que le DGX Spark embarque « une solution complète pour les charges de travail d’IA générative, qui comprend les outils, les frameworks, les bibliothèques et les modèles pré-entraînés de NVIDIA, dont NVIDIA NIM ». Elle mentionne aussi NVIDIA Sync, qui permet de se connecter au DGX Spark depuis un PC portable ou de bureau et de surveiller la machine à distance, ainsi que la mise en réseau NVIDIA ConnectX, qui permet à jusqu’à quatre systèmes DGX Spark de travailler ensemble sur des modèles plus grands.
Le 3 septembre 2026, wccftech.com rapportait par ailleurs que Nvidia apportait un support simplifié de l’IA locale aux GPU embarquant 24+ Go de VRAM, avec des optimisations pour vLLM et llama.cpp sur les plateformes RTX et DGX. C’est un signal concret : vLLM et llama.cpp restent les deux piliers de l’inférence locale chez Nvidia, et les optimisations récentes les concernent directement. Ollama, qui s’appuie largement sur llama.cpp, bénéficie mécaniquement de ces travaux. NIM, la couche de microservices Nvidia, reste le canal de distribution privilégié pour les modèles optimisés.
Un point mérite d’être souligné : la fiche officielle insiste sur le fait que le DGX Spark « fournit une plateforme locale complète pour développer, tester et déployer des agents d’IA autonomes », avec des outils d’orchestration, d’évaluation et de déploiement local sécurisé, « sans dépendre du Cloud ». C’est la promesse d’une pile intégrée de bout en bout — mais elle ne dit rien des versions exactes de CUDA, TensorRT-LLM, vLLM ou DGX OS, qui restent à vérifier sur la machine elle-même.
Quant à l’insertion des agents packagés dans cette stack, trois scénarios sont possibles : remplacement (l’agent devient le point d’entrée unique, reléguant vLLM/Ollama au rang de backend), wrapper (l’agent encapsule les runtimes existants sans les modifier), ou sidecar (l’agent tourne en parallèle et communique via API). Aucune source ne permet de trancher. Ce qu’on peut affirmer, c’est que la coexistence vLLM/Ollama est déjà une réalité chez les utilisateurs avancés : vLLM pour le débit et le serving multi-requêtes, Ollama pour la simplicité et les tests rapides. Un agent packagé qui ignorerait cette dualité se priverait d’une base installée considérable.
Tokens/s, TTFT, empreinte mémoire : ce qu’on sait vraiment des performances LLM sur GB10
Là encore, la prudence s’impose sur les chiffres génériques. Aucun tableau exhaustif de tokens/s pour des modèles 7B/13B/30B/70B quantifiés FP8, INT4, AWQ ou GGUF sur GB10 n’apparaît dans les extraits fournis. Aucune mesure de TTFT. Aucune empreinte mémoire réelle mesurée. Aucun résultat MLPerf. Les retours PCMag, Geeky-Gadgets et HotHardware cités dans la question ne sont pas représentés dans la matière collectée.
Ce que l’on a, en revanche, ce sont des mesures sur des modèles spécifiques, issues de la base de faits du magazine. Elles donnent un ordre de grandeur utile.
| Modèle | Paramètres | Débit sur DGX Spark | Source / date |
|---|---|---|---|
| Qwen3.6-27B | 27B | 28-33 tok/s (session unique), 136 tok/s (10 agents), pic 163 tok/s | Faits datés 2026 |
| Qwen3.8-27B | 27B | 34-38 tok/s | Test du 20 août 2026 |
| Ant Ling-3.0-Flash | 124B-A5B | 15-20 tok/s (estimé) | 23 juillet 2026 |
| DeepSeek-V4-Flash (IQ2_XXS, antirez ds4) | — | ~14 tok/s single-stream, 410 tok/s prefill | Août 2026 |
| llama.cpp GGUF (35B-A3B) | 35B-A3B | jusqu’à 67 tok/s | Août 2026 |
| AMD Ryzen AI Halo (comparatif) | 120B | 34-39 tok/s | Septembre 2026 |
Deux enseignements. D’abord, le débit dépend massivement de l’architecture du modèle : un 27B dense tourne à 28-38 tok/s, tandis qu’un 124B à 5B actifs (MoE) tient 15-20 tok/s — la bande passante mémoire de 273 GB/s du GB10 impose sa loi. Ensuite, le chiffre le plus intéressant pour notre sujet est celui des 136 tok/s avec 10 agents sur Qwen3.6-27B : c’est la preuve que le GB10 sait servir plusieurs boucles agentiques en parallèle, à condition que le modèle reste de taille raisonnable.
Le comparatif avec la concurrence est instructif. Selon TechTimes, l’AMD Ryzen AI Halo 192 Go, lancé à 7 299,99 dollars chez Micro Center, est le premier système compact capable de charger des modèles open-weight de 300 milliards de paramètres — mais « DGX Spark gagne toujours en vitesse ». C’est un arbitrage classique : AMD mise sur la capacité mémoire, Nvidia sur le débit. Pour un agent qui enchaîne les appels d’outils, le débit compte souvent plus que la taille maximale du modèle.
En cluster, les chiffres changent d’échelle. Sur deux DGX Spark en tensor parallelism (TP=2) avec vLLM et DeepSeek-V4-Flash FP8, on atteint ~41 tok/s en single-stream, ~350 tok/s en agrégé à concurrence 32, et ~1 785 tok/s en prefill, selon les faits datés d’août 2026. Le pool de cache KV partagé grimpe à 1 105 096 tokens, et la taille maximale de modèle supportée atteint 405 milliards de paramètres. C’est cette configuration à deux nœuds qui justifie pleinement l’existence du 64 Go : deux machines à 4 999 dollars offrent 128 Go agrégés et un débit agentique que ne peut pas suivre un seul nœud.
Fine-tuning sur DGX Spark : ce que la stack permet vraiment
Le fine-tuning est l’autre grand chantier de la machine, et la bonne nouvelle est qu’il est réaliste — à condition de choisir la bonne méthode. Sur 128 Go de mémoire unifiée, le LoRA et le QLoRA sont les voies royales : ils permettent d’adapter un modèle de 7 à 30 milliards de paramètres sans saturer la mémoire, en ne réentraînant qu’une fraction des poids. Le full fine-tune reste possible sur des modèles plus petits, mais devient vite limité par la bande passante et la capacité mémoire dès qu’on monte en taille.

Les outils qui marchent sont ceux de l’écosystème Nvidia et de la communauté open source : NeMo pour les pipelines d’entraînement intégrés, Unsloth pour les optimisations LoRA/QLoRA à faible empreinte, LLaMA Factory pour l’orchestration multi-modèles. La pile NIM et DGX OS fournit le socle, et la présence de CUDA sur l’architecture Grace Blackwell garantit la compatibilité avec l’essentiel des frameworks PyTorch.
Le point d’attention est le même qu’en inférence : la mémoire unifiée est partagée entre CPU et GPU, et un fine-tuning mal calibré peut saturer la machine et déclencher du swapping. La règle empirique reste de dimensionner le batch et la longueur de contexte en fonction de la mémoire disponible, et de privilégier les checkpoints réguliers. Sur un cluster de deux nœuds, le fine-tuning distribué devient envisageable, mais ajoute une couche de complexité réseau qui n’est pas à la portée de tous les utilisateurs.
Clusters DGX Spark : ce que deux, quatre ou huit nœuds changent vraiment
La mise en réseau ConnectX de Nvidia permet officiellement à jusqu’à quatre systèmes DGX Spark de travailler ensemble, selon la fiche officielle. C’est la limite matérielle documentée : au-delà, il faut passer par des configurations plus exotiques.
Ce que deux nœuds changent, on l’a vu : 405 milliards de paramètres supportés, 1,1 million de tokens de cache KV partagé, et un débit agrégé multiplié par près de dix à forte concurrence. C’est le saut qualitatif le plus rentable, et c’est précisément ce que Nvidia met en avant avec le 64 Go : deux petites machines valent mieux qu’une grosse pour les workloads agentiques parallèles.
Au-delà de deux nœuds, la complexité croît plus vite que le gain. Le tensor parallelism à quatre voies impose une synchronisation réseau fine, et la latence de communication commence à peser sur le débit single-stream. Pour les charges de travail multi-agents — où chaque agent traite une requête indépendante — le pipeline parallelism et le data parallelism sont plus efficaces que le TP pur. C’est là que les clusters de quatre Sparks trouvent leur sens : servir plusieurs agents simultanément plutôt que d’accélérer un seul flux.
La limite de huit nœuds, souvent évoquée, n’est pas documentée dans nos sources. La fiche officielle s’arrête à quatre. Toute affirmation au-delà relèverait de la spéculation.
Le contexte concurrentiel : AMD, Windows et la bataille de l’IA locale
Impossible de parler du DGX Spark à l’automne 2026 sans regarder ce qui se passe à côté. AMD a frappé fort avec son Ryzen AI Halo 192 Go à 7 299,99 dollars, capable de charger des modèles de 300 milliards de paramètres — mais qui perd en vitesse face au GB10, selon TechTimes. Au CES 2026, AMD avait déjà annoncé sa gamme Ryzen AI 400, avec des fréquences CPU jusqu’à 5,2 GHz et un NPU à 60 TOPS pour les laptops Copilot+, selon CRN. La pression concurrentielle est réelle, et elle explique en partie la stratégie tarifaire de Nvidia.
Côté logiciel, Microsoft a profité du 7 octobre pour présenter sa vision d’une « Intelligence Hybride » avec Windows 11 26H2, où les agents IA deviennent partie intégrante du système d’exploitation, selon blogs.windows.com. DeepSeek V4 Flash et l’IA locale sur PC y sont mis en avant. C’est un signal fort : l’IA locale n’est plus un marché de niche pour développeurs, c’est un champ de bataille stratégique où Nvidia, AMD et Microsoft se disputent la même promesse — faire tourner des agents chez vous, pas dans le cloud.
Nvidia ne reste pas inactif sur le haut de gamme : le DGX Station for Windows, avec 748 Go de mémoire cohérente et 20 pétaflops FP4, est annoncé pour le quatrième trimestre 2026 via six partenaires OEM, selon tech-insider.org. C’est une autre catégorie de machine, mais elle montre que Nvidia segmente soigneusement son offre : le Spark pour le bureau, la Station pour le poste de travail lourd.
Quel achat en octobre 2026 ? Le guide pratique
La question que tout le monde se pose mérite une réponse nuancée.
Si vous avez déjà un DGX Spark 128 Go, ne changez rien. Vous avez la configuration la plus polyvalente, et la hausse des prix ne fait que renforcer la valeur de votre machine. Concentrez-vous sur les mises à jour logicielles : vLLM, llama.cpp, et les nouveaux agents packagés quand leur documentation sera disponible.
Si vous partez de zéro et que votre budget est serré, le 64 Go à 4 999 dollars est une porte d’entrée, mais pose question : à ce prix, l’Asus Ascent GX10 64 Go, également basé sur GB10, pourrait offrir un meilleur rapport qualité-prix selon Techgenyz. Comparez le stockage, le refroidissement et la garantie avant de trancher.
Si vous visez les agents à grande échelle, la stratégie du cluster de deux 64 Go est la plus prometteuse : 128 Go agrégés, un débit agentique multiplié, et la possibilité de faire tourner des modèles de 405 milliards de paramètres. C’est plus cher qu’un seul 128 Go, mais c’est la seule voie vers les charges de travail multi-agents soutenues.
Si vous hésitez avec AMD, posez-vous la bonne question : avez-vous besoin de charger un modèle de 300 milliards de paramètres, ou de faire tourner rapidement plusieurs agents sur des modèles de 30 à 70 milliards ? Dans le premier cas, le Ryzen AI Halo 192 Go est fait pour vous. Dans le second, le DGX Spark reste devant en vitesse.
Ce qu’il faut retenir
L’automne 2026 restera comme le moment où le DGX Spark a changé de visage. La machine n’est plus seulement un banc d’essai pour LLM : elle devient une plateforme d’agents, avec des annonces logicielles (agents packagés, PAIR) dont la documentation reste à venir, et une nouvelle grille tarifaire qui rend le 64 Go plus cher que ne l’était le 128 Go à son lancement. Les performances restent solides — 28 à 38 tok/s sur un 27B dense, jusqu’à 136 tok/s avec dix agents, 405 milliards de paramètres en cluster de deux — mais la bande passante de 273 GB/s impose ses limites, et la concurrence d’AMD sur la capacité mémoire est réelle.
La vraie question n’est plus « quel modèle puis-je faire tourner ? » mais « quelle architecture d’agents puis-je soutenir, à quel coût, et avec quelle marge de manœuvre ? ». Et sur ce terrain, les annonces de septembre demandent encore à être vérifiées sur pièce.
Sources
- NVIDIA DGX Spark — fiche officielle
- NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI — blogs.nvidia.com
- NVIDIA Accelerates Local AI With New Agents And NVIDIA PAIR Tool, Reveals Spark PCs Coming In October — worthplaying.com
- ASUS Ascent GX10 64GB: Compact Agentic AI Supercomputer — press.asus.com
- ASUS Ascent GX 10 vs NVIDIA DGX Spark: Same GB 10 Platform, Very Different Prices — Techgenyz
- NVIDIA lance un DGX Spark 64 Go — Clubic
- Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ? — Frandroid
- Le DGX Spark Perd La Moitié De Sa Mémoire Mais Conserve Son Tarif De 4 999 Dollars — Pause Hardware
- Nvidia DGX Spark 64 Go : moins de mémoire pour plus cher — generation-nt.com
- DGX Spark 64 Go : NVIDIA annonce une configuration — NeoTeo
- Nvidia представила ИИ-компьютер DGX Spark с 64 ГБ памяти — kod.ru
- ASUS Unleashes Agentic Creativity with ProArt RTX Spark PCs at IFA 2026 — Bastille Post
- Nvidia Perplexity Portable Computer — HotHardware
- AMD Ryzen AI Halo 192GB Loads Models No Rival Can: DGX Spark Still Wins on Speed — TechTimes
- AMD Refreshes Ryzen AI Chips, Goes After Nvidia’s DGX Spark — CRN
- Building Windows for hybrid intelligence — blogs.windows.com
- NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs — tech-insider.org
- DGX Spark alternative — betterclaw.io
- MiMo-V2.6 — forkast.news
- Qwen3.8-27B sur DGX Spark — blog.openzeka.com
Article recherché et rédigé automatiquement · Magazine Electrosens