
 NVIDIA DGX Spark · 14 October 2026
Portable Computer de Perplexity sur DGX Spark : l’agent IA local-first à l’épreuve du réel (automne 2026)
C’est une petite boîte noire qui murmure à l’oreille de votre DGX Spark. Perplexity et NVIDIA ont officialisé le « Portable Computer », une version de Perplexity Computer qui s’exécute entièrement sur la machine, avec la promesse d’un travail local qui ne consomme aucun crédit. Derrière le slogan, il y a une vraie bascule architecturale — et un contexte matériel qui a beaucoup bougé en 2026 : hausse de prix, arrivée d’une déclinaison 64 Go, montée en puissance des clusters et des modèles open weight. Décryptage d’une annonce qui redessine la carte de l’inférence locale, chiffres et dates à l’appui.
Une annonce qui sent le tournant
L’écosystème de l’IA locale a longtemps vécu dans l’ombre des géants du cloud. Les API d’OpenAI, d’Anthropic ou de Google dominaient le marché des agents, avec leurs coûts par token, leurs latences imprévisibles et leurs questions de souveraineté des données. Puis, discrètement, la donne a commencé à changer. Les modèles open weight ont franchi un cap qualitatif, et le matériel a suivi : le NVIDIA DGX Spark, avec son superchip GB10 et ses 128 Go de mémoire unifiée, a transformé ce qui était un rêve de passionné en une réalité tangible.
C’est dans ce contexte que Perplexity et NVIDIA ont choisi de frapper fort. L’annonce du « Portable Computer » n’est pas un simple add-on logiciel de plus. C’est une déclaration d’intention : l’agent IA peut désormais vivre entièrement sur votre matériel, sans jamais avoir besoin de téléphoner à un serveur distant — sauf quand vous l’y autorisez explicitement. Selon le blog officiel de Perplexity, Portable Computer « exécute Perplexity Computer entièrement sur l’appareil avec NVIDIA, en gardant les données privées locales et en basculant vers le cloud uniquement lorsqu’une tâche le nécessite ». Le produit a été conçu avec NVIDIA pour permettre aux utilisateurs de posséder l’infrastructure sur le DGX Spark, et il « sera bientôt disponible sur les PC équipés de GPU NVIDIA RTX ».
Le timing n’est pas anodin. L’annonce s’inscrit dans une séquence où NVIDIA pousse ses « one-click AI agents » et sa plateforme RTX Spark, tandis que Microsoft, de son côté, a présenté début octobre 2026 sa vision d’une « Intelligence Hybride » pour Windows (voir plus bas). L’idée commune est simple : démocratiser l’IA locale en la rendant aussi simple à installer qu’une application de bureau. Le Portable Computer s’inscrit parfaitement dans cette logique. Il ne s’agit plus de bricoler des scripts Python, de compiler des kernels CUDA ou de jongler avec des dépendances. Perplexity promet un bundle clé en main : un modèle, un serveur et un harnais (harness), le tout préconfiguré pour fonctionner sur une liste précise de matériels.
Le Portable Computer en pratique : un bundle, pas une boîte magique
Il faut dissiper immédiatement un malentendu : le « Portable Computer » n’est pas un nouveau boîtier matériel. C’est un logiciel, un agent d’IA locale qui s’installe sur du matériel existant. Et la liste du matériel supporté est à la fois précise et exigeante. Le point d’ancrage officiel est le NVIDIA DGX Spark, l’ordinateur IA de bureau de NVIDIA, avec une extension annoncée vers les PC équipés de GPU RTX. La prise en charge de Windows est promise, mais au moment de la rédaction, Linux reste le seul système d’exploitation pleinement opérationnel pour l’expérience de référence.
Cette exigence matérielle est logique. Un agent IA local, capable de raisonner, de planifier et d’exécuter des tâches, nécessite une mémoire conséquente pour loger le modèle et son contexte. Le choix du modèle initial est révélateur : Qwen 3.8 27B, un modèle dense de 27 milliards de paramètres publié par Alibaba en août 2026, ou PPLX 27B, une version post-entraînée du même modèle par Perplexity. Pourquoi ce choix ? Parce qu’il représente le meilleur compromis actuel entre qualité de raisonnement et empreinte mémoire. Sur un DGX Spark, ce modèle tourne à des vitesses tout à fait honorables : les benchmarks communautaires publiés fin août 2026 rapportent environ 48 tokens par seconde, tandis que d’autres tests indépendants (20 août 2026) mesurent entre 34 et 38 tokens par seconde selon la configuration. Des chiffres qui rendent l’expérience utilisateur fluide, même si l’on est loin des vitesses de certaines API cloud.
Détail important que le blog de Perplexity précise explicitement : « L’orchestrateur, le planificateur, le routeur d’outils, le planificateur de tâches, la file d’attente de tâches durables et l’index de recherche local s’exécutent tous sur l’appareil. » Autrement dit, ce n’est pas seulement le modèle qui est local, c’est toute la tuyauterie agentique. C’est ce qui distingue Portable Computer d’un simple wrapper autour d’un LLM : la boucle de raisonnement, la gestion des tâches longues et l’indexation des documents ne dépendent pas d’un serveur distant.
| Modèle | Paramètres | Architecture | Support Portable Computer | Vitesse observée sur DGX Spark |
|---|---|---|---|---|
| Qwen 3.8 27B | 27 Md | Dense | Initial (confirmé) | 34-48 tok/s (sources communautaires) |
| PPLX 27B | 27 Md | Dense (post-entraîné de Qwen) | Initial (confirmé) | Non précisé |
| Nemotron 3.5 Lightning | 30 Md | MoE hybride | À venir (annoncé) | Non précisé |
| DeepSeek V4 Flash 0731 | 284 Md (13 Md actifs) | MoE | Non mentionné | 59 tok/s multi-agent sur dual Spark |
Le support futur de NVIDIA Nemotron 3.5 Lightning, un modèle ouvert de 30B, est annoncé par Perplexity lui-même pour le sélecteur de modèles. Ce choix est stratégique : les architectures MoE (Mixture of Experts) activent seulement une fraction des paramètres à chaque inférence, ce qui permet d’obtenir des performances élevées avec une empreinte mémoire réduite. C’est exactement le genre de modèle qui peut tirer parti des 128 Go de mémoire unifiée du GB10 tout en laissant de la place pour un large contexte.
Zéro coût de token : la promesse et ses limites
Le cœur de la proposition de valeur du Portable Computer tient en une formule choc : le travail local ne consomme pas de crédits. Perplexity l’affirme dans son blog technique officiel : « Les données privées restent locales et le travail sur l’appareil ne consomme pas de crédits. » L’inférence locale ne génère donc aucun frais par token, et les données sensibles ne quittent pas l’appareil sans permission explicite. L’agent fonctionne dans un environnement isolé, ce qui ajoute une couche de sécurité bienvenue pour les usages professionnels.
Cette promesse est-elle tenable ? Techniquement, oui. Lorsque le modèle tourne localement, il n’y a effectivement aucun appel API, donc aucun coût par token. Mais il faut nuancer. D’abord, le « zéro coût » ne concerne que l’inférence locale. L’abonnement Perplexity reste payant — c’est la condition d’accès au logiciel. Ensuite, la promesse de souveraineté des données doit être tempérée : le blog officiel est clair sur ce point, « lorsque l’utilisateur l’autorise, le modèle local peut basculer vers le cloud pour des recherches et un raisonnement plus avancés tout en maintenant les informations sensibles sur l’appareil ». Le sandbox isole le modèle, mais l’utilisateur garde la main sur les bascules — et c’est précisément là que réside le risque : une bascule mal comprise peut faire transiter des données hors de la machine.
Il y a aussi la question des performances. Les tests communautaires notent avec honnêteté que les performances brutes sont plus rapides sur une mémoire GPU dédiée avec plus de bande passante. Mais un point crucial demeure : les fenêtres de contexte plus larges sont plus réalisables sur le DGX Spark grâce à son large pool de mémoire unifiée. C’est un arbitrage fondamental. Un GPU comme le RTX 5090, avec ses 32 Go de VRAM, offre une bande passante énorme mais une capacité limitée. Le GB10, avec ses 128 Go de mémoire unifiée et ses 273 Go/s de bande passante, peut charger des contextes gigantesques au prix d’une vitesse d’inférence légèrement inférieure.
| Critère | Cloud (API) | Local (DGX Spark + Portable Computer) |
|---|---|---|
| Coût par token | Oui, variable selon le modèle | Zéro sur l’appareil (mais abonnement requis) |
| Latence | Réseau + serveur (variable) | Locale (déterministe) |
| Confidentialité | Dépend du fournisseur | Données sur l’appareil (sandbox), bascule cloud sur autorisation |
| Contexte maximal | Souvent limité par le plan | Limité par la RAM unifiée (128 Go) |
| Personnalisation | Limitée aux paramètres API | Fine-tuning possible localement |
Sur le terrain : Qwen 3.8 27B et le DGX Spark, ce que disent les benchmarks
Pour évaluer sérieusement le Portable Computer, il faut regarder ce qui se passe réellement sur le matériel. Le DGX Spark, avec son GB10, est devenu une référence dans la communauté de l’IA locale. Les chiffres publiés en août 2026 sont éloquents. Le blog openzeka.com rapporte 48 tok/s pour Qwen 3.8-27B, un score qui place ce modèle en tête de sa catégorie sur l’Artificial Analysis Intelligence Index (52 points). D’autres tests, datés du 20 août 2026, mesurent entre 34 et 38 tok/s. Cette variabilité s’explique par les configurations : température, longueur de contexte, activation du speculative decoding, etc.
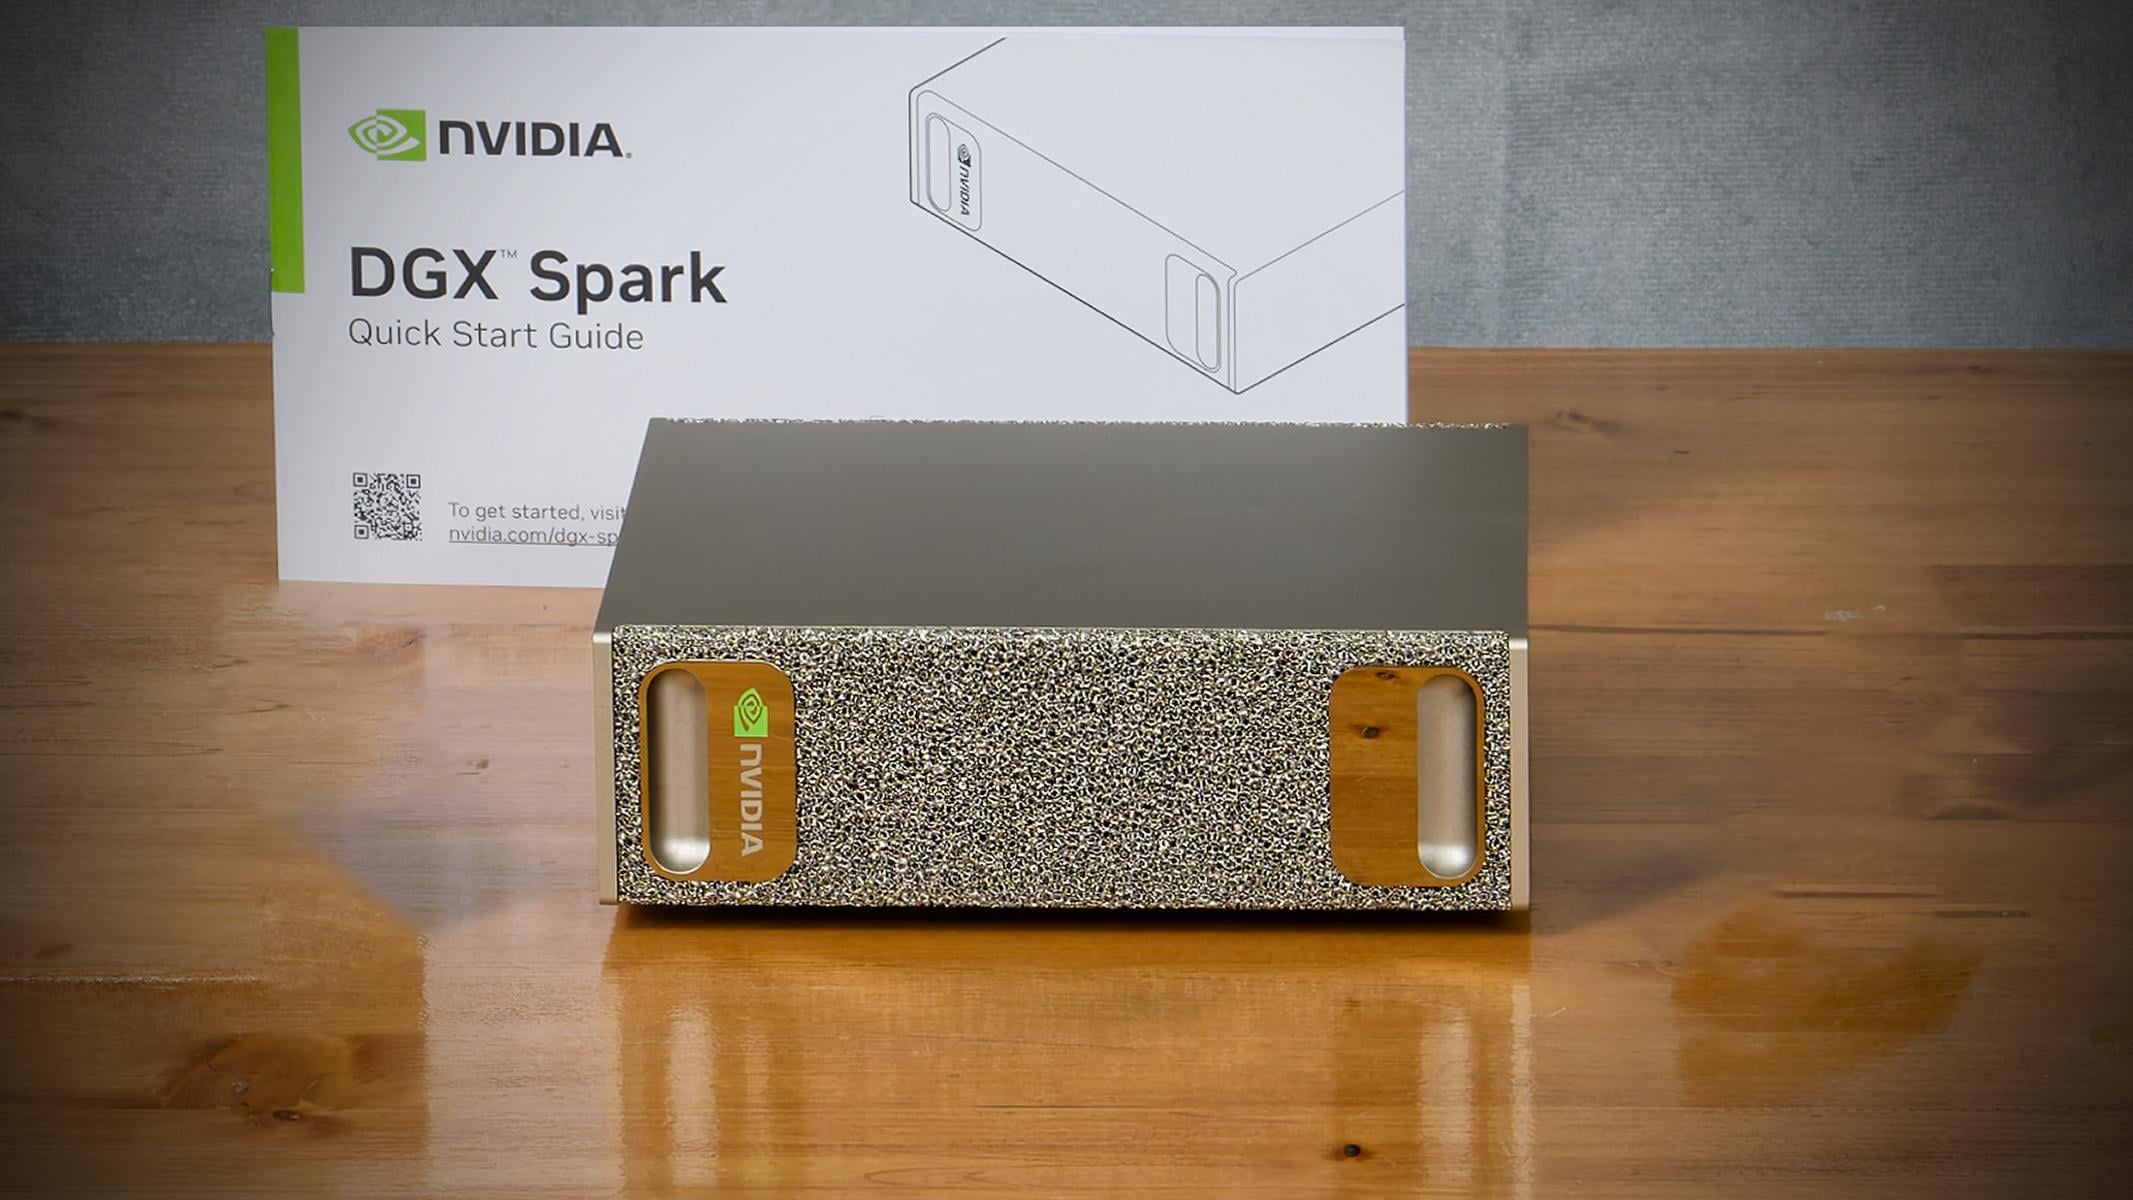
Car c’est là que les choses deviennent intéressantes. La communauté ne cesse d’optimiser. Une implémentation de Multi-Token Prediction (MTP) pour Qwen 3.8-Flash-Next GGUF a été publiée début septembre 2026, avec un speedup annoncé de 1,67x et des vitesses passant de 83 à 138 tok/s — mais sur du matériel différent, probablement des GPU plus puissants. NVIDIA a également annoncé des optimisations pour ses GPU RTX et DGX, notamment dans vLLM et llama.cpp. L’écosystème logiciel progresse vite, et le DGX Spark en bénéficie directement.
Le point crucial pour un agent IA est la capacité à gérer des sessions multiples. Les tests de la communauté (forums.developer.nvidia.com, août 2026) montrent que le DGX Spark peut servir plusieurs agents simultanément : avec DeepSeek V4 Flash 0731, un modèle MoE de 284 milliards de paramètres dont seulement 13 milliards sont actifs, on atteint 59 tok/s en multi-agent serving sur une configuration double Spark. C’est un chiffre remarquable, qui montre que la plateforme n’est pas limitée aux petits modèles.
Un outil de référence est venu structurer ce paysage : AA-AgentPerf-Local, publié par Artificial Analysis le 29 septembre 2026. Il s’agit d’un outil open source pour tester la vitesse d’exécution des agents IA sur laptops et stations de travail, avec des résultats de lancement pour le DGX Spark, le Ryzen AI Halo, le MacBook Pro (M5 Pro) et le RTX 5090 sur quatre modèles open weight. C’est désormais la grille de lecture la plus récente et la plus comparable pour évaluer si le Portable Computer tient ses promesses sur un Spark donné.
Et pour les gros modèles ? Le dual-Spark et la question du 405B
La question que tout le monde se pose : peut-on faire tourner des modèles de 405 milliards de paramètres sur un DGX Spark ? La réponse est oui, mais avec des compromis. Deux DGX Spark interconnectés peuvent exécuter un modèle 405B, mais les performances restent inférieures à celles du cloud. C’est une nuance importante.
L’interconnexion entre deux Spark est un point technique délicat. Le DGX Spark dispose d’un lien 10GbE (1,25 Go/s de débit théorique), ce qui est correct mais loin des interconnexions haute vitesse des serveurs de données. Pour un modèle 405B, il faut sharder les poids entre les deux machines, et chaque communication entre les couches du modèle passe par ce lien. Le goulot d’étranglement est là : la bande passante mémoire de chaque Spark est de 273 Go/s (pour le GB10), mais l’interconnexion entre les deux n’atteint que 1,25 Go/s. C’est un facteur de 200 entre la bande passante interne et externe.
Les retours de la communauté sur le dual-Spark avec DeepSeek V4 Flash 0731 (forums.developer.nvidia.com, août 2026) sont instructifs. L’un des utilisateurs a dû corriger ses mesures : « my decode-share numbers were wrong, and one of my conclusions was too ». La configuration requiert des ajustements fins, notamment sur le KV-cache et le scheduling. Un autre utilisateur rapporte qu’avec une petite modification de configuration, le modèle passe de 30 tok/s à une « acceptance rate » bien meilleure. Autrement dit, le dual-Spark fonctionne, mais il demande une expertise que le Portable Computer ne fournit pas encore.
Les chiffres canoniques de l’été 2026 confirment cette lecture : en configuration 2× DGX Spark avec TP=2 sous vLLM et DeepSeek-V4-Flash FP8, on atteint environ 350 tok/s agrégés à concurrence 32, mais seulement ~41 tok/s en single-stream — et un prefill d’environ 1 785 tok/s. Le pool de cache KV partagé sur deux nœuds atteint 1 105 096 tokens, ce qui ouvre la voie à des agents à très long contexte. À l’inverse, un seul Spark sur DeepSeek-V4-Flash IQ2_XXS plafonne à ~14 tok/s en single-stream avec un prefill de 410 tok/s. Le message est clair : le cluster change la donne pour les charges agentiques, pas pour la latence d’un utilisateur unique.
Le logiciel de Perplexity, dans sa version initiale, ne supporte que Qwen 3.8 27B et PPLX 27B. Il ne gère donc pas nativement le mode cluster. Pour l’instant, le Portable Computer est un produit mono-machine. C’est une limitation assumée, mais qui laisse la porte ouverte : si Perplexity étend son support aux configurations multi-nœuds, le produit deviendrait un sérieux concurrent des serveurs cloud pour les charges de travail agentiques lourdes.
Le TCO en question : local vs cloud, qui gagne vraiment ?
Analysons maintenant la dimension économique, souvent décisive — et c’est là que le contexte 2026 complique sérieusement le calcul.

Le DGX Spark a connu une valse des prix qui a rebattu les cartes. La Founders Edition a été lancée à 3 999 $, puis NVIDIA l’a relevée à 4 699 $ le 23 février 2026, en invoquant la flambée des prix de la mémoire (LPDDR5X/NAND). Depuis, la situation s’est encore tendue : selon plusieurs sources d’octobre 2026, la version 128 Go dépasse désormais les 6 000 $ sur le marché, tandis que NVIDIA a officialisé une déclinaison 64 Go à 4 999 $, disponible à partir du 23 octobre 2026. Autrement dit, la version « entrée de gamme » coûte aujourd’hui plus cher que la version 128 Go à son lancement en 2025 — une inversion qui résume la tension sur la mémoire.
À ce coût matériel, il faut ajouter l’électricité, la maintenance et la dépréciation sur 3 ans. Un usage intensif — disons 8 heures par jour à pleine charge — consomme environ 100-150 W pour le Spark, soit 300-450 kWh par an. À 0,20 €/kWh, cela représente 60 à 90 € par an. La maintenance logicielle est quasi nulle pour un particulier, mais pour une entreprise, il faut compter le temps d’administration.
Face à cela, la concurrence s’organise. Le Ryzen AI Halo d’AMD (Strix Halo, Ryzen AI MAX+ 395) est proposé à 3 999 $ avec 128 Go de mémoire unifiée et 256 Go/s de bande passante, sous-cotant le DGX Spark de 700 $. Mais l’écart de performances est net sur le prefill : environ 340 tok/s pour le Halo contre ~1 720 tok/s pour le Spark sur gpt-oss 120B, pour un débit de génération quasi identique (~34 vs ~39 tok/s), les deux machines étant limitées par la bande passante. Les variantes OEM du Spark, comme l’ASUS Ascent GX10, ont elles aussi vu leur prix grimper (de 2 999 $ à 3 999 $ le 18 août 2026), et l’Acer DGX se positionne 500 à 1 000 $ sous le prix NVIDIA officiel avec le même GB10 et 128 Go.
Pour un flux de travail agentique lourd, la comparaison avec le cloud dépend du volume. Plus vous consommez de tokens, plus l’amortissement du matériel local devient favorable — à condition de ne pas avoir besoin de la dernière frontière de raisonnement en permanence. C’est exactement le pari de Portable Computer : garder le gros du travail en local, et ne payer le cloud que pour les cas où le modèle local ne suffit pas.
Fine-tuning : ce que le Spark permet vraiment
Un des arguments forts du DGX Spark face aux boîtiers concurrents est sa capacité à faire du fine-tuning, pas seulement de l’inférence. C’est un point que le Portable Computer n’exploite pas encore directement, mais qui compte pour quiconque veut adapter un modèle à son domaine.
L’exploit souvent cité dans la communauté est la possibilité de faire du fine-tuning LoRA d’un modèle 35B en BF16 sur un seul Spark, grâce aux 128 Go de mémoire unifiée. C’est précisément le type de tâche où le Spark justifie sa prime par rapport à un Strix Halo : le Halo est excellent en inférence bande-passante-limitée, mais l’écosystème CUDA et la maturité des outils de fine-tuning restent l’apanage de NVIDIA. Pour un utilisateur qui veut à la fois faire tourner un agent local et l’affiner sur ses propres données, le Spark est aujourd’hui le choix le plus cohérent — même à 4 699 $ ou plus.
La déclinaison 64 Go change toutefois la donne pour le fine-tuning. Avec la moitié de la mémoire, les marges se réduisent : les modèles plus gros et les contextes longs deviennent difficiles, et le fine-tuning se limite à des modèles plus petits ou à des méthodes plus économes. C’est un arbitrage à connaître avant d’acheter.
L’écosystème logiciel : CUDA 13.x, TensorRT-LLM, NemoClaw et Windows
Le Portable Computer ne vit pas seul. Il s’appuie sur un écosystème logiciel qui a beaucoup évolué en 2026.

Côté NVIDIA, la pile s’articule autour de CUDA 13.x, TensorRT-LLM et de l’outillage NemoClaw, avec des mises à jour à cadence mensuelle qui touchent au noyau, aux pilotes, mais aussi à des firmwares UEFI, EC, USB PD, TPM et SoC. La mise à jour majeure de juin 2026 a notamment introduit le NVFP4 (format de quantification FP4) et un clustering simplifié, tandis que la vague de juillet 2026 a corrigé des problèmes d’OOM, de mémoire d’affichage et de cloud-init. Pour un utilisateur de Portable Computer, cela signifie que la machine se comporte de plus en plus comme un service : il faut accepter de suivre les vagues, sous peine de se retrouver avec des incompatibilités.
Côté Microsoft, le paysage a basculé début octobre 2026. Le 7 octobre 2026, Microsoft a présenté sa vision d’une « Intelligence Hybride » pour Windows, avec des agents IA sécurisés et l’IA locale au cœur du système. Le même jour, la keynote évoquait explicitement DeepSeek V4 Flash et l’IA locale sur PC. Windows 11 26H2 est par ailleurs disponible depuis fin septembre 2026. Pour Portable Computer, dont la prise en charge de Windows est promise, cette convergence est une aubaine : le terrain est préparé par l’OS lui-même.
Enfin, la gamme matérielle s’élargit. NVIDIA a dévoilé la DGX Station for Windows (748 Go de mémoire cohérente, 20 pétaflops FP4, lancement au Q4 2026 via six partenaires OEM), qui vise des modèles à 1 000 milliards de paramètres sur un bureau. Le Spark n’est donc plus seul : il devient l’entrée de gamme d’une famille qui monte en puissance.
Ce qu’il faut retenir
Le Portable Computer de Perplexity n’est pas une révolution matérielle — c’est un logiciel bien pensé, adossé à un matériel qui a mûri. Sa force est d’assembler, dans un bundle clé en main, un modèle solide (Qwen 3.8 27B / PPLX 27B), un orchestrateur local et une promesse de confidentialité crédible. Sa limite est double : il reste mono-machine dans sa version initiale, et il dépend d’un DGX Spark dont le prix a fortement augmenté en 2026.
Pour l’acheteur, la question n’est plus « local ou cloud ? » mais « quel local, pour quel usage ? ». Si vous faites surtout de l’inférence sur des modèles MoE, un boîtier Strix Halo moins cher peut suffire. Si vous voulez du prefill rapide, du fine-tuning, du clustering et un écosystème CUDA mature — et que vous voulez faire tourner un agent comme Portable Computer sans rationner vos tokens — le DGX Spark reste la référence, à condition d’accepter son nouveau prix. La vraie nouveauté de l’automne 2026 n’est pas un chiffre : c’est que l’IA agentique locale est devenue un produit, pas un projet.
Sources
- Perplexity — Découvrez Portable Computer pour l’IA locale
- Perplexity — Introducing Portable Computer for local-first AI
- NVIDIA — DGX Spark
- NVIDIA Developer — Nemotron 3.5 Lightning
- Artificial Analysis — AA-AgentPerf-Local (29 septembre 2026)
- Compute Market — DGX Spark vs Strix Halo: The 128GB Local-AI Desktop Showdown (2026)
- RunAIHome — AMD Ryzen AI Halo vs NVIDIA DGX Spark 2026
- ScienceActu — Portable Computer de Perplexity : l’agent IA local-first sur DGX Spark
- Microsoft — Building Windows for hybrid intelligence (7 octobre 2026)
- Journal du Geek — Windows présente son « Intelligence Hybride » (7 octobre 2026)
- Frandroid — Nvidia lance le DGX Spark en 64 Go (2 octobre 2026)
- Clubic — NVIDIA lance un DGX Spark 64 Go (2 octobre 2026)
- PauseHardware — Le DGX Spark perd la moitié de sa mémoire mais conserve son tarif de 4 999 $ (2 octobre 2026)
- NeoTeo — DGX Spark 64 Go : NVIDIA annonce une configuration (3 octobre 2026)
- Tech-Insider — NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs (8 octobre 2026)
- Context Studios — Matériel pour l’IA locale en 2026 : DGX Spark, Mac Studio M5 Ultra, RTX 5090 et Strix Halo comparés (24 septembre 2026)
- Forums NVIDIA Developer — retours communauté dual-Spark et DeepSeek V4 Flash (août 2026)
Article recherché et rédigé automatiquement · Magazine Electrosens