
 Magazine LLM Opensource · 11 September 2026
La fin des fossés défensifs : quand l’open source a gagné la guerre des modèles
En à peine deux ans, l’avantage compétitif des modèles propriétaires s’est volatilisé. Entre la sortie de Llama 3.1 en juillet 2024 et celle de DeepSeek V3 en décembre de la même année, la parité de performance sur les benchmarks est devenue la norme, et des analystes comme SemiAnalysis ont pu déclarer la mort du « fossé défensif » de l’IA. Aujourd’hui, en septembre 2026, la question n’est plus de savoir quel modèle est le meilleur, mais comment orchestrer des systèmes complexes avec des briques devenues des commodités. Voici l’état des lieux d’une bascule historique.
Six mois pour combler le fossé
Il faut se souvenir de l’état du paysage à l’été 2024. GPT-4o et Claude 3.5 Sonnet régnaient en maîtres, et l’idée qu’un modèle ouvert puisse rivaliser avec les fleurons propriétaires relevait encore du vœu pieux. La sortie de Llama 3.1, le 23 juillet 2024, a marqué un premier tournant : Meta publiait un modèle de 405 milliards de paramètres sous licence open source, avec des performances qui, sur de nombreux benchmarks, se rapprochaient dangereusement des modèles fermés. Puis vint DeepSeek V3 en décembre 2024, et là, le choc fut total : un modèle chinois, entraîné pour une fraction du coût des géants américains, atteignait des scores comparables sur MMLU, HumanEval et GPQA. La trajectoire était claire : la parité n’était plus une promesse, mais une réalité.
Ce que cette séquence a révélé, ce n’est pas seulement la qualité technique des modèles ouverts, mais la vitesse à laquelle l’écart se comblait. Là où il fallait auparavant des années pour rattraper un leader, il suffisait désormais de quelques mois. Les analystes de SemiAnalysis, suivis par une large partie de la presse spécialisée, ont alors popularisé l’expression : « le fossé défensif de l’IA est mort ». Non pas que les modèles propriétaires soient devenus mauvais — ils restent excellents — mais leur avantage quantitatif sur les benchmarks s’est effondré. Et avec lui, la justification économique de payer des prix premium pour des API fermées.
Le mouvement s’est accéléré en 2025 et 2026. En août 2025, quinze modèles chinois figuraient déjà dans le top 20 du classement d’Artificial Analysis. En août 2026, Z.ai sortait GLM-5.3, un modèle Mixture-of-Experts de 743 milliards de paramètres, sans ajouter un seul paramètre nouveau par rapport à la version précédente, mais en gagnant des points spectaculaires sur Terminal-Bench 3.0 (de 4,6 % à 28,3 %) grâce au seul post-entraînement. Le message est limpide : la frontière de la performance s’est déplacée de l’architecture vers les données et les techniques d’entraînement, et l’open source est en première ligne.
La mécanique de la chute : distillation, MoE et quantization
Comment expliquer une telle accélération ? Trois leviers techniques ont convergé pour casser les coûts et démocratiser l’accès aux modèles de pointe.
D’abord, la distillation de données synthétiques. Les grands laboratoires ont compris qu’ils pouvaient utiliser leurs meilleurs modèles pour générer des données d’entraînement de très haute qualité, puis les réutiliser pour entraîner des modèles plus petits et moins chers. Cette technique, popularisée par les travaux de Meta et de Mistral, a permis à des modèles de 70 milliards de paramètres d’atteindre des performances proches de modèles dix fois plus gros. Le cas de Qwen 2.5 est emblématique : cette collection de modèles « open weight » publiée le 18 septembre 2024 par Alibaba Cloud, sous licence Apache 2.0, a été entraînée sur jusqu’à 18 000 milliards de tokens, avec une fenêtre de contexte de 128 000 tokens. Selon Hugging Face, le modèle de 72 milliards de paramètres surpasse Mistral Large 2, Mixtral 8x22B et Llama 3.1 70B, et n’est que légèrement distancé par Llama 3.1 405B. Le tout avec une architecture dense, sans recours à la Mixture-of-Experts — preuve que la qualité des données prime sur la taille du modèle.
Ensuite, les architectures Mixture-of-Experts (MoE) ont révolutionné l’efficacité de l’inférence. Au lieu d’activer l’ensemble des paramètres à chaque token, un modèle MoE n’en sollicite qu’une fraction. GLM-5.3, avec ses 743 milliards de paramètres, n’active qu’une partie d’entre eux à chaque inférence, ce qui réduit drastiquement le coût de calcul. DeepSeek V3 a poussé cette logique encore plus loin, et DeepSeek V4-Pro, sorti en août 2026, continue sur cette lancée avec un prix par token défiant toute concurrence, tout en offrant une fenêtre de contexte d’un million de tokens. La course aux paramètres n’est plus le critère ; c’est l’efficacité par token qui compte.
Enfin, la quantization a rendu ces modèles déployables sur du matériel modeste. Les techniques comme AWQ (Activation-aware Weight Quantization) ont réduit la pénalité de perplexité en INT4 de 74 % par rapport à GPTQ (de 4,57 à 1,17), permettant de faire tourner des modèles de 70 milliards de paramètres sur des GPU grand public avec une perte de qualité négligeable. Un modèle de 70B en FP16 pèse environ 140 Go, mais en GGUF Q4_K_M, il tombe à 40-45 Go. Cette compression a ouvert la voie au déploiement local, sur des postes de travail, voire des laptops. C’est ce qui a rendu possible l’émergence de modèles comme Muse Glimmer, le modèle agentique multimodal de 30 milliards de paramètres publié par Meta en août 2026 sous licence Apache 2.0, conçu pour fonctionner sur PC et Mac.
Le vrai prix du token : sortir des API propriétaires
Pendant des années, la comparaison entre modèles s’est faite au prix catalogue du million de tokens. GPT-4o et Claude 3.5 Sonnet affichaient des tarifs élevés, justifiés par leur supériorité présumée. Mais à mesure que la parité s’est installée, ce critère a perdu de sa pertinence. Les analyses de coût total de possession (TCO) ont mis en lumière ce que les praticiens savaient déjà : le prix du token n’est qu’une fraction du coût réel d’un système à base de LLM.
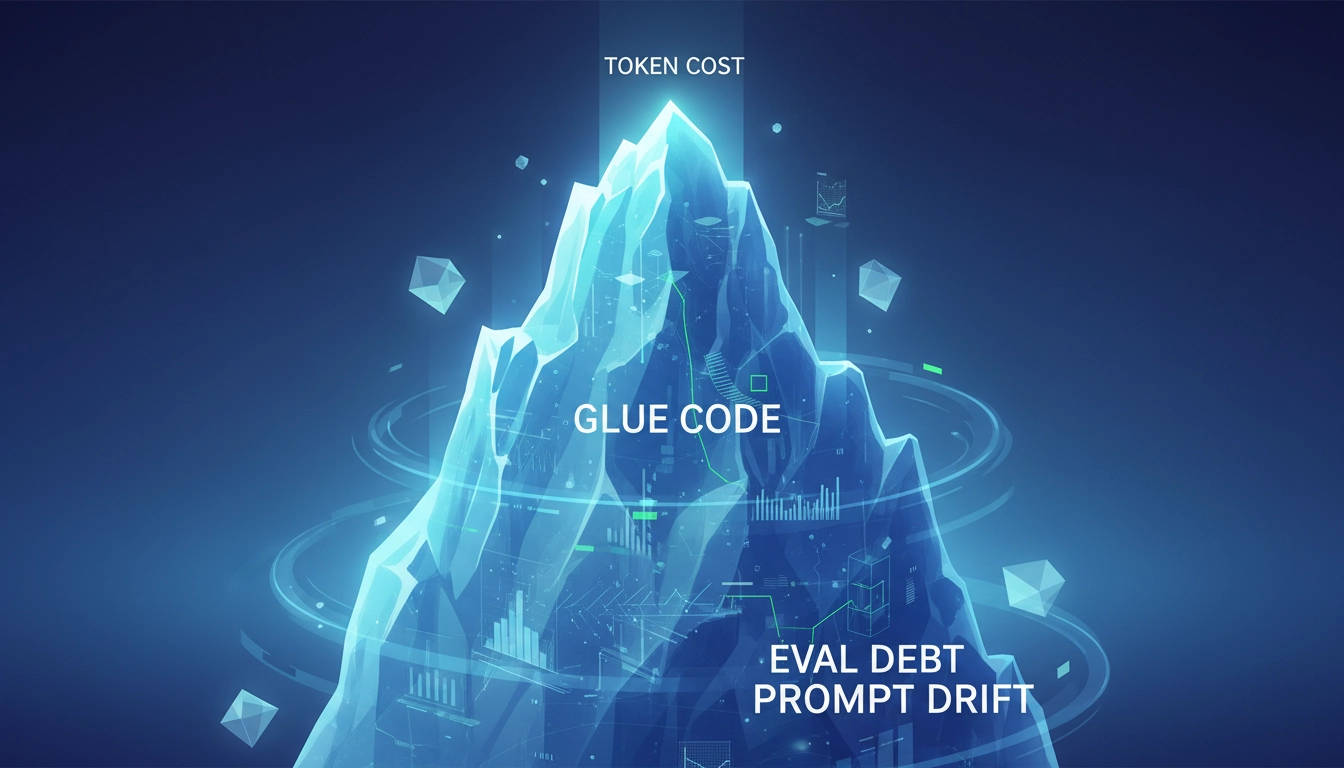
Les coûts cachés sont nombreux. Le « glue code » d’abord : l’intégration d’une API propriétaire dans une infrastructure existante demande du développement, des tests, de la maintenance. Le « prompt drift » ensuite : les modèles propriétaires évoluent en silence, et les prompts qui fonctionnaient hier peuvent produire des résultats différents demain, sans avertissement. Enfin, la « dette d’évaluation » : chaque changement de modèle impose de réévaluer l’ensemble des cas d’usage, un travail chronophage et souvent sous-estimé. Ces coûts, bien réels, ne figurent sur aucune facture, mais pèsent lourd dans le budget des équipes.
Face à cela, l’auto-hébergement d’un modèle open source sur AWS, Azure ou GCP devient économiquement rationnel, même en comptant l’infrastructure. Les prix des instances GPU ont baissé, et les modèles quantizés tournent sur du matériel moins coûteux. Les entreprises qui ont fait ce calcul — et elles sont nombreuses, comme le rapporte le New York Times dans son enquête de septembre 2026 sur l’adoption de l’IA open source par les entreprises américaines — réalisent des économies substantielles tout en gardant le contrôle de leurs données. La souveraineté n’est plus un luxe, c’est une option par défaut.
Le tableau ci-dessous compare quelques modèles open weight récents, avec leurs caractéristiques clés :
| Modèle | Date de sortie | Paramètres | Contexte | Licence | Particularité |
|---|---|---|---|---|---|
| Qwen 2.5 (72B) | 18 septembre 2024 | 72B (dense) | 128K | Apache 2.0 | Entraîné sur 18 000 Md de tokens |
| GLM-5.3 | 14 août 2026 | 743B (MoE) | 1M | Open weight | Post-entraînement seul, +23,7 pts sur Terminal-Bench 3.0 |
| DeepSeek V4-Pro | août 2026 | non précisé | 1M | Open weight | Prix très agressif sur OpenRouter |
| Muse Glimmer | 14 août 2026 | 30B | non précisé | Apache 2.0 | Agentique, conçu pour exécution locale |
| Hy4 (Tencent) | 8 septembre 2026 | 770B (49B actifs) | 1M | Open source | Coding, bureautique, recherche |
Le casse-tête du praticien : choisir, fine-tuner, déployer
Cette abondance d’offres ouvertes transforme le métier des équipes techniques. Fini le temps où il suffisait de choisir entre deux ou trois API propriétaires. Aujourd’hui, un praticien doit arbitrer entre des dizaines de modèles open weight, tous crédibles, avec des compromis différents en termes de latence, de coût, de qualité et de souveraineté. Le leaderboard BenchLM, qui classe 95 modèles open-weight en juillet 2026, donne une idée de la profusion.

La question centrale est devenue : quand fine-tuner un modèle open source plutôt que d’appeler une API fermée ? La réponse tient en trois critères : la confidentialité des données, la latence requise, et le coût à l’échelle. Si les données sont sensibles, si la latence doit être minimale, ou si le volume d’inférence est massif, le fine-tuning d’un modèle local devient rapidement la meilleure option. Les outils ne manquent pas : Axolotl, par exemple, supporte plus de 100 modèles, avec un support multimodal natif (LLaMA-Vision, Qwen2-VL, Pixtral), et permet de fine-tuner un Llama-3.1 8B en QLoRA en 5,8 heures sur une seule A100 40 Go. La barrière à l’entrée est devenue très basse.
Mais cette facilité cache un nouveau défi : la gestion du cycle de vie des modèles. Un modèle fine-tuné doit être réévalué à chaque mise à jour du modèle de base, et les benchmarks internes doivent être maintenus. La dette d’évaluation, ce concept qui consiste à accumuler des tests obsolètes, devient un vrai sujet de gestion. Les équipes qui réussissent sont celles qui automatisent l’évaluation continue et qui traitent leurs modèles comme des composants logiciels, avec des versions, des tests de régression et des procédures de rollback. La compétence se déplace de la sélection du modèle vers l’ingénierie système.
Les nouveaux remparts : données propriétaires et agents
Si les poids du modèle sont devenus des commodités, la différenciation se déplace ailleurs. Les données propriétaires restent le principal avantage compétitif : un modèle fine-tuné sur un corpus interne, enrichi par du RAG (Retrieval-Augmented Generation) sur des bases documentaires exclusives, produit des résultats qu’aucun modèle générique ne peut égaler. C’est là que se joue la vraie valeur, et c’est un avantage structurellement difficile à copier, même avec les mêmes poids ouverts.
Les workflows agentiques constituent le deuxième rempart. Un agent qui orchestre plusieurs modèles, des outils externes, des bases de données et des API métier est un système complexe, ancré dans l’infrastructure de l’entreprise. Le copier nécessiterait de copier toute l’organisation. Meta l’a bien compris avec Muse Glimmer, un modèle agentique conçu pour fonctionner localement sur les postes de travail, ouvrant la voie à des agents personnels qui traitent les données sans les envoyer dans le cloud. Les entreprises qui construisent des systèmes agentiques sur des modèles ouverts créent une valeur qui ne dépend pas de la qualité intrinsèque du modèle, mais de l’orchestration.
Il faut aussi mentionner les risques. Les poids ouverts sont modifiables, et des recherches comme BackdoorLLM (accepté à NeurIPS 2025) ont montré qu’il est possible d’injecter des portes dérobées dans des modèles, avec 8 stratégies d’attaque testées sur 6 architectures et 200 expériences. La confiance dans la chaîne d’approvisionnement des modèles devient un enjeu de sécurité majeur, comme l’a illustré la faille NemoClaw découverte en août 2026 dans l’API d’Ollama, permettant un empoisonnement persistant des modèles. Les praticiens doivent donc intégrer la vérification des poids et l’audit des modèles dans leurs processus.
L’écosystème se régionalise : Qwen, Mistral et la verticalisation
La commoditisation a aussi bouleversé la géopolitique de l’IA. Les architectures chinoises, en particulier Qwen d’Alibaba, servent désormais de base à des modèles régionaux. En septembre 2026, une entreprise saoudienne a lancé un LLM basé sur un modèle chinois, illustrant cette dynamique de transfert technologique. Les modèles chinois dominent les classements : quinze des vingt meilleurs modèles selon Artificial Analysis en août 2025 étaient chinois, et cette tendance s’est confirmée avec GLM-5.3, DeepSeek V4-Pro et Hy4 de Tencent (770 milliards de paramètres, 49 milliards actifs, contexte d’un million de tokens, sorti en preview le 8 septembre 2026).
Face à cela, les acteurs européens cherchent leur voie. Mistral AI, le champion français, a bouclé le 8 septembre 2026 une levée de fonds de 3 milliards d’euros, un montant record qui lui permet de financer l’intégration verticale : matériel, modèles, cloud. Cette stratégie contraste avec celle de Meta, qui utilise l’open source comme une arme défensive pour éroder la part de marché d’OpenAI, et avec celle des acteurs chinois, qui utilisent l’open source agressif pour conquérir la communauté mondiale de développeurs. Mistral mise sur la souveraineté européenne et la confiance, un positionnement qui trouve un écho auprès des institutions et des grandes entreprises du continent.
Le nouveau champ de bataille n’est plus la qualité du modèle, mais l’intégration verticale. Les fournisseurs qui contrôlent la pile complète — des puces aux API en passant par les modèles — ont un avantage structurel. NVIDIA l’a compris avec ses NPU et ses frameworks d’inférence comme TensorRT-LLM, tandis que des acteurs comme vLLM et SGLang se disputent le marché de l’optimisation d’inférence. Le Ray Summit 2026, qui s’est tenu fin août à San Francisco, a mis en évidence cette convergence : le post-entraînement par renforcement (RL) impose une convergence des infrastructures open source, et la frontière entre entraînement et inférence s’estompe.
De l’inférence au déploiement : l’ère des NPU et du edge
La commoditisation pousse les coûts d’inférence vers zéro, et cela change radicalement les options de déploiement. Les NPU (Neural Processing Units) spécialisés, longtemps cantonnés aux smartphones, deviennent des cibles crédibles pour l’inférence de LLM en périphérie. L’article de SemiEngineering sur les NPU packet-based dans l’ère des LLM souligne le basculement des charges de travail : de compute-bound (limitées par le calcul) à memory-bound (limitées par la bande passante mémoire), ce qui favorise les architectures spécialisées pour l’edge et l’automobile.
Pour le praticien, cela signifie une nouvelle dimension d’arbitrage : où placer l’inférence ? Dans le cloud, pour les tâches lourdes et non sensibles ; en on-premise, pour les données confidentielles ; en edge, pour les applications à faible latence ou hors ligne. Muse Glimmer, avec ses 30 milliards de paramètres fonctionnant sur un PC ou un Mac, est l’illustration parfaite de cette tendance. Les modèles deviennent des composants embarqués, et le praticien devient un architecte d’infrastructure, qui doit optimiser latence, confidentialité et coût en fonction des cas d’usage.
Cette évolution s’accompagne de nouveaux défis. La sécurité des systèmes agentiques, par exemple, est devenue un sujet de premier plan : l’OWASP GenAI Security Project a publié en septembre 2026 son Top 10 pour les applications LLM, avec un nouveau standard de contrôle des agents. Les modèles déployés en edge doivent être mis à jour, surveillés, et protégés contre les attaques par extraction ou empoisonnement. La commoditisation n’élimine pas la complexité ; elle la déplace vers les couches système.
Et maintenant ? La commoditisation comme point de départ
Que nous réserve cette bascule ? Sur le court terme, la course aux benchmarks va continuer, mais avec des gains marginaux de plus en plus faibles. La valeur se déplacera inexorablement vers l’orchestration de systèmes complexes : des pipelines agentiques, des bases de connaissances propriétaires, des boucles de rétroaction humaines. Les entreprises qui réussiront seront celles qui traiteront les modèles comme des commodités interchangeables, et qui investiront dans l’ingénierie des données et des systèmes.
La question finale est de savoir qui gagne vraiment quand l’intelligence devient un bien de première nécessité. Les intégrateurs, qui savent assembler des briques hétérogènes en solutions fiables, ont un rôle central. Les détenteurs de données, qui possèdent les corpus exclusifs qui font la différence, ont un avantage structurel. Et les fournisseurs d’infrastructure — qu’il s’agisse des clouds publics ou des fabricants de puces — captent une part croissante de la valeur, car c’est eux qui rendent possible l’exécution à grande échelle. La commoditisation des modèles n’est pas une fin, c’est un point de départ : elle libère les énergies pour des problèmes plus intéressants, et plus humains, que la simple course à la performance.
Sources
- LLM Moats Quickly Evaporating — Hackaday, 30 août 2026
- Open-source AI developer Mistral closes €3B funding round — SiliconANGLE, 8 septembre 2026
- Corporate America Is Getting Hooked on Open-Source A.I. — The New York Times, 4 septembre 2026
- Packet-Based NPUs In The LLM Era — SemiEngineering
- Saudi firm launches LLM based on Chinese AI model — Global Times, septembre 2026
- Tencent Releases Open-Source Hy4 LLM Preview With 770B Parameters and 1M+ Token Context — GadgetPilipinas, 8 septembre 2026
- Z.ai releases GLM-5.3 for coding and cyber work — DataNorth, 17 août 2026
- GLM-5.3: Z.ai Tops the Open Coding Leaderboard on Post-Training Alone — The Agent Report, 14 août 2026
- DeepSeek V4-Pro Shows China’s AI Price War Is Not Slowing — TechBooky, 13 août 2026
- Meta lance Muse Glimmer : une IA open-source pour les agents IA locaux — ITdaily, 12 août 2026
- OWASP GenAI Security Project Releases 2026 Top 10 for LLM Applications — TMCnet, 2 septembre 2026
- NemoClaw i OpenClaw: błąd sieciowy w API Ollama — Security Bez Tabu, 26 août 2026
- Ray Summit 2026: RL Post-Training Forces Open-Source AI Infrastructure to Converge — TechTimes, 25 août 2026
- LLM Inference Optimization: vLLM vs TensorRT-LLM vs SGLang Decision Framework — Spheron Blog, 19 août 2026
- [Qwen 2.5 — LeMagIT, septembre 2024](https://www.le magit.fr) (via les faits datés du magazine)
Article recherché et rédigé automatiquement · Magazine Electrosens