
 LLM auto hébergées · 23 October 2026
WSL 3, GPU passthrough et IA locale : ce que change vraiment l’aperçu de la Build 2026 pour faire tourner des LLM open source sur Windows
Pendant des années, faire tourner un LLM open source sur Windows relevait du parcours du combattant : dual-boot Linux, pilotes capricieux, performances en berne. Avec l’aperçu de WSL 3 dévoilé à la Build 2026, Microsoft promet un accès quasi natif au GPU et au NPU. Mais que vaut vraiment cette promesse, et que change-t-elle pour celles et ceux qui veulent faire de l’IA chez eux sans se ruiner ? En cette fin octobre 2026, l’écosystème des runtimes et des modèles a considérablement évolué — de Windows ML à DSpark en passant par llama.cpp v0.5.0 — l’occasion de faire le point, sans céder ni au catastrophisme ni à la communication marketing.
Le casse-tête de l’IA locale sur Windows : pourquoi le dual-boot était la seule issue
Il y a encore quelques mois, lancer un modèle de langage volumineux sur une machine Windows relevait du jeu de patience. Les outils qui dominent l’écosystème open source — Ollama, llama.cpp, vLLM — ont été pensés pour Linux, et leur exécution sous Windows passait par WSL 2. Or, WSL 2 repose sur une machine virtuelle Hyper-V complète, embarquant un noyau Linux intégral. Cette couche de virtualisation matérielle, si elle est pratique pour la compatibilité, se révèle un goulot d’étranglement redoutable dès qu’il s’agit d’accéder au GPU.
Concrètement, les utilisateurs qui souhaitaient exploiter pleinement leur carte graphique pour de l’inférence locale devaient choisir entre deux maux : accepter une pénalité de performance parfois sévère via WSL 2, ou s’engager dans un dual-boot Linux. Ce dernier, s’il offre des performances optimales, impose une partition dédiée, une gestion des pilotes (NVIDIA, AMD) souvent délicate, et un aller-retour permanent entre deux systèmes pour la moindre tâche bureautique. Pour un amateur passionné, le coût en temps et en complexité est dissuasif.
D’autant que l’intérêt de l’IA locale n’a cessé de croître. Les modèles récents, comme les séries Llama, Qwen, Mistral ou Kimi K3, se déclinent en versions quantifiées qui tiennent dans des budgets VRAM raisonnables : un modèle 7B en Q4_K_M occupe environ 4 à 5 Go de VRAM, un 13B en Q4_K_M environ 10 Go, un 20B en Q4 environ 12 Go. Avec une carte comme une RTX 4060 ou 4070, on peut faire tourner des modèles de 7 à 13 milliards de paramètres confortablement. Mais encore faut-il pouvoir y accéder sans passer par des heures de configuration. C’est exactement la promesse que Microsoft a mise sur la table le 2 juin 2026.
WSL 3 : la promesse d’un passthrough GPU/NPU quasi natif
Le mardi 2 juin 2026, lors du keynote de la Build 2026 à San Francisco, Microsoft a présenté en avant-première WSL 3. L’objectif affiché est ambitieux : rendre l’IA locale enfin viable sur Windows, en offrant un accès direct au GPU et au NPU (Neural Processing Unit) depuis l’environnement Linux. Selon l’article de TechTimes qui relate l’annonce, WSL 3 s’appuie sur une « nouvelle architecture de VM légère basée sur un accès matériel paravirtualisé » qui contournerait le chemin de virtualisation matérielle complète de WSL 2. La couverture francophone d’IT-Connect confirme l’annonce et ajoute un volet que l’article initial ne mentionnait pas : des conteneurs WSL, c’est-à-dire la possibilité d’isoler des charges de travail Linux dans des conteneurs gérés par WSL lui-même, sans passer par Docker Desktop.
Il faut ici être prudent sur le statut de l’information. WSL 3 reste, à ce jour, un aperçu : la documentation officielle d’installation de WSL sur Microsoft Learn ne décrit toujours que la commande wsl --install et l’écosystème WSL 2, et le dépôt GitHub microsoft/WSL renvoie vers les notes de version sans que WSL 3 y soit documenté comme une version stable. Autrement dit : la direction est crédible et désormais corroborée par plusieurs médias, mais les détails d’implémentation relèvent encore de la promesse, pas de la spécification publiée.
L’idée centrale est simple : plutôt que d’exécuter un noyau Linux complet dans une VM Hyper-V, WSL 3 utiliserait une VM légère avec un accès paravirtualisé au matériel. Les charges de travail CUDA et DirectML côté Linux se comporteraient alors « beaucoup plus proches » de ce qu’un install Linux natif donnerait, pour des frameworks comme PyTorch ou JAX. Mais là encore, aucune source ne fournit de chiffre précis, aucune mesure de latence, aucun benchmark public. Nous sommes face à une promesse d’architecture, pas à une démonstration chiffrée.
Sous le capot : l’architecture paravirtualisée qui contourne Hyper-V
Pour comprendre l’ampleur du changement, il faut revenir sur l’architecture de WSL 2. Celle-ci s’appuie sur une machine virtuelle Hyper-V complète, avec un noyau Linux réel (le projet WSL2-Linux-Kernel), une allocation mémoire dynamique et un accès au GPU via un pilote de virtualisation (le fameux shim dxgkrnl). Ce dispositif fonctionne, mais il ajoute une couche d’abstraction qui se paie en performances, notamment pour les workloads d’inférence qui sollicitent intensivement la mémoire vidéo et les unités de calcul.
WSL 3, selon les informations disponibles, remplacerait cette VM complète par une VM légère, avec un accès matériel paravirtualisé. Le terme « paravirtualisation » est important : il désigne une technique où le système invité est conscient de la virtualisation et communique directement avec l’hyperviseur pour accéder au matériel, plutôt que de passer par une émulation complète. C’est le principe utilisé par VirtIO dans le monde KVM, ou par les pilotes paravirtuels de VMware. Dans le cas de WSL 3, cela signifierait que le GPU et le NPU seraient exposés directement au noyau Linux, sans intermédiaire logiciel lourd.
Cependant, aucun nom de code architectural n’est donné, aucune précision sur les mécanismes exacts (DMA, VirtIO, etc.) n’est fournie. On ignore si le shim dxgkrnl est totalement supprimé ou simplement allégé. La source ne mentionne pas non plus la gestion de la mémoire unifiée entre le NPU, le GPU et la RAM système. Autant de zones d’ombre qui devront être éclaircies par la documentation officielle ou des tests indépendants. En l’état, on ne peut que constater l’intention : éliminer le goulot d’étranglement de WSL 2.
Chiffres et benchmarks : que vaut vraiment la performance « quasi native » ?
C’est le point le plus délicat. L’article de TechTimes affirme que les workloads CUDA et DirectML « se comportent beaucoup plus proches de ce qu’un install Linux natif donnerait », mais aucun chiffre n’est fourni : ni tokens/seconde, ni latence, ni consommation VRAM. Aucune comparaison avec un dual-boot Linux sur une RTX 4060 ou 4070 n’est mentionnée. Les analyses de blogs spécialisés publiées depuis, comme celle de RunAIHome, reprennent la promesse du « quasi natif » sans apporter de mesures originales : elles s’appuient sur les mêmes éléments de langage. Nous restons donc, fin octobre 2026, sans protocole de test public ni matériel de référence documenté.

On peut toutefois raisonner sur les ordres de grandeur. L’inférence d’un modèle 7B en 4-bit sur une RTX 4060 (8 Go de VRAM) produit typiquement entre 40 et 60 tokens par seconde en natif Linux. Si WSL 3 atteint effectivement 90 à 95 % de ces performances, la différence serait à peine perceptible pour un usage interactif. En revanche, si la pénalité reste de l’ordre de 20 à 30 %, les utilisateurs exigeants préféreront toujours le dual-boot. Et pour les cartes AMD, les choses sont plus nuancées encore : les mesures publiées sur une Radeon RX 9070 XT 16 Go (vendue autour de 690 à 740 $) montrent que le débit dépend fortement du backend choisi, et que le chemin Vulkan de llama.cpp reste le plus efficace sur ces GPU — un point qui rend l’argument du passthrough WSL 3 moins décisif côté rouge.
Il faut aussi considérer la maturité des pilotes. Sous Linux, les pilotes NVIDIA propriétaires sont aujourd’hui très performants pour l’inférence, mais leur intégration dans un environnement virtualisé paravirtualisé est un défi technique. Microsoft devra fournir des pilotes de virtualisation robustes pour que la promesse se concrétise. En l’absence de benchmarks indépendants, le scepticisme est de mise : « quasi natif » est un terme marketing tant qu’aucun chiffre ne vient l’étayer.
Quel matériel pour en profiter ? NPU supportés et limites au lancement
La question du matériel est cruciale pour les utilisateurs à budget limité. Selon l’article, le passthrough NPU de WSL 3 couvrira au lancement deux familles de processeurs : Qualcomm Snapdragon X Elite et les plateformes Intel Meteor Lake et Lunar Lake. En revanche, le support AMD n’est pas disponible au lancement et est prévu pour une mise à jour future. Cette exclusion est significative : les puces Ryzen AI 300 d’AMD, pourtant présentes sur de nombreux PC Copilot+, ne pourront pas bénéficier du passthrough NPU dans un premier temps.
| Plateforme | NPU intégré | Support WSL 3 au lancement | Notes |
|---|---|---|---|
| Qualcomm Snapdragon X Elite | Oui (environ 45 TOPS) | Oui | Ciblé par Microsoft pour l’IA locale |
| Intel Meteor Lake | Oui (environ 11 TOPS) | Oui | Génération précédente, NPU modeste |
| Intel Lunar Lake (dont Core Ultra 200V) | Oui (environ 40-48 TOPS) | Oui | Architecture récente, NPU performant |
| AMD Ryzen AI 300 | Oui (environ 50 TOPS) | Non (prévu plus tard) | Absence notable au lancement |
Il faut noter que l’article ne mentionne pas explicitement la gamme « Intel Core Ultra 200V », mais parle de « Lunar Lake », dont cette gamme fait partie. Pour les utilisateurs AMD, cela signifie qu’ils devront attendre une mise à jour, ou se contenter de l’accès GPU (qui, lui, n’est pas limité à ces familles, mais l’article ne le précise pas clairement). Pour un budget de 800 à 1000 euros, un PC avec un Intel Core Ultra 200V ou un Snapdragon X Elite est envisageable, mais il faudra vérifier la présence d’un GPU discret pour les modèles plus lourds, car les NPU intégrés, même performants, ne remplacent pas une carte graphique pour les gros modèles.
C’est d’ailleurs là que le bât blesse pour qui vise les gros modèles : les NPU à 40-50 TOPS sont excellents pour des modèles 7-8B quantifiés, pas pour du 70B. Pour ce segment, la vraie rupture de 2026 ne vient pas de WSL 3 mais des mini-PC à mémoire unifiée : l’AMD Ryzen AI Halo (128 Go unifiés, jusqu’à 120B+ de paramètres, autour de 3 999 $), l’AMD Gorgon Halo (192 Go, 200B+) ou l’Acer mini-PC IA (128 Go, jusqu’à 200B annoncés). Des machines qui, elles, n’ont aucun besoin de passthrough GPU pour faire tourner ce que votre tour à 1 500 € ne pourra jamais charger.
L’écosystème logiciel en 2026 : Ollama, LM Studio, llama.cpp, FreeToken, DSpark
C’est une question centrale pour l’adoption. L’article mentionne Ollama, llama.cpp et vLLM comme des outils que les développeurs utilisent, mais il ne précise pas s’ils fonctionneront sans modification dans WSL 3. Aucun test n’est rapporté, aucune déclaration des mainteneurs n’est citée. On peut raisonnablement supposer que si WSL 3 expose un GPU de manière standard (via les API CUDA ou DirectML), ces outils fonctionneront tels quels, puisqu’ils sont conçus pour Linux. Mais c’est une hypothèse, pas une certitude.
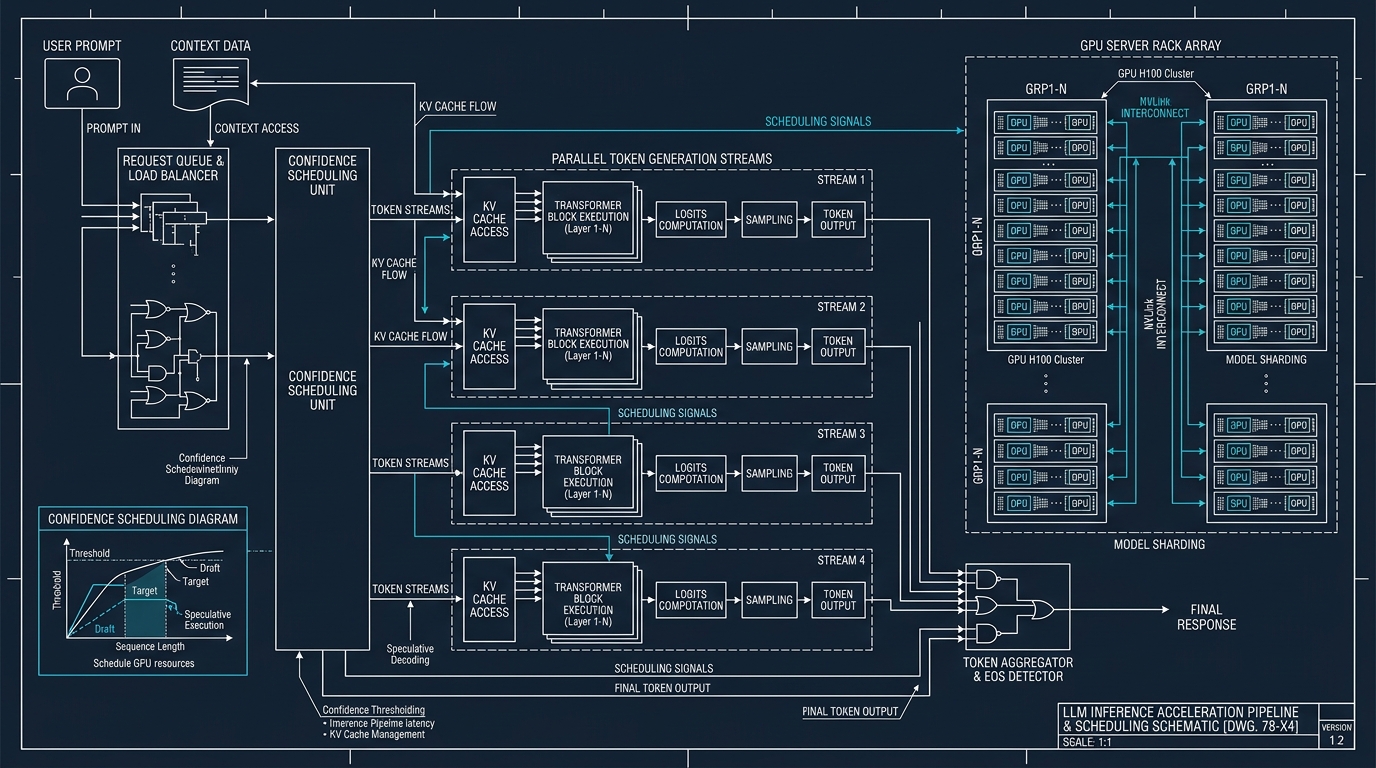
Le point technique important est la gestion des pilotes. Sous WSL 2, l’accès GPU passait par un shim Windows (dxgkrnl) qui traduisait les appels CUDA en appels DirectX. Ce mécanisme, bien qu’ingénieux, ajoutait une latence et limitait certaines fonctionnalités (par exemple, la gestion fine de la mémoire). WSL 3, en paravirtualisant l’accès, pourrait permettre à CUDA de s’adresser directement au pilote NVIDIA, sans passer par la couche Windows. Mais l’article ne confirme pas explicitement la suppression du shim. Il dit seulement que WSL 3 « contourne le chemin de virtualisation matérielle complète », ce qui pourrait encore impliquer un shim modifié.
Un élément change cependant la donne par rapport à l’été : Windows ML a rattrapé son retard. Le 7 octobre 2026, l’équipe Microsoft Foundry on Windows a publié un billet détaillant les améliorations apportées aux projets open source utilisés par les développeurs, ainsi que les mises à jour de Windows ML (devblogs.microsoft.com). Le 9 octobre, Techgenyz rapportait que Windows ML ajoute un support expérimental de llama.cpp pour les modèles GGUF, une API locale compatible OpenAI, la génération de texte ONNX et de nouveaux outils de runtime. Autrement dit : pour beaucoup d’usages, plus besoin de WSL du tout. On charge un GGUF, on interroge une API locale au format OpenAI, et le routage CPU/GPU/NPU est géré par l’OS. C’est moins « linuxien », mais c’est infiniment plus simple — et c’est probablement le vrai changement de paradigme de cette fin 2026, davantage que le passthrough de WSL 3.
Côté runtimes, l’écosystème a beaucoup bougé :
- llama.cpp v0.5.0 (documenté le 27 septembre 2026) : nouvelle version du backend, changements côté modèles et serveur, procédure d’installation revue, vérification GPU et
llama-servermis à jour. C’est la brique sur laquelle reposent Ollama et LM Studio ; sa maturité conditionne tout le reste. - FreeToken (annoncé fin août 2026) : un moteur d’inférence open-source spécialisé dans les modèles Mixture of Experts (MoE). Il promet d’exécuter des modèles massifs jusqu’à 3 fois plus vite qu’Ollama sur des GPU grand public, en optimisant le chargement et le cache. Pour les hobbyistes qui veulent faire tourner des modèles de type MoE (comme DeepSeek-V4-Flash, 284 milliards de paramètres au total mais seulement ~13 milliards activés par token), c’est une piste sérieuse — à condition de vérifier les chiffres par soi-même, l’annonce n’ayant pas encore été répliquée indépendamment.
- DSpark (publié le 27 juin 2026 par DeepSeek et l’université de Pékin, avec Liang Wenfeng parmi les auteurs) : un framework d’accélération par décodage spéculatif semi-autorégressif. En production réelle sur DeepSeek-V4, il améliore la vitesse de génération de 60 à 85 % (57 à 78 % sur V4-Pro). Le code d’entraînement, DeepSpec, est sous licence MIT. DSpark est compatible avec la quantification et les modèles MoE, ce qui en fait un complément intéressant pour l’inférence locale. Attention toutefois : DSpark n’est pas un modèle, c’est un framework, et les gains annoncés ont été mesurés sur l’infrastructure de DeepSeek, pas sur une RTX 3090 de salon.
- Strata (évoqué le 5 octobre 2026) : un moteur qui revendique de faire tourner un Qwen 125B sur une carte graphique ordinaire, au cœur d’un débat sur r/LocalLLaMA autour des « moteurs d’inférence sur-entraînés ». À suivre, mais prudence : aucune validation indépendante solide à ce stade.
Quant à LM Studio, il n’est pas mentionné dans la source TechTimes. Cet outil, très populaire pour l’IA locale sur Windows, repose sur llama.cpp et fonctionne nativement sous Windows. Il n’aura probablement pas besoin de WSL 3, mais les utilisateurs qui préfèrent l’écosystème Linux (Ollama, scripts Python, etc.) y trouveront un intérêt. En l’état, la compatibilité logicielle de WSL 3 reste à démontrer.
Optimiser son budget : quantification, KV cache, offloading
Au-delà de WSL 3, les stratégies pour faire tourner des LLM sans se ruiner n’ont pas changé, mais elles se sont affinées. La quantification reste le premier levier : un GGUF en Q4_K_M offre le meilleur compromis taille/qualité pour la majorité des usages, et le format GGUF lui-même est désormais bien documenté (contenu, quantification à choisir, tailles de fichiers, exécution sur Windows, macOS et Linux). Un guide complet publié le 18 septembre 2026 sur Brief IA détaille d’ailleurs les budgets et performances réalistes pour des LLM jusqu’à 70B — utile pour se faire une idée avant d’acheter.
Le deuxième levier, souvent négligé, est le KV cache. C’est lui qui décide vraiment de ce que votre machine peut faire tourner : un 70B peut tenir en VRAM et refuser net dès que le contexte dépasse quelques milliers de tokens. En 2026, les techniques réellement déployables — compression du cache, gestion par blocs (memory pool vs buffer contigu), et surtout l’offloading du KV cache sur NVMe — changent la donne pour les configurations modestes. C’est probablement le levier le plus sous-estimé, bien avant le choix du runtime.
Troisième levier : l’offloading partiel et les solutions extrêmes. AirLLM (dépôt lyogavin/AirLLM, « AirLLM 70B inference with single 4GB GPU ») promet de faire tourner un 70B sur 4 Go de VRAM en échange d’une latence très dégradée. Ce n’est pas confortable, mais c’est une voie de secours pour tester un gros modèle sans changer de machine. À l’inverse, les iGPU comme la Radeon 780M plafonnent autour de 8-12 tok/s sur du 7B en Vulkan (avec un gain d’environ +50 % obtenu via les optimisations Vulkan de llama.cpp et +12,9 % via le réglage MMVQ) : suffisant pour du chat, pas pour du travail intensif.
Enfin, un rappel qui n’a rien de technique mais pèse lourd dans le budget réel : la sécurité. Un serveur Ollama exposé sur le port 11434 sans pare-feu, des GGUF téléchargés sans vérification, un RAG empoisonné — autant de coûts cachés (données, temps, parfois argent) qui peuvent ruiner l’économie d’un setup auto-hébergé. Le guide sécurité de notre magazine détaille les bonnes pratiques : sandbox, pare-feu, chiffrement, vérification des poids avant chargement.
Faut-il attendre WSL 3 ou passer à Windows ML dès maintenant ?
La réponse pragmatique, en cette fin octobre 2026, tient en trois points.

Pour un débutant ou un utilisateur « confort » : n’attendez pas WSL 3. Windows ML, avec son support expérimental de llama.cpp pour GGUF et son API locale compatible OpenAI, couvre déjà l’essentiel des besoins sur Windows 11 26H2. Vous installez, vous chargez un GGUF, vous interrogez l’API. Pas de dual-boot, pas de VM, pas de shim à comprendre.
Pour un utilisateur avancé qui vit dans l’écosystème Linux (scripts Python, CUDA, vLLM, outils de recherche) : WSL 2 reste fonctionnel, et WSL 3 est une promesse séduisante mais non mesurée. Si vous avez déjà un dual-boot qui vous satisfait, rien ne presse. Si vous êtes sur une machine récente Snapdragon X Elite ou Intel Lunar Lake et que vous voulez tester l’aperçu, faites-le sur une partition ou une VM de test — pas sur votre installation de production.
Pour un budget serré : le meilleur rapport performance/prix reste une carte NVIDIA d’occasion ou une RTX 4060/4070 avec un modèle 7-13B quantifié, sous Windows ML ou LM Studio. Les mini-PC à mémoire unifiée (Ryzen AI Halo à 3 999 $, Gorgon Halo à 192 Go) sont fascinants mais hors budget pour la plupart ; ils intéressent ceux qui veulent du 120B+ sans datacenter, pas ceux qui cherchent à faire tourner un 8B.
WSL 3, s’il tient ses promesses, simplifiera la vie de ceux qui veulent le meilleur des deux mondes. Mais tant qu’aucun benchmark indépendant n’aura été publié, il faut le traiter pour ce qu’il est : un aperçu, pas une solution. Et garder en tête que la vraie question, en 2026, n’est plus « Windows ou Linux ? » mais « quel runtime pour quel modèle sur quel matériel, à quel coût total ? ».
Sources
- WSL 3 at Build 2026: Near-Native GPU and NPU Passthrough Brings Local AI to Windows — TechTimes, 2 juin 2026
- Microsoft dévoile WSL 3 et les conteneurs WSL pour Windows — IT-Connect
- Installer WSL et Install WSL — Microsoft Learn
- microsoft/WSL et microsoft/WSL2-Linux-Kernel — GitHub
- WSL 3 GPU Passthrough for Local AI on Windows in 2026: Near-Native… — RunAIHome
- AI Development on Windows: from PyTorch and llama.cpp to Windows ML — Microsoft Foundry on Windows Blog, 7 octobre 2026
- Windows ML: 2026 Updates for GGUF Models and Local AI — Techgenyz, 9 octobre 2026
- llama.cpp v0.5.0 in 2026: What Changed, How to Install, Run GGUF & Use the Local API — 27 septembre 2026
- Faire tourner une IA en local en 2026 : guide complet — Brief IA, 18 septembre 2026
- Modèles GGUF : types de quantification et exécution — 9 septembre 2026
- Performance LLM sur GPU AMD Radeon 9070XT — 25 septembre 2026
- DeepSeek dévoile DSpark, son framework qui accélère les grands modèles de langage de 60 à 85 % — Roboactu, 27 juin 2026
- Intégration API IA : DSpark de DeepSeek — 1er septembre 2026
- Почему все говорят о Strata: эпоха переобученных движков — 5 octobre 2026
- Dossiers internes du magazine : « DSpark de DeepSeek : le décodage spéculatif qui accélère l’inférence locale de 60 à 85 % », « Faire tourner des LLM open source chez soi sans se ruiner : le guide sécurité et coûts réels (édition 2026) », « llm-d 1.0 et DeepInfer : la bataille de l’inférence distribuée arrive (enfin) chez vous », « Windows ML en 2026 : l’OS veut devenir votre runtime LLM », « Kimi K3 en open source : 2,8 billions de paramètres qui rebattent les cartes de l’IA locale », « Le KV cache en 2026 : le gouffre mémoire qui décide de ce que votre machine peut vraiment faire tourner ».
Article recherché et rédigé automatiquement · Magazine Electrosens