
 Magazine LLM Opensource · 31 August 2026
RL post-training : la convergence forcée de l’infrastructure open source
Le post-entraînement par renforcement s’est imposé en deux ans comme l’étape décisive de la vie des modèles ouverts. Au Ray Summit 2026, l’infrastructure qui le rend possible a cessé d’être un assemblage de bricolage pour devenir un système intégré — et c’est toute la stack open source qui se recompose autour de cette contrainte.
The RL Revolution: Why Post-Training Became the New Battleground
Il y a encore trois ans, la course aux LLM open source se jouait au pré-entraînement : qui lèverait le plus de capitaux, empilerait le plus de GPU, avalerait le plus de tokens. Cette époque est révolue. Le basculement s’est opéré discrètement, puis brutalement, avec la publication de modèles de raisonnement qui ont prouvé que la qualité finale d’un modèle se joue désormais presque entièrement dans sa phase de post-entraînement.
Le signal le plus éclatant est venu de Z.ai avec GLM-5.3, sorti le 14 août 2026. Le laboratoire pékinois a publié une version de son modèle avec zéro nouveau paramètre : il réutilise la base Mixture-of-Experts de 743 milliards de paramètres de GLM-5.2, et n’a travaillé que sur le post-entraînement. Les résultats parlent d’eux-mêmes : Terminal-Bench 3.0 passe de 4,6 % à 28,3 % — un gain de 23,7 points obtenu sans toucher à l’architecture. CyberGym, le benchmark de cybersécurité, est conquis à 84,5 %, devant Claude Sonnet 5 et GPT-5.6 Sol. DeepSWE atteint 66,9. Tout cela par le seul post-entraînement.
Ce cas n’est pas isolé. Il cristallise une tendance que les équipes d’infrastructure observent depuis 2025 : le pré-entraînement produit des modèles de base de plus en plus interchangeables, et la différenciation se joue dans l’alignement, le raisonnement, l’agenticité — tout ce qui relève du renforcement. Les publications OpenAI sur les modèles de raisonnement ont montré la voie ; DeepSeek-R1 a démontré qu’on pouvait la suivre en open source ; et désormais, chaque release majeure — de Muse Glimmer chez Meta (30B, Apache 2.0, publié le 11 août 2026) à DeepSeek V4 Pro (sorti le 12 août 2026) — met en avant son post-entraînement comme argument principal.
Le Ray Summit 2026, qui s’est tenu du 24 au 26 août au San Francisco Marriott Marquis avec plus de 3 000 participants confirmés, a acté cette bascule. Plus qu’une conférence technique, c’était une déclaration : le post-entraînement par renforcement n’est plus un sujet de recherche, c’est un problème d’ingénierie système — et toute l’industrie open source s’organise autour de cette réalité.
When Inference Meets Training: The System Engineering Crisis
Pour comprendre pourquoi le RL post-training bouleverse l’infrastructure, il faut saisir ce qui le distingue radicalement du pré-entraînement classique. Dans un pipeline traditionnel, l’entraînement et l’inférence sont deux mondes séparés : on entraîne un modèle sur des clusters dédiés, on le déploie ensuite sur des serveurs d’inférence. Le RL post-training mélange les deux en permanence, dans une boucle serrée.
Le cycle est le suivant : le modèle génère des rollouts (des séquences de raisonnement ou d’action), un récompenseur évalue ces sorties, puis la politique du modèle est mise à jour par un algorithme de renforcement comme GRPO ou PPO. Chaque itération exige que l’inférence et l’entraînement tournent simultanément, en équilibre. Bryan Catanzaro, VP Applied Deep Learning Research chez NVIDIA, l’a formulé sans détour dans son keynote : si l’inférence s’arrête, l’utilisation GPU chute ; si elle va trop vite, la politique devient obsolète avant d’avoir pu apprendre de ses propres rollouts.
Ce n’est pas un problème de performance pure, c’est un problème de coordination temps réel entre CPU et GPU. La génération de rollouts est fondamentalement différente de l’inférence de production : elle exige un échantillonnage stochastique, des séquences longues, des récompenses calculées à la volée. Les moteurs d’inférence classiques, optimisés pour la latence et le throughput en mode serving, ne sont pas conçus pour ce régime. Les frameworks d’entraînement, eux, ne savent pas gérer la génération de données en continu.
Le résultat est une crise d’ingénierie système : les équipes qui veulent faire du RL post-training sérieux se retrouvent à câbler ensemble des outils qui n’ont pas été pensés pour fonctionner en boucle fermée. C’est exactement le problème que le Ray Summit 2026 a mis au centre des débats — et que l’industrie open source est en train de résoudre par la convergence.
The Convergence of Stacks: Ray, vLLM, SGLang and the New Orchestration
Le signe le plus tangible de cette convergence est organisationnel : la conférence vLLM d’Inferact s’est tenue en parallèle du Ray Summit 2026, sous le même toit, avec un pass unique pour les deux événements. Ce n’est pas un détail logistique — c’est la reconnaissance que les communautés de l’inférence et de l’orchestration parlent désormais le même langage, parce qu’elles résolvent le même problème.
Dans cette stack unifiée, chaque outil a un rôle complémentaire. Ray est le framework d’orchestration distribué, créé à UC Berkeley en 2016 sous la direction d’Ion Stoica (également co-créateur d’Apache Spark et de SkyPilot). Il coordonne les workloads : génération de données, inférence, mise à jour des poids. C’est la couche qui décide quoi tourner où, quand, et avec quelles ressources. Ses déploiements de production incluent l’infrastructure d’entraînement de modèles d’OpenAI et le LLM interne Hendrix de Spotify — un pedigree qui rassure les équipes en production.
vLLM est le moteur d’inférence, développé à l’origine au Sky Computing Lab de UC Berkeley, avec plus de 2 000 contributeurs. Il apporte les mécanismes techniques qui rendent la génération de rollouts viable : PagedAttention pour la gestion de la KV cache, continuous batching pour maximiser l’utilisation GPU, chunked prefill, prefix caching, quantification (FP8, INT8), décodage spéculatif, et parallélisme tensor/pipeline/data/expert/context. C’est la brique qui transforme l’inférence en service fiable et rapide.
SGLang, de son côté, se positionne comme un moteur d’inférence optimisé pour les workloads de génération structurée et de raisonnement. Moins documenté dans les sources disponibles, il est régulièrement cité aux côtés de vLLM dans les comparatifs d’optimisation d’inférence, et son écosystème (notamment via Baseten et NVIDIA Dynamo) en fait un acteur sérieux du paysage.
La convergence ne signifie pas fusion, mais interopérabilité. Ray orchestre, vLLM ou SGLang exécutent, et les interfaces entre les deux se standardisent. Les sessions du Ray Summit consacrées au "LLM Post-Training and High-Performance Serving" avec SkyRL, à l’agentic RL et à vLLM montrent que cette intégration est devenue le sujet central — plus personne ne discute de savoir s’il faut orchestrer, mais comment.
| Outil | Rôle principal | Origine | Points forts documentés |
|---|---|---|---|
| Ray | Orchestration distribuée | UC Berkeley (2016), Ion Stoica | Coordination CPU/GPU, workloads mixtes, production chez OpenAI et Spotify |
| vLLM | Moteur d’inférence | UC Berkeley, 2000+ contributeurs | PagedAttention, continuous batching, parallélisme multi-formes, quantification |
| SGLang | Moteur d’inférence | Communauté open source | Génération structurée, intégration écosystème (Baseten, NVIDIA Dynamo) |
Benchmarks and Metrics: The Missing Yardstick
Si la convergence technique progresse, un angle mort persiste : l’absence de benchmarks standardisés pour comparer les stacks de RL post-training. Les métriques classiques de l’inférence — throughput en tokens/s, latence, coût par requête — ne capturent pas ce qui compte vraiment dans une boucle de renforcement.
Prenons un exemple concret. Une stack qui génère des rollouts 20 % plus vite peut sembler supérieure, mais si elle le fait au prix d’une utilisation GPU irrégulière (pics et creux), le coût réel en GPU-hours explose. Inversement, une stack plus lente mais parfaitement équilibrée entre inférence et entraînement peut produire plus d’itérations utiles par heure. Les métriques d’inférence classiques ne mesurent pas l’équilibre — elles mesurent la vitesse d’un seul composant.
Le taux d’utilisation GPU est un meilleur indicateur, mais il reste partiel. Il ne dit rien de la qualité des rollouts générés, ni de la stabilité de l’entraînement. Or, dans le RL post-training, la qualité des données générées est aussi importante que la vitesse de génération. Un rollout médiocre qui fait régresser la politique coûte plus cher qu’un rollout lent mais bon.
Les équipes qui déploient ces stacks en production se retrouvent donc à inventer leurs propres métriques : nombre d’itérations RL par heure, stabilité de la loss, taux de rejet des rollouts, coût total par point de benchmark gagné. C’est un terrain de jeu ouvert, et les acteurs qui proposeront des repères fiables — qu’il s’agisse de benchmarks académiques ou de suites de tests industrielles — prendront un avantage décisif. En attendant, la prudence s’impose : comparer deux stacks sur un seul chiffre de throughput, c’est comparer deux voitures sur la seule puissance du moteur sans regarder la consommation, la tenue de route ou la fiabilité.
Architectural Trade-offs: Orchestration vs Inference Engines
Le choix d’une stack de RL post-training se résume souvent à une question : où placer la frontière entre orchestration et inférence ? Ray et vLLM/SGLang incarnent deux philosophies différentes, et le compromis est rarement évident.
Ray est un framework d’orchestration généraliste, Python-native, conçu pour coordonner des workloads distribués hétérogènes. Sa force est la flexibilité : il peut gérer des pipelines complexes, des dépendances entre tâches, des reprises après échec, et s’adapter à des topologies changeantes. Sa faiblesse est la latence : la couche d’orchestration ajoute une surcharge qui peut devenir pénalisante dans des boucles RL à haute fréquence, où chaque milliseconde compte.
vLLM et SGLang sont des moteurs d’inférence spécialisés, optimisés pour une seule chose : exécuter des modèles de langage le plus efficacement possible. Leur force est la performance brute : continuous batching, gestion fine de la KV cache, parallélisme optimisé. Leur faiblesse est leur périmètre : ils ne savent pas orchestrer, et leur tolérance aux pannes est limitée à leur propre domaine.
Dans la pratique, les équipes qui choisissent une stack "tout-Ray" privilégient la scalabilité et la robustesse : elles acceptent une surcharge d’orchestration en échange d’une capacité à gérer des workloads massifs et hétérogènes. Celles qui choisissent une stack "vLLM-centrée" privilégient la performance brute et la simplicité : elles acceptent une orchestration plus rudimentaire en échange d’une latence minimale.
Il n’y a pas de bonne réponse universelle — il y a des compromis. Une équipe qui fait du RL sur des modèles de 7B à 13B, avec des rollouts courts, peut se contenter d’une stack simple. Une équipe qui travaille sur des modèles de 70B ou plus, avec des rollouts longs et des récompenses complexes, aura besoin d’une orchestration robuste. Le Ray Summit 2026 a montré que l’industrie converge vers une intégration étroite des deux couches, mais la frontière exacte reste un choix d’architecture — et donc une décision politique interne à chaque équipe.
Inside the Ray Summit 2026: Key Sessions and Announcements
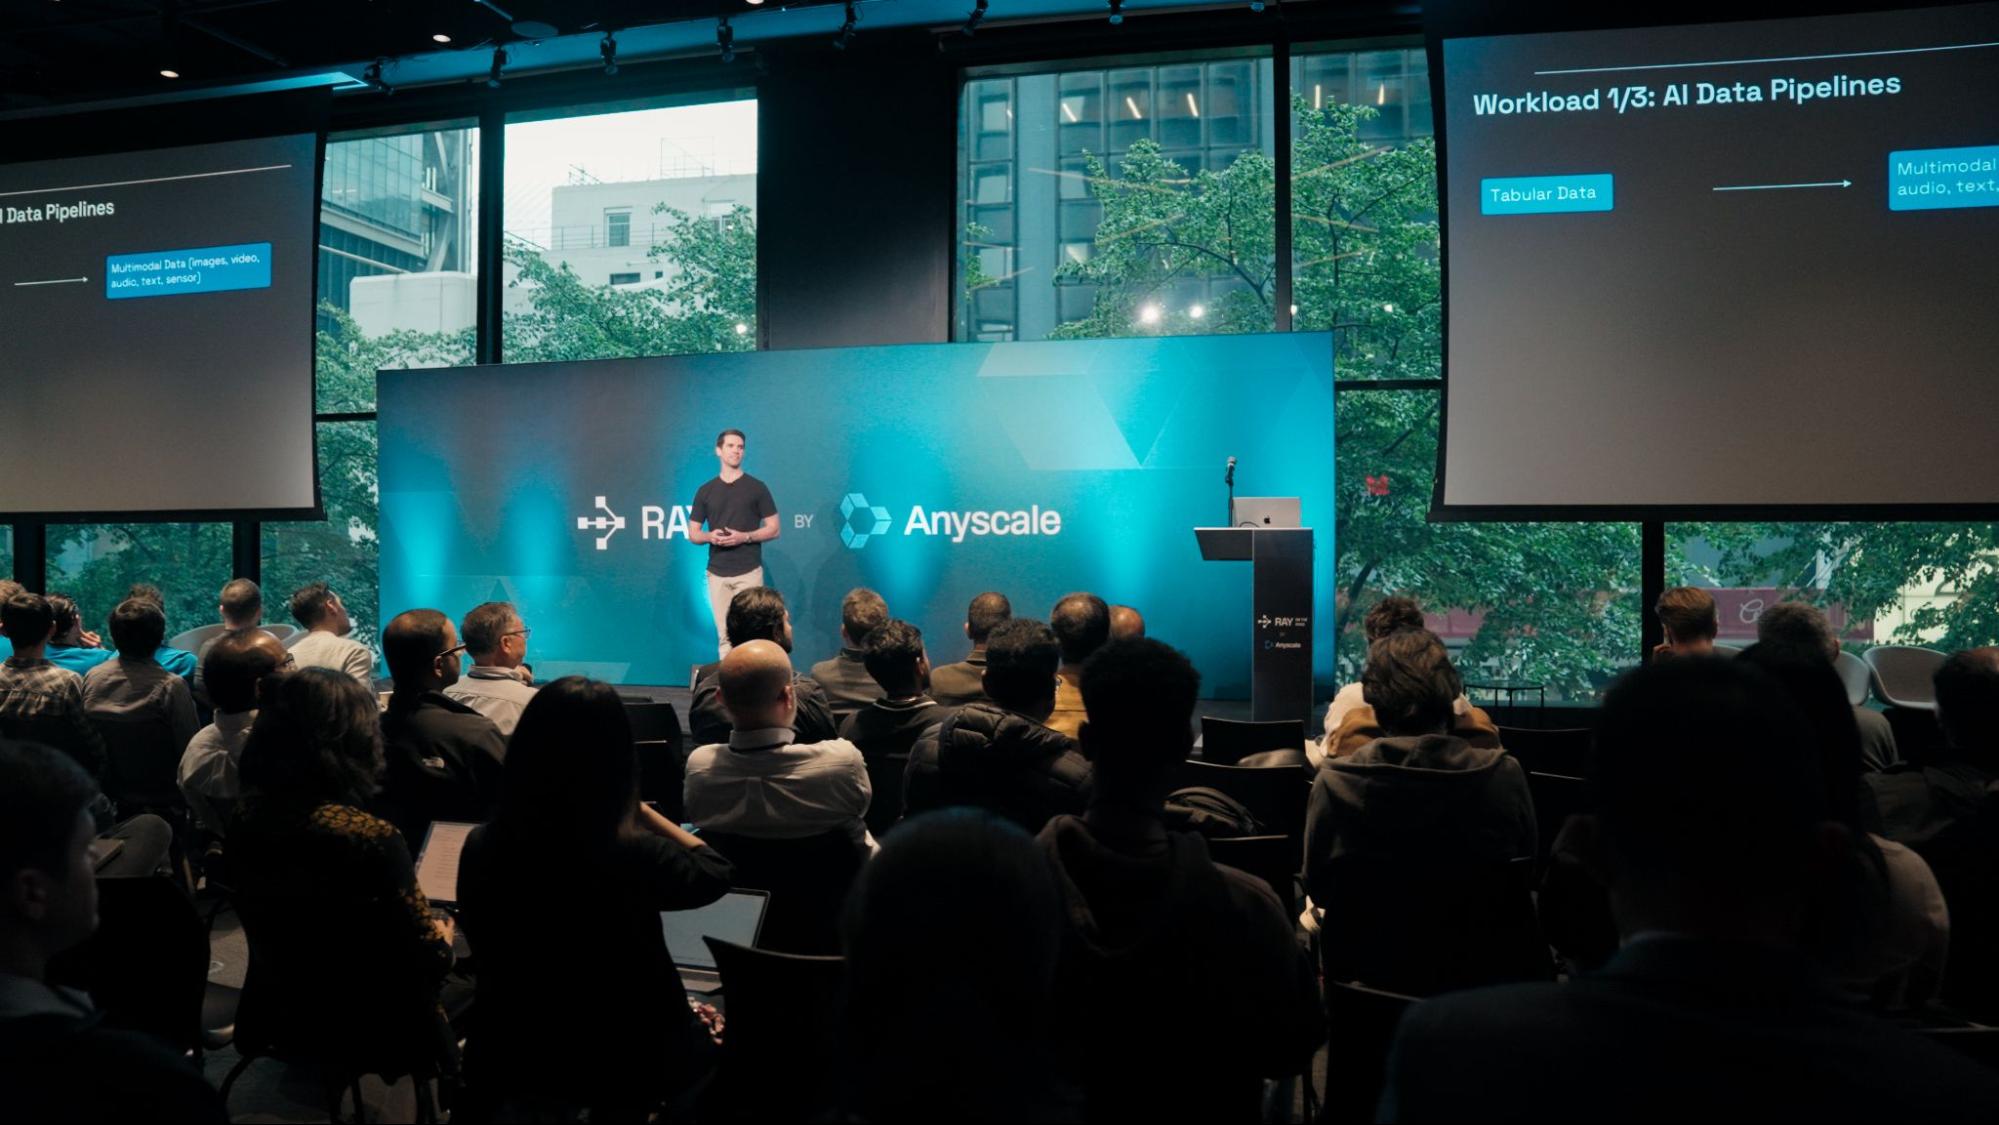
Le programme du Ray Summit 2026 dessine clairement les priorités de l’industrie. Le keynote de Bryan Catanzaro (NVIDIA) sur le post-training de modèles open source avec Nemotron a posé le cadre : le RL post-training est un défi d’ingénierie système, pas un problème de recherche. Cette formulation, venant du VP Applied Deep Learning Research de NVIDIA, a valeur de signal : le plus grand fabricant de GPU du monde considère que le goulot d’étranglement n’est plus la puissance de calcul, mais la coordination des workloads.
Les sessions consacrées à SkyRL et à l’agentic RL confirment l’orientation. SkyRL, framework de RL post-training, était au centre d’une session intitulée "LLM Post-Training and High-Performance Serving" — le titre lui-même résume la convergence : le post-entraînement et le serving ne sont plus des sujets séparés. L’agentic RL, qui étend le renforcement aux agents autonomes (navigation, utilisation d’outils, raisonnement multi-étapes), pousse encore plus loin les exigences d’infrastructure : les rollouts deviennent des épisodes entiers, avec des durées variables et des dépendances externes.
Une session NVIDIA portait sur la collaboration full-stack pour améliorer les performances de DeepSeek et MiniMax. C’est un signal fort : les grands laboratoires chinois, qui dominent les classements open source (15 modèles chinois dans le top 20 du classement Artificial Analysis en août 2025), travaillent désormais main dans la main avec les fournisseurs d’infrastructure américains. La convergence n’est pas seulement technique — elle est géopolitique.
Enfin, la co-localisation avec la conférence vLLM d’Inferact, avec un pass unique, a offert aux participants un panorama complet de la stack : orchestration d’un côté, inférence de l’autre, et la certitude que les deux communautés avancent désormais au même rythme.
Choosing Your Stack: Practical Guidance for Production Teams
Pour une équipe qui déploie des LLM en production et envisage le RL post-training, le choix de la stack se joue sur quatre critères : la taille des modèles, la fréquence des mises à jour, les besoins de scalabilité, et le compromis entre simplicité d’intégration et performance brute.
Petits modèles (7B-13B), rollouts courts, itérations fréquentes. Une stack légère suffit : vLLM pour l’inférence, un framework d’orchestration minimal (ou même une boucle Python simple) pour la coordination. La latence d’orchestration est négligeable à cette échelle, et la simplicité d’intégration prime. C’est le cas typique des équipes qui font de l’alignement domaine-spécifique sur des modèles de taille moyenne.
Modèles moyens (30B-70B), rollouts longs, récompenses complexes. L’orchestration devient nécessaire. Ray apporte la robustesse et la scalabilité, vLLM ou SGLang fournissent l’inférence optimisée. C’est le régime où la convergence Ray-vLLM montre sa valeur : la coordination CPU/GPU devient critique, et les reprises après échec sont indispensables. Les équipes qui travaillent sur des agents de codage ou du raisonnement mathématique se situent typiquement ici.
Très grands modèles (100B+), workloads massifs. La stack complète s’impose : Ray pour l’orchestration distribuée à grande échelle, vLLM avec parallélisme multi-formes (tensor, pipeline, data, expert, context) pour l’inférence, et une attention particulière à la gestion de la KV cache et à la quantification. C’est le domaine des laboratoires et des grandes entreprises, où le coût en GPU-hours se compte en millions de dollars et où chaque point de pourcentage d’utilisation GPU compte.
Cas particulier : modèles agentiques. Le RL agentique (comme celui qui a produit Muse Glimmer chez Meta) exige une orchestration encore plus fine : les rollouts sont des épisodes entiers, avec des durées variables et des interactions avec des outils externes. La stack doit gérer l’asynchronisme, les timeouts, et la reprise après échec d’épisodes entiers. Ray, avec sa gestion des tâches distribuées, est souvent le choix naturel.
| Critère | Stack légère | Stack complète |
|---|---|---|
| Taille des modèles | 7B-13B | 70B+ |
| Rollouts | Courts, fréquents | Longs, complexes |
| Orchestration | Minimale | Ray complet |
| Inférence | vLLM seul | vLLM + parallélisme multi-formes |
| Priorité | Simplicité | Robustesse et scalabilité |
The Road Ahead: What’s Next for RL Post-Training Infrastructure
La convergence observée au Ray Summit 2026 n’est pas un aboutissement — c’est une étape. Trois tendances se dessinent pour les mois à venir.
La standardisation des interfaces. Aujourd’hui, chaque stack est un assemblage sur mesure. Demain, les interfaces entre orchestration et inférence se normaliseront : des protocoles communs pour la génération de rollouts, le calcul de récompenses, et la synchronisation des poids. Les frameworks spécialisés (SkyRL, OpenRLHF, TRL) joueront un rôle clé dans cette standardisation, en proposant des couches d’abstraction qui masquent la complexité sous-jacente.
La montée en puissance des frameworks spécialisés. Le RL post-training est devenu trop important pour être laissé aux généralistes. Des frameworks dédiés émergent, qui intègrent nativement l’orchestration, l’inférence et l’entraînement dans une boucle optimisée. Leur succès dépendra de leur capacité à offrir des performances comparables aux stacks bricolées, avec une simplicité d’utilisation nettement supérieure.
Le rôle croissant de l’open source dans la souveraineté technologique. Le débat sur l’autonomie stratégique européenne, alimenté par des analyses comme celles de The Conversation, trouve un écho direct dans l’infrastructure RL. Les modèles open source rattrapent la frontière avec environ un an de retard et tournent sur du matériel grand public — mais leur post-entraînement exige des clusters GPU que peu d’acteurs possèdent. La démocratisation du RL post-training passe par des outils open source qui optimisent l’utilisation des ressources existantes, plutôt que par l’accumulation de puissance brute.
Les défis restent nombreux : l’absence de benchmarks standardisés, la complexité de la coordination CPU/GPU, la rareté des ingénieurs capables de câbler ces stacks. Mais le Ray Summit 2026 a montré une chose : l’industrie open source a cessé de subir la complexité du RL post-training pour l’organiser. La convergence est en marche — et elle est forcée, parce qu’il n’y a pas d’alternative.
Sources
- TechTimes, "Ray Summit 2026: RL post-training forces open-source AI infrastructure to converge", 25 août 2026 — https://www.techtimes.com/articles/325476/20260825/ray-summit-2026-rl-post-training-forces-open-source-ai-infrastructure-converge.htm
- Gist GitHub (recommandations de sessions Ray Summit 2026) — https://gist.github.com/arkadyark-cohere/cc6bb12dd42380c06739935491de341e
- Dépôt officiel vLLM — https://github.com/vllm-project/vllm
- The Conversation, "L’IA open source et frugale, la clé de l’autonomie stratégique européenne" — https://theconversation.com/lia-open-source-et-frugale-la-cle-de-lautonomie-strategique-europeenne-259748
- The Conversation, "Abondance, rareté, open source : et si le débat sur l’IA se trompait d’étage ?" — https://theconversation.com/abondance-rarete-open-source-et-si-le-debat-sur-lia-se-trompait-detage-285977
- The Agent Report, "GLM-5.3: Z.ai Tops the Open Coding Leaderboard on Post-Training Alone", 14 août 2026 — https://the-agent-report.com
- DataNorth, "Z.ai releases GLM-5.3 for coding and cyber work", 17 août 2026 — https://datanorth.ai
- Spheron Blog, "LLM Inference Optimization: vLLM vs TensorRT-LLM vs SGLang Decision Framework (2026)" — https://spheron.network
Article recherché et rédigé automatiquement · Magazine Electrosens