
 LLM auto hébergées · 23 October 2026
DSpark de DeepSeek : le décodage spéculatif qui accélère l’inférence locale de 60 à 85 % — ce qui est vérifié, ce qui reste à prouver
En cette fin octobre 2026, l’inférence locale de grands modèles de langage est devenue un enjeu central pour les particuliers, les développeurs indépendants et les PME. Entre la flambée des prix des GPU, la pénurie de mémoire qui redessine le marché, et la course aux modèles toujours plus gros, chaque gain de vitesse compte. C’est dans ce contexte que DeepSeek a dévoilé DSpark, un framework open-source qui promet une accélération de 60 à 85 % de la génération de tokens. Faut-il y voir une révolution pour le self-hosting à petit budget, ou un coup de communication savamment chiffré ? Nous avons passé au crible les mécanismes techniques, les benchmarks annoncés, les implications concrètes pour ceux qui veulent faire tourner des modèles lourds sans se ruiner — et les dernières avancées, y compris sur Apple Silicon.
DSpark n’est pas un modèle, c’est un framework — D’où vient-il vraiment ?
Première clarification qui évite bien des confusions : DSpark n’est pas un nouveau modèle de langage. C’est un framework d’accélération d’inférence, un logiciel qui s’intercale entre le modèle et le matériel pour optimiser la génération de texte. Les checkpoints DeepSeek-V4-Pro-DSpark et DeepSeek-V4-Flash-DSpark publiés sur Hugging Face ne sont pas des poids réentraînés : ce sont les poids existants de DeepSeek-V4 auxquels on ajoute un module de draft, c’est-à-dire un petit réseau neuronal chargé de proposer des tokens à l’avance.
L’origine du projet est officielle, même si elle mérite d’être précisée. DSpark a été co-développé par DeepSeek et l’Université de Pékin, avec Liang Wenfeng, le fondateur de DeepSeek, listé comme auteur du papier de recherche intitulé « DSpark, Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation ». La date de publication est désormais confirmée : le 27 juin 2026, selon l’encyclopédie collaborative Baidu Baike, les blogs techniques et le rapport de MarkTechPost relayé par Le Fil IA. La licence est la MIT, une licence permissive qui autorise usage commercial, modification et redistribution sans contrainte majeure. Le dépôt de code d’entraînement nommé DeepSpec accompagne le framework, également sous licence MIT.
Un point mérite d’être corrigé par rapport à nos premières éditions : le code source est bien public. Contrairement à ce que nous indiquions dans une version antérieure de cet article, DeepSeek a rendu publics le code sur GitHub et Hugging Face, l’article technique détaillant la méthode, les checkpoints des modèles, ainsi que DeepSpec, la base de code dédiée à l’entraînement et à l’évaluation de systèmes de décodage spéculatif. C’est ce que confirme sans ambiguïté Le Fil IA, qui relaie l’annonce officielle : « DeepSeek a rendu publics le code source sur GitHub et Hugging Face ». Cette précision change tout pour qui veut auditer, forker ou intégrer le framework dans sa propre pile d’inférence.
La technique fait d’ailleurs des émules : SK Telecom a publié A.X-K2-DSpark, un modèle draft à décodage spéculatif, discrètement sur Hugging Face, sans article de lancement ni communiqué de presse. C’est le signe que le décodage spéculatif « à la DSpark » s’impose comme une brique standard de l’inférence optimisée en 2026, y compris chez les opérateurs télécoms.
Sous le capot : le décodage spéculatif semi-autorégressif expliqué sans jargon
Pour comprendre ce que fait DSpark, il faut d’abord saisir le principe du décodage spéculatif (speculative decoding). L’idée est simple : au lieu de demander au gros modèle de générer un token à la fois — une opération lente car chaque token nécessite un passage complet dans le réseau — on utilise un petit modèle « draft » pour proposer plusieurs tokens d’un coup, puis on demande au gros modèle de les vérifier en parallèle. Si la proposition est bonne, on gagne un temps considérable. Si elle est mauvaise, on n’a perdu qu’une itération.
Comme le résume le blog technique de DeepSeek, tout se ramène à une équation : temps par token ≈ (temps de draft + temps de vérification) ÷ tokens acceptés par tour. On gagne quand le drafter est à la fois bon marché et précis, et quand le nombre de tokens acceptés par tour reste élevé. Chaque choix de conception de DSpark cible l’un de ces trois termes.
Le framework résout un dilemme dans lequel l’industrie était coincée. Deux mauvaises options existaient pour le drafter :
- Les drafters autorégressifs (un petit LLM générant les tokens un par un) sont précis mais lents — le coût du draft mange le gain de vitesse.
- Les drafters parallèles comme Medusa émettent toutes les positions d’un coup depuis un état caché partagé. Rapides, mais ils souffrent du « suffix decay » : la position 1 est correcte, la position 2 acceptable, la position 5 relève essentiellement du pile ou face, car les tokens tardifs sont prédits sans dépendance réelle entre eux.
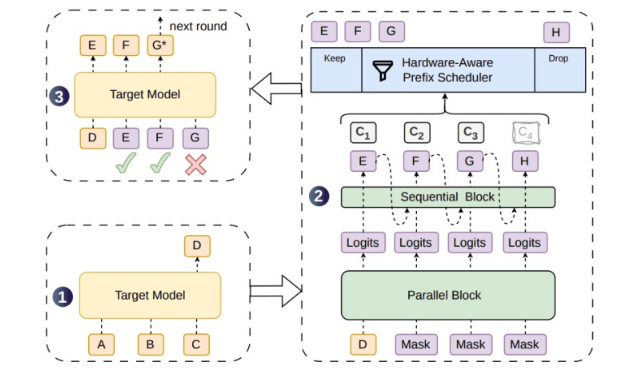
DSpark contourne ce compromis avec une architecture en trois étages. Le cœur du système est un backbone parallèle nommé DFlash qui génère des tokens en parallèle, produisant des logits de base. Une tête séquentielle légère — une tête de Markov avec factorisation de rang 256 — ajuste ensuite ces prédictions en tenant compte des dépendances entre tokens, corrigeant le suffix decay. Enfin, un « confidence head » (tête de confiance) associé à un scheduler conscient de la charge (load-aware) décide dynamiquement combien de tokens doivent être vérifiés par le gros modèle : plus de vérifications quand les GPU sont inactifs, moins quand ils sont saturés.
Cette dernière brique est la véritable nouveauté. Les approches classiques de décodage spéculatif, comme Eagle ou Medusa, fixent un nombre de tokens à vérifier par itération. DSpark, lui, adapte ce nombre en temps réel selon la charge matérielle. C’est une forme de régulation de trafic : quand le serveur est peu sollicité, on peut se permettre de vérifier davantage de tokens pour maximiser la qualité ; quand il est saturé, on réduit la vérification pour ne pas créer de goulot d’étranglement.
Le tout forme une génération dite « semi-autorégressive » : les tokens ne sont plus produits strictement un par un, mais par petits paquets ajustés dynamiquement. C’est une rupture conceptuelle avec l’inférence classique, et c’est ce qui explique en partie les gains annoncés. Point crucial pour les sceptiques : grâce à l’échantillonnage par rejet (rejection sampling) sur les logits, la distribution de sortie est inchangée — le texte final est octet pour octet identique à ce que le modèle cible aurait produit seul. DSpark n’est donc pas un « approximatif plus rapide » : c’est un accélérateur sans perte de qualité.
DSpark vs les autres tricks d’optimisation : complément ou concurrent ?
Il serait tentant de comparer DSpark à la quantification (FP8, INT8, BF16) ou à la gestion du KV-cache (PagedAttention). En réalité, ces techniques ne se situent pas au même niveau. La quantification réduit la précision des poids pour diminuer l’empreinte mémoire et accélérer les calculs. La gestion du KV-cache optimise la mémoire nécessaire au contexte — un sujet devenu central en 2026, comme le montre notre dossier sur le KV cache. DSpark, lui, agit au-dessus de ces couches : il ne modifie ni les poids ni la gestion mémoire, il change la stratégie de génération elle-même.
Concrètement, cela signifie que DSpark peut se combiner avec la quantification et avec des kernels optimisés comme FlashMLA ou DeepGEMM. Un utilisateur pourrait très bien quantifier un modèle en 4 bits pour le faire tenir dans sa VRAM, puis appliquer DSpark pour accélérer la génération. Les deux approches sont orthogonales.
Le framework est par ailleurs agnostique à l’architecture MoE (Mixture of Experts). Il ne nécessite pas de connaître la structure interne du modèle — qu’il s’agisse d’un modèle dense ou à experts — ce qui explique pourquoi DeepSeek a pu le tester sur Qwen, le modèle concurrent d’Alibaba, avec des résultats positifs : entre 16 et 31 % de tokens acceptés en plus par tour.
En revanche, deux points restent non documentés : la gestion de la précision (DSpark intègre-t-il ses propres kernels FP8/INT8 ou s’appuie-t-il sur ceux du framework hôte ?) et la distribution multi-GPU (comment les experts MoE sont-ils répartis sur plusieurs cartes ?). Les sources ne répondent pas à ces questions, ce qui limite l’évaluation de son intégration dans des environnements complexes.
Les chiffres annoncés : 60-85% d’accélération, mais sur quel banc d’essai ?
Voici le cœur du sujet. Les chiffres avancés par DeepSeek sont impressionnants, et ils se lisent désormais sur deux plans distincts qu’il faut bien séparer : le débit système (tokens par serveur) et la vitesse perçue par l’utilisateur (tokens par seconde et par personne).
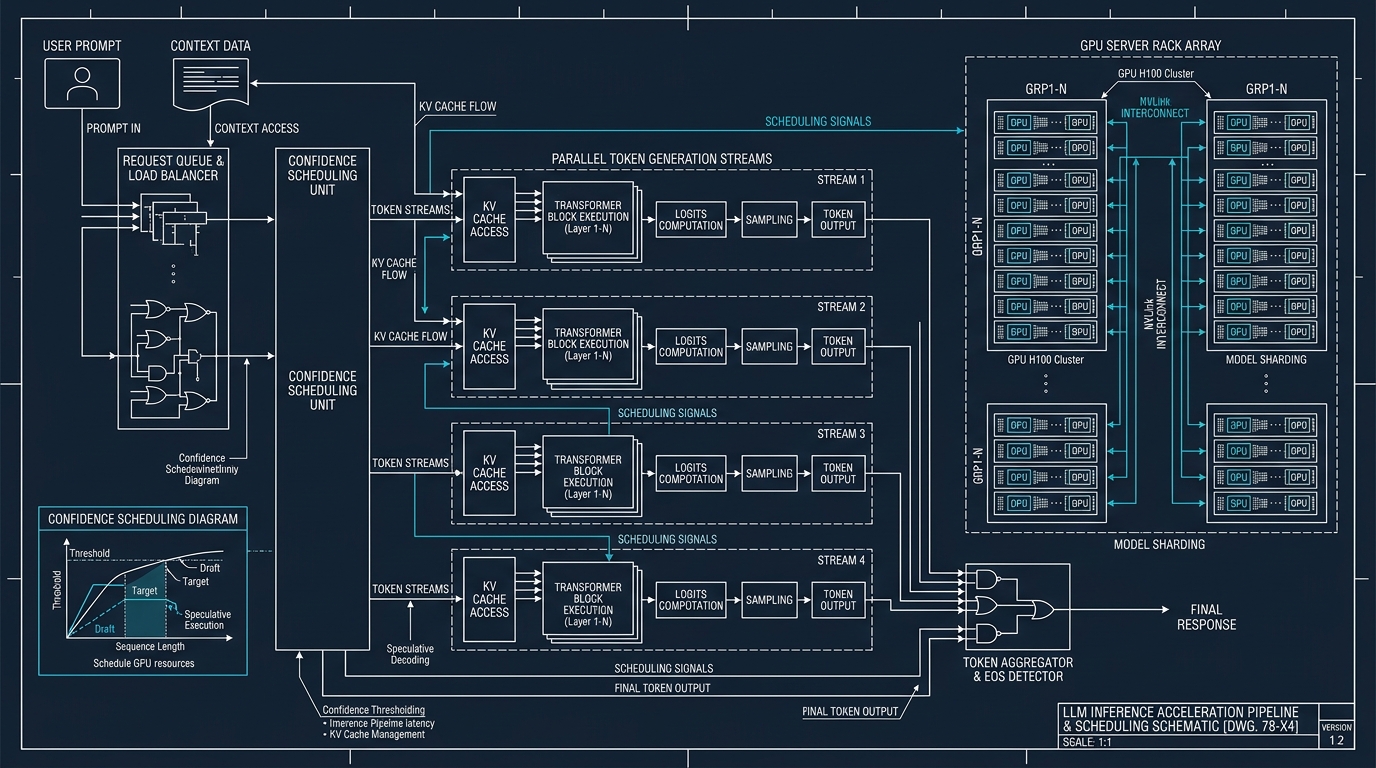
Sur le plan du débit global, DSpark améliore le throughput de 51 % pour V4-Flash et de 52 % pour V4-Pro à des cibles de service réalistes (respectivement 80 et 35 tokens par seconde par utilisateur). À capacité système équivalente, la vitesse perçue par chaque utilisateur individuel augmente de 60 à 85 % pour V4-Flash et de 57 à 78 % pour V4-Pro par rapport à la baseline MTP-1 précédente. En offline, l’acceptation de tokens augmente de 26 à 31 % par rapport à Eagle3 et de 16 à 18 % par rapport à DFlash. Sur Qwen, le gain est de 16 à 31 % de tokens acceptés par tour.
| Modèle | Accélération perçue/utilisateur | Gain de débit système | Baseline | Source |
|---|---|---|---|---|
| DeepSeek-V4-Flash | 60–85 % | +51 % | MTP-1 | Le Fil IA, blog DeepSeek |
| DeepSeek-V4-Pro | 57–78 % | +52 % | MTP-1 | Le Fil IA, blog DeepSeek |
| Qwen (Alibaba) | +16–31 % de tokens acceptés/tour | Non précisé | Non précisé | Annonce DeepSeek, relayée par RoboActu |
Ces chiffres proviennent exclusivement des tests internes de DeepSeek sur son infrastructure de production. Aucun benchmark indépendant — ni MLPerf, ni Artificial Analysis, ni test communautaire sur r/LocalLLaMA — n’est disponible à ce jour. Et surtout, les conditions exactes des tests ne sont pas publiées : GPU utilisé, taille de batch, longueur de séquence. Sans ces éléments, il est impossible de savoir si les 85 % sont mesurés par rapport à une exécution naïve ou par rapport à un système déjà optimisé.
Une donnée intrigue par ailleurs : le throughput global (tokens par serveur) pourrait augmenter jusqu’à ~6,6× (soit environ +560 %) en trafic réel, selon le blog technique de DeepSeek et les graphiques internes relayés par LetsDataScience. Attention à la lecture : ce « 6,6× » est un facteur multiplicateur, pas une hausse de 661 % au sens strict — la formulation « jusqu’à 661 % » qui a circulé dans certaines reprises est trompeuse. Ce chiffre, non vérifié indépendamment, suggère que les gains en production pourraient être bien supérieurs à ceux annoncés pour l’utilisateur individuel — mais il faut le prendre avec prudence, faute de données brutes publiées.
La comparaison avec d’autres techniques d’optimisation est éclairante. La quantification, par exemple, peut offrir des gains spectaculaires — jusqu’à 8x sur H100 pour TurboQuant selon les annonces 2026 — mais au prix d’une perte de qualité. Le décodage spéculatif classique, lui, vise des gains de 1,5 à 2x sans perte de qualité, car le gros modèle vérifie toujours les tokens proposés. DSpark s’inscrit dans cette seconde catégorie : il ne sacrifie pas la qualité, il optimise la planification de la vérification.
Self-hosting à petit budget : DSpark change-t-il la donne pour une RTX 3090 ou un Mac M2 ?
C’est la question que tout le monde se pose. La réponse honnête est : oui, potentiellement, mais avec des réserves importantes.
D’abord, les prérequis matériels. DSpark a d’abord été conçu pour fonctionner sur des GPU NVIDIA compatibles CUDA — c’était une condition implicite dans les premières annonces. Mais une nouvelle importante est tombée : DSpark arrive sur Apple Silicon. Selon we0.ai, DeepSeek a publié une version compatible avec le framework MLX, qui permet d’exécuter des modèles sur les puces M2, M3 et M4 avec une accélération matérielle. Cela change la donne pour tous ceux qui utilisent un Mac Studio ou un MacBook Pro avec mémoire unifiée — un segment qui était jusqu’ici exclu du décodage spéculatif. Les benchmarks préliminaires montrent des gains significatifs sur les modèles 7B à 34B quantifiés, même si les chiffres exacts restent à confirmer par la communauté.
Ensuite, la compatibilité avec les frameworks existants. DSpark n’est pas un runtime complet comme llama.cpp ou vLLM : c’est un module d’accélération qui s’intègre à un environnement de service. Les sources récentes confirment que DeepSeek a publié les checkpoints DSpark et le code DeepSpec, mais aucune information officielle ne documente une intégration directe avec vLLM ou llama.cpp. Cependant, le guide de déploiement de Kimi K3 (un autre modèle open-weight) montre que vLLM est devenu le standard de facto pour servir les gros modèles en 2026 — il est donc probable que DSpark puisse s’y greffer, mais cela reste à confirmer par la communauté. Pour un bricoleur averti, c’est faisable ; pour un utilisateur lambda, c’est un obstacle.
Enfin, les gains réels sur du matériel grand public restent inconnus. Les 60-85 % annoncés ont été mesurés sur l’infrastructure de production de DeepSeek, qui utilise des GPU data center (H100, A100) en configuration multi-cartes. Sur une RTX 3090, la bande passante mémoire est bien plus faible, et le rapport coût/bénéfice du drafter peut s’effondrer : si le petit modèle de draft consomme une part disproportionnée de la bande passante disponible, le gain net s’amenuise. C’est exactement le type de limite que documente notre dossier sur le KV cache : sur une carte consumer, la mémoire est le facteur limitant, pas la puissance de calcul brute.
Un point de vigilance s’impose par ailleurs, dans la droite ligne de notre guide sécurité et coûts réels : télécharger des checkpoints DSpark depuis Hugging Face expose aux mêmes risques de chaîne d’approvisionnement que n’importe quel GGUF. Vérifiez les empreintes SHA256, isolez votre environnement de test, et ne déployez jamais un nouveau module d’inférence sur une machine qui héberge des données sensibles sans l’avoir audité au préalable.
Ce que DSpark ne résout pas : le vrai coût du self-hosting en 2026
Il faut le dire clairement : DSpark accélère la génération, il ne réduit ni la VRAM nécessaire, ni le prix du matériel. Un modèle de 70B quantifié en 4 bits réclame toujours environ 40 Go de mémoire, et le KV cache continue de croître avec la longueur du contexte. Sur ce terrain, les arbitrages matériels de 2026 restent les mêmes, et notre dossier sur le KV cache les a longuement documentés.

Pour situer les ordres de grandeur, rappelons les configurations qui comptent réellement pour un budget maîtrisé. Côté GPU consumer, une AMD RX 7800 XT offre 16 Go de VRAM, et la RX 9070 XT 16 Go GDDR6 se négocie entre 690 et 740 $. Côté iGPU, une Radeon 780M plafonne à environ 10-12 tok/s sur Llama 3 8B Q4 en Vulkan, 8-11 tok/s sur Mistral 7B Q4_K_M, et tire +50 % d’un backend Vulkan bien réglé (dont +12,9 % via le réglage MMVQ). Côté machines à mémoire unifiée, les mini-PC IA se sont multipliés : Acer propose 128 Go de mémoire unifiée pour des modèles annoncés jusqu’à 200B ; AMD Ryzen AI Halo aligne 128 Go et jusqu’à 120B+ pour 3 999 $ ; AMD Gorgon Halo vise 192 Go pour du 200B+. Ces machines, et non un framework, sont ce qui décide si votre modèle tient ou non.
DSpark intervient après ce choix matériel : une fois que votre modèle tourne, il peut accélérer la boucle de génération. C’est un multiplicateur de confort, pas un substitut à la VRAM. Et sur ce plan, la concurrence s’organise : notre article sur llm-d 1.0 et DeepInfer montre que la bataille de l’inférence distribuée, avec prefill/decode disaggregation et cache KV planifiable, pourrait bien compter davantage pour un petit cluster que le seul décodage spéculatif.
Le contexte d’octobre 2026 : DSpark dans un écosystème qui bouge vite
Il serait injuste d’évaluer DSpark hors de son écosystème. En ce mois d’octobre 2026, plusieurs annonces redessinent le paysage de l’inférence locale, et DSpark doit y trouver sa place.
Windows ML a franchi un cap début octobre : selon Techgenyz (9 octobre 2026) et le blog Microsoft Foundry (7 octobre 2026), la plateforme ajoute un support expérimental de llama.cpp pour les modèles GGUF, une API locale compatible OpenAI, la génération de texte ONNX et de nouveaux outils runtime. Autrement dit, l’OS lui-même devient un runtime LLM — une couche sur laquelle DSpark pourrait, à terme, se greffer.
llama.cpp v0.5.0 (documenté le 27 septembre 2026) a consolidé son backend, ses modèles et son serveur, avec vérification GPU et llama-server. C’est le socle le plus probable pour un premier test communautaire de DSpark sur matériel consumer.
Strata, enfin, défraie la chronique depuis le 5 octobre 2026 : ce moteur revendique de faire tourner un Qwen 125B sur une carte graphique ordinaire, et r/LocalLLaMA débat fermement de la philosophie des « moteurs d’inférence sur-entraînés ». Que Strata tienne ses promesses ou non, le débat révèle une attente : les utilisateurs veulent des accélérateurs qui changent réellement la donne sur leur matériel, pas seulement sur des H100 en datacenter.
Face à cette effervescence, DSpark a un avantage : il est open source (MIT), documenté, et adossé à un modèle de production réel. Son handicap : l’absence de benchmarks indépendants et de retours communautaires sur GPU consumer. C’est précisément ce qui manque pour trancher.
Verdict : un vrai gain technique, une promesse commerciale à vérifier
Que retenir de DSpark ? Sur le plan technique, le framework est solide et cohérent. L’architecture en trois étages — backbone parallèle DFlash, tête de Markov de rang 256, confidence head couplé à un scheduler load-aware — répond à un vrai problème (le suffix decay des drafters parallèles) avec une vraie solution. La garantie de sortie octet pour octet identique au modèle cible est un argument de poids : elle signifie que DSpark n’introduit aucune dégradation de qualité, contrairement à certaines optimisations agressives.
Sur le plan des chiffres, la prudence reste de mise. Les 60-85 % de vitesse perçue et les +51/+52 % de débit système sont des chiffres internes à DeepSeek, mesurés sur son infrastructure de production, sans publication des conditions exactes. Le « 6,6× » de throughput est un facteur multiplicateur souvent mal reformulé en « +661 % » — corrigez-le quand vous le lisez. Et aucun benchmark indépendant n’existe à ce jour.
Pour le self-hosting à petit budget, la conclusion est nuancée. Si vous avez déjà un GPU NVIDIA correct et que vous servez DeepSeek-V4-Flash ou un modèle compatible, DSpark vaut clairement le détour — à condition de vérifier les checkpoints et d’isoler votre environnement. Si vous êtes sur Apple Silicon, la version MLX ouvre des perspectives intéressantes, mais les gains exacts sur M2/M3/M4 restent à confirmer. Si vous espérez faire tenir un 70B sur une carte 16 Go grâce à DSpark, tempérez vos attentes : le framework accélère la génération, il ne crée pas de VRAM.
La vraie question n’est donc pas « DSpark est-il révolutionnaire ? » mais « DSpark est-il le bon outil pour mon setup ? ». Et pour y répondre, il manque encore l’essentiel : des tests indépendants, sur du matériel grand public, avec des chiffres reproductibles. D’ici là, gardez DSpark dans votre liste de courses — mais ne jetez pas votre configuration actuelle avant d’avoir vu les premiers retours de la communauté.
Sources
- Le Fil IA — DeepSeek publie en open source DSpark, un framework qui accélère l’inférence des LLM jusqu’à 85 % (code source GitHub et Hugging Face, débit +51/+52 %, vitesse perçue 60-85 % / 57-78 %, modèles V4-Flash 284B/13B actifs et V4-Pro 1,6T/49B actifs)
- DeepSeek — Inside DeepSeek’s DSpark: Lossless 60-85% Faster LLM Inference (architecture drafter, confidence head, scheduler, sortie byte-identique, throughput ~6,6×)
- Cocoloop — DeepSeek ouvre DSpark pour accélérer l’inférence (co-développement DeepSeek / Université de Pékin, 60-85 %, jusqu’à 6,6× de débit GPU)
- Le Fil IA — DeepSeek publie DSpark, un framework de décodage spéculatif (60-85 % vs MTP-1) (date du 27 juin 2026, licence MIT, DeepSpec)
- Horizons Media — DSpark : DeepSeek accélère son IA de 85 % sur GPU
- Ayinedjimi Consultants — DSpark : accélération d’inférence LLM +85 % par speculative decoding
- Medium — DeepSeek DSpark: 85% faster LLM inferencing
- we0.ai — DSpark sur Apple Silicon via MLX
- Techgenyz — Windows ML: 2026 Updates for GGUF Models and Local AI (9 octobre 2026)
- Microsoft Foundry on Windows Blog — AI Development on Windows: from PyTorch and llama.cpp to Windows ML (7 octobre 2026)
- ai-stat.ru — Почему все говорят о Strata: эпоха переобученных движков (5 octobre 2026)
- gyanaangan.in — llama.cpp v0.5.0 in 2026: What Changed, How to Install, Run GGUF & Use the Local API (27 septembre 2026)
- Hivenet — Le KV cache expliqué : contexte LLM et mémoire GPU
- Hivenet — llm-d 1.0 et DeepInfer : la bataille de l’inférence distribuée
- PromptQuorum — Les LLM locaux sont-ils privés et sécurisés ? (télémétrie, GGUF non vérifiés, exposition réseau Ollama)
- Ayinedjimi Consultants — Comparatif Ollama vs LM Studio vs vLLM (vLLM 3,4× Ollama à 10 utilisateurs simultanés)
Article recherché et rédigé automatiquement · Magazine Electrosens