
 NVIDIA DGX Spark · 19 October 2026
LLM open source sur NVIDIA DGX Spark : clusters, benchmarks, fine-tuning et la nouvelle donne du 64 Go à l’automne 2026
L’été 2026 restera comme la saison où le supercalculateur personnel est devenu une réalité tangible. NVIDIA a officialisé le support multi-nœuds pour le DGX Spark, promettant des modèles jusqu’à 700 milliards de paramètres en local. Mais entre la promesse marketing et la réalité du câblage, du firmware et des benchmarks enfin publiés, le chemin s’est éclairci — sans pour autant devenir une promenade de santé. Et l’automne a rebattu les cartes : une version 64 Go à 4 999 dollars, une hausse du 128 Go au-delà des 6 000 dollars, et un écosystème logiciel qui mûrit enfin. Voici le guide de terrain que tout possesseur de DGX Spark attendait, mis à jour avec les retours de clusters réels et les modèles qui tournent vraiment en octobre 2026.
Le mirage des 700B : ce que promet NVIDIA, ce que la réalité du terrain confirme
Il y a des annonces qui électrisent une communauté. Celle de juin 2026 en fait partie : NVIDIA officialise le support multi-nœuds pour le DGX Spark, et avec lui la capacité annoncée de faire tourner des modèles jusqu’à 700 milliards de paramètres sur un cluster de quatre machines. La fièvre s’empare des forums, des blogs et des groupes Telegram. Le supercalculateur personnel, jusqu’ici réservé aux initiés et aux early adopters fortunés, devient soudain un objet de désir accessible — du moins sur le papier.
Car il faut bien le dire : la réalité du terrain ressemble davantage à un parcours du combattant qu’à une promenade de santé. Les premiers adoptants qui se sont lancés dans l’aventure du cluster 4× ont découvert un monde de câbles capricieux, de firmwares récalcitrants, de nœuds invisibles et de benchmarks introuvables. La documentation officielle existe, les playbooks aussi, mais leur mise en pratique réserve son lot de surprises.
Et depuis, les choses ont évolué plus vite que prévu — et pas toujours dans le sens espéré. Le prix du DGX Spark a grimpé de 18 % en février 2026, passant de 3 999 à 4 699 dollars. Puis, le 2 octobre 2026, NVIDIA a frappé un grand coup en annonçant une version 64 Go de mémoire unifiée, commercialisée à partir du 23 octobre chez plusieurs constructeurs, à 4 999 dollars — soit 1 000 dollars de plus que le prix de lancement de la version 128 Go en 2025, comme le relèvent Frandroid et kod.ru. Dans le même temps, la version 128 Go dépasse désormais les 6 000 dollars sur le marché, selon Pause Hardware — conséquence directe de l’envolée des cours de la mémoire LPDDR5. Le blog officiel de NVIDIA présente cette mouture 64 Go comme une façon de « donner aux développeurs plus de moyens de construire et de scaler l’IA locale », avec la pile logicielle NVIDIA complète et la possibilité de clusteriser pour gagner en performance à mesure que les charges grandissent.
La mise à jour de juin 2026 a apporté le support NVFP4 et un clustering simplifié, et les clusters peuvent désormais atteindre 8 nœuds. De nouveaux modèles open-source — DeepSeek V4 Flash 0731, Qwen3.8-27B, GLM-5.3 Flash, Qwen-3.8 Flash Next — tournent sur un seul Spark avec des performances qui auraient semblé impossibles il y a un an.
Mais surtout, les benchmarks indépendants existent désormais. Fini les chiffres fantômes : des retours de clusters réels, comme celui de QDNA (mis en service en février 2026, modèles basculés en août 2026), documentent précisément ce qui tourne, à quelle vitesse, et avec quelles limites. Ce dossier n’a pas pour ambition de vous vendre du rêve, mais de vous outiller. Nous allons disséquer les architectures possibles, démonter les rumeurs techniques, compiler les retours d’expérience des premiers clusters, et tenter de répondre à la question qui fâche : ce cluster en vaut-il vraiment la peine ? Du câblage aux benchmarks, en passant par le fine-tuning et la facture finale, voici le guide complet.
Sur le dos de la bête : ConnectX-7, QSFP et le casse-tête des câbles approuvés
Avant de brancher quoi que ce soit, il faut comprendre ce qui se cache sous le capot. Chaque DGX Spark embarque un Superchip GB10 (architecture Grace Blackwell), 128 Go de mémoire LPDDR5x unifiée — ou 64 Go pour la nouvelle mouture d’octobre —, un stockage NVMe de 1 To, et surtout une carte réseau ConnectX-7 de NVIDIA. C’est cette dernière qui rend le clustering possible, et c’est elle qui concentre l’essentiel des débats techniques.
La documentation officielle de NVIDIA est formelle : le DGX Spark dispose de deux ports QSFP sur la face arrière, chacun supportant jusqu’à 200 Gb/s en Ethernet. Une précision qui tranche avec certaines sources tierces, comme 3DVF, qui annonçaient initialement du 100 GbE. La confusion est compréhensible : les premières communications de NVIDIA mentionnaient une connectivité « jusqu’à 100 Gb/s », et le port RJ-45 10GbE présent sur la machine a ajouté à la confusion. Mais la doc actuelle du hub de clustering est sans ambiguïté : 200 Gb/s par port QSFP, en configuration Ethernet uniquement — pas d’InfiniBand, pas de surprise.
Le corollaire immédiat : les câbles. NVIDIA a publié une liste très fermée de câbles DAC (Direct Attach Copper) approuvés pour l’interconnexion. Deux références reviennent systématiquement : l’Amphenol NJAAKK-N911 (400 mm, 32 AWG, gaine LSZH) et le Luxshare LMTQF022-SD-R (400 mm, 30 AWG). Une variante de l’Amphenol, le NJAAKK0006, existe pour la version 0,5 mètre. Rien d’autre. Pas de câbles optiques AOC, pas de transceivers 200GBase-SR4, pas de connecteurs MPO-12.
C’est ici qu’il faut démonter une rumeur tenace. Plusieurs blogs et fils de discussion évoquent l’utilisation de câbles MPO-12 avec breakout vers 4× QSFP28, ou de transceivers optiques pour étendre la distance entre les nœuds. Or, aucune de ces solutions n’apparaît dans la documentation officielle de NVIDIA. Le hub de clustering ne mentionne que les DAC QSFP112, point final. Cela ne signifie pas que ces alternatives sont impossibles — certains utilisateurs bricoleurs ont réussi à faire fonctionner des configurations optiques — mais elles sortent du cadre supporté, et les risques de comportements erratiques sont réels.
| Élément | Spécification officielle | Source |
|---|---|---|
| Ports réseau | 2× QSFP (ConnectX-7), 200 Gb/s chacun | NVIDIA Documentation Hub |
| Câbles approuvés | Amphenol NJAAKK-N911, Luxshare LMTQF022-SD-R | NVIDIA Documentation Hub |
| Configuration réseau | Ethernet uniquement | NVIDIA Documentation Hub |
| Rumeurs MPO-12 / SR4 | Non documentées, non supportées | Absence dans la doc officielle |
Le message est clair : pour un cluster fiable, on s’en tient aux DAC approuvés. C’est moins glamour, mais ça évite bien des nuits blanches.
Full-mesh, étoile ou 8 nœuds : le duel des topologies qui divise la communauté
Une fois les câbles en main, se pose la question de l’architecture réseau. Deux écoles s’affrontent : le full-mesh direct, où chaque nœud est relié à tous les autres, et l’étoile, où un switch centralise les connexions. Le choix n’est pas anodin, et il conditionne la scalabilité du cluster.
Pour 2 ou 3 nœuds, la réponse est simple : NVIDIA fournit des playbooks officiels de connexion directe. Le « Connect Two Sparks » et le « Connect Three Sparks » décrivent précisément comment relier les machines entre elles via leurs ports QSFP, sans switch intermédiaire. Cette configuration full-mesh fonctionne, et elle a l’avantage de la simplicité : pas de matériel supplémentaire, pas de configuration de switch, juste des câbles DAC entre les ports.
Mais le passage à 4 nœuds change la donne. Le revendeur Exxact, qui a publié un guide détaillé sur la construction d’un cluster 4×, est catégorique : « Les directives de clustering de NVIDIA supportent jusqu’à trois systèmes DGX Spark connectés avec des câbles directs. Mais quatre systèmes ou plus nécessitent un switch réseau managé. » Cette affirmation est corroborée par l’existence du playbook officiel « Multi Sparks Through a Switch », qui décrit précisément la configuration avec un switch QSFP.
Pourquoi cette limite ? La réponse tient à la topologie des ports. Chaque DGX Spark n’a que deux ports QSFP. En full-mesh, chaque nœud doit se connecter à trois autres — impossible avec seulement deux ports. Pour 4 nœuds, il faut donc un switch, qui centralise les connexions et permet à chaque machine de communiquer avec toutes les autres via un seul lien.
Le playbook officiel pour 4 nœuds, mis à jour le 21 juillet 2026, précise les exigences : un switch QSFP avec au moins 4 ports QSFP56-DD (200 Gb/s chacun), et une mise à jour systématique de tous les systèmes vers la dernière version de l’OS et du firmware. Le choix du switch reste ouvert : NVIDIA ne recommande pas explicitement un modèle, mais la compatibilité RoCE v2 est essentielle pour tirer parti des performances du ConnectX-7. Certains utilisateurs évoquent le Spectrum-X de NVIDIA, d’autres utilisent des switchs Ethernet génériques compatibles RoCE v2 — avec des résultats variables.
Et la mise à jour de juin 2026 a élargi le spectre : les clusters peuvent désormais atteindre 8 nœuds, avec des topologies documentées pour 2 à 8 Sparks. Les retours des premiers utilisateurs de clusters 8×, rapportés sur les forums NVIDIA, indiquent que la scalabilité est réelle mais que la configuration réseau devient le facteur limitant — au-delà de 4 nœuds, la latence du switch et la qualité des câbles DAC font toute la différence.
| Topologie | Nœuds | Switch requis | Avantages | Inconvénients |
|---|---|---|---|---|
| Full-mesh direct | 2-3 | Non | Simple, pas de matériel additionnel | Limité à 3 nœuds (2 ports QSFP par machine) |
| Étoile avec switch | 4-8 | Oui (4 ports QSFP56-DD min.) | Scalable, configuration centralisée | Coût additionnel, configuration plus complexe |
La question du full-mesh « sans switch » pour 4 nœuds reste un sujet de débat. Certains bricoleurs ont tenté des configurations avec des câbles optiques et des transceivers pour contourner la limitation des ports, mais ces approches sortent du cadre supporté et les retours sont mitigés. La voie officielle — et la plus sûre — passe par le switch.
Le firmware qui fâche : playbooks officiels, mises à jour et la chasse aux versions fantômes
C’est le point qui fâche, et il mérite qu’on s’y attarde. Le playbook officiel pour le cluster 4 nœuds, mis à jour le 21 juillet 2026, est explicite : il exige de mettre à jour tous les systèmes vers la dernière version du système d’exploitation et du firmware avant de procéder au câblage et à la configuration. Une exigence logique en apparence, mais qui se heurte à un problème de taille : les numéros de version exacts de ces mises à jour sont introuvables.
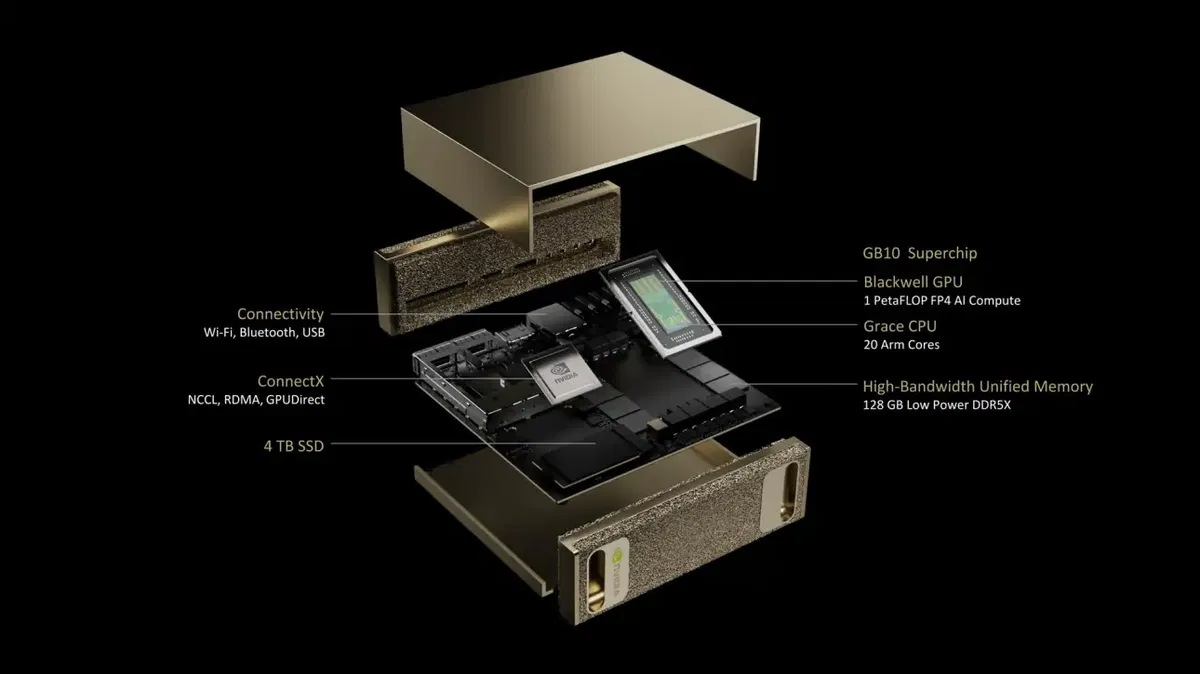
On sait que DGX OS suit un calendrier de publication semestriel, autour de février et août. On sait aussi que la mise à jour de juin 2026 a officiellement activé le support multi-nœuds — c’est l’annonce qui a déclenché la fièvre estivale. Mais aucune note de version numérotée, aucun numéro de build précis pour DGX OS, CUDA ou le firmware du ConnectX-7 n’a été publié de manière vérifiable dans les sources disponibles. Les forums officiels de NVIDIA regorgent de questions à ce sujet, et les réponses des modérateurs restent évasives.
Cette opacité a des conséquences pratiques. Comment savoir si votre machine est à jour ? Comment vérifier que le firmware du ConnectX-7 est compatible avec le playbook 4 nœuds ? La réponse, pour l’instant, tient plus de l’empirisme que de la procédure documentée. Les utilisateurs expérimentés recommandent de vérifier les versions via les outils système (nvidia-smi pour le GPU, mstflint pour le firmware ConnectX-7), et de comparer avec les informations disponibles sur le hub de clustering. Mais sans numéros de référence officiels, la marge d’erreur est grande.
Un autre point mérite d’être souligné : la mise à jour de juin 2026 n’est pas la seule évolution logicielle récente. Le 21 juillet 2026, NVIDIA a publié la première developer preview de CUDA Toolkit 13.4 pour Windows sur Arm, ouvrant la voie aux machines RTX Spark. Un signe que l’écosystème logiciel s’élargit, mais aussi que les versions se multiplient — et avec elles, les risques d’incompatibilité. Plus récemment encore, le 8 octobre 2026, NVIDIA a dévoilé la DGX Station for Windows (748 Go de mémoire cohérente, 20 PFLOPs FP4, lancement au quatrième trimestre 2026 via six partenaires OEM), selon tech-insider.org — une machine qui ne remplace pas le Spark mais redessine le haut de gamme du poste de travail IA local.
| Élément | Date clé | Statut |
|---|---|---|
| Mise à jour multi-nœuds | Juin 2026 | Annoncée, versions non vérifiées |
| Playbook 4 nœuds | 21/07/2026 | Documenté, exige mise à jour OS/firmware |
| DGX OS calendrier semestriel | Février / Août | Confirmé par source tierce |
| CUDA 13.4 preview Windows on Arm | 21/07/2026 | Developer preview publiée |
| DGX Station for Windows | 08/10/2026 | Annoncée, Q4 2026, 6 OEM |
En attendant des notes de version plus transparentes, la prudence est de mise : on ne monte pas un cluster 4× avec des machines qui n’ont pas été mises à jour, mais on ne se fie pas non plus aux rumeurs de forums pour valider une version.
Chiffres enfin publiés : les benchmarks qui changent la donne en août-septembre 2026
Parlons chiffres, puisque c’est ce que tout le monde attend. Et cette fois, les données sont là, mesurées, datées, reproductibles. Le plafond physique du GB10 reste ce qu’il est : 128 Go de mémoire unifiée mais seulement 273 Go/s de bande passante. C’est cette seconde donnée, bien plus que la première, qui décide de tout en décodage — et c’est ce que confirment les campagnes de mesure de l’été et de l’automne.
Le cluster 2× : le sweet spot enfin documenté
C’est sur la configuration à deux nœuds que les chiffres sont les plus solides. Avec vLLM en tensor parallel 2 (TP=2) et DeepSeek-V4-Flash en FP8, les mesures d’août 2026 donnent : ~41 tokens/s en single-stream, ~1 785 tokens/s en prefill, et surtout ~350 tokens/s en débit agrégé à concurrence 32. Un pool de cache KV partagé de 1 105 096 tokens a été mesuré sur cette même configuration. Et la taille maximale de modèle supportée sur 2 Sparks est documentée à 405 milliards de paramètres.
Ces chiffres racontent une histoire simple : le 2× n’est pas un mini-cluster de secours, c’est la configuration qui offre le meilleur rapport performance/complexité. On double la mémoire disponible, on partage le cache KV, on monte à 405B de paramètres, et on obtient un débit agrégé qui rend le serving multi-utilisateurs crédible.
Le single Spark : ce qui tourne vraiment
Sur une seule machine, les chiffres d’août 2026 confirment la hiérarchie des usages :
- DeepSeek-V4-Flash en IQ2_XXS via ds4.c : ~14 tokens/s en single-stream, mais 410 tokens/s en prefill — un prefill élevé qui rend le modèle utilisable en interactif malgré un décodage modeste.
- Suite GGUF llama.cpp : jusqu’à 67 tokens/s sur un modèle de type 35B-A3B (MoE à activation réduite).
- Qwen3.8-27B (sorti en août 2026) : 34-38 tokens/s sur DGX Spark, avec un contexte de 262K et un empreinte d’environ 21 Go en quantification Unsloth UD-Q4_K_XL, selon Tokenstead.
- Qwen3.6-27B : 28-33 tokens/s en session unique, jusqu’à 163 tokens/s en pic de décodage, et 136 tokens/s avec 10 agents en parallèle.
Le message est limpide : sur GB10, le MoE à activation réduite écrase le dense en débit, et le prefill n’est presque jamais le goulot — c’est le décodage, contraint par les 273 Go/s, qui fixe la loi.
Le tournant NVFP4
La mise à jour de juin 2026 a activé le support NVFP4, et c’est probablement l’évolution la plus sous-estimée de l’été. Sur le chemin optimisé NVFP4, Qwen 3.6 35B A3B atteint 200+ tokens/s avec un tool-calling parfait, toujours d’après Tokenstead. C’est le genre de saut qui change un usage : un modèle d’agent, avec appels d’outils fiables, à 200 tokens/s sur une machine de bureau. À comparer aux 67 tokens/s de la même famille en GGUF classique : le format de quantification et le moteur pèsent autant que le matériel.
Les benchmarks indépendants arrivent
Le 29 septembre 2026, Artificial Analysis a publié AA-AgentPerf-Local, un outil open source de mesure des agents IA locaux sur laptops et workstations, avec des résultats de lancement pour le DGX Spark, le Ryzen AI Halo, le MacBook Pro (M5 Pro) et la RTX 5090, sur quatre modèles open weight. C’est une première : un protocole commun, des machines comparées sur le même banc, et des chiffres d’agents — pas seulement des tokens/s de chatbot. Pour la première fois, on peut situer le Spark face à ses concurrents sur une tâche réaliste plutôt que sur une fiche technique.
Le comparatif matériel de Context Studios (24 septembre 2026) va dans le même sens : DGX Spark, Mac Studio M5 Ultra, RTX 5090 et Strix Halo comparés sur Qwen3.8 et GLM-5.3, avec tokens/s réels, prix et coût par token face au cloud. La conclusion qui se dégage des différentes sources est cohérente : le Spark n’est pas le plus rapide en single-stream face à une RTX 5090, mais il gagne sur la capacité mémoire unifiée et sur le coût par token en serving local soutenu.
| Configuration | Modèle / moteur | Débit clé | Date |
|---|---|---|---|
| 1× Spark | DeepSeek-V4-Flash IQ2_XXS (ds4.c) | ~14 tok/s single, 410 tok/s prefill | 08/2026 |
| 1× Spark | 35B-A3B (llama.cpp GGUF) | jusqu’à 67 tok/s | 08/2026 |
| 1× Spark | Qwen3.8-27B (UD-Q4_K_XL) | 34-38 tok/s | 08/2026 |
| 1× Spark | Qwen3.6-27B, 10 agents | 136 tok/s | 2026 |
| 1× Spark | Qwen 3.6 35B A3B (NVFP4) | 200+ tok/s, tool-calling parfait | 2026 |
| 2× Spark | DeepSeek-V4-Flash FP8 (vLLM TP=2) | ~41 tok/s single, ~350 tok/s @ c=32, ~1 785 tok/s prefill | 08/2026 |
| 2× Spark | Cache KV partagé | 1 105 096 tokens | 08/2026 |
Les modèles de l’automne 2026 : ce qui tient, ce qui gagne, ce qui casse
Le paysage des modèles open weight a beaucoup bougé entre août et septembre 2026, et le Spark est devenu une cible de choix pour les laboratoires chinois qui optimisent l’inférence locale.

Qwen3.8-27B (Alibaba, août 2026) est le nouvel all-rounder de référence sur la machine : 88 en coding, 89 en raisonnement, 94 en tool-calling selon les notations Tokenstead, avec un contexte de 262K et une empreinte d’environ 21 Go. C’est le modèle à installer en premier si vous voulez l’état de l’art sur un seul Spark sans sacrifier la marge mémoire pour le contexte et l’OS.
GLM-5.3 Flash (Zhipu AI, 26 août 2026) et Qwen-3.8 Flash Next (Alibaba, même jour) poussent la logique du MoE à l’extrême pour l’inférence agentique à bas coût, comme le détaille LeMagIT. GLM-5.3 Flash est le premier modèle multimodal de la collection GLM 5 : il active 18 milliards de ses 320 milliards de paramètres. Qwen-3.8 Flash Next affiche 125 milliards de paramètres, n’en active que 6 milliards à l’inférence (plus 51 milliards de paramètres d’embedding n-grammes), avec une fenêtre jusqu’à 1 million de tokens. Pour un Spark, ces profils MoE sont idéaux : peu d’activation, donc peu de pression sur la bande passante, et une qualité qui rivalise avec les modèles frontière sur les tâches agentiques.
Xiaomi MiMo-V2.6 (Pro, Flash et 9B, open source sous licence MIT, 22-24 septembre 2026) complète le tableau. Selon SiliconANGLE et Forkast, le MiMo-V2.6-Pro égale Grok 4.7 sur l’Intelligence Index et surpasse Claude Opus 5 sur certains benchmarks clés. Attention toutefois : eWeek souligne que les gains de RL ne bénéficient pas encore de réplication indépendante et reposent sur une infrastructure d’entraînement coûteuse. Sur un Spark, les variantes Flash et 9B sont les plus pertinentes ; la Pro demande de la mémoire et de la patience.
Enfin, un signal fort pour l’écosystème local : Alibaba a annoncé que Qwen-3.8 27B tourne nativement sur son processeur XuanTie C950 (RISC-V, 5 nm, 64 cœurs jusqu’à 3,2 GHz), sans GPU ni couche d’émulation, comme le rapporte Tom’s Hardware. Ce n’est pas une alternative au Spark — le C950 vise l’edge et l’inférence privée monothread — mais cela confirme que les modèles 27B sont devenus le standard de facto de l’IA locale, et que tout le monde optimise pour eux.
Un dernier point d’attention, documenté sur GitHub le 26 septembre 2026 : l’inférence MiniMax H3 FL2VA sur un Spark unique a coïncidé avec un blocage complet de l’hôte lors d’une génération texte-vers-vidéo 864×480 de 124 frames, après des exécutions réussies. C’est le rappel que les charges vidéo, bien plus gourmandes en mémoire que le texte, restent un terrain instable sur GB10 — et qu’il faut surveiller la mémoire unifiée comme le lait sur le feu.
Fine-tuning et piles d’inférence : ce qui marche, ce qui casse, ce qui gagne
Le fine-tuning sur Spark est possible, mais il faut être lucide sur ce qu’on peut réellement entraîner. Avec 128 Go unifiés et 273 Go/s de bande passante, le LoRA sur des modèles de 7 à 30 milliards de paramètres est le domaine réaliste ; le full fine-tuning de modèles frontière n’est pas à l’ordre du jour. La bonne nouvelle, c’est que la pile logicielle NVIDIA (NGC, conteneurs, CUDA) est désormais complète sur aarch64 — mais le piège des cinq premières minutes reste entier : un pip install malheureux peut vous installer un PyTorch CPU-only qui vous vole votre GPU sans le moindre message d’erreur. Vérifiez systématiquement que la roue aarch64 CUDA est bien celle qui est chargée.
Côté piles d’inférence, le comparatif 2026 est sans appel : sur une Spark, ce n’est pas la machine qui varie d’un facteur deux, c’est le moteur. vLLM reste la référence pour le serving et les agents, à condition de dompter PagedAttention et le KV cache — c’est lui qui délivre les ~350 tokens/s agrégés en TP=2 sur DeepSeek-V4-Flash. SGLang et TensorRT-LLM sont les options à considérer quand chaque milliseconde de TTFT se paie en heures de build ; TensorRT-LLM est aussi le chemin privilégié pour tirer parti de NVFP4. llama.cpp et Ollama restent imbattables pour la simplicité et le prototypage, avec des débits honnêtes (jusqu’à 67 tokens/s sur du 35B-A3B), mais ils laissent de la performance sur la table en serving concurrent. ExLlamaV2/V3 et MLC visent la latence pure, au prix de builds plus exigeants.
Le vrai enseignement de l’automne : la combinaison gagnante n’est pas un moteur unique, mais un couple moteur/quantification adapté à l’usage. NVFP4 + TensorRT-LLM pour les agents à haut débit, vLLM + FP8 pour le serving multi-utilisateurs sur cluster, llama.cpp + GGUF pour l’expérimentation rapide. C’est là que se gagnent les 2× sans changer de machine.
La facture finale : 64 Go ou 128 Go, un ou deux Sparks ?
La question qui fâche mérite une réponse chiffrée, et l’annonce du 2 octobre 2026 la rend plus complexe qu’avant. Résumons la grille tarifaire à jour :
- DGX Spark 64 Go : 4 999 dollars, disponible à partir du 23 octobre 2026 chez plusieurs constructeurs.
- DGX Spark 128 Go : plus de 6 000 dollars sur le marché, contre 4 699 dollars après la hausse de février 2026 et 3 999 dollars au lancement.
- Alternatives OEM : les mini-PC GB10 d’Acer, livrés depuis le 8 septembre 2026, sont positionnés 500 à 1 000 dollars sous le prix NVIDIA, avec 128 Go de mémoire unifiée.
Le calcul est donc moins évident qu’il n’y paraît. Deux Sparks 64 Go coûtent environ 10 000 dollars, soit nettement plus qu’un seul 128 Go à 6 000 dollars — mais deux nœuds ouvrent la porte au TP=2, au cache KV partagé de plus d’un million de tokens et aux 405 milliards de paramètres. À l’inverse, un seul 128 Go reste la solution la plus simple, la plus silencieuse et la plus économe en énergie, et il suffit à faire tourner confortablement Qwen3.8-27B ou un 120B quantifié. La vraie question n’est donc pas « 64 ou 128 » mais « un gros ou deux petits » — et la réponse dépend entièrement de votre usage : serving multi-utilisateurs et agents parallèles penchent vers le cluster, prototypage et inférence mono-utilisateur vers la machine unique.
N’oubliez pas non plus le coût caché du cluster : le switch QSFP managé (indispensable dès 4 nœuds), les câbles DAC approuvés, et le temps d’ingénierie. Un cluster 4× n’est pas quatre Sparks posés sur une étagère ; c’est une infrastructure réseau à part entière.
Verdict : le supercalculateur personnel a tenu sa promesse, à moitié
Un an et demi après son annonce, le DGX Spark n’est ni la révolution marketing des 700 milliards de paramètres, ni le fiasco que certains forums annonçaient. C’est une machine qui a mûri — par vagues, avec des à-coups, des prix qui montent et une documentation qui reste en retard sur la réalité du terrain.
Ce qui marche : le single Spark sur les modèles MoE récents (Qwen3.8-27B, GLM-5.3 Flash, MiMo-V2.6 Flash), le NVFP4 qui décuple le débit des agents, le cluster 2× qui atteint 405B de paramètres avec un cache KV partagé de plus d’un million de tokens, et un écosystème de benchmarks indépendants (AA-AgentPerf-Local, Tokenstead, Context Studios) qui permet enfin de choisir sur des chiffres.
Ce qui coince : les versions de firmware opaques, la limite des deux ports QSFP qui impose un switch dès 4 nœuds, les charges vidéo qui peuvent bloquer l’hôte, et une grille tarifaire devenue défavorable — 4 999 dollars pour 64 Go, plus de 6 000 pour 128 Go, quand les OEM GB10 d’Acer restent 500 à 1 000 dollars en dessous.
La recommandation de terrain est simple. Pour un développeur solo qui veut faire tourner des modèles de 27 à 120 milliards de paramètres en local : un Spark 128 Go (ou un OEM GB10 équivalent), vLLM ou llama.cpp selon l’usage, et Qwen3.8-27B comme couteau suisse. Pour une petite équipe qui veut servir des agents en parallèle : deux Sparks en TP=2, c’est le sweet spot documenté. Pour les ambitieux du 405B et au-delà : le cluster 4× avec switch, en acceptant le coût et la complexité. Et pour tous : méfiance avec les rumeurs de câbles optiques, prudence avec les firmwares non vérifiés, et un œil sur la DGX Station for Windows qui, dès le quatrième trimestre 2026, viendra redessiner le haut de gamme.
Le supercalculateur personnel est là. Il n’est pas parfait, mais il est réel — et à l’automne 2026, il a enfin des chiffres pour le prouver.
Sources
- NVIDIA DGX Spark 64GB Gives Developers More Ways to Build and Scale Local AI — blog officiel NVIDIA, 2 octobre 2026
- Nvidia lance le DGX Spark en 64 Go : faut-il acheter deux petits plutôt qu’un gros ? — Frandroid, 2 octobre 2026
- Nvidia представила ИИ-компьютер DGX Spark с 64 ГБ памяти — kod.ru, 3 octobre 2026
- Le DGX Spark Perd La Moitié De Sa Mémoire Mais Conserve Son Tarif De 4 999 Dollars — Pause Hardware, 2 octobre 2026
- NVIDIA lance un DGX Spark 64 Go : moins de mémoire, mais une drôle d’astuce pour dépasser le modèle 128 Go — Clubic, 2 octobre 2026
- DGX Spark 64 Go : NVIDIA annonce une configuration — NeoTeo, 3 octobre 2026
- Nvidia DGX Spark 64 Go : moins de mémoire pour plus cher — Generation-NT, 4 octobre 2026
- The Best DGX Spark for Local AI in 2026: LLM Speed, Model Sizes, and Clusters, With Sources — Pyshine, 1er octobre 2026
- DGX Spark Benchmarks: Which Local Model Wins in 2026 — Tokenstead
- AA-AgentPerf-Local: Benchmarking local AI agents on laptops and workstations — Artificial Analysis, 29 septembre 2026
- Matériel pour l’IA locale en 2026 : DGX Spark, Mac Studio M5 Ultra, RTX 5090 et Strix Halo comparés — Context Studios, 24 septembre 2026
- GLM-5.3 Flash, Qwen-3.8 Flash Next : zAI et Alibaba cherchent à casser les prix de l’inférence IA — LeMagIT, 26 août 2026
- Xiaomi introduces Mimo-V2.6 series open-source AI model family — SiliconANGLE, 22 septembre 2026
- Xiaomi’s MiMo-V2.6 Ships Open Weights at Frontier-Class Performance — Forkast, 22 septembre 2026
- Xiaomi MiMo-V2.6 Open Source: Pro, Flash, 9B Models — eWeek, 23 septembre 2026
- Fin des GPU pour l’IA : Alibaba lance son processeur en 5 nm pour faire tourner Qwen — Tom’s Hardware, 2026
- MiniMax H3 FL2VA on single DGX Spark GB10: whole-host loss during 864×480 T2V — GitHub issue, 26 septembre 2026
- NVIDIA DGX Station for Windows: 748GB, 20 PFLOPs — Tech-Insider, 8 octobre 2026
- Building Windows for hybrid intelligence — Windows Blog, 7 octobre 2026
Article recherché et rédigé automatiquement · Magazine Electrosens